

上交大与字节跳动联手:不用Docker也能训练出顶级代码AI
上海交通大学与字节跳动提出Dockerless系统,无需Docker环境即可判断代码修复正确性,通过主动侦查代码仓库生成验证证据并综合裁决。在多个测试集上达到62.0%问题解决率,超越同类模型,且与真实测试环境训练性能接近。
这篇由上海交通大学与字节跳动旗下抖音集团联合完成的研究,于2026年6月26日以预印本形式发布,编号为arXiv:2606.28436。如果你对细节感兴趣,可以直接去arXiv上搜这个编号,全文都在那儿。
先抛个问题给你:假设你开了个程序员培训班。每次想测试学员写的代码对不对,你都得给每个人单独搭一个完整的开发环境——装特定版本的语言、配专属依赖库、搭好测试基础设施。而且,还得给每个委托方公司的每套代码库都造一个“测试工厂”。这不光累死人,最关键的是,如果委托方的代码库是私有的、尘封已久的,甚至压根儿就没有像样的测试用例,这条路就彻底走不通了。
这正好掐住了当前训练代码AI的命门。现在那些能自动修复GitHub上真实软件Bug的智能体,训练时极度依赖一种叫“执行验证”的机制——让AI写出修复代码后,真的在项目环境里跑一遍测试,用测试通不通来打分。这个机制的问题在于,每个开源项目都得一个独立的Docker容器,里面装上精确匹配的依赖库、测试脚本和运行工具。光搭建这些环境就是个大工程,就算用上最先进的自动化流水线,也只能覆盖候选代码库中的一小撮。至于那些企业内部的私有代码库、二十年前的老古董,根本没法用这种方式来训练AI。
为了解决这个痛点,上交大和抖音团队搞了个叫Dockerless的系统。名字已经说得很明白了:不需要Docker,不需要任何特别的运行环境,照样能判断AI修的代码对不对。
一、为什么“有没有测试环境”是个大问题
在聊Dockerless之前,得先搞清楚,为什么“测试环境”这事儿这么重要,以至于整个AI训练都绕不开它。
训练代码AI的流程,就像培训一个新程序员。先给AI看大量“好的修复案例”,让它学怎么修Bug,这叫监督微调(SFT)。然后让AI自己去试,修对了给奖,修错了罚它,在反复试错中变强,这叫强化学习(RL)。不管哪个阶段,你都需要一个裁判——一个能可靠判断“AI这次修得对不对”的机制。
现在最靠谱的裁判就是跑测试:把AI写的修复代码塞进项目环境,运行最新测试用例,全过了就算对,有测试失败就算错。这个裁判很准,但代价惊人。研究人员发现,就算有自动化工具帮忙,也只有有限比例的代码库能成功搭起可用的测试环境。更现实的问题是,企业内部私有代码、二十年前的遗留系统,根本不可能为AI训练专门搭一套环境。
换句话说,现有的代码AI训练方法,只适用于那些恰好有完整Docker环境和测试套件的开源项目,范围窄得很。现实世界里数量更多的“长尾”代码库,这套体系完全失效。
研究团队意识到,解决这问题不在于怎么更高效率地搭环境,而在于根本绕开环境依赖。关键突破口是:能不能训练出一个足够聪明的“裁判”,光靠读代码本身,就能判断一个修复对不对——就像一位经验丰富的老工程师,不用跑测试,光看代码就知道这么改行不行?
二、已有的“不跑测试”判断方法为什么不够用
在Dockerless出现之前,学术界已经有人尝试过不依赖测试环境来打分,这类方法统称“无环境验证器”(environment-free verifier)。现有方法大概分两类,但都有明显毛病。
第一类是直接用大型语言模型(LLM)来当裁判。把问题描述、参考答案(正确修复代码)和AI生成的修复代码一起塞给大模型,让它判断AI修的对不对。问题在于,大模型裁判只能看到代码文本,对整个代码仓库的上下文一无所知。这就好比让一个从没进过厨房的人,光看菜谱来判断一道菜做得好不好——光看文字,根本不知道灶台火候、食材状态的真实情况。
第二类是训练专门验证器模型。有些团队试着训练专用于判断代码修复好坏的模型,比如SWE-Gym Verifier、R2E-Gym Verifier、OpenHands Critic和DeepSWE Verifier。这些模型有同样的问题:打分时只依赖表面信息,不会主动去查代码仓库。
这里有个非常典型的反例:假设标准答案是用辅助变量实现某个逻辑,而AI的答案是用内联三元表达式实现完全一样的逻辑。两种写法功能等价,但代码外观截然不同。单纯比对代码文本,相似度极低,表面层面的评分方法会判AI的答案错误。但如果能深入查阅代码仓库,确认两种写法在实际调用链和边界情况处理上效果一致,才能做出正确判断。
研究团队正是基于这个洞察,设计了Dockerless:一个会主动“侦查”代码仓库的智能裁判。
三、Dockerless是怎么工作的:一个会问问题的侦探
理解Dockerless的工作方式,可以用侦探破案来类比。优秀侦探判断一个人是不是嫌疑人时,不会只盯着他的脸反复比对,而是会主动出去查:去案发现场勘察、查档案、访问目击者、收集物证。收集到足够线索后,再综合所有证据做判断。
Dockerless的工作方式一模一样,分两个阶段。
第一阶段:出题调查
给定一个问题描述、一个参考答案(正确修复代码)和一个待判断的AI修复代码,Dockerless先从问题描述和参考答案里推导出2到4个“侦查问题”。比如:“修复应该发生在代码仓库的哪个位置?”“修改后的代码应该实现什么功能?”“什么样的测试或断言能证明修对了?”“仓库里还有哪些地方可能因为这次修改受影响?”推导出问题后,Dockerless为每个问题派出一个“子侦探”(sub-agent),这些子侦探并行工作,各自通过只读的命令行工具(如find、grep、rg)在代码仓库里翻查线索,每个子侦探最终返回一段有代码证据的简短回答。
第二阶段:综合判决
所有子侦探返回调查结果后,Dockerless把问题描述、参考答案、待判断的修复代码,以及所有问答对,一起交给最终判决模型。判决模型综合所有证据,输出一个二进制裁决:1表示修复正确,0表示不正确。为了得到一个更精细的连续评分,研究团队巧妙读取模型输出“1”和“0”两个词的概率值,用一个简单公式转换成0到1之间的连续分数。分数越高,说明Dockerless越确信修复正确。
这个设计的精妙之处在于,Dockerless不是在比较AI答案和标准答案有多像,而是在用证据验证AI答案是否真的解决了问题。就像侦探不是在问“嫌疑人的长相和目击者描述有多像”,而是在问“全部证据能不能指向这个人就是真凶”。
四、Dockerless是怎么被训练出来的
有了这个架构设计,下一个问题是:怎么让Dockerless学会这套侦查和判断能力?
训练过程采用了一种叫“拒绝采样”(rejection sampling)的方法,可以理解成“留优去劣的示范学习”。研究团队用一个强大的教师模型(GLM-5)作为初始侦探,在3700个有执行标签的代码问题上运行这套流程。所谓“有执行标签”,就是这些问题有真实测试环境,能跑测试,能得到确定的对错结论——这是训练数据收集阶段唯一用到测试环境的地方。
教师模型在每个问题上跑完流程后,会给出一个裁决。研究团队只保留那些裁决结论与真实测试结果一致的轨迹,也就是“教师判对了的案例”,丢弃判错的。这个筛选过程保证了训练数据质量——Dockerless只从正确的推理过程中学习,而不是从“凑巧说对了”的偶然案例中学习。
为了防止正负样本比例严重失衡(错误修复通常比正确修复多得多),研究团队把负样本与正样本的比例上限控制在4:1。最终训练数据覆盖了3700个独立问题,每个训练案例包含问题生成轨迹、若干子侦探调查轨迹,以及一段最终判决轨迹。整个Dockerless系统用一个共享神经网络骨干(基于Qwen3.5-9B模型)统一训练,问题生成、子侦探调查、最终判决三个子任务共用同一套参数。训练在验证集上以标准下一词预测损失为目标,最佳检查点大约在150步优化后出现。
五、用Dockerless训练代码AI:两个阶段的完整流水线
Dockerless训练好之后,就可以作为核心裁判,支撑起一套完全不依赖Docker环境的代码AI训练流水线。这套流水线分两个阶段,对应代码AI训练的两个标准步骤。
第一阶段:监督微调
传统做法是让AI在带测试环境的项目上跑,收集那些测试通过的修复轨迹作为训练数据。新做法是:让AI在一个极简的Linux基础镜像上运行,完全不搭任何项目专属环境,收集大批量修复尝试轨迹,然后用Dockerless对每个轨迹的最终修复代码打分,只保留得分最高的那一批,用来训练AI。
具体来说,研究团队在SWE-Rebench-v2这个数据集上,用这种方式收集了16000条修复轨迹,然后让Dockerless对所有轨迹打分,只取得分最高的4000条作为最终训练数据。每条轨迹会经过2次独立的Dockerless评估,取平均分作为最终得分,以提升评分稳定性。
第二阶段:强化学习
以第一阶段训练好的模型为起点,对于每个代码问题,让AI生成一组8条修复尝试,用Dockerless对每条修复打分。然后用一种叫GRPO的算法,将得分高的修复对应的策略方向强化,得分低的方向弱化。整个过程中同样不需要运行测试,也不需要任何项目专属的Docker环境。强化学习阶段总共训练了50步,每条修复同样经过2次独立的Dockerless评估取平均。
六、实验结果:数字说明了什么
研究团队在三个标准测试集上评估了整套系统:SWE-bench Verified(英文Python代码库测试集)、SWE-bench Multilingual(多语言代码库测试集)和SWE-bench Pro(更难的长周期任务测试集)。评估指标是“问题解决率”,就是AI正确修复了多少百分比的真实软件问题。
从验证器性能来看,Dockerless在专门构建的验证器评估基准上(776个样本),在SWE-bench Verified分支上达到了81.0的AUC分数(AUC衡量分类器判别能力,满分100),在Multi-SWE-bench Flash分支上达到了72.1分。对比一下:最好的开源训练验证器DeepSWE Verifier在两个分支上分别只有66.7和62.9分,差距超过14分;GPT-5.4、GLM-5等顶级商业大模型零样本作裁判,最高分别只有75.9和63.9,同样明显低于Dockerless。
从下游代码AI性能来看,以Qwen3.5-9B为基础模型,经过两阶段完全无环境训练后得到的Dockerless-RL-9B模型,在三个测试集上分别达到62.0%、50.0%和35.2%的问题解决率,比基础模型分别提升了2.4、8.7和2.9个百分点。这个结果超越了所有同等规模(参数量低于100亿)的开源代码AI专项模型:比SWE-Lego-8B高出约20.8、31.0和19.1个百分点,比SWE-Gym-7B和SWE-Dev-7B的差距更悬殊。
更值得关注的是横向对比。研究团队特意设计了受控实验,来分离SFT阶段和RL阶段各自的贡献,并与用真实测试环境的对照组比较。
在SFT阶段,“用真实Docker环境筛选轨迹训练的模型”(Env-SFT-9B)在三个测试集上分别达到60.0%、48.3%和33.9%,而“用Dockerless筛选无环境轨迹训练的模型”(Dockerless-SFT-9B)则是60.6%、47.7%和35.3%。两者非常接近,有时无环境版本还略胜一筹。
在RL阶段,以相同SFT模型为起点,分别尝试了三种奖励来源:用Dockerless打分(Dockerless-RL-9B)、用DeepSWE Verifier打分、以及用真实测试执行打分(Test-Execution RL)。结果显示,真实测试执行版本(62.4%、51.3%、35.7%)略好于Dockerless版本(62.0%、50.0%、35.2%),差距在0.4到1.3个百分点之间,属于非常微小的差异。而Dockerless版本则以1.4到2.7个百分点的优势明显胜过DeepSWE Verifier版本。
七、细节中的魔鬼:验证问题数量和计算开销
研究团队还仔细研究了一个实用问题:子侦探应该调查多少个问题,才能让Dockerless性能最优?
对验证问题数量K从0到8逐一测试,结果揭示了一个清晰规律:K等于0时(完全不调查,直接判断),AUC为78.3分;K从1增加到4时,AUC稳步提升,在K等于4时达到最高的81.0分;K继续增加到6和8时,AUC反而下滑到79.6和80.3。这说明适量调查能帮助裁判做出更准确判断,但问题太多后,新增结果往往是冗余甚至带来噪音的,边际收益递减。因此,最终Dockerless在推理时设定生成2到4个验证问题,在准确性和计算效率之间取得平衡。
在计算开销方面,研究团队以7680条强化学习训练轨迹为样本,分析了三种奖励来源下每条轨迹的耗时分解。结果显示,AI生成修复轨迹本身平均耗时约2308秒,是整个流程的绝对主体。奖励计算的额外耗时为:DeepSWE Verifier增加41秒(约1.7%),真实测试执行增加83秒(约3.5%),Dockerless增加180秒(约7.2%)。虽然Dockerless需要主动调查代码库,比简单查表的方法慢一些,但额外开销仅占总时间的7.2%,属于可以接受的范围。从总耗时分布图看,三种奖励来源的总耗时分布几乎完全重叠,都以2400到3000秒为主体的单峰分布,并伴有向硬超时方向延伸的长尾。这说明整个流程的瓶颈是那些运行缓慢、接近超时的修复轨迹,而非奖励计算本身。
八、一个真实案例:同样的逻辑,不同的写法
论文中一个真实案例,生动说明了Dockerless的核心价值。这是一个来自matplotlib(Python数据可视化库)的Bug修复任务,问题是:图表偏移量文字(offsetText)的颜色,应该使用标签颜色(labelcolor),而不是刻度颜色(tick.color)。
参考答案(正确修复)的写法是:先用辅助变量提取正确颜色,再将辅助变量赋值给offsetText。AI生成的候选修复则是:直接用内联三元条件表达式,在赋值时就完成颜色逻辑判断。两种写法语义完全等价,但代码结构差异明显。
文本相似度比较的结果是0.468分(满分1.0),大幅偏低。DeepSWE Verifier给出的分数只有0.035,几乎直接判定为错误修复。而Dockerless派出两个子侦探调查了两个问题:第一个子侦探确认AI的修复同时更新了XAxis和YAxis两个初始化路径,与标准修复一致;第二个子侦探确认AI的修复正确保留了“inherit”继承语义。基于这两条来自代码库的实证线索,Dockerless给出了0.996的高分,与真实测试执行结果(正确,满分1.0)高度吻合。
九、无环境训练的边界:哪些语言还是差了点
当然,没有任何方法是万能的。研究团队通过细致的分语言分析,诚实地指出了无环境训练方法的局限边界。
在Python、Go、Ja vaScript、Ja va、PHP、Ruby这些高使用量语言上,有环境训练与无环境训练的效果差异普遍在正负2.5个百分点以内,两者基本旗鼓相当。但在Rust和C这两门语言上,有环境训练的效果分别高出约7.0和13.3个百分点,差距相当显著。
研究团队分析,这个差距的根本原因在于:Rust和C都是强编译型语言,编译器本身就是一个非常强力的调试助手。在有环境的条件下,AI修复代码时能实时看到编译器报出的类型错误、链接失败等信息,这些信息极大地帮助AI在多轮尝试中收敛到正确答案。而在无环境条件下,AI只能从源代码本身推断这些信息,缺失了这一信道。研究团队指出,这个差距的解法可能不是收集更多有环境的训练数据,而是想办法在无环境流水线中引入某种形式的编译器反馈模拟,这被留作未来工作。
说到底,Dockerless这项研究做到的事情是:证明了一件以前被认为必须依赖测试执行的任务——判断代码修复的正确性——可以通过智能的代码库调查来接近等效地完成。这个结论在工程实践上的意义相当深远。企业里庞大的私有代码仓库、年久失修的遗留系统、没有完整测试套件的开源项目,都可能因此受益于高质量的AI辅助。训练一个好的代码AI,不必再事先为每一个代码库单独搭建一套测试基础设施。
当然,这并不意味着测试执行从此变得不重要。真实的测试环境在某些场景下仍然提供了无可替代的精确信号,尤其是编译型语言的强编译器反馈。但Dockerless为那些无法依赖测试环境的大多数场景,提供了一条切实可行的替代路径。
对于关心AI辅助编程未来发展的读者来说,一个值得思考的问题是:随着这类无环境验证技术的成熟,代码AI的训练数据来源会如何演变?私有企业代码库是否会成为下一批大规模训练语料?企业代码安全与AI训练数据之间的张力,将会如何影响技术的实际落地?这些问题目前尚无定论,但Dockerless的工作无疑推开了这扇大门的一条缝。对这项研究感兴趣的读者,可通过arXiv编号2606.28436查阅完整论文,原文包含了完整的提示词模板、训练超参数配置以及更详细的消融实验结果。
Q&A
Q1:Dockerless是什么,它解决了什么问题?
A:Dockerless是由上海交通大学与字节跳动联合研发的代码修复验证器,它能在不搭建任何项目专属Docker测试环境的情况下,判断AI生成的代码修复是否正确。传统方法需要为每个代码库单独配置测试环境,耗时费力且无法覆盖私有或遗留代码库,Dockerless通过主动调查代码仓库内容来替代执行测试,绕开了这一工程瓶颈。
Q2:Dockerless不运行测试,怎么知道代码修复是否正确?
A:Dockerless采用“侦探调查”式的工作方式:先从问题描述中生成2到4个关键侦查问题,再为每个问题派出一个独立的子智能体,在代码仓库中用只读命令行工具查找证据,最后将收集到的所有问答证据交给判决模型综合分析,输出一个0到1之间的置信评分。这种方式让它能识别出功能等价但写法不同的修复,而不是简单比较代码文字相似度。
Q3:Dockerless训练的代码AI和传统方法训练的效果差多少?
A:在SWE-bench Verified、Multilingual和Pro三个标准测试集上,用Dockerless完全无环境流水线训练的Dockerless-RL-9B模型,与用真实测试执行训练的对照模型相比,差距约在0.4到1.3个百分点之间,表现非常接近。但在Rust和C这类强编译型语言上差距更明显,约7到13个百分点,这被认为是编译器反馈信息缺失所致。
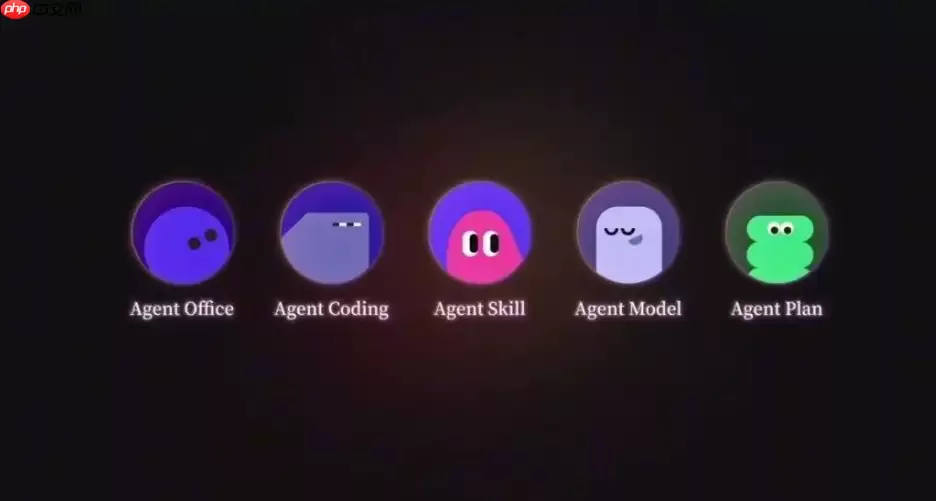
扣子2.0发布四项核心能力:AgentSkills将业务场景和工具链封装为技能包;AgentPlan支持设定中长期目标并自主规划执行;AgentOffice提供上下文理解和决策级洞察;AgentCoding实现自然语言驱动的云端一体化开发环境。
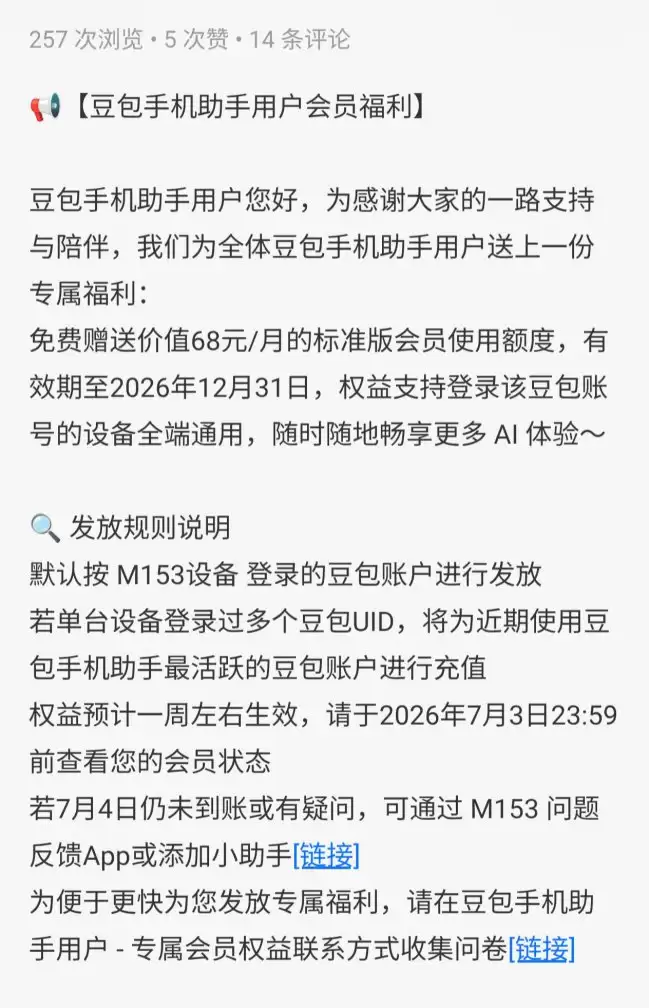
此次字节跳动专门为每位努比亚M153“豆包手机”用户赠送的每月价值68元的标准版会员,其有效期至2026年12月31日,该会员权益随豆包账号通用,将默认发放给设备上最活跃的账户。
据悉,百度旗下昆仑芯计划港股上市,估值约500亿美元。腾讯已成其客户,字节跳动评估其AI芯片但接近人士否认合作。其P800芯片已完成规模化验证,支撑文心5.1大模型训练。
百度旗下AI芯片公司昆仑芯传赴港上市,腾讯已为其客户,但字节跳动否认合作意向。火山引擎总裁谭待称自研芯片不重要,模型能力才是核心竞争力。昆仑芯已完成六轮融资,三代产品亮相。
字节跳动CEO梁汝波时隔四年更新十条领导力原则,新增“做有高度的事”等条目,强调管理者深入一线、信息透明优先于控制,并直接纳入晋升与考核标准,以整治形式化和业务空转。
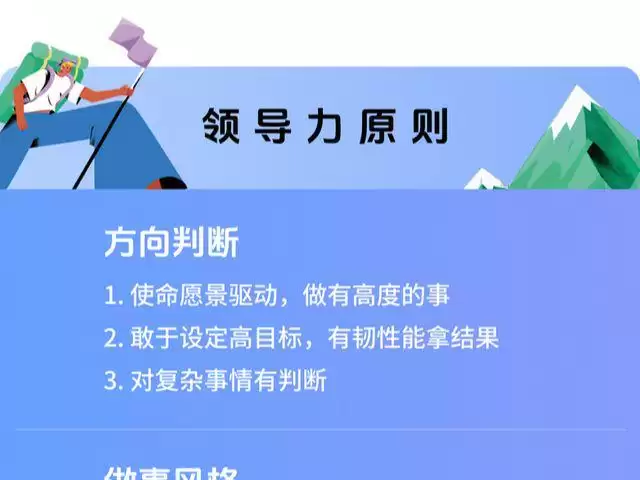
字节跳动近期更新领导力原则,围绕“勇攀高峰”方向,在原有基础上新增“做有高度的事”“敢于设定高目标”,将“有危机感”“深入一线”独立成条,并强调信息共享与有效控制。更新后共十条原则。
字节跳动等机构提出DanceOPD框架,将文字生图、局部编辑和全局编辑统一为速度场,采用硬路由、在线取经和单次语义侧取经策略,使模型同时掌握多种能力且互不干扰。实验表明,该框架在编辑和生成任务上显著优于现有方法。
香港大学与字节跳动联合提出“桥接动作”方法,仅保留手腕三维平移轨迹,丢弃旋转信息,从人类操作视频学习机器人技能。在15个双臂任务上,经三阶段训练后平均成功率达60%,进度分72%。该方法有效解决人类与机器人运动机制差异问题。
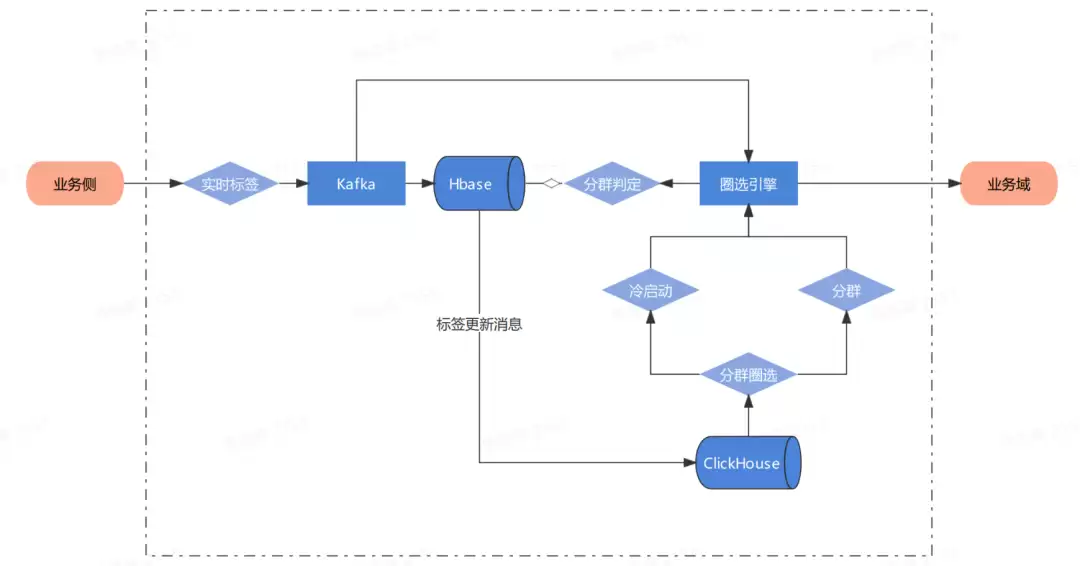
更多技术交流、求职机会、试用福利,欢迎关注字节跳动数据平台微信公众号,回复【1】进入官方交流群相信大家都对大名鼎鼎的ClickHouse有一定的了解,它强大的数据分析性能让人印象深刻。但在字节大量生产使用中,发现了ClickHouse依然存在了一定的限制。例如:缺少完整的upsert和delete操
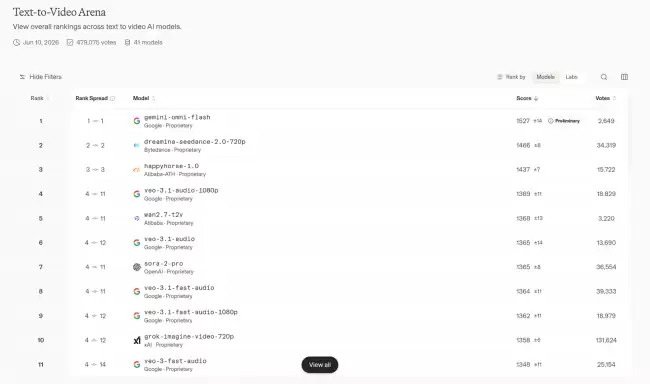
DeepMind的GeminiOmniFlash模型以1404Elo登顶VideoArena盲测榜,领先字节Seedance2.0Mini达101Elo,较自家Veo提升7位。盲测基于用户真实投票,谷歌在视频生成领域实现显著突破。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



