

阿里AMAP团队的AI提速新招:"动态换挡"让大模型推理快4.2倍
阿里AMAP团队提出BlockPilot系统,动态调整推测解码的块大小,使大模型推理加速最高达4.2倍。在Qwen3-4B模型上,平均验收长度提升至6.59,优于固定块大小方案,有效提升了推理效率。
说到提升大语言模型推理速度这件事,有一个长期被忽略的细节:每次你向AI助手提问,背后的服务器并不是在“查询”答案,而是在“一个字一个字地造”答案。你得等它打完一个字,才能继续猜下一个字该写什么。这种逐字生成的技术叫“自回归解码”,说白了,就像打字速度成了大模型的瓶颈。
为了绕开这个瓶颈,研究人员想出了一个策略——“推测解码”。它的本质是一条流水线:先让一个轻巧的小模型(草稿模型)快速猜出一串可能的后续字符,再交给精准但缓慢的大模型(目标模型)一次性判断这串猜测是否靠谱。猜对了,全盘采纳;猜错了,从出错的地方截断。大模型不用再一个字一个字的去核对,而是一次核对好几个字,速度自然提上去。
在这条“猜题+批改”的路径上,近几年出现了一种更激进的变体:草稿模型不逐字猜,而是一次性“块”着猜,也就是所谓的“块级推测解码”。其中性能最强的方案叫做DFlash,它通过将大模型的内部状态注入到草稿模型中,大幅提升了猜题质量,一度是该领域的天花板。
但阿里巴巴AMAP机器学习团队在深入研究中发现,DFlash乃至所有类似方法,在推理时都有一个共同的盲点:每次猜多少个字——即“块大小”——是固定不变的,直接沿用训练时的设置。这就像出租车司机在高速上用一个挡位没问题,但到了山路,还硬着头皮用同样挡位,结果只能是乘客颠簸、油耗飙升。
他们的核心贡献就是给这个问题找到了一个优雅的解:开发了一套叫BlockPilot的系统,让AI在推理时可以根据每个不同的输入,自动挑选此时最合适的“挡位”(块大小),在“猜得多”和“猜得准”之间找到最佳平衡。最终,在Qwen3-4B模型上,实现了高达4.20倍的推理加速。
一、为什么“固定挡位”是个问题
继续拿出租车司机打比方。不同问题的难度差异很大:问“1加1等于几”,答案几乎是百分百确定的,草稿模型可以大胆地一次猜出一长串,而且大概率全对。但如果让模型“写一首关于秋天的诗”,接下来的走向有无数可能,猜一大片反而容易猜错,最终大模型只能接受很短的一段,大量预测作废。
为了验证这个直觉,团队做了一个系统性实验。他们拿出GSM8K(数学题)、MT-Bench(对话)、AIME24(竞赛数学)、MBPP(编程)、Alpaca(指令跟随)等多个代表性数据集,对每道题分别尝试不同大小的“块”,并记录下哪种块大小能让“被接受的平均字数”(即验收长度τ)最高。这个最优块大小,就是他们眼中每道题的最优“挡位”,记作B*。
统计结果相当有说服力。在Alpaca数据集上,高达94%的样本的最佳块大小并不等于训练时固定使用的默认值B;在GSM8K上,这个比例也有66%。换句话说,大多数情况下,用固定的块大小从来都不是最优解,只是之前没人注意到,更没人想着去改变它。
这就像去超市购物,收银员每次都硬要塞给你同一个大小的袋子——有时候东西太少,袋子浪费;有时候东西太多,硬撑破袋子。真正聪明的做法,是根据你买了多少东西,选一个最合适的袋子。
二、“挡位”虽然变,但变化有规律
发现问题是第一步,接下来的难题是:既然最优块大小因样本而异,总不能在推理时穷举所有可能的块大小去测试吧?那计算量只会比原本推理多出几十倍,完全不现实。
数据给出了一个令人振奋的规律:虽然不同样本的最优块大小各有不同,但它们高度集中在训练时默认块大小B的附近,呈现出清晰的“局部性”结构。具体来说,对于几乎所有样本,最优块大小都落在[B-3, B+3]这个仅有7个数字的小区间里。超出这个范围后,验收长度会急剧下降,极端块大小几乎从来都不是最优解。
从分布形状看,最优块大小有两种典型模式:一种是以B为峰值的单峰分布,中间高两侧低;另一种是以B为中心的对称双峰分布,像是两个相邻的小山包,但都紧挨着B。无论哪种情况,最优值都乖乖待在B附近,很少“离家出走”。
这个发现的意义在于:它把一个原本看似无边无际的搜索问题,压缩成了一个极小、结构清晰的分类问题。这就好比找一把丢失的钥匙,一开始以为可能遍布全城,后来发现它99%的概率就在你家的三个房间里——问题瞬间变得简单。
三、用“预感”来选挡位:BlockPilot的核心思路
既然问题已经转化为一个在7个候选值中选最优的分类任务,下一步是:依据什么来做选择?
团队给出了一个精巧的答案。在大语言模型的工作流程里,有一个自然发生的环节叫“预填充”:当你把问题输进去,模型会先从头到尾读一遍,形成对输入的全面理解,并预测出下一个最可能出现的词的概率分布。这一步是每个推理都必须的,不需要额外付出代价。
关键在于:这个“最后一个位置的预测概率分布”包含着丰富信息。由于模型通过注意力机制从头浏览了整个问题,这个概率分布实际上是对整个问题的一种浓缩。如果这道题很有规律、答案确定,概率分布就会非常集中(一个或几个词的概率特别高);如果开放性很强、走向很多,概率分布就会很分散(很多词的概率差不多)。
这种“集中”还是“分散”的性质,恰巧能预判:这道题适合大块猜(集中则预测稳定,可以大胆),还是应该保守小块猜(分散则不确定性高,猜多了容易错)。
基于这个思路,BlockPilot的设计分为三步。首先,模型在完成预填充后,直接提取最后一个位置的完整预测概率分布,把它作为当前这道题的“状态描述”。第二步,把这个概率分布输入一个极其轻量的小型神经网络——一个只有两层的多层感知机(可简单理解为“打分器”),让它从7个候选块大小中挑出一个预计验收长度最高的选项。第三步,用选出的块大小驱动后续整个推理过程,包括草稿生成和大模型验证。整个预测只发生一次,之后块大小就固定下来,不再反复调整。
整个过程就像经验老道的厨师在开灶前先闻一下食材的气味:闻到浓郁规律的香气,就知道菜简单,可以多备食材;闻到复杂多变的气味,就知道难度高,要谨慎分批处理。整个判断只需要一瞬间,不影响正式烹饪。
值得一提的是,团队也尝试过只取概率分布里排名最高的前几个值(Top-k)作为输入,以此减少信息量。结果很糟糕:训练时准确率达到80%,但在新测试数据上只有10%,明显过拟合。这说明完整的概率分布带来的信息远比前几名重要——它保留了整个词表上的细微差异,这些差异对判断“当前生成的不确定性有多高”至关重要。
四、如何训练这个“打分器”
有了设计思路,下一步是训练数据。问题是:每道题的“最优块大小”并不是现成标注好的,需要从头计算。
团队采用了一种“穷举标注”方案。对训练集里每一道题,先跑一遍大模型的预填充,记录下最后位置的概率分布;然后分别用候选范围内的每一个块大小(即B-2、B-1、B、B+1、B+2,共五个值,对应k=2的设置)运行完整推测解码,记录每种块大小对应的平均验收长度;最后把验收长度最高的那个块大小标为此题的“正确答案”。
这样构造出的数据集,每条都是(概率分布,最优块大小)的配对,格式清晰,可直接用来训练分类器。五种块大小之间的测试相互独立,可以并行运行,大大缩短了数据构造时间。训练集来自ShareGPT(多轮对话数据)、WSC(常识推理数据)、COPA(因果推理数据)等多个公开数据集,覆盖了对话、推理等多种场景。
训练本身非常简单:把数据集喂给那个两层的小网络,用标准的交叉熵损失(可以理解成“让模型对正确答案赋予更高分数”)反复调整参数,直到它能准确从概率分布预测最优块大小。训练跑100个轮次,使用Adam优化器,学习率设为0.00001,网络隐藏层宽度设为2048。
五、实验结果:四款大模型全面提速
团队在四款代表性大模型上做了系统测试:Qwen3-4B、Qwen3-8B、Llama-3.1-8B-Instruct以及Qwen3-Coder-30B-A3B(一个300亿参数的代码专用模型)。评测涉及数学推理(GSM8K、MATH-500、AIME24)、代码生成(HumanEval、MBPP、SWE-Bench)和对话生成(MT-Bench)三大类任务,并分别在确定性解码(温度T=0)和随机采样(温度T=1)两种设置下进行测试。
以Qwen3-4B为例,在T=0设置下,BlockPilot平均加速比达到4.17倍,平均验收长度为6.59个字符;在T=1的随机采样下,加速比进一步达到4.20倍,平均验收长度为5.92。相比之下,同等设置下最强的固定块大小方案DFlash(16)最佳表现只有3.99倍(T=0)和3.80倍(T=1)。具体到单个数据集,BlockPilot在GSM8K上以4.76倍领先,在MATH-500上达到5.45倍,在HumanEval上达到4.74倍,全面超越所有对手。
Qwen3-8B的结果同样亮眼。T=0时平均加速比4.66倍,T=1时达到3.94倍,同样是所有方法中的最优。值得关注的是,在某些数据集上提升幅度尤为显著——在AIME24竞赛数学上,BlockPilot以6.16倍的加速比远超DFlash(16)的5.57倍。
在Llama-3.1-8B-Instruct上,BlockPilot在T=0时平均加速3.25倍,T=1时平均加速2.40倍,两项均优于所有DFlash固定块大小变体。特别是在T=1、AIME24这个最难的组合下,标准DFlash方法甚至出现了慢于自回归基准的情况(加速比低于1),而BlockPilot依然维持了1.48倍正向加速,自适应选择在困难场景下的鲁棒性明显更强。
在Qwen3-Coder-30B-A3B这个大体量代码模型上,BlockPilot在T=0时平均加速4.12倍,T=1时达到3.95倍,同样是最优表现。特别是在HumanEval和MBPP这两个代码生成基准上,验收长度分别达到9.07和7.80,远超其他方法。
一个普遍观察是:DFlash(32)(块大小固定为32,远大于训练时的块大小)的表现往往不如DFlash(16),说明块大小并非越大越好。太大的块虽然“野心勃勃”一次猜很多,但猜对比例急剧下降,最终吞吐量反而降低。BlockPilot通过自适应选择,正好能规避这种“贪多嚼不烂”的问题。
六、这个小网络到底有多轻巧
一个自然的问题是:为这套推理系统增加一个额外的“打分器”,会不会显著增加计算开销?
数据给出了明确回答。团队对比了预测器和主干模型的资源占用:Qwen3-4B的推理延迟约183毫秒,而块大小预测器的延迟仅为7.34毫秒,占比约4%。在内存方面,Qwen3-4B需要约8.62GB显存,预测器只额外占用0.62GB。预测器的参数量仅约0.32亿,远小于主干模型的数十亿参数。
更重要的是,这个预测只发生一次——预填充结束后跑一下,之后整个推理过程中块大小不再变化。这7毫秒的开销被整个推理过程摊薄,对总体速度的影响微乎其微。从绝对收益看,这7毫秒换来平均验收长度从6.31提升到6.59(T=0下的Qwen3-4B),加速比从3.99倍提升到4.17倍,这笔账相当划算。
七、细节决定成败:消融实验揭示的设计智慧
为了弄清BlockPilot里每个设计决策的重要性,团队做了一系列“如果换一种做法会怎样”的对比实验,这在学术界叫消融研究。
关于网络结构的选择,团队发现,将隐藏层宽度从1024扩大到2048,性能有明显提升;但继续扩大到4096几乎没有额外收益,说明2048已足够捕捉从概率分布到最优块大小的映射关系。在网络深度方面,两层比一层稍好,三层没有进一步改善,有些数据集上还略有下降——说明这个分类任务并不复杂,不需要深层网络来“过度思考”。
关于候选范围k的选择,团队测试了k=1、k=2、k=3三种设置。k=1时搜索范围太窄,遗漏了部分本可选的更优块大小;k=2时性能最好,在GSM8K和HumanEval上表现最优;k=3时性能反而下滑,因为候选集变大,分类难度增加,预测准确率下降。因此最终选择k=2,对应候选集为{B-2, B-1, B, B+1, B+2},共5个选项。
关于输入如何处理,团队对比了三种方案:直接使用原始概率分布、对概率做归一化处理、以及对概率做softmax变换。结果显示,直接使用原始概率分布效果最好,归一化和softmax都会使性能有不同程度的下降。这说明原始分布中绝对概率值的大小本身就是有效信息——如果最高概率是0.9,说明模型非常确定;如果只有0.3,则说明模型在多个候选间犹豫不决。归一化和softmax会抹去这种绝对尺度信息,导致判断依据不够充分。
八、理论上为什么这套方案是合理的
团队不仅做了实验,还从理论上论证了BlockPilot的合理性。这部分内容相对抽象,但可以用直观方式来理解。
首先,他们从“前缀存活过程”的角度分析验收长度。可以把大模型验证草稿token的过程,想象成一排待审查的士兵一个个通过长官检阅。每位士兵被淘汰的概率不同,一旦某位被淘汰,后面的士兵全部不再考虑。平均能通过多少士兵,取决于每位士兵各自通过概率的连乘积——这就是前缀存活概率。
接下来,团队分析块大小如何影响这个连乘结果。他们指出,每个位置的接受概率可分解为两部分:一部分反映这道题本身的“可预测性”(记作γ),另一部分反映当前块大小与训练时块大小之间的“匹配程度”(记作r(b,B))。可预测性γ因题而异:数学计算题答案确定,γ高;开放性对话题答案发散,γ低。匹配程度r(b,B)被建模为一个以B为中心的高斯衰减函数:块大小越靠近训练时的B,r越接近1;偏离越远,r越接近0。
把这两部分代入验收长度公式,会得到一个关键结论:最优块大小一定集中在训练块大小B附近,而具体集中在哪里,则取决于γ的高低。这从数学上证明了两件事:其一,最优块大小确实具有局部性(所以才能限制到7个候选值里);其二,不同样本γ不同,所以最优块大小确实因样本而异,固定块大小策略必然次优。
另外,团队还分析了“万一预测错了怎么办”的问题。他们推导出,验收长度的损失与预测出的块大小和真实最优块大小的距离成正比。这意味着哪怕没完全猜对,只要猜到的块大小与最优值相差不远,损失就会很小。结合候选范围只有5个值的现实,进一步说明一个轻量级预测器完全足够胜任,不需要大型专门模型。
归根结底,BlockPilot做的事情并不复杂:它发现了一个长期被忽视的问题(推测解码的块大小不该固定),找到了一个规律(最优值集中在训练块大小附近),设计了一个简单有效的解法(用预填充后的概率分布训练一个轻量分类器),并用大量实验证明了这套方案在多个模型和多种任务上的有效性。
对普通用户而言,这项研究意味着:未来使用基于大模型的应用——无论是AI聊天助手、代码补全工具还是数学解题器——响应速度可能比现在快三到四倍,而输出内容质量丝毫无损(因为最终生成仍由大模型把关,推测解码本质上是无损加速)。这在需要实时互动的场景,如代码开发辅助或在线教学,体验提升会相当明显。
当然,这项研究也有一个坦诚指出的局限性:对特别大的模型(如300亿参数级别),构建训练数据时需对每个样本跑5次完整推测解码(对应5个候选块大小),每次约5秒,加起来约25秒一个样本,数据构建阶段的计算成本不算低廉。但团队也指出,这个开销只在离线数据准备阶段发生一次,训练和推理阶段不受影响,未来还可通过启发式剪枝、早停等策略进一步优化。
对于那些对这个方向感兴趣的读者,可以进一步思考一个问题:既然块大小可以自适应调整,那么草稿生成的步数(即扩散步骤数)是否同样应该自适应?或者验证策略本身是否也有优化空间?这些问题或许会是这个领域下一步值得探索的方向。完整论文可通过arXiv编号2606.31315查阅。
Q&A
Q1:BlockPilot是用来做什么的,和普通大模型推理有什么区别?
A:BlockPilot是一套专门用于加速大语言模型推理的系统,建立在“推测解码”技术之上。普通大模型推理每次只能生成一个字,推测解码会用一个小模型批量猜测多个字,再让大模型一次性检查,从而加快速度。BlockPilot的创新在于,它会根据每道题的具体特点,自动决定每次猜多少个字最合适,而不是像传统方法那样固定数量,从而在Qwen3-4B上实现了4.20倍加速。
Q2:BlockPilot自适应选择块大小的依据是什么?
A:BlockPilot在大模型读完用户输入后,会提取出模型对下一个词的预测概率分布,这个分布能反映当前任务有多“确定”。确定性高的任务(如数学计算)概率集中,适合一次猜更多字;开放性强的任务(如写诗)概率分散,适合保守一次猜少一些。BlockPilot用一个两层的小型神经网络,把概率分布输入进去,从5个候选块大小中选出预计效果最好的那个,整个过程只需约7毫秒。
Q3:BlockPilot会不会影响大模型输出的质量或准确性?
A:不会。BlockPilot只改变了草稿生成策略,最终输出依然经过大模型完整验证,不符合大模型判断的草稿字符会被截断丢弃,只有大模型认可的部分才会保留。因此,从用户角度看,最终生成的内容与原来的大模型完全一致,质量和准确性无任何损失,加速是完全无损的。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
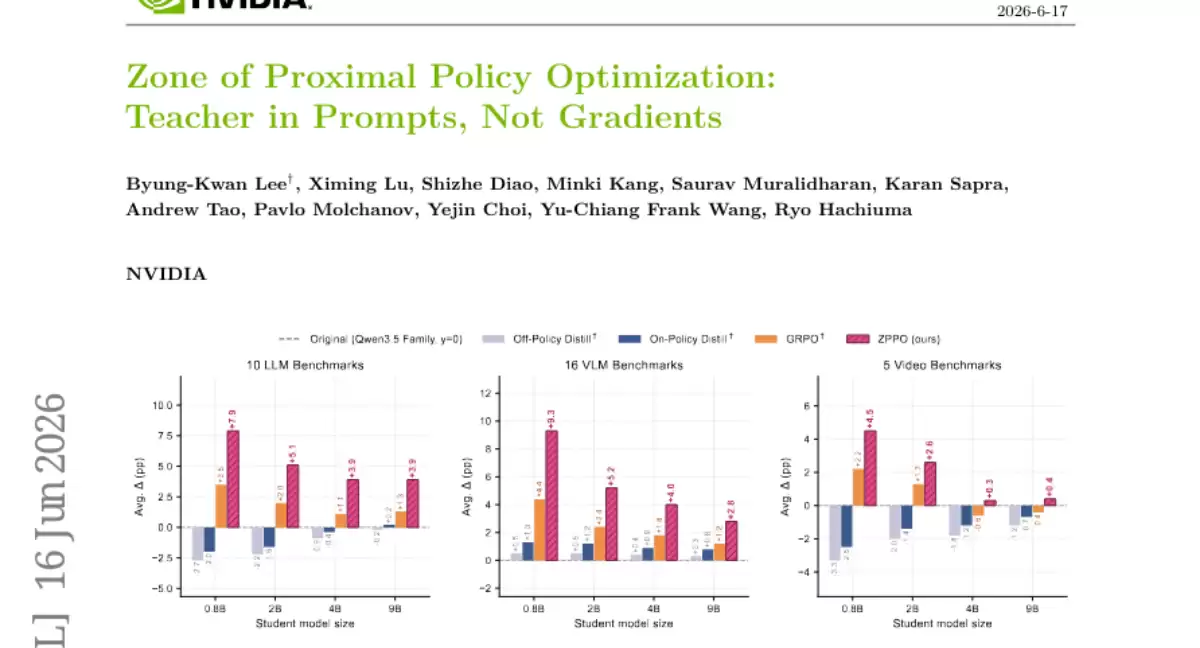
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
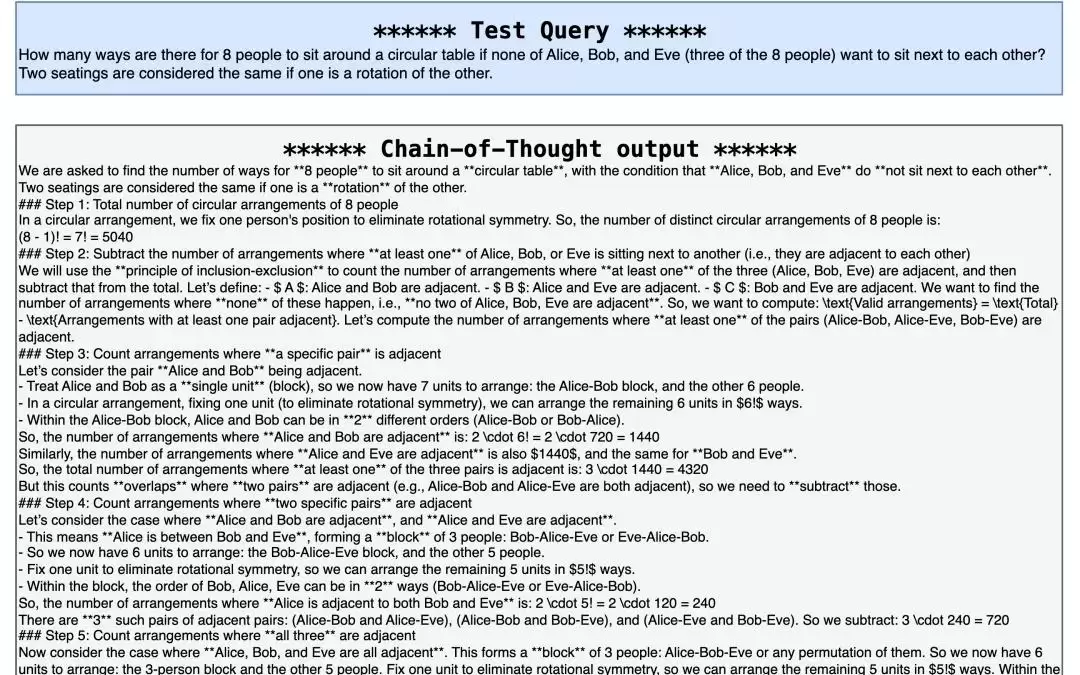
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
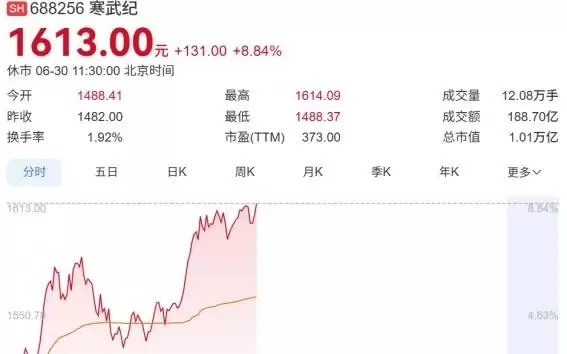
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



