

天大与上海AI实验室:让AI同时"读懂"和"模拟"人类大脑的视觉思维
天津大学与上海人工智能实验室等提出BrainJanus系统,将大脑信号、图像和文字统一为相同词元空间,通过自回归Transformer实现四种跨模态任务双向翻译,在大脑解码任务中全面领先,并揭示了现有编码评估体系的系统性漏洞。
先说一个让人细思极恐的事实:当你看到一只长颈鹿时,你的大脑在瞬间就完成了一场复杂的“翻译”——那个橙黄色的身躯、斑驳的花纹、细长的脖子,这些视觉信号会同时激活语言区域,自动跳出“长颈鹿”这个词,甚至还能唤起记忆里动物园的气味。你的视觉皮层和语言区域在这一刻协同工作,把来自眼睛的光信号变成一套完整的、多层次的内心体验。神经科学家把这种能力叫做“多模态整合”,说白了,大脑天生就是一个跨越图像、语言、情绪的统一处理平台。
这个看似理所当然的过程,却是人工智能研究者长期头疼的难题。一方面,科学家想搞清楚:当你看一张图片时,大脑里的神经信号长什么样?这叫“大脑编码”,相当于破译密码,要找出视觉刺激如何变成神经活动。另一方面,研究者还想反向操作:拿到一段脑部扫描数据,能不能还原出当时那个人看到了什么?这叫“大脑解码”,好比从密码倒推回原始信息。
问题在于,过去的研究往往是各管各的:编码和解码用完全不同的模型和工具,就像用两套不相通的语言来描述同一个故事。更尴尬的是,这些系统大多只懂得把大脑信号与图像对齐,却忽略了一个关键事实:大脑本身就是一个语言和视觉都懂的“双语者”。
正是为了填补这个裂缝,天津大学人工智能学院、上海人工智能实验室联合香港中文大学的研究团队,在ICML 2026上提出了一个名为BrainJanus的系统——一个能在大脑、图像、语言三种“语言”之间自由切换、双向翻译的统一模型。这是这个方向上第一个真正做到“一个模型,四种任务”的尝试,覆盖了从图像到大脑、从文字到大脑、从大脑还原图像、以及从大脑还原文字描述这四个方向,全部放在同一套框架里完成。
一、为什么以前的方法总是“各说各话”
要理解BrainJanus为什么重要,得先看看之前的研究都在做什么,以及它们为什么总让人觉得差了点意思。
过去十年,神经科学和人工智能的交叉研究确实干出了不少成果。研究者利用功能性磁共振成像记录人在看图片时的神经响应,然后训练算法去还原这些图片——确实能重建出一只猫或一辆汽车的大致样貌。然而这些研究存在一个深层的结构性问题:它们几乎无一例外地把大脑信号和CLIP的视觉特征对齐。CLIP是OpenAI开发的图文匹配模型,擅长把图像和文字放在同一个空间里比较相似度。把大脑信号和CLIP的视觉输出对齐,听起来很合理,但这样做意味着模型只懂得把大脑信号解读为“一种视觉特征”,完全抛弃了大脑信号中天然包含的语言和语义层次信息。
神经科学早就证明了,人类大脑在处理视觉刺激时会同时激活语言相关的皮层区域,语义地图铺满整个大脑皮层——从处理低级视觉特征的早期视皮层,一直延伸到处理高层抽象概念的区域。换句话说,大脑本来就是多语言的,而过去的模型硬是把它变成了只懂视觉的单语者。再加上“大脑编码”和“大脑解码”这两类任务在以往研究中几乎是完全割裂的,各自有各自的模型、训练方式和评估体系,就像一座城市里有两套完全不互通的地铁系统,中间没有换乘站。更糟的是,由于从大脑信号中解读出的语义内容不够丰富,这些系统不得不依赖大量外部工具来弥补,比如冻结的预训练CLIP模型、Stable Diffusion这样的图像生成系统、LLaMA或GIT这样的大型语言模型。系统本身的“大脑理解”能力其实很有限,生成的结果更多来自外部工具的“脑补”,而非真正的神经信号解读。
二、BrainJanus的核心思路:建一个三语通用的“翻译站”
研究团队选择了一个简洁而优雅的解决方案,核心思路可以用一个类比来理解。把大脑信号、图像和文字分别看作三种不同的“方言”。过去的研究是硬生生地在方言之间直接翻译,比如从闽南语直接翻成粤语,但因为两者之间差异太大,翻译质量参差不齐。BrainJanus的做法是:先把三种方言都翻译成同一种“普通话”,然后在这个统一的中间语言里自由操作,最后再翻译回任意一种方言。
这个“普通话”在技术上叫做Omni空间——一个所有模态共享的统一表示空间。为了让大脑信号也能进入这个空间,研究团队专门设计了一个统一大脑分词器,从零开始训练,专门负责把连续的神经活动信号转化为离散的“词元”,就像把一段连续的音频信号转录成一个个独立的文字一样。视觉信号和文字信号也有各自对应的分词器,把图片和句子同样转化为词元序列。这样一来,三种来源的信息都变成了同一种格式的“积木块”,可以自由拼接和处理。
大脑分词器的技术基础是VQ-VAE,这是一种专门用于压缩和离散化连续信号的神经网络结构。打个比方,它做的事情类似于把一首完整的交响乐转化为乐谱——乐谱会丢失一些细节,比如演奏者的轻微颤音,但保留了所有核心的音乐结构和语义信息,而且乐谱这种格式比录音更方便存储、比较和处理。研究团队使用了128个“音符”(码本大小为128),压缩比为128,嵌入维度为32,在来自8个受试者的fMRI数据上联合训练,让这个分词器能够跨不同人的大脑活动学习到通用的表示。
三、一个模型,四种任务:全向自回归架构
有了统一的词元空间,下一步就是建一个能够处理这些词元的模型。研究团队选择了大型语言模型最核心的技术:自回归Transformer,也就是GPT类模型的基本架构。
自回归模型的工作方式跟填词游戏很像。给你一段句子的前半部分,模型负责一个词一个词地预测接下来的内容,每次预测都基于已有的全部上下文。BrainJanus把这个逻辑推广到了多模态场景:无论输入是脑信号词元、图像词元还是文字词元,模型都把它们当作同一种“词”来处理,按照顺序一个接一个地生成后续内容。
这样的设计让模型天然地支持任意方向的跨模态生成。给模型一段脑信号词元序列,加上“接下来生成文字”的指令,模型就会输出对应的文字描述;换成“接下来生成图像”,模型就会输出图像词元,再经过视觉解码器还原成图片。反过来,把图像或文字词元作为输入,让模型预测脑信号词元,就实现了大脑编码。四个任务通过统一的自回归预测机制无缝切换,中间不需要任何额外的“转接器”或“适配器”。
四、大脑解码实验:从神经信号还原世界
研究团队在两个解码方向上都进行了系统性的定量和定性评估。
在大脑解码→文字方向,BrainJanus与三个代表性基线方法做了比较:MindEye2、UMBRAE和MindLLM。评估使用了从BLEU到CLIP得分等一整套标准指标。当使用原始COCO短描述作为参考标准时,BrainJanus在所有指标上全面领先,BLEU-1达到63.20,CLIP得分高达94.8%。
当切换到Qwen生成的详细描述作为参考标准时,差距变得更加悬殊。在这个更严苛的评测场景下,BrainJanus的BLEU-1为40.21,CLIP得分高达96.2%,而其他三个模型的得分则大幅滑落——MindEye2的BLEU-1仅有4.32。这个差距充分说明BrainJanus生成的文字描述更接近详细准确的语义内容,而非简单的模式匹配。
从具体案例来看更直观。比如对于一张画面是“两匹棕色马在绿色草地上并排站立,天空有白云”的图片,BrainJanus生成的描述是:“两匹棕色的马在草地上面对面,其中一匹的头靠近另一匹的颈部,在明亮的天空下”,准确捕捉到了马的颜色、数量、姿态和背景;而MindEye2只生成了“几头奶牛站在草地上”,MindLLM则输出了“一男一女站在长颈鹿旁边”——错误明显。
在大脑解码→图像方向,BrainJanus是唯一参与比较的自回归模型,其余方法全部基于扩散模型。它在高层语义指标上的表现相当出色:CLIP相似度达到94.4%,Inception得分为94.7%,这些指标均达到或超过了主流扩散模型的水平。值得注意的是,它在低层像素保真度指标上略低于扩散模型,这是自回归生成方式本身的特点——它更擅长捕捉语义结构而非精确的像素细节,就像一个优秀的故事转述者,能准确描述情节但不追求一字不差。
五、大脑编码实验:从图像生成“假大脑信号”
大脑编码方向——也就是给定一张图片,让模型预测出对应的脑活动信号——在这个领域历史上一直是个更难评估的问题。研究团队在这里做了一件对整个领域非常有价值的工作:他们系统地揭示了现有评估体系的严重漏洞。
目前该领域有两种主流评估方式。第一种是体素级指标,直接比较合成的fMRI信号与真实记录的fMRI信号在每个体素上的相关性。研究团队分析了8名受试者的数据后确认,即使对同一名受试者、在不同试次下观看同一张图片,其fMRI响应之间也存在相当大的随机性变异,这意味着任何编码模型的性能都被这个生物噪声天花板限制住了。
第二种评估方式是语义级指标:先用编码模型从图像生成合成fMRI,再把这个合成fMRI输入解码模型还原成图像,最后衡量还原图像与原始图像的相似度。然而研究团队发现,这套评估体系存在一个几乎致命的漏洞,并专门设计了一个“填充攻击”基线来证明这一点。
“填充攻击”的做法极其简单:不学习任何真实的生物映射关系,直接把图像的VQ-VAE视觉嵌入向量用零值填充到与体素数量相同的维度,当作“合成fMRI”输出。解码器端再做反操作,从这个“假fMRI”中提取出视觉嵌入,还原成图像。这个方法本质上把大脑的体素空间当成了一个稀疏的存储介质,完全不学习任何神经科学规律。
结果令人咋舌:这个毫无生物意义的攻击基线在所有评估指标上都取得了接近满分的成绩——PixCorr达到0.919,CLIP得分达到100%。相比之下,真正学习了生物映射的方法得分远远低于这个“作弊”基线。这个结果说明,重建图像质量指标根本无法区分“真正的神经合成”和“信息泄露”,整套语义级评估体系存在系统性缺陷。
正是基于这个认识,BrainJanus在编码任务的训练中完全避免了与预训练视觉嵌入的直接对齐,仅使用交叉熵损失来训练编码任务,强迫模型真正学习神经模式而非简单的特征存储。在这个更严格的公平评估框架下,BrainJanus的Inception得分为72.8%,CLIP图像得分为75.3%,全面超越线性回归基线和Transformer编码基线。
六、研究的局限与未来的方向
研究团队对自身工作的局限性保持了坦诚。目前BrainJanus只处理视觉皮层的fMRI数据,而非全脑活动,这意味着它捕捉到的神经活动只是大脑全部信息处理的一个局部切片。对于更高层次的认知过程、情绪反应、听觉信息处理等,目前这套框架还无法涵盖。
模型对强大生成先验的依赖也可能带来一定风险:生成的图像有时会“过度脑补”,优先保证视觉上的美观和合理性,而非严格忠实于原始神经信号所包含的信息。这就像一个高度熟练的翻译员,有时会把说话人的意思翻译得比原话更加流畅优美,但代价是可能引入了原话中并不存在的内容。
计算资源的需求和对不同神经模态、不同受试者群体的泛化能力,也是这个框架未来需要系统性验证的课题。
说到底,BrainJanus做的事情放在更大的图景里看,是在尝试建立一座横跨神经科学与人工智能的真正意义上的桥梁。过去的研究更像是在两岸各自建造一半桥,但桥面并不相接;而BrainJanus在两岸之间铺通了一条共同的通道,让信息能够双向流动。这意味着什么?脑机接口领域或许能从中受益——通过更准确地合成特定视觉内容对应的fMRI模式,可以帮助开发用于辅助视觉受损患者的神经假肢。认知神经科学家也可以用这类模型来探索大脑视觉处理的内在机制。而将大脑信号、语言和视觉统一到同一个自回归框架的尝试本身,也为未来更广义的“全模态智能”提供了一种可行的方向。
回到那只让大脑同时产生视觉图像和“长颈鹿”这个词的动物。BrainJanus现在能做到的,是接收你看到它时的脑信号,然后同时输出一张长颈鹿的图片和一段文字描述,也能反过来,从一张长颈鹿图片或一段文字出发,预测你的大脑会产生怎样的活动模式。这距离真正“读懂大脑”还有很长的路,但这是迄今为止走得最为整合、最为统一的一步。
Q&A
Q1:BrainJanus和之前的大脑解码模型比,最大的区别是什么?
A:BrainJanus最大的区别在于“统一性”。之前的模型通常只做一件事,要么从脑信号还原图像,要么生成文字描述,而且都高度依赖CLIP这类外部视觉模型作为对齐目标。BrainJanus把图像、文字、脑信号三种模态放进同一个词元空间,用一个自回归模型同时处理四种任务。
Q2:fMRI大脑编码的语义级评估为什么容易被“作弊”?
A:研究团队发现,现有的语义级评估是用“合成fMRI→还原图像”的质量来判断编码好不好,但这套流程根本无法防止一种极端的信息泄露:把视觉嵌入向量直接填零补位塞进体素空间,解码时再把它取出来。这个完全不学习任何神经规律的“填充攻击”在所有指标上能得到接近满分,说明高重建质量既可以来自真实的神经映射,也可以来自简单的信息搬运,两者在现有指标上无法区分。
Q3:BrainJanus在大脑信号编码任务上为什么选择用交叉熵损失而不对齐视觉特征?
A:正是因为发现了上述“填充攻击”漏洞。如果训练时直接让合成fMRI与预训练CLIP或VQ-VAE的视觉嵌入对齐,模型很可能走捷径,把视觉特征信息编码进体素空间而非真正学习生物映射。改用交叉熵损失直接预测脑信号词元,迫使模型从真实的神经活动模式中学习,虽然得分看起来低一些,但结果更具有真实的神经科学意义。
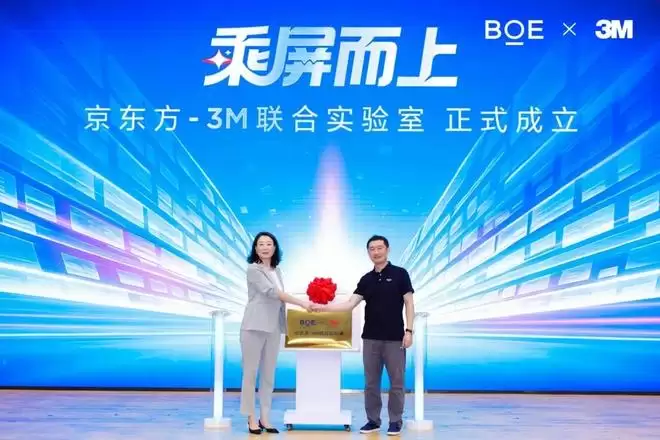
8月21日消息,以“乘屏而上”为主题的BOE(京东方)-3M联合实验室发布会在京东方技术创新中心举办,双方共建的联合实验室正式揭牌启用。该实验室将聚焦光学膜材、光学透明胶、结构胶及前沿创新,围绕LCD、OLED、MLED领域的光效提升、折叠技术与超窄边框工艺等核心课题,开展深度协同攻关,推动包括柔性
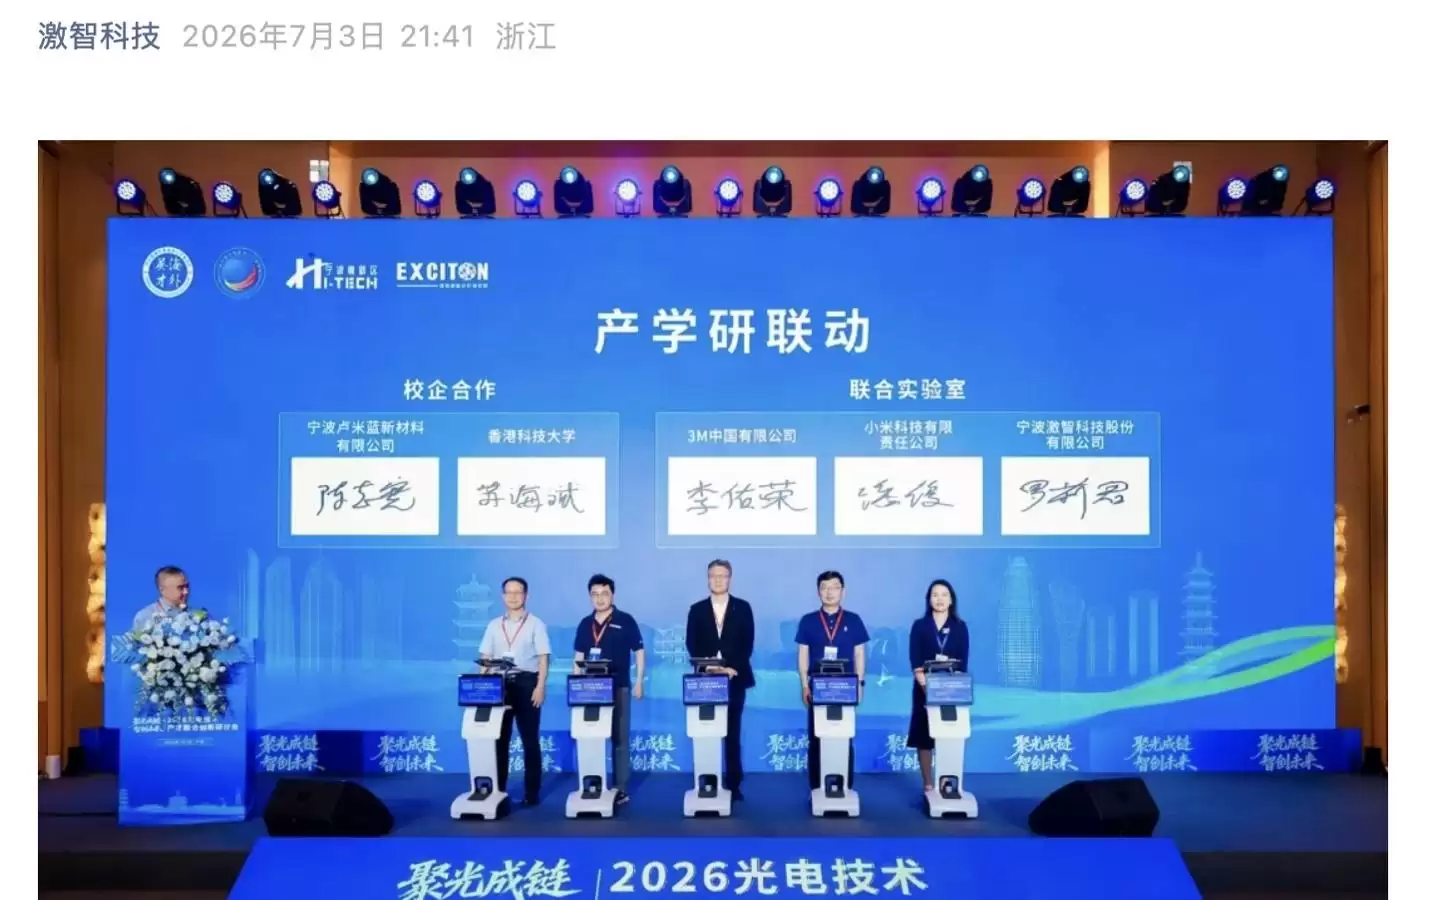
小米、3M中国与激智科技在宁波宣布共建新型显示联合实验室,三方将整合光学材料、终端电子与光学膜研发制造优势,重点推进新一代光学膜研发,提升电视亮度与辉度,打通上游原材料至下游终端创新链条,攻克微显示等关键技术。
8 月 14 日消息,荣耀MagicOS 今日宣布,荣耀已与抖音正式成立基础体验联合实验室,接下来双方将围绕用户基础体验、智慧互联以及 AI 创新等方向,进一步展开深度合作。眼下,双方合作到底会落到哪些具体层面,还没有更明确的信息。不过有一个时间点值得留意:早在 2024 年 9 月,抖音 App
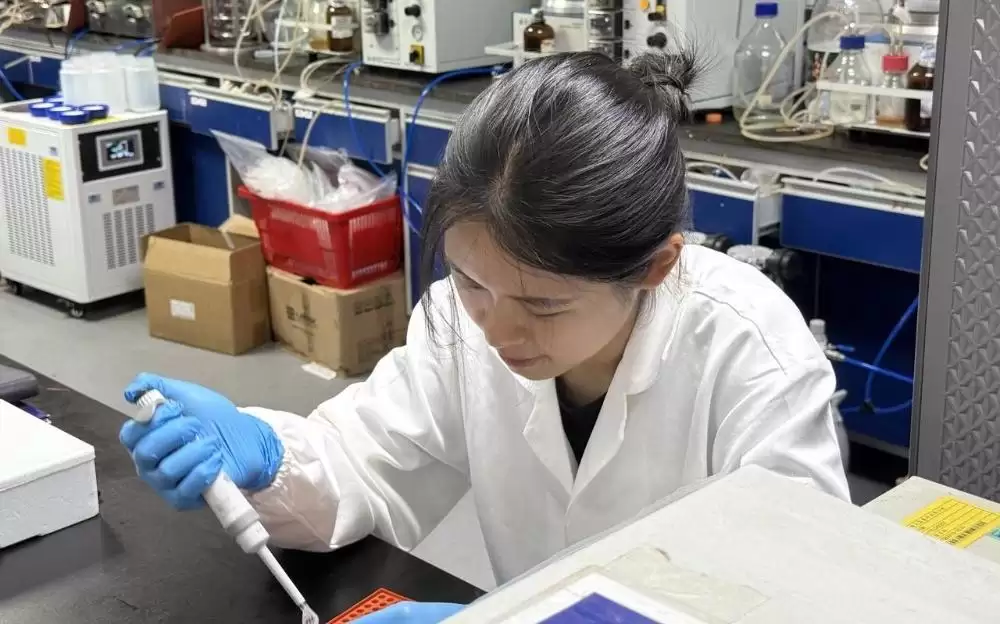
当镜头 聚焦操作台与实验仪器,一场名为 LabTour (奇妙实验室漫游)的线上实验室参观热潮,正在短视频平台悄然兴起。 近日,抖音热搜话题# 引发全网热议。中国科学院天津工业生物技术研究所博士生“C-”(邱靖)凭借通俗幽默、极具画面感的方式拆解抽象生物实验,让晦涩的课本知识、前沿的科研日常走进大众
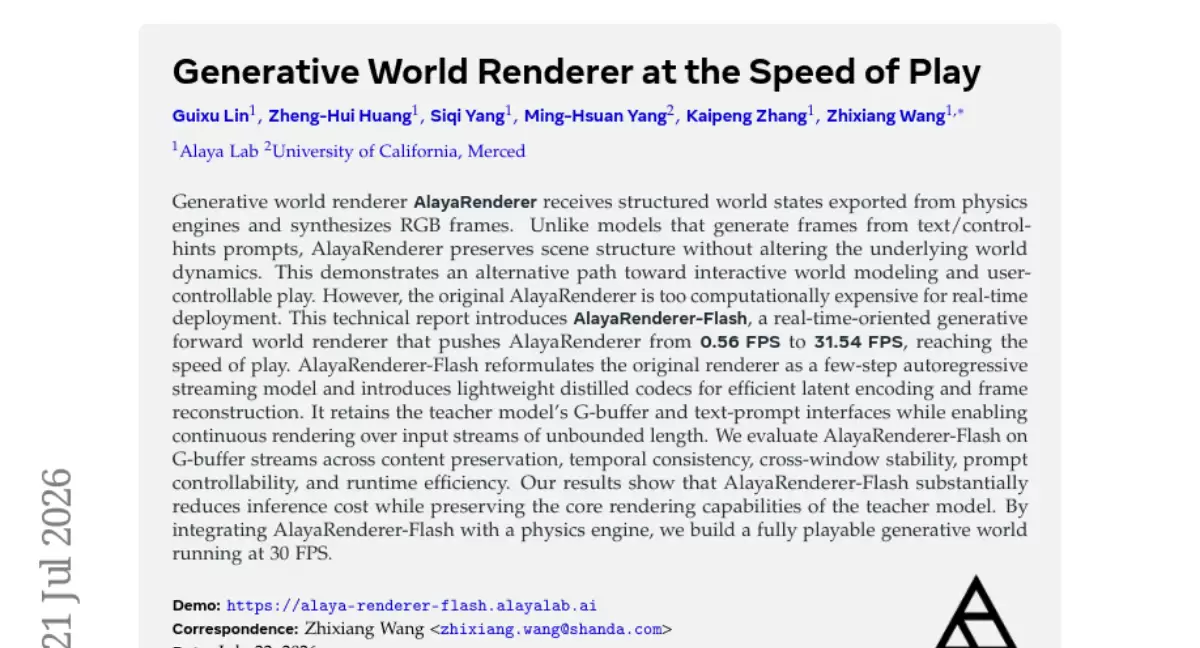
阿拉雅实验室联合加州大学默塞德分校开发了AlayaRenderer-Flash,通过自回归流式生成、4步蒸馏与轻量级编解码器三项改进,将AI游戏画面渲染从0.56帧/秒提升至31.54帧/秒,在单张H200显卡上实现30帧实时可玩,并支持游戏过程中实时切换文字提示改变视觉风格。
协创数据与北京大学共建联合实验室,聚焦AI基础模型、创新药物分子设计及绿色生物制造,推动BioViMo智能云平台落地,整合算力与交叉学科优势,打通AI药物研发从模型到产业的全链条闭环。
安谱实验与诺瑞共建超5600平方米智能实验室,融合AI与物联网,精准控制温湿度,破解标准物质环境控制难题,降低量值不确定度15%,年产能翻倍。未来三年将高端CRM标物品类扩至200种以上,助力半导体、生物医药等领域国产替代。
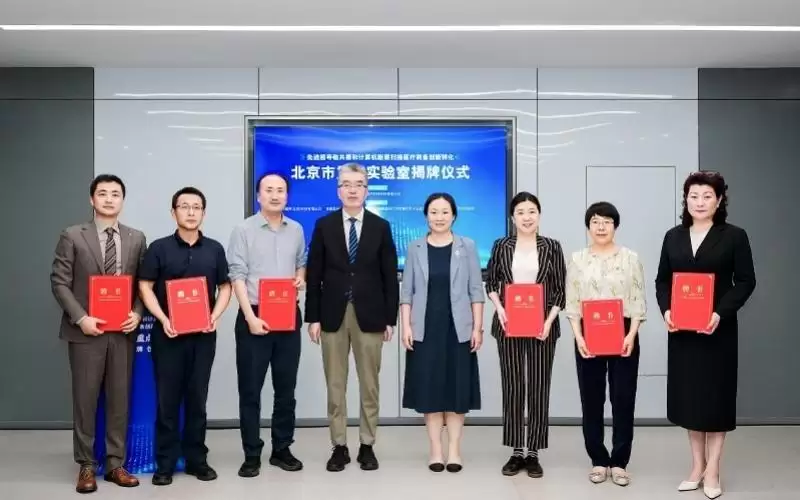
万东医疗牵头的北京市重点实验室揭牌,聚焦无液氦超导磁共振和超宽体超高速CT技术,突破无液氦磁体集成、探测器贴装等核心瓶颈,采用“产业龙头+科研院所+顶级临床”协同模式,114人科研队伍中硕博占比超八成。
郭彦良发表在《Science》上的那项工作,最初差点被当成一组废数据永远留在电脑回收站里。 2024年8月,他和一名博士生临时决定尝试一项实验。一个小时后,屏幕上出现了一些不符合预期的结果。博士生觉得没有意义,随手就把数据删掉了;但郭彦良觉得,异常本身值得追问,又把它从回收站里找了回来。 经过后续实
之江实验室位于杭州城西科创大走廊,创新氛围浓厚。“三体计算星座”已部署20个AI模型,新增卫星搭载具身智能模型。通过“总体部制”实现一箭十二星287天完成,借助“科学家工作坊”打造GeoGPT,服务全球145个国家和地区5.6万科研人员,推动人工智能基础模型助力全球科研。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



