

西伯利亚神经网络公司用小模型挑战大模型
西伯利亚神经网络公司研究团队在arXiv发布预印本,测试了17个小模型在俄语RAG问答系统中的表现。结果表明,Qwen3系列小模型在答案质量上接近GPT-5-mini,且可在普通电脑CPU运行。但CPU推理速度较慢,实际应用需在速度与质量间取舍。
这项由俄罗斯西伯利亚神经网络有限公司研究团队完成的工作,以预印本形式于2026年6月29日发布在arXiv平台,论文编号为arXiv:2606.30062v1。对技术细节感兴趣的朋友,可以直接通过这个编号去搜索完整论文。
一切都要从一个现实的困境说起
近几年,人工智能圈子里最流行的词是“大模型”——参数动辄几百亿、上千亿,运行起来需要专门的服务器机房和昂贵的显卡集群,光是电费就是一笔不小的开销。普通公司、医院、学校,甚至个人开发者,往往只能通过付费API接口“借用”这些巨无霸模型,把数据发送到别人的服务器上处理。
问题在于:很多场景根本不允许这样做。医院里的病历、律师事务所的案件资料、企业内部的会议记录,这些数据绝对不能随随便便传到外网。另一种场景是硬件条件受限——偏远地区的设备、工厂车间里的工控机、用户手机上的本地应用,根本没有足够的算力和内存来跑大模型。
正是在这样的现实需求下,“小语言模型”(Small Language Models,简称SLM)开始引起研究者的关注。相比动辄千亿参数的大模型,小模型的参数量在几百万到几十亿之间,可以直接在普通电脑的CPU上运行,不需要任何显卡,速度也相当快。西伯利亚神经网络公司的研究团队就做了一件很实在的事:他们把17个小模型放进一个真实的问答系统里跑了一遍,看看这些“小脑袋”到底能不能在实际工作中顶用。
一、RAG系统:给AI配一本随时可查的参考书
要理解这项研究,首先需要明白一个叫做“检索增强生成”(Retrieval-Augmented Generation,简称RAG)的技术框架。
可以用图书馆管理员来理解这个概念。假设你向一位管理员提问:“俄罗斯1812年拿破仑战争中,库图佐夫将军在哪场战役中撤退保全了军队?”一个纯靠“记忆”工作的AI,只能凭借训练时学到的知识回答,如果训练数据里没有相关内容,它就可能胡编乱造。而RAG系统的工作方式完全不同——它首先像图书馆管理员一样,跑到书库里快速检索出和问题最相关的几段文献,然后把这些文献原文摆在AI面前,让AI根据这些现成的参考资料来组织答案。
这套系统分成两个部分:检索模块负责“找书”,生成模块负责“根据找到的书回答问题”。检索模块通常用的是相对较小的嵌入模型,它只需要在建立知识库的时候把所有文档编码一次,之后每次查询都在这个编码库里搜索就行,计算量不大。但生成模块就麻烦了——每次用户提问,都需要一个语言模型把问题和检索到的文档一起读懂,然后生成一段流畅、准确的答案,这个过程对模型能力的要求相当高。
目前行业里的主流做法,是在生成模块用大模型——毕竟大模型理解能力强,生成质量高。但正如前面说的,大模型跑不起来的情况实在太普遍了。于是研究团队就产生了一个核心疑问:如果把生成模块换成小模型,答案质量会差多少?能不能达到实用的标准?
二、打造一套公平的考试卷
要评判小模型的表现,首先得有一套客观、全面的考题。研究团队为此专门组建了一个俄语问答数据集,共包含500道题目,来源是5个不同的数据集,每个数据集抽取100道题。
这5个数据集涵盖了非常不同的应用场景,各有侧重。第一个是DaNetQA,专门测试“是/否”类问题,比如“这个说法是真的吗?”,考验模型对常识和世界知识的理解。第二个是SberQuAD,内容来自俄语维基百科,每道题都有一段原文和一个问题,答案就藏在原文里某个地方,考的是阅读理解能力。第三个是RuRAG测试集,专门为评测俄语RAG系统设计,同样基于俄语维基百科,题目和答案更贴近RAG的实际使用场景。第四个是Grounded-RAG-QA-RU,这个数据集用GPT-4生成了问题和答案,有些问题故意设计成“无法仅凭提供的文档回答”,用来测试模型是否会在信息不足时乱猜,而不是老老实实说“我不知道”。第五个则是来自西伯利亚神经网络公司自己业务里的专有数据集,内容是5000份会议和讲座演示文稿,每份大约4500个单词,题目由人工精心编写,代表了真实工业场景中的知识问答需求。这个专有数据集因为许可限制无法公开,但其结构与其他数据集完全一致。
为了让评测更有层次感,研究团队还用Qwen3-8B模型对每道题进行了分类,分成了六种题型:事实型问题(比如“某人出生于哪年”)、推理型问题(需要多步逻辑推导)、证据型问题(答案必须直接来自提供的文档)、比较型问题(比较两个事物的异同)、经验型问题(涉及主观判断或个人经历)以及指令型问题(答案是一套操作步骤)。
从分布上来看,这500道题里事实型问题最多,占了278道,其次是经验型57道、证据型77道、推理型45道、比较型40道,指令型最少只有3道。不同数据集的题型分布差异相当大,比如专有讲座数据集里经验型和证据型题目特别多,而ru-rag-test数据集里99%都是事实型问题。这种分布上的差异正好反映了不同应用场景的特点。
研究团队还对这套题目进行了质量分析。题目平均长度是8.72个词,标准答案平均长度是41.62个词,说明这些问题相当简洁,但答案需要有一定的展开和说明。不同数据集之间的内容相似度非常低,余弦相似度只有0.06到0.12,说明覆盖的话题确实很多样,不会出现很多重复内容。题目的难度评分平均是4.94分(满分10分),属于中等难度,不简单但也不刁钻。题目和标准答案之间的匹配度平均达到7.012分,说明标准答案质量很高,答案和问题确实对得上。
三、谁来给模型打分?先考一考“考官”
评测AI答题效果,比看起来复杂得多。传统的评分方法,比如BLEU、ROUGE、METEOR,说白了就是“数一数模型的答案和标准答案有多少词是一样的”。这种方法在机器翻译这类任务上还凑合用,但在开放式问答里就显得很笨——同一个意思可以用无数种不同的方式表达,两个句子即使一个词都不同,意思也可能完全一样;反过来,两句话字面相似,实际内容却可能大相径庭。
研究团队选择了目前更先进的“LLM作为评判者”方法(LLM-as-a-Judge),简单说就是:用另一个AI来评判被测试AI的答案好不好。这就像请一位经验丰富的专家来打分,而不是用机器死板地数有多少个字相同。
为了用好这套方法,研究团队先专门建了一个测试评判者能力的数据集。做法很聪明:从原始500道题里,把不同题目的问题、答案、标准答案、背景文档随机打乱混搭,人为制造出一批“明显错误”的答题记录,这些错误记录标分为0;然后把原始正确的问题-答案配对保留下来,标分为1。把这两类数据混在一起,就形成了一套测试评判者辨别能力的考卷。
共有13个不同的AI模型参与了评判者测评,包括GPT-5、GPT-5-mini、GPT-4o-mini、Qwen3系列(4B、8B、32B、235B)、GLM-4.7、Gemma-3系列、DeepSeek-v3.2以及GPT-oss-120B。评测指标包括四个维度:正确性(答案是否事实准确)、答案相关性(答案是否回应了用户的问题)、上下文相关性(检索到的文档是否和问题相关)、忠实度(答案内容是否有文档支撑,没有无中生有)。
评估每个评判者时,研究团队计算了三个指标。第一是F1分数,衡量评判者区分正确答案和错误答案的能力,满分是1.0。第二是“平均差答案分数”,专门看评判者给明显错误答案打了多少分,分数越低说明评判者越会识别错误,更接近0越好。第三是与所有评判者共识的皮尔逊相关系数,衡量这个评判者是否和大多数评判者保持一致,越接近1越好。
测评结果显示,大多数模型都表现出色。GPT-5-mini、GLM-4.7、DeepSeek-v3.2-alt、GPT-oss-120B、GPT-4o-mini、GPT-5、Qwen3-32B和Qwen3-235B在F1分数上都达到了1.0,也就是完美区分了正确和错误答案。而较小的Gemma-3-4B-it表现则差一些,F1只有0.94,更糟糕的是它给错误答案打的平均分高达0.22,说明它经常把明显错误的答案误判为正确。
最终,研究团队从中挑选了三个评判者组成“评审团”:GPT-5-mini、Qwen3-8B和GLM-4.7。选择这三个的理由是:它们的F1分数都很高,与群体共识的相关性强,给错误答案的打分很低,而且三者来自完全不同的模型家族(分别是OpenAI、阿里巴巴Qwen系列、智谱AI),能有效避免“同一家族模型相互包庇”的系统性偏差。三位评判者之间的组内相关系数(ICC)高达0.96,说明他们的评分高度一致,构成了一个可靠的“专家评审团”。
四、17位“小脑袋”上场,成绩怎么样?
选模型的标准相当务实:参数量要在可接受范围内、涵盖多个不同模型家族、必须是开源可用的、支持GGUF格式(一种专门针对CPU推理优化的模型存储格式)、而且在16GB内存的普通电脑上就能跑。所有候选模型都先在纯CPU环境下进行了预测试,确认能正常运行才进入正式评测。最终筛选出17个模型,参数量从1B(10亿)到8B(80亿)不等,同时还把GPT-5-mini作为“顶级对照组”加入比较。
每个模型都在“带背景文档”的模式下接受测试:把检索到的相关文档和用户的问题一起喂给模型,让它根据文档内容生成答案。另外,GPT-5-mini还额外测试了“不带背景文档”的模式,只给问题不给参考资料,用来对比上下文信息对答案质量的影响。
从测试结果来看,整体格局相当清晰,Qwen3系列表现最为突出。参数量最大的Qwen3-8B-Q4KM拿到了正确性0.72、答案相关性0.87、忠实度0.83的成绩,在所有小模型里排名第一,与GPT-5-mini(正确性0.73、答案相关性0.88、忠实度0.89)的差距相当小。Qwen3-4B-Instruct-2507-Q5KM的正确性是0.71、答案相关性高达0.89(和GPT-5-mini持平!)、忠实度0.80,在4B参数量这个档次里表现出色。
相比之下,Llama-2-7B-Chat-Q4KM表现最弱,正确性只有0.32,答案相关性0.46,忠实度0.42,远远落后于其他模型。DeepSeek-R1-Distill-Qwen-7B-Q4KM和Saiga-Mistral-7B-Q4K也表现平平,正确性分别只有0.40和0.44。
一个很有意思的对比来自GPT-5-mini自身。在带背景文档的模式下,GPT-5-mini正确性是0.73;而在不给任何背景文档的情况下,正确性骤降到0.47,足足掉了0.26。这一对比有力地说明了这套测试题的设计质量:这些题目确实需要外部信息才能答对,不是靠背诵训练数据就能糊弄过去的,测的就是模型利用检索信息生成准确答案的真实能力。
五、速度也是实力的一部分
对于需要在CPU上本地运行的系统来说,回答一个问题要等多久,往往比答案质量还要关键。研究团队专门测量了每个模型在50个样本上的平均响应时间。
测速结果里有几个很有代表性的数据点。Meno-tiny-1.5B-0.1-FP16是速度最快的,平均每个问题只需要27.8秒,这对于一个在CPU上运行、无需任何显卡的模型来说相当快。Meno-lite-7B-Q4KM只要31.4秒,速度同样惊人,而且质量比Meno-tiny高出不少,正确性0.56、答案相关性0.75、忠实度0.74。Qwen2.5-3B-Instruct-Q5KM也只需要31.8秒。
而有些模型虽然质量不差,速度却慢得让人难以接受。DeepSeek-R1-Distill-Qwen-7B-Q4KM平均要等297.4秒,接近5分钟一个答案,QVikhr-3-4B-Instruction-Q5KM要254.4秒,Saiga-Mistral-7B-Q4K需要257.1秒,Qwen3-4B-Q5KM虽然质量不错但也要205.1秒。Qwen3-8B-Q4KM品质最好,但需要339.3秒,将近6分钟。
研究团队最终为自己的生产系统选择了Qwen3-4B-Instruct-2507-Q5KM,平均响应时间70.9秒,正确性0.71,答案相关性0.89,忠实度0.80——在速度和质量之间取得了一个相对合理的平衡点。当然,70秒对于一个实时对话系统来说依然不算快,但对于文档处理或批量问答这类对延迟要求不那么苛刻的场景来说,已经很实用了。
六、模型说什么语言?一个被忽略的细节
由于所有的测试题都是俄语,研究团队还顺带观察了一个有趣的现象:在没有明确要求“请用俄语回答”的情况下,这些模型倾向于用什么语言输出答案?
结果显示,大多数模型能够“跟着问题走”,看到俄语问题就自然而然地用俄语回答,西里尔字母(俄语字母)占了输出内容的绝大部分。但也有少数模型出现了“语言漂移”的问题,偶尔夹杂英语或其他语言。这对于面向俄语用户的产品系统来说是一个实实在在的工程问题——如果模型经常用英语回答俄语问题,用户体验会很差,还需要额外的后处理步骤来纠正。
七、研究的边界和未解之题
研究团队在论文里对自己研究的局限性讲得相当坦诚。这项研究只考察了小模型在RAG系统里的生成能力,完全没有涉及检索环节——用什么嵌入模型、用什么检索算法,对整体答案质量同样有很大影响,但这部分不在本研究的考察范围内。
另一个局限是提示词设计。研究团队对所有17个模型使用了同一套提示词(给模型的“任务说明”),并没有针对每个模型的特点进行定制优化。事实上,不同架构的模型对提示词格式和措辞往往有各自的偏好,定制化提示词很可能让某些模型的表现明显提升。因此,这份测试结果更多反映的是“同等条件下”的相对表现,而非每个模型的理论最优表现。
此外,这套测试完全基于俄语,结论能否推广到中文、英文或其他语言,还需要专门的验证。毕竟不同语言的语法复杂度、训练数据丰富程度差别很大,一个俄语表现出色的小模型,放到中文场景里不一定同样好用。
说到底,这项研究做的事情用一句话就能概括:用真实的俄语问答任务,把17个可以在普通电脑CPU上运行的小模型认认真真考了一遍,看看它们能不能胜任RAG系统的生成工作。
结论是可以,但要看场景。Qwen3系列的小模型,尤其是4B和8B参数量的版本,在答案质量上已经非常接近顶级大模型GPT-5-mini,而它们对硬件的要求仅仅是一台普通的笔记本电脑,不需要任何昂贵的GPU。这对于需要保护数据隐私、在本地部署AI的场景来说,是一个相当有说服力的证明。
当然,CPU推理的速度问题依然是一根刺——最快的模型也要将近半分钟,最慢的接近六分钟,在对响应时间极敏感的实时场景里还是会让用户等得不耐烦。随着模型量化技术和CPU推理框架的持续进步,这个瓶颈会逐渐改善,但目前来说,选择小模型意味着要在速度和质量之间做取舍,没有完美的答案。
对于关心数据安全的普通用户、希望在内网部署AI但没有算力预算的中小企业,还是想在资源受限设备上集成智能问答功能的开发者,这项研究提供了一份来自真实生产场景的参考答案。有兴趣深入了解完整细节和实验代码的读者,可以通过arXiv编号2606.30062查阅原论文。
Q&A
Q1:小语言模型在RAG系统中的答题准确度和GPT-5-mini差距大吗?
A:差距并不像想象中那么大。测试结果显示,Qwen3-8B-Q4KM的正确性得分为0.72,而GPT-5-mini是0.73,差距极小。即便是4B参数量的Qwen3-4B-Instruct-2507-Q5KM,答案相关性得分也与GPT-5-mini持平,达到0.89。当然,在忠实度(答案是否完全依据文档)上,小模型与GPT-5-mini仍有一定差距。
Q2:在普通电脑CPU上运行小语言模型,大概要等多久才能得到答案?
A:这项研究在纯CPU环境下测量了各模型的响应时间。最快的Meno-tiny-1.5B只需约28秒,性价比较高的Meno-lite-7B和Qwen2.5-3B约需31秒。研究团队为生产系统选择的Qwen3-4B-Instruct-2507-Q5KM平均需要约71秒。速度最慢的Qwen3-8B接近6分钟一个答案。速度快慢主要取决于模型参数量大小。
Q3:RAG系统里的检索模块和生成模块有什么区别?
A:可以把RAG系统理解为“图书管理员+解说员”的组合。检索模块相当于图书管理员,负责在知识库里快速找到与用户问题最相关的文档,这部分用的是较小的嵌入模型,计算量不大。生成模块相当于解说员,负责读懂问题和检索到的文档,再组织成一段流畅的答案,这部分需要语言模型参与,对算力要求更高,也是这项研究专注评测的核心环节。
华盛顿大学团队构建TheoremGraph,从arXiv提取1170万条定理陈述,利用Lean证明库获取388k形式化声明,通过slogan嵌入匹配和GPT-5.4裁决,确认47952对跨模态对应,有效连接非形式化与形式化数学知识,推动数学推理研究。
答案:搭建C++神经网络框架需定义Tensor、Layer基类及Network管理类,选用Eigen或CUDA库优化矩阵运算,通过运算符重载或表达式模板实现自动微分,利用多态统一管理全连接、卷积等层,结合内存池与智能指针优化内存,使用protobuf实现模型序列化,并借助GoogleTest进行单元测试。
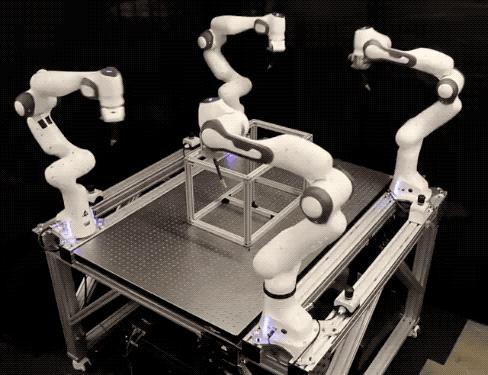
一群机械臂手忙脚乱地自己干活,彼此配合、互不碰撞。科幻大片场景真的走入现实了。优雅,实在是优雅。△视频中为4个机械臂,在仿真环境下4个安装在桌子上,另外4个安装在天花板上。这就是发表在Science子刊ScienceRobotics上,由DeepMind、IntrinsicAI和UCL等研究机构共同提出的最新成果——RoboBallet(机器芭蕾)。RoboBallet创新性地将图神经网络(GNN)用于强化学习,作为其策略网络和状态-动作价值估计,以解决多机器人(机械臂)
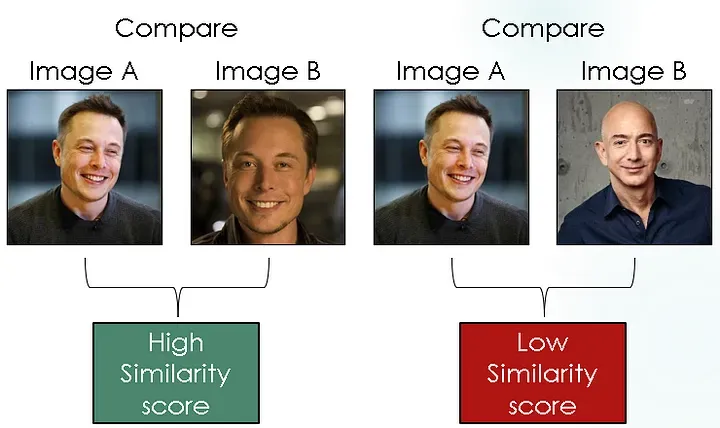
简介在计算机视觉领域,准确地测量图像相似性是一项关键任务,具有广泛的实际应用。从图像搜索引擎到人脸识别系统和基于内容的推荐系统,有效比较和查找相似图像的能力非常重要。Siamese网络与对比损失结合,为数据驱动方式学习图像相似性提供了强大的框架。在这篇博文中,我们将深入了解Siamese网络的细节,探讨对比损失的概念,并探讨这两个组件如何共同工作以创建一个有效的图像相似性模型。首先,Siamese网络由两个相同的子网络组成,这两个子网络共享相同的权重和参数。每个子网络将输入图像编码为特征向量,这些向量捕捉

随着人工智能技术的不断发展,图像识别已经成为了一项非常重要的任务。而基于神经网络的图像识别系统,则是实现高精度识别、分类和检测的常用方法之一。本文将介绍如何使用Java编写一个基于神经网络的图像识别系统。神经网络的基础知识神经网络是由很多个神经元相互连接而成的网络,每一个神经元都有输入、输出和激活函数。在图像识别中,神经网络的输入层通常是原始图像的像素值,隐
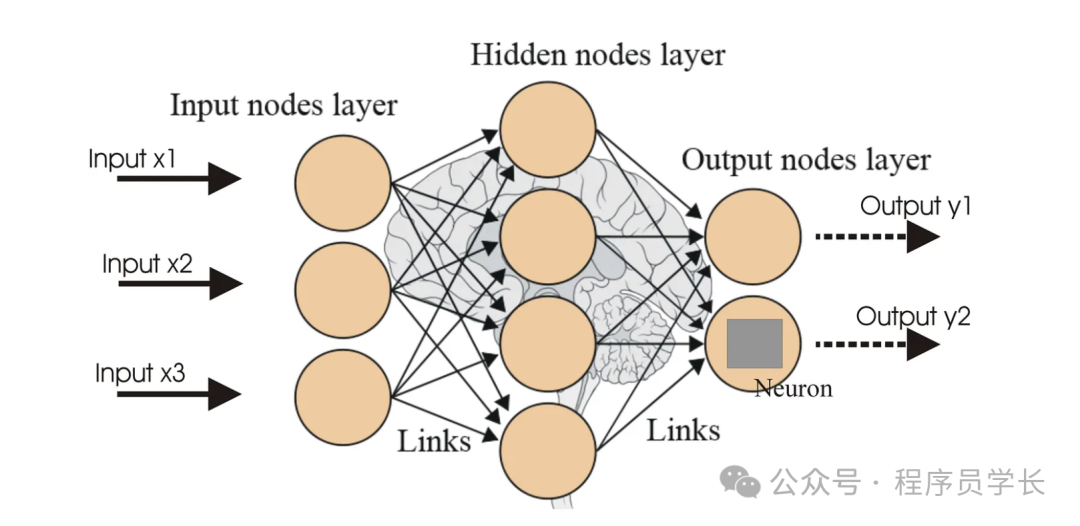
今天给大家分享一个超强的算法,CNN卷积神经网络(CNN)是一种深度学习模型,广泛应用于图像和视频分析、自然语言处理和其他相关领域。CNN通过模拟生物视觉系统的处理方式来分析图像和视频,能够自动学习数据的层次特征。它的处理方式是通过模拟生物视觉系统的处理方式,能够自动学习数据的层次特征。CNN通过模拟生物视觉系统的处理方式来分析图像和视频,能够自动学习数据的层次特征。这种处理方式通过模拟生物视觉系统来解决视觉问题,对于层次化特征更加敏感,使得它成为处理大规模图像和视频数据的首选算法之在了解什么是CNN以及

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文作者赵博是加州大学圣地亚哥分校的三年级在读博士,其导师为RoseYu。她的主要研究方向为神经网络参数空间中的对称性,及其对优化、泛化和损失函数地貌的影响。她曾获DeepMind奖学
研究领域:空间组学,多切片整合对齐,多尺度,动态图卷积神经网络董弘禹|作者论文题目:SANTO:acoarse-to-finealignmentandstitchingmethodforspatialomics论文来源:NatureCommunications论文链接:https://www.nature.com/articles/s41467-024-50308-x随着空间组学技术的蓬勃发展,对平面2D切片进行对齐与拼接,进而形成3D空间模型以发现全局特征,已成为空间组学分析中不可或缺的步骤。然而,现有

用光训练神经网络,清华成果最新登上了Nature!无法应用反向传播算法怎么办?他们提出了一种全前向模式(FullyForwardMode,FFM)的训练方法,在物理光学系统中直接执行训练过程,克服了传统基于数字计算机模拟的限制。简单点说,以前需要对物理系统进行详细建模,然后在计算机上模拟这些模型来训练网络。而FFM方法省去了建模过程,允许系统直接使用实验数据进行学习和优化。这也意味着,训练不需要再从后向前检查每一层(反向传播),而是可以直接从前向后更新网络的参数。打个比方,就像拼图一样,反向传播需要先看到
1.Python与机器学习的邂逅python作为一种简单易学、功能强大的编程语言,深受广大开发者的喜爱。而机器学习作为人工智能的一个分支,旨在让计算机学会如何从数据中学习并做出预测或决策。Python与机器学习的结合,可谓是珠联璧合,为我们带来了一系列强大的工具和库,使得机器学习变得更加容易实现和应用。2.Python机器学习库探秘Python中提供了众多功能丰富的机器学习库,其中最受欢迎的包括:NumPy:提供了高效的数值计算功能,是机器学习的基础库。SciPy:提供了更高级的科学计算工具,是NumPy





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



