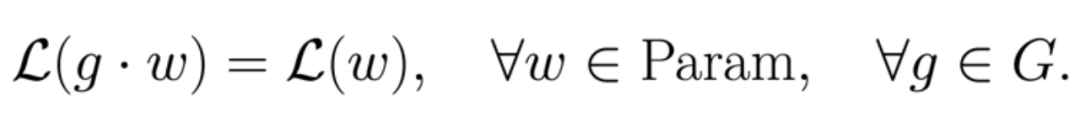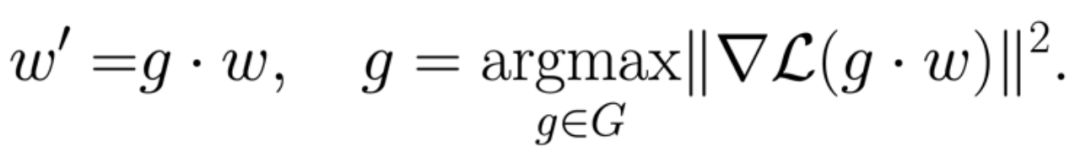当前位置:

首页 > 业界资讯 > ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效

ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文作者赵博是加州大学圣地亚哥分校的三年级在读博士,其导师为RoseYu。她的主要研究方向为神经网络参数空间中的对称性,及其对优化、泛化和损失函数地貌的影响。她曾获DeepMind奖学

本文目录
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com
    本论文作者赵博是加州大学圣地亚哥分校的三年级在读博士,其导师为 Rose Yu。她的主要研究方向为神经网络参数空间中的对称性,及其对优化、泛化和损失函数地貌的影响。她曾获 DeepMind 奖学金,并且是高通创新奖学金的决赛入围者。邮箱:bozhao@ucsd.edu

    众多神经网络模型中都会有一个有趣的现象:不同的参数值可以得到相同的损失值。这种现象可以通过参数空间对称性来解释,即某些参数的变换不会影响损失函数的结果。基于这一发现,传送算法(teleportation)被设计出来,它利用这些对称变换来加速寻找最优参数的过程。尽管传送算法在实践中表现出了加速优化的潜力,但其背后的确切机制尚不清楚。

    近日,来自加州大学圣地亚哥分校、Flatiron Institute、美国东北大学等机构的研究人员发布的《Improving Convergence and Generalization Using Parameter Symmetries》论文中,展示了传送不仅能在短期内加快优化过程,而且能总体上缩短收敛时间。此外,研究还发现,传送到具有不同曲率的最小值可以改善模型的泛化能力,这意味着最小值的曲率与泛化能力之间存在联系。研究者们进一步将传送技术与多种优化算法以及基于优化的元学习相结合,这些结果充分展示了在优化过程中融入参数空间对称性的潜力。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
    • 论文链接:https://openreview.net/forum?id=L0r0GphlIL
    • 代码链接:https://github.com/Rose-STL-Lab/Teleportation-Optimization
    • 作者主页:https://b-zhao.github.io/
    背景:对称性和传送算法

    参数空间对称性(parameter space symmetry)是群 G 在参数空间(Param)上的一个作用,该作用使得损失函数 L 的值保持不变:
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
    对称传送算法(symmetry teleportation)在损失函数水平集中寻找更陡峭的点以加速梯度下降:
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
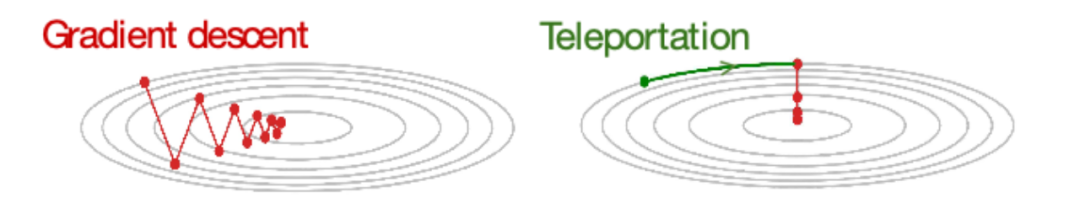
    传送后,损失值不会改变。然而,梯度和之后的训练轨迹会有所不同。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
    传送对收敛速度的提高

    论文第一部分提供了对传送提高收敛速度的理论证明。

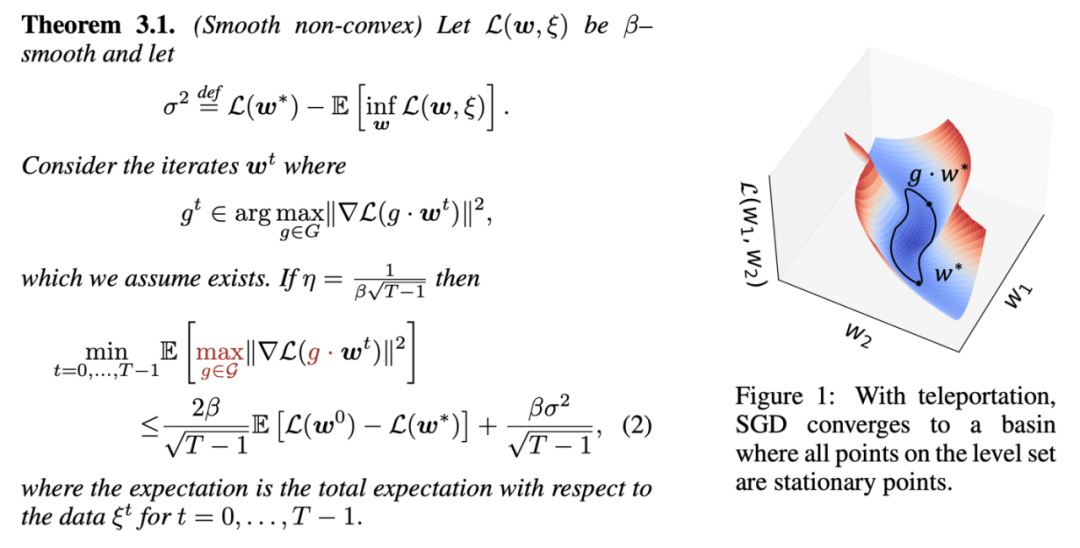
    通过传送,随机梯度下降(SGD)会收敛到一个包含多个静止点的盆地,其中通过传送可达的每个点都是静止的。图 1 中的定理提供了损失函数梯度期望值的上限。相比之下,普通 SGD 只能保证存在一个点 wt,使得梯度最终会很小。加入传送后,对于群作用轨道上所有的点,梯度都将很小。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                   图 1:该定理提供了损失函数梯度期望值的上限

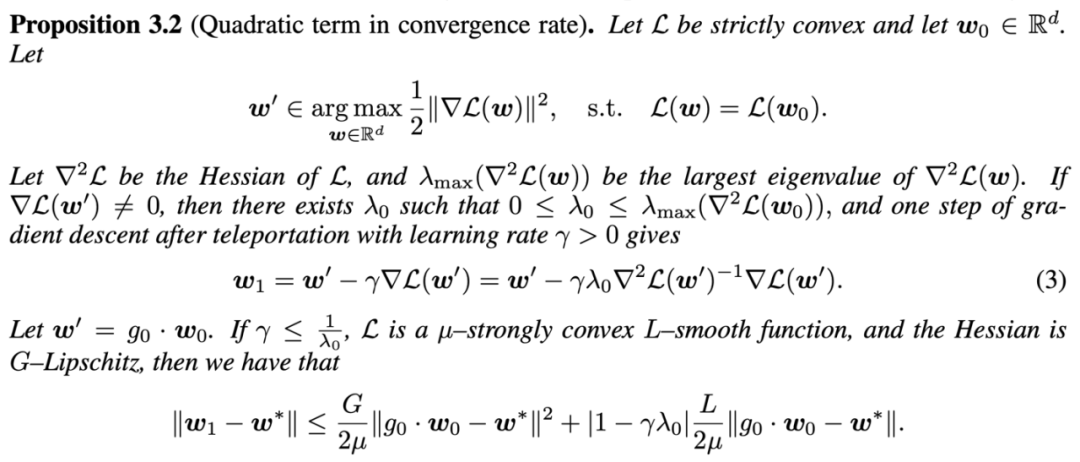
    此外,在进行一次传送后,梯度下降的方向与牛顿法(Newton’s method)方向相同。因此,收敛速度具有一个二次收缩项,这是二阶方法的典型特征。相反,如果在相同的假设下省略传送步骤,算法的收敛速度将仅呈现线性收敛。图 2 中的定理展示了传送导致的线性和二次收敛的混合。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                   图 2:该定理展示了传送导致的线性和二次收敛的混合

    通过传送改善泛化能力

    在探索机器学习模型优化的过程中,「传送」这一概念最初被提出是为了加速收敛并提高算法的效率。然而,在该论文的第二部分,研究者们将视野扩展到了一个新的目标 —— 提升模型的泛化能力。

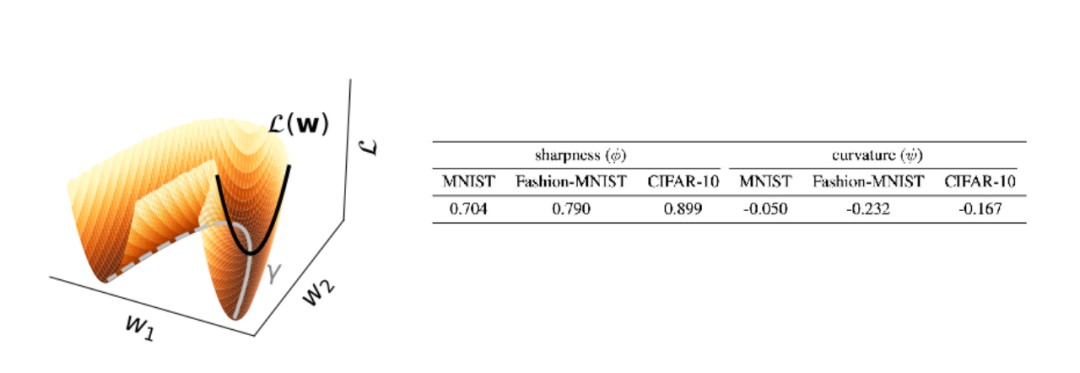
    泛化能力通常与模型在训练过程中达到的极小值的「锐度」(sharpness) 相关。为了深入理解这一点,研究者们引入了一个新的概念 ——「极小值曲率」(curvature),并讨论其对泛化的影响。通过观察极小值的锐度、曲率与泛化能力之间的关联,研究者们提出了一种新的方法,将锐度和曲率纳入传送的目标中来提升模型的泛化性能。 

    图 3 通过可视化的方式展示了一个梯度流 L (w) 和一条极小值上的曲线(γ),这两条曲线的曲率对应着极小值的锐度和曲率。此外,表中还显示了测试集上的损失与锐度或曲率之间的 Pearson 相关性。在三个数据集中,锐度与验证损失呈强正相关,而极小值的曲率则与验证损失呈负相关。这些发现表明,具有较小锐度或较大曲率的极小值,可能会带来更好的泛化效果。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                       图 3:展示了一个梯度流 L (w) 和一条极小值上的曲线(γ)

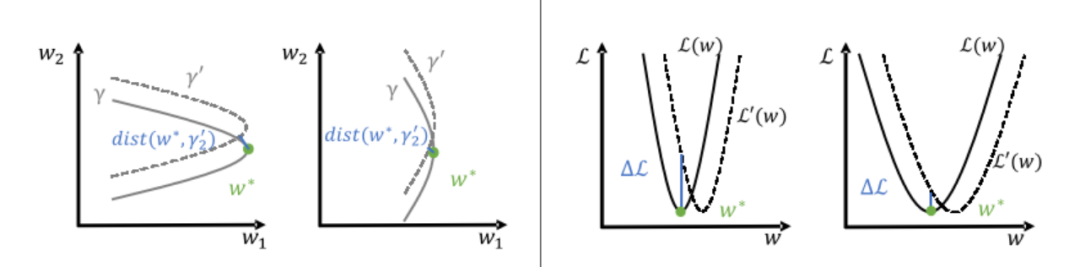
    这些相关性的一种解释来源于损失地形(loss landscape)在不同数据分布上的变化。当数据分布发生变化导致损失地形变化时,尖锐的极小值损失增加较大(如图 4 右侧所示)。在图 4 中,曲率较大的极小值与变化后的极小值距离更远(如图 4 左侧所示)。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                                图 4

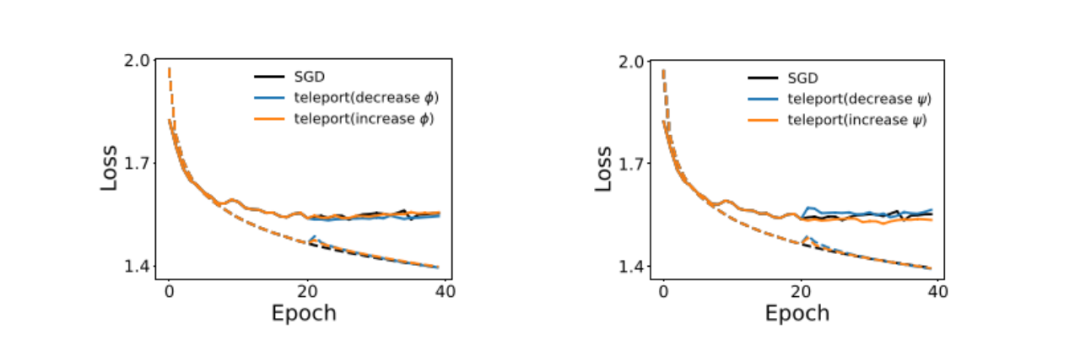
    取得了极小值的属性与泛化能力的相关性后,该研究人员将参数传送到具有不同锐度和曲率的区域,以提高模型的泛化能力。图 5 为在 CIFAR-10 上 SGD 的训练曲线,其中在第 20 个 epoch 进行了一次传送。实线代表平均测试损失,虚线代表平均训练损失。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                                        图 5

    传送到更平坦的点略微改善了验证损失。通过传送改变曲率对泛化能力有更显著的影响。传送到曲率较大的点有助于找到具有较低验证损失的极小值,而传送到曲率较小的点则产生相反的效果。这表明至少在局部,曲率与泛化相关。

    传送和其他优化器的结合

    标准优化器

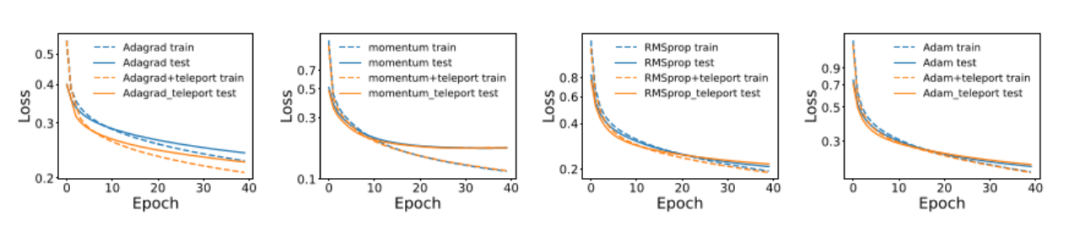
    传送不仅有助于 SGD 的收敛速度。为了展示传送与其他标准优化器的良好兼容性,研究者们使用不同的优化器在 MNIST 上训练了一个三层神经网络,并进行了带传送和不带传送的训练。如图 6 所示,在使用 AdaGrad、带动量的 SGD、RMSProp 和 Adam 时,传送提高了这些算法的收敛速度。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                    图 6:在使用 AdaGrad、带动量的 SGD、RMSProp 和 Adam 时,传送提高了这些算法的收敛速度

    学习传送

    受条件编程(conditional programming)和基于优化的元学习(meta-learning)的启发,研究者们还提出了一个元优化器,用于学习在损失水平集中移动参数的位置。这种方法避免了在群流形上优化的计算成本,并改进了现有的仅限于局部更新的元学习方法。

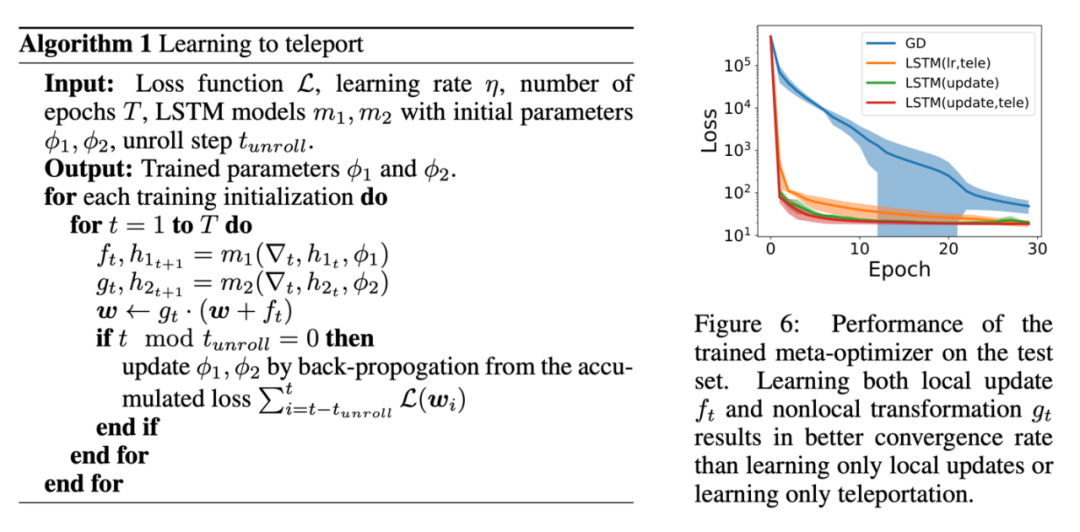
    图 7 总结了训练算法。研究人员使用了两个 LSTM 元优化器 (m1, m2) 来学习局部更新 ft 和传送中使用的群元素 gt。在两层 LeakyReLU 神经网络上的实验中,他们使用了不同初始化创建的多个梯度下降轨迹上训练元优化器,并在训练中未见过的新初始值上测试收敛速度。
    ICLR 2024 Oral|用巧妙的「传送」技巧,让神经网络的训练更加高效
                                    图 7:总结了训练算法

    与基线相比,同时学习两种更新类型(LSTM (update,tele))比单独学习它们(LSTM (update) 、LSTM (lr,tele))能够实现更好的收敛速率。

    总结

    该论文的主要贡献包括传送加速 SGD 收敛的理论保证、极小值曲率的量化及其与泛化相关性的证据、基于传送的改善泛化的算法以及学习传送位置的元学习算法。

    传送广泛适用于在损失水平集中搜索具有优秀属性的参数。对称性与优化之间的密切关系开启了许多激动人心的机会。探索传送中的其他目标是一个有潜力的未来方向。其他可能的应用包括将传送扩展到不同的架构,如卷积或图神经网络,以及不同的算法,如基于采样的优化。
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯 神经网络
    相关文章 更多
    华盛顿大学用AI为数学知识建了一张
    华盛顿大学用AI为数学知识建了一张"神经网络"

    华盛顿大学团队构建TheoremGraph,从arXiv提取1170万条定理陈述,利用Lean证明库获取388k形式化声明,通过slogan嵌入匹配和GPT-5.4裁决,确认47952对跨模态对应,有效连接非形式化与形式化数学知识,推动数学推理研究。
    西伯利亚神经网络公司用小模型挑战大模型
    西伯利亚神经网络公司用小模型挑战大模型

    西伯利亚神经网络公司研究团队在arXiv发布预印本,测试了17个小模型在俄语RAG问答系统中的表现。结果表明,Qwen3系列小模型在答案质量上接近GPT-5-mini,且可在普通电脑CPU运行。但CPU推理速度较慢,实际应用需在速度与质量间取舍。
    C++神经网络框架入门教程
    C++神经网络框架入门教程

    答案:搭建C++神经网络框架需定义Tensor、Layer基类及Network管理类,选用Eigen或CUDA库优化矩阵运算,通过运算符重载或表达式模板实现自动微分,利用多态统一管理全连接、卷积等层,结合内存池与智能指针优化内存,使用protobuf实现模型序列化,并借助GoogleTest进行单元测试。
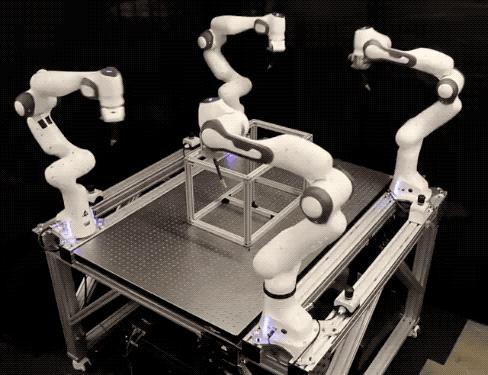
    AlphaGo 作者带队,8 机械臂无碰撞协作新作登 Science 子刊
    AlphaGo 作者带队,8 机械臂无碰撞协作新作登 Science 子刊

    一群机械臂手忙脚乱地自己干活,彼此配合、互不碰撞。科幻大片场景真的走入现实了。优雅,实在是优雅。△视频中为4个机械臂,在仿真环境下4个安装在桌子上,另外4个安装在天花板上。这就是发表在Science子刊ScienceRobotics上,由DeepMind、IntrinsicAI和UCL等研究机构共同提出的最新成果——RoboBallet(机器芭蕾)。RoboBallet创新性地将图神经网络(GNN)用于强化学习,作为其策略网络和状态-动作价值估计,以解决多机器人(机械臂)
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效

    伴随大模型迭代速度越来越快,训练集群规模越来越大,高频率的软硬件故障已经成为阻碍训练效率进一步提高的痛点,检查点(Checkpoint)系统在训练过程中负责状态的存储和恢复,已经成为克服训练故障、保障训练进度和提高训练效率的关键。近日,字节跳动豆包大模型团队与香港大学联合提出了ByteCheckpoint。这是一个PyTorch原生,兼容多个训练框架,支持Checkpoint的高效读写和自动重新切分的大模型Checkpointing系统,相比现有方法有显著性能提升和易用性优势。本文介绍了大模型训练提效中C

    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习
    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文第一作者杜超群是清华大学自动化系2020级直博生。导师为黄高副教授。此前于清华大学物理系获理学学士学位。研究兴趣为不同数据分布上的模型泛化和鲁棒性研究,如长尾学习,半监督学习,迁移

    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索
    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者是来自OpenSearch中国研发团队的机器学习负责人杨扬博士以及机器学习工程师耿志超和管聪。OpenSearch是一个由亚马逊云科技发起的纯开源搜索和实时分析引擎项目。目前软件
    探索使用对比损失的孪生网络进行图像相似性比较
    探索使用对比损失的孪生网络进行图像相似性比较

    简介在计算机视觉领域,准确地测量图像相似性是一项关键任务,具有广泛的实际应用。从图像搜索引擎到人脸识别系统和基于内容的推荐系统,有效比较和查找相似图像的能力非常重要。Siamese网络与对比损失结合,为数据驱动方式学习图像相似性提供了强大的框架。在这篇博文中,我们将深入了解Siamese网络的细节,探讨对比损失的概念,并探讨这两个组件如何共同工作以创建一个有效的图像相似性模型。首先,Siamese网络由两个相同的子网络组成,这两个子网络共享相同的权重和参数。每个子网络将输入图像编码为特征向量,这些向量捕捉

    将图像自动文本化,图像描述质量更高、更准确了
    将图像自动文本化,图像描述质量更高、更准确了

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com皮仁杰:香港科技大学博士三年级学生,师从张潼教授和周晓方教授。于2024年获得苹果奖学金。目前主要研究方向是多模态大语言模型和数据为中心的AI。张鉴殊:武汉大学本科三年级学生,目前在张潼
    告别逐一标注,一个提示实现批量图片分割,高效又准确
    告别逐一标注,一个提示实现批量图片分割,高效又准确

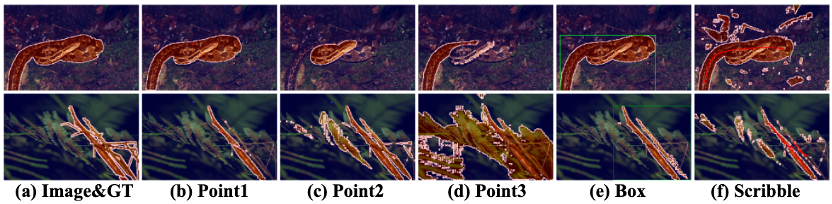
    仅需一个任务描述,即可一键分割所有图片!SegmentationAnythingModel(SAM)的提出在图像分割领域引起了巨大的关注,其卓越的泛化性能引发了广泛的兴趣。然而,尽管如此,SAM仍面临一个无法回避的问题:为了使SAM能够准确地分割出目标物体的位置,每张图片都需要手动提供一个独特的视觉提示。如下图所示,即使点击的是同一物体(图(b)-(d)),微小位置变化都会导致分割结果的显著差异。这是因为视觉提示语义信息的缺乏,即使提供了想要分割的目标物体上,仍然可能引发歧义。框提示和涂鸦提示(图(e)(


    查看更多
    精品专题 更多
    装机必备
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows
    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程
    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    Mac软件 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    Aperty macOS版
    Aperty macOS版
    macOS

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    WINDOWS 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    PixTV 网页版
    PixTV 网页版
    Windows

    PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。