

香港科技大学研究新突破:一个"翻译官"同时读懂视频和声音
香港科技大学研究团队提出AVTok统一音视频分词器,将视频和音频编码为同一维离散代码,通过双流变压器架构和分阶段训练消除表示差距。实验表明,该模型视频重建质量超越专用单模态模型,音频重建性能具有竞争力。
这项由香港科技大学研究团队完成的研究成果,以预印本形式发布于2026年6月29日,论文编号为arXiv:2606.30811v1,研究方向属于计算机视觉领域。感兴趣的读者可以通过该编号在arXiv学术平台查阅完整论文。
让我们先想一个场景:看一段无声视频时,总觉得少了点什么;或者,听一段声音录音时,脑子里会不由自主地浮现出对应的画面。人类的大脑天生就把声音和画面绑在一起处理。当一个孩子拍手时,我们同时感知到手掌碰撞的声音和手掌合拢的动作——这两件事在大脑里是一个整体,而非两条分开的信息流。
然而,当AI试图生成“有声视频”时,它遇到了一个根本性的麻烦:它同时雇用了两个“翻译官”——一个只懂图像语言,一个只懂声音语言——两人各说各话,生成出来的画面和声音经常对不上号。枪声响起,但人还没开枪;音乐节拍和舞蹈动作错位;说话的嘴型和语音驴唇不对马嘴。这个问题被研究者称为“表示差距”(Representation Gap),是长期悬而未决的核心障碍。
香港科技大学的这支研究团队决定彻底重新思考这个问题。思路非常直接:与其训练两个语言互不相通的翻译官,不如培养一个同时精通两种语言的“双语翻译”,让视频和音频从一开始就被统一编码进同一个语言系统里。基于这个思路,他们提出了名为A VTok的全新统一音视频分词器——这也是该领域首次有人系统性地挑战这个问题。
一、为什么现有方法总是“左手不知右手在干嘛”
要理解A VTok的价值,先来了解目前的AI视频生成系统是怎么工作的。现有的主流方案大多采用“双分支架构”的设计。顾名思义,这套系统就像一个工厂里有两条完全独立的流水线:一条处理视频画面,另一条处理音频声音。每条流水线各自用一个预训练好的分词器(Tokenizer,可以理解为把原始内容压缩成简洁代码的机器)把对应的媒体内容压缩成一串数字代码,之后再由各自的生成模块分别生成新的画面和声音。
问题在于,这两套代码系统从来没有在同一个“语言环境”下学习过。就像一个人从小只学英语、另一个人从小只学中文,两人各自的语言习惯、思维方式都不一样,沟通时免不了产生误会。两个分词器学到的“音频语言”和“视频语言”之间存在天然的鸿沟,后续的生成模型即便想让声音和画面匹配,也很难跨越这道沟。
研究团队对现有系统做了一个可视化实验,用一种叫t-SNE的降维技术把视频和音频各自编码后的特征投影到同一个二维平面上。结果非常直观:视频的特征点和音频的特征点像两群不同的人在广场上各自扎堆,中间隔着一片空地,很少有混合或交叠——说明两套系统确实生活在两个互不相通的世界里。右侧展示A VTok结果的图中,同一类别的视频和音频特征开始相互靠近、交融,代表“狗叫声”的点和“一只狗的视频”的点开始聚集在一起。这种融合,正是生成时音画对应的基础。
二、把视频和音频放进同一本“词典”:核心思路的来龙去脉
研究团队面临的第一个选择是:用什么格式来统一表示视频和音频?这个问题听起来简单,其实颇为棘手,因为两种媒体天生的“体型”就不一样。
视频是三维的——它有宽度、高度和时间三个维度,就像一叠照片摞在一起。大多数视频分词器为了忠实表达视频的空间结构,会生成一种三维的代码块,存储大量的空间位置信息。
音频则是一维的——它本质上是一条随时间变化的声波,就像一根绳子随时间上下起伏。专门处理音频的编解码器(神经音频编码器)天然地把音频压缩成一维的时间序列代码。也有一些方法会把音频先转换成“梅尔频谱图”(Mel-spectrogram,一种把声音的频率和时间信息可视化的二维图像,就像把声音画成了一幅热力图),再当作图像来处理。
两种格式的“形状”不一样(三维 vs 一维或二维),这给统一带来了天然障碍。关键的突破点来自于近年视觉领域的一个新进展:一些研究者(尤其是LARP等工作)证明,视频也可以被压缩成一维的离散代码序列,而且这种一维表示对于用自回归方式(Autoregressive,简单说就是像写文章一样,逐字逐词地按顺序生成内容的方式)生成视频非常友好——因为自回归模型本来就擅长处理一维的序列数据,就像擅长读句子一样。
音频编码器本来就是一维的,视频现在也可以是一维的——两者在格式上终于打通了!A VTok团队抓住了这个机会,选定一维离散潜在表示(即一串离散数字代码)作为统一表示视频和音频的格式,由此建立起统一的“词典”。
三、双流变压器:一套共用的大脑,两套专属的“方言字典”
确定了目标格式后,下一个问题是:如何设计具体的网络结构来实现这种统一编码?
研究团队的整体架构灵感来自专门处理音视频预训练任务的两项工作(CA V-MAE和CA V-MAE Sync),但做了根本性的改造。A VTok的编解码器(Encoder和Decoder)采用标准的Transformer(变换器,现代AI的核心组件,擅长处理序列数据并发现其中的关联)架构。
最关键的设计思路可以用一个比喻来理解:把A VTok的编解码器想象成一套同时服务于中文和英文读者的图书馆系统。图书馆的主体建筑、书架结构、管理系统都是共用的(这对应于共享的编解码器参数),但每种语言都有自己专属的分类索引和检索方式(这对应于各个模态专属的可学习查询向量和归一化层)。
具体来说,视频画面首先会被切分成一块块的“视觉小补丁”(patches),音频的梅尔频谱图也会被切分成“音频小补丁”。两套补丁分别进入A VTok的编码器,但它们走的是两条独立的前向传播路径(dual-stream forward pass,双流前向传播),每次只处理一种模态。在处理视频时,编码器会调用视频专属的归一化层参数;在处理音频时,则调用音频专属的归一化层参数。除了这两组专属的归一化层和可学习查询向量之外,编解码器的其余所有参数(包括自注意力层、前馈网络等绝大部分参数)是两个流共享的。
这种设计带来了两个好处。第一,共享参数使得两个模态的信息在训练过程中通过参数更新隐性地“对话”——音频的学习会对视频的参数产生影响,反之亦然,从而在没有明确交叉注意力的情况下促进音视频对齐。第二,模态专属的查询向量和归一化层保证了每个模态的独特特征不被另一个模态淹没,就像那本专属的分类索引能让你在共用图书馆里精确找到自己语言的书籍。
编码结束后,视频会产生1024个整体性离散代码(holistic tokens),音频会产生128个整体性离散代码,合计1152个代码。这些代码全部共用一个统一的代码本(codebook),即所有“词汇”来自同一本词典——这是实现表示统一的物理基础。
解码阶段同样对称:视频流使用1024个可学习的“补丁查询向量”来重建原始视频帧,音频流使用120个可学习的补丁查询向量来重建梅尔频谱图,最后梅尔频谱图通过一个预训练好的声码器(vocoder,一种把频谱图还原成实际音频波形的工具,A VTok默认使用HiFi-GAN)还原成真实可听的声音。
研究团队也测试了一个更简单的“单流版本”(vanilla version),即把视频和音频补丁直接拼接在一起,用一套统一的查询向量处理。实验结果表明,这个简单方案的性能明显不如双流版本,尤其是在音频重建质量上差距较大——原因正是缺乏模态专属的组件来保护每个模态的独立特征。
四、“先练左手再练右手”:解决训练难题的分层策略
有了好的架构还不够,训练一个能同时处理两种模态的模型本身就是一个充满陷阱的过程。
研究团队很快发现了一个核心问题:视频和音频携带的信息量差异悬殊。一段16帧、128×128分辨率的视频包含的像素信息量远大于对应时长的音频频谱图。这种“信息密度不平衡”会让模型在训练时不由自主地把绝大部分精力集中在处理视频上,音频的学习因此受到压制——就像一个班级里一个特别爱举手回答问题的学生,无形中挤占了其他学生的发言机会。
为此,研究团队设计了一套名为VFAL(Video-First-Audio-Later,视频优先、音频其后)的三阶段分层训练策略。
第一阶段持续75个训练轮次(epoch),专注于视频流的训练。此时音频相关的专属组件处于休眠状态,模型全力学习如何把视频压缩成一维代码再重建回来,同时建立一个稳固的离散潜在表示空间。
等到视频流的重建能力趋于稳定后,进入第二阶段,持续35个训练轮次。此时视频流和共享参数被冻结,模型只更新音频专属的查询向量和归一化层。因为梅尔频谱图可以被视为一张灰度图像,已经学会了如何处理图像的共享编解码器天然地能够被用于处理音频频谱——就像一个学会了弹钢琴的人学电子琴会更快一样。共享参数作为已经稳定的“底层能力”,帮助音频流快速起步。
第三阶段只持续10个训练轮次,对解码器的两个流同时进行微调,实现音视频联合重建的最终优化,打磨各自的输出质量。
这种分阶段的策略保证了每个模态都能在合适的阶段获得足够的“训练注意力”,避免了两条流相互干扰、两败俱伤的结果。
五、请“特级教练”来帮忙:表示对齐学习
即使有了双流架构和分阶段训练,研究团队还发现了另一个隐患:两个流之间的隐性融合(通过共享参数)不够主动,导致模型没有充分挖掘视频和音频之间的语义对应关系来提升重建质量。换句话说,图书馆里的中文书和英文书虽然用同一套管理系统,但没有人专门维护一本“中英对照词典”。
解决方案是引入一个外部的“特级教练”——一个预训练好的音视频基础模型CA V-MAE Sync(对比音视频掩码自编码器同步版)作为对齐监督信号来源。这个基础模型在海量的音视频数据上训练,已经学会了识别“拍手的画面”和“拍手的声音”在语义上是同一件事。
在训练A VTok时,研究团队把这个基础模型的中间层输出作为一种“标准答案”,强制要求A VTok编码器提取出来的视频补丁特征和音频补丁特征,能够与基础模型提取的对应特征保持一致(通过一个小型的多层感知机投影层hφ进行适配)。这个额外的训练目标被称为表示对齐损失Lrep,计算方式是最大化A VTok提取的特征与基础模型特征之间的相似度。
在训练时,基础模型本身是冻结的(不更新参数),只有那个小型投影层和A VTok自身在学习。基础模型在推断(实际使用)阶段会被丢弃,不会增加实际使用时的计算负担。消融实验(就是逐一去掉某个组件来看其贡献的对比实验)显示,去掉这个对齐损失后,音频重建质量的rFAD指标(越低越好)从5.93上升到8.48,视频的rFVD也略有下降——证明这个“特级教练”确实发挥了实质性作用。
六、让AI能“顺序生成”:自回归先验模型
完成了统一编码之后,A VTok还面临最后一个工程问题:那1152个离散代码的排列顺序是随意的,没有前后逻辑。这对于用“自回归方式”(逐步按顺序预测下一个代码)工作的生成模型来说是个麻烦,因为自回归模型依赖代码之间的有序关系来做预测,就像写文章依赖上下文。
为此,A VTok在训练时引入了一个轻量级的自回归先验模型MP(基于GPT-2架构)。这个先验模型在训练时和A VTok一起优化,通过“下一个代码预测”目标(Next Token Prediction,NTP)来倒逼编码器产生出具有良好顺序结构的代码序列——就像给一堆随机摆放的乐高积木施加了一个“先从地基开始搭”的约束,最终整体结构会变得有规律可循。
有趣的是,为了同时支持音频到视频(先给声音代码,再预测视频代码)和视频到音频(反向)两个方向的生成,研究团队在训练时简单地用两种代码顺序——视频代码在前加音频代码在后(xv∥xa),以及音频代码在前加视频代码在后(xa∥xv)——来同时计算这个预测损失。消融实验结果非常反直觉:去掉这个先验模型后,重建质量反而是所有配置里最好的(rFVD降到10.63,rFAD降到3.47),但下游生成任务的质量则是最差的。这和此前LARP的发现一致,表明先验模型在训练时扮演的是“引导代码空间有序化”的角色——牺牲了一点重建精度,换来了对生成任务更友好的代码结构。
七、训练结束后,先验模型悄悄离场
值得一提的是整个系统的一个精妙设计:CA V-MAE Sync基础模型和自回归先验模型MP在实际推断时都会被彻底丢弃。它们只在训练阶段发挥引导作用——最终用户调用的A VTok只包含编解码器和代码本,既轻量又高效,不会因为引入了额外的监督信号而增加使用时的计算成本。
八、三种下游任务:一套代码走天下
A VTok的1152个统一代码不仅用于重建,还可以直接接入自回归生成模型来完成三类不同的生成任务。
第一类是音频到视频生成(A2V):把音频编码得到的128个代码作为条件输入,让一个Llama风格的自回归变换器逐步预测出1024个视频代码,再由A VTok解码器还原成视频帧。两种模态之间的代码序列用一个特殊分隔符[SEP]标记隔开。
第二类是视频到音频生成(V2A):反过来,把视频的1024个代码作为条件,让模型预测128个音频代码,再经过声码器还原成声音。
第三类是类条件联合音视频生成(cJA VG):在序列最前面放一个类别标签代码[CLS](比如“狗叫”或“篝火噼啪声”),模型同时生成视频和音频的代码——这是最接近从零开始创造有声视频的任务形式。
这三种任务共用同一个208.4M参数的A VTok分词器和632M参数左右的AR生成模型,无需为每个任务单独训练分词器——这正是统一表示的核心价值。
九、实验结果:数字背后的故事
研究团队在VGGSound(约20万条带声音的视频,覆盖310个类别)和TA VGBench(约170万条样本)两个数据集上进行了实验,训练分词器时合计使用了约64万条数据,训练生成模型时使用了约18万条数据。
在重建质量方面,A VTok和视频领域的最强单模态对手LARP(使用1024个代码、128×128分辨率)比较时,A VTok的PSNR(图像保真度,越高越好)从24.53提升到25.62,rFVD(视频重建质量,越低越好)从14.24降低到12.80,LPIPS(感知质量,越低越好)从0.137降到0.126。这意味着A VTok在同时处理两种模态的前提下,视频重建质量不仅没有下降,反而超过了专门只做视频的对手——研究团队将此归因于音频信息的辅助提供了额外的语义约束,帮助视频重建“想得更清楚”。
在音频重建方面,A VTok与三个代表性的专用音频编解码器对比,在rFAD指标上以5.93的成绩明显优于Wa vTokenizer(6.82)和UniCodec(6.73),稍逊于SpectralCodec(5.56),在MR-STFT指标上也处于有竞争力的位置(1.523 vs SpectralCodec的1.514和UniCodec的1.508)。考虑到A VTok是一个同时承担视频和音频编码的统一模型,这个成绩相当扎实。
在下游生成任务中,A VTok-A2V(音频到视频生成)的gFVD为150.26,比采用10亿参数扩散模型的TempoTokens(786.61)大幅降低,IB-Score(语义对齐分数,越高越好)也从0.132提升到0.143,同时参数量仅是其三分之一左右。A VTok-V2A(视频到音频)的gFAD为49.47,处于所有对比方法的第二位,仅次于MMAudio(17.09),但A VTok所用的生成模型参数量不到MMAudio的一半,且推断效率更高(单样本生成耗时1.395秒 vs MMAudio的1.304秒,几乎持平)。在联合生成任务中,A VTok-cJA VG以138.80的gFVD和56.58的gFAD大幅超越Ja visDiT(1040.28 gFVD、268.51 gFAD)和Ovi(972.65 gFVD、129.02 gFAD),同时IB-Score为0.206,也优于两者——而且生成单个样本的耗时仅12.755秒,而Ovi需要87.282秒,Ja visDiT需要32.240秒。
在效率方面,A VTok的生成管线所需的TFLOPs(浮点运算量)为3.48(联合生成)到1.82(单向生成),而Ja visDiT需要2600,Ovi需要14990——差距达到数百乃至数千倍。
十、哪些地方还可以做得更好
研究团队在论文中诚实地列出了现有工作的几个局限性。
目前训练使用的数据规模相对有限(64万条),场景也受限于VGGSound和TA VGBench的内容分布(主要是动物、乐器、日常生活场景),当面对更复杂或更多样化的场景时可能会出现生成瑕疵。
模型目前只能处理固定分辨率(128×128)的视频和固定长度(约4秒)的音频——这是Transformer位置编码的先天限制,工业级应用通常需要更高分辨率和更长时长的支持。
在时间同步方面,现有架构对音视频之间的精确时间对齐依赖于隐性的参数共享和因果自注意力机制,没有设计明确的同步建模组件,因此在对口型、音乐节拍配舞这类需要高精度时间对齐的任务上仍有提升空间。
此外,VFAL分阶段训练策略虽然有效,但操作比较繁琐——每个阶段的超参数需要单独调整,且阶段间的误差可能会累积。未来如果能设计出单阶段端到端的训练方案,将进一步简化使用门槛,尽管这会带来更高的优化难度和计算成本。
说到底,A VTok做的事情其实并不神秘:它试图让AI学会像人类一样,把视频和声音当成一个整体来理解和生成,而不是分别处理两段孤立的信息再强行拼接。这件事听起来自然,做起来却需要一套精心设计的架构和训练策略——双流共享编解码器、模态专属查询向量、三阶段分层训练,再加上音视频基础模型的语义对齐监督。
对于普通用户来说,A VTok这类技术成熟后意味着:AI生成“配套声音的视频”或“配套视频的声音”的成本会大幅下降,而且生成出来的内容在语义上更能“对得上”——不再是画面说一套、声音说另一套的奇怪体验。从影视辅助创作、游戏音效自动生成到社交媒体内容制作,这类技术的商业化潜力相当广阔。
对于研究者来说,A VTok提供了一个重要的参考方向:统一的多模态离散表示,加上设计良好的分流架构和分阶段训练,可能是在资源有限的条件下挑战大参数双分支方案的有力替代路径。
如果你对这项工作的完整技术细节感兴趣——包括每一个损失函数的具体权重、每阶段训练的精确设置,以及更多的可视化样本——都可以通过arXiv编号2606.30811查阅原始论文,研究团队也承诺会公开代码、模型检查点和数据集。
Q&A
Q1:A VTok和普通的视频生成AI有什么本质区别?
A:普通的音视频生成AI通常用两套独立的系统分别处理视频和音频,两者“语言”不通,容易导致声画不匹配。A VTok则用一套共用的编解码器把视频和音频同时压缩进同一组数字代码,两者从一开始就在同一个“语言环境”里学习,生成时自然更容易语义对齐。
Q2:A VTok的1152个代码是视频和音频各占多少?
A:A VTok把视频编码成1024个整体性离散代码,把音频编码成128个整体性离散代码,合计1152个代码,全部来自同一个共享的代码本(词典)。视频代码数量远多于音频代码,也反映了两种模态信息密度的差异。
Q3:VFAL训练策略为什么要先训练视频再训练音频?
A:因为视频信息密度远高于音频,如果同时训练,模型会把绝大部分“注意力”都放在视频上,压制音频的学习。先单独训练视频流,让共享参数稳固下来,再冻结这些参数、专门训练音频专属组件——就像先打好地基再装修,能保证两种模态都得到充分的训练机会。
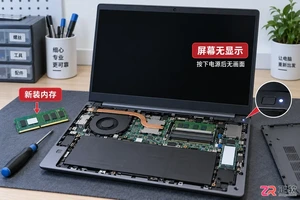
笔记本加装新内存后遇到黑屏或无法开机?不要慌张,本文通过重新插拔、清洁金手指、单根测试等具体操作步骤,帮你快速判断是安装失误还是硬件不兼容,并给出相应解决办法。
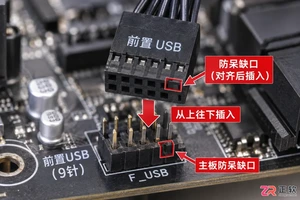
针对电脑主机前置USB接口无法识别设备的问题,本文提供一套基于因果逻辑的排查流程。涵盖检查机箱内部USB针脚连接、验证BIOS中USB控制器状态、更新芯片组驱动以及排除供电不足等常见原因,帮助用户快速恢复接口功能。
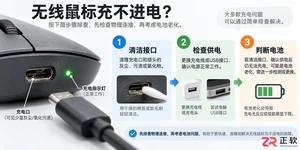
遇到无线鼠标充不进电的问题,不要急于更换设备。本文详解从清理接口氧化层、更换数据线到检测电池电压的完整排查流程,帮助你判断是临时故障还是硬件损坏。
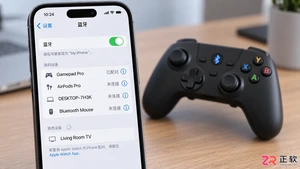
想知道如何用蓝牙手柄玩吃鸡游戏?本文详细讲解手机蓝牙手柄的连接步骤、主流映射软件的使用方法以及实战中的键位布局技巧,助你提升射击手感,同时解析外设玩家的匹配机制与注意事项。
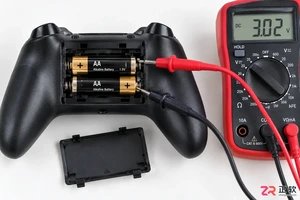
本文深入分析游戏手柄蓝牙频繁断开且需重连的根本原因,涵盖电池电压检测、操作系统电源管理策略及驱动冲突。通过具体的系统设置调整和固件更新步骤,解决蓝牙握手失败问题,恢复手柄的稳定连接状态。
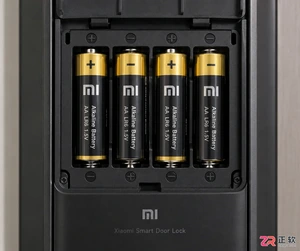
小米智能门锁更换新电池后无法开机或屏幕不亮?本文详解电池极性检查、金属触点清洁及强制重启方法,帮你快速解决供电问题,让门锁恢复正常使用。
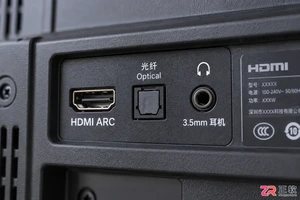
想让电视声音更震撼?本文详解如何通过HDMI ARC、光纤、蓝牙和3.5mm接口将电视连接至外置音响,包含具体设置步骤与常见问题排查,助你轻松打造家庭影院。
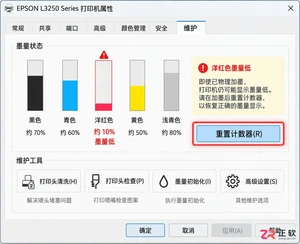
解决打印机加墨水后打印无色的问题,涵盖墨盒芯片计数器重置、喷头气锁排除方法以及驱动程序颜色设置检查,帮助用户快速恢复彩色打印功能。
面对主机运转正常但显示器无信号的困境,本文通过场景化分析,指导用户从线缆检查、输入源切换、内存金手指清洁到显卡重新插拔,逐步排除故障,恢复显示。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。