

明尼苏达大学等机构联手打造"进化式微调"
明尼苏达大学等机构提出进化式微调(EFT),收集371个优化任务的17万条进化轨迹训练开源小模型,得到Finch系列。在22个陌生任务上平均提升10.22%,展现出跨领域知识迁移能力,较小模型可超越未训练的大模型。
这项由美国明尼苏达大学主导,联合卡内基梅隆大学、韩国科学技术院、剑桥大学、汉阳大学等多所机构共同完成的研究,以arXiv预印本形式于2026年6月27日发布,论文编号为arXiv:2606.29082。有兴趣深入钻研原文的读者,可以通过这个编号直接检索完整论文。
AI解题高手的尴尬:每次都要从零开始
假设你是一位经验丰富的棋手,每次坐到棋盘前,你都会凭借多年积累的直觉——哪里该进攻,哪里该防守,什么时候该退一步——做出精妙决策。然而,现有的AI系统却面临一个奇怪的困境:它们每次面对新问题,都像是刚学会下棋的新手,完全不记得上一局学到了什么。
核心问题可以这样理解:在数学、编程、芯片设计、生物信息学等领域,有一类特别棘手的问题——没有标准答案,你只能给候选解法打分,然后不断尝试、改进,最终找到最好的那个。比如一个数学猜想的极端情况,或者如何让GPU运算得更快。这类问题统称为“优化任务”。
近年来,把大语言模型和“进化搜索”结合起来,已经在这类任务上取得了惊人成果。具体流程是这样的:让AI不断提出新的候选解法,计算机系统自动给这些解法打分,然后选出最好的几个,再让AI基于这些好解法进一步改进,如此循环往复。这种流程被形象地称为“进化搜索脚手架”。
然而,这套系统有一个根本性的缺陷:AI本身并没有真正“学会”如何进化。它每次解题时积累的经验,在任务结束后就被扔掉了。换句话说,AI是一个失忆的棋手——它赢了几百局棋,却没有把任何经验存进记忆里,下一次还是从零开始。
当前做法的三层局限
现有的进化搜索方法大体上分成两类,但都有明显的短板。
第一类叫“测试时搜索”。意思是,在解题过程中,AI的参数完全不变,由外部的脚手架系统来控制搜索策略。这就像是一个聪明的顾问,但他的所有知识都藏在公司手册里,而不是在他自己脑子里。这类方法通常需要依赖非常强大的商业AI(比如GPT-5、Claude等),因为脚手架在每一轮都需要AI给出高质量的候选解法。稍差一点的AI就会在这个流程里频繁出错。研究团队发现,参数量小于90亿的开源模型在这类流程中往往表现很差——就像是让一个初中生直接参加博士答辩一样吃力。
第二类叫“测试时学习”。这种方法允许AI在解题过程中更新自己的参数,相当于让它边解题边学习。这确实让较小的模型也能胜任,而且已经在一些数学难题上取得了新的最优解。然而,这种学习是专属于单个任务的:AI在解A问题时学到的技巧,无法自动迁移到解B问题上。就像是一个学生每次考试前临时抱佛脚,考完就忘——每次考试都要重新临时准备。
更本质的问题是,无论哪类方法,AI自身都没有真正内化“如何进化解法”这项能力。这项能力始终存在于外部的脚手架系统里,而不是AI本身的思维方式。
达尔文雀的启示
研究团队从一个生物学故事中获得了灵感。达尔文在加拉帕戈斯群岛发现,同一种雀鸟在不同的岛屿上演化出了不同形状的喙——有的适合啄硬壳坚果,有的适合吸花蜜,有的适合捕虫。这些雀鸟并不是针对某一个特定食物源设计的专家,而是通过在多样化的环境压力下不断适应,形成了跨环境的适应能力。
研究团队把他们的方法命名为“进化式微调(Evolution Fine-Tuning,EFT)”,而把训练出的模型系列称为“Finch”(芬奇,即雀鸟)。这个名字背后有深刻的隐喻:他们希望AI像达尔文雀一样,通过在大量不同的优化任务上积累经验,形成一种跨领域、跨任务的通用进化能力——而不是只会在单一任务上发力。
一次“练习赛”:收集17万条进化轨迹
EFT的核心思路可以用一句话概括:把AI在进化搜索过程中的历史记录,当作训练素材来教给另一个AI。
具体来说,研究团队首先收集了371个来自不同领域的优化任务。这些任务涵盖范围极广,从数学猜想(如厄多斯最小重叠问题)、竞技编程题、数值算法优化、GPU内核设计、符号回归(从数据中找出物理公式)、生物信息学(单细胞RNA数据去噪)到各类组合优化难题,几乎跨越了计算科学的每一个重要方向。
接下来,研究团队用一个名为OpenEvolve的开源脚手架系统,驱动一个极其强大的大模型(Qwen3.5-397B,参数量达3970亿)在这371个任务上分别进行进化搜索。每一次搜索迭代都会产生一条“轨迹”:记录当前候选解法、历史上已有的好解法、打分系统的反馈,以及AI是如何在这些信息基础上提出下一个候选解法的。
这个过程一共产生了172,997条原始轨迹,相当于17万次“进化尝试”的完整日志。
当然,不是所有的日志都值得学习。研究团队做了严格的清洗工作。他们剔除了三类不应该被模仿的轨迹:一是系统错误轨迹,比如程序运行超时、语法错误、打分系统崩溃等技术性失败(共6321条,约3.7%);二是“无可救药”的情况,即不仅AI给出的新解法有错,连它参考的上一个解法本身也是错的,在这种情况下AI很难学到任何有意义的东西(共1575条,约0.9%);三是过长的样本,为了让训练稳定,他们去掉了那些输入或输出超过特定长度限制的轨迹(约5.0%)。
清洗之后,最终保留了156,731条轨迹,构成了一个名为“Finch Collection”的数据集,这也是目前已知规模最大、领域最多样的优化轨迹数据集。
这个数据集本身就有很多有趣的特征。从编程语言来看,Python占68.5%,C++占31.5%;从改进策略来看,“基于差异的局部修改”(只改一部分代码)和“整体重写”(完全重写解法)各占约一半,非常均衡。从轨迹内容来看,有39.4%的轨迹是“真正改进了”的(得分比上一版高),有19.2%是“没有变化的”,有41.3%是“退步的”。
这里有个重要的设计选择:研究团队最终主要使用“真正改进了”的那39.4%的轨迹来做监督学习,因为让AI专门模仿那些导致退步的操作,会干扰训练效果——就像是让学生专门记住错题的错误解题过程,而不是正确解法。至于那些“退步”的轨迹,研究团队通过另一种叫做“偏好学习”(KTO算法)的方式加以利用,让AI学会区分哪些操作是好的、哪些是坏的,从而培养“品味”。
从输入输出长度的关系来看,这个数据集还揭示了一个有趣的现象:输入长度平均约8902个词元(相当于大概7000个单词),而输出(也就是AI给出的新候选解法)平均只有6865个词元。这说明AI需要从大量历史信息中“挑拣”出有用的信号,然后高效地生成改进。在那些“没有改进”的轨迹中,AI的输出反而更长——平均是改进轨迹输出长度的2.9倍——这说明AI在进化陷入瓶颈时,会用更长的思考过程来尝试突破,尽管未必成功。
Finch的诞生:用进化历史训练进化能力
有了Finch Collection之后,研究团队用它来微调了一系列较小的开源模型:Qwen3.5系列的2B、4B、9B,以及Qwen3-8B,得到了Finch-2B、Finch-4B、Finch-8B、Finch-9B四个新模型(B代表十亿参数)。
微调的方式非常直接:给模型看一条轨迹,让它学会“在这种状态下(当前有哪些候选解法、历史上有哪些尝试、打分系统给出了什么反馈),下一步应该怎么改”。这就是EFT的本质——把进化搜索的“实战经验”直接编码进模型的神经网络权重里。
为了防止某些任务的轨迹数量过多影响训练平衡(比如符号回归任务产生了大量轨迹),研究团队对每个任务只取一条改进轨迹进行训练,最终共使用了30,445条训练轨迹,在8块NVIDIA H200 140GB GPU上训练了一个周期。
测试:跨越22个陌生任务的能力迁移
这批Finch模型究竟学到了什么?研究团队对它们进行了一次严格的“陌生任务测试”。他们选取了22个完全没在训练中间出现过的任务,横跨5个领域:数学发现(包括厄多斯最小重叠问题、自相关不等式、圆形填充、Hadamard行列式等)、算法工程(AtCoder竞赛题)、系统性能优化(大语言模型推理加速、数据库优化等)、竞技编程(UC伯克利的CALICO竞赛题)和算法启发式优化。
结果显示,在同等规模下,Finch系列模型在22个任务上平均比对应的基础模型提升了10.22%。最引人注目的改进发生在ahc058任务(一个日本竞技编程平台上的优化题)上,Finch-9B的得分比基础模型提升了惊人的290.59%——基础模型的初始得分接近于零,Finch让它从几乎无法完成任务,变成了能拿到5.25亿分的水平。在Transaction(数据库事务处理优化)任务上,Finch-4B也取得了74.30%的相对提升。
更有趣的是,经过EFT训练的较小模型,有时能超过没有经过EFT训练的更大模型:Finch-4B在厄多斯问题上的得分(0.386460,越低越好)已经接近Qwen3-8B的水平(0.403585),尽管Finch-4B的参数量只有后者的一半。这说明EFT不仅是在“量”上扩展模型的能力,更是在“质”上改变了模型思考问题的方式。
一个令人惊喜的涌现现象:跨领域知识搬运
研究团队在分析Finch如何解决一道竞技编程题(CALICO P263)时,发现了一个出乎意料的现象。基础模型在面对这道题时,整个搜索过程始终徘徊在同一种方法(高斯-赛德尔均匀权重迭代)附近,反复尝试同一个方向,像是一个只会用锤子的工匠,所有问题都试图用锤子解决。
Finch则完全不同。它在搜索过程中先后从好几个不同的领域里调取了解决方案:从推荐系统领域借来了“对数域交替最小二乘法(一种处理矩阵分解问题的技术)”、从数值优化领域引入了“莱文贝格-马夸特算法(一种处理非线性最小化问题的方法)”、从鲁棒统计和计算机视觉领域搬来了“随机抽样一致(RANSAC)”思路(一种剔除异常点的技术)。最终,Finch把这些来自不同领域的工具组合起来,拼装出了一个远超基础模型的解法。
这种“跨领域知识迁移”并非设计之初就预期的,它是EFT带来的一种涌现能力——正是因为Finch在训练时接触了来自推荐系统、数值优化、鲁棒统计等10个不同领域的进化轨迹,它学会了在遇到新问题时,把来自不同领域的工具灵活组合。就像一个同时学过烹饪、化学和工程学的人,在面对一个复杂的料理挑战时,能同时调用这三个领域的知识,而不是只会用一种方法。
训练任务数量越多,跨任务能力越强
研究团队还专门测试了“训练任务数量”对Finch能力的影响。他们把训练任务从15个逐步增加到187个,再到355个,观察模型在3个固定测试任务上的表现变化。
结果呈现出清晰的上升趋势。以AC2(第二自相关不等式)为例,当训练任务仅有15个时,模型得分约为0.8801;增加到187个任务后,得分提升到0.8907;再增加到355个任务,得分进一步攀升到0.9122。在圆形填充(CP n=26)和PRISM(一种AI推理加速框架优化)任务上,也呈现出类似的稳步提升趋势。
这个结果非常重要,因为它说明Finch Collection的训练信号是“可扩展的”:收集越多样化的任务轨迹,模型学到的通用进化能力就越强。换句话说,这不是一种只在特定任务上有效的技巧,而是真正在模型参数层面内化了“如何进化”这项通用技能。
让Finch再上一层楼:与在线强化学习结合
EFT被研究团队定位为一种“中间训练”——它发生在基础模型预训练之后、实际部署应用之前。这个定位让Finch和另一类方法“测试时强化学习”(在解题过程中实时更新模型参数)之间不是竞争关系,而是可以叠加的互补关系。
研究团队在三个数学优化任务上验证了这种叠加效果。他们用一个名为nanodiscover的开源系统(对原始TTT-Discover方法的复现)来对Finch-8B进行测试时强化学习。结果显示,Finch-8B在两个圆形填充任务(CP n=26和CP n=32)上,达到了与当前已知最优方法完全相同的成绩(2.635983和2.939573),超越了此前仅用基础模型进行测试时学习的结果。在厄多斯问题上,Finch-8B结合测试时强化学习后,也比单纯用基础模型进行测试时学习的版本提升了约3.2%。
值得一提的是,即便不做测试时强化学习,仅仅把Finch作为进化搜索中的“变异算子”(提出新候选解法的角色),它也已经能在多个任务上逼近用昂贵商业大模型(如Claude-Opus-4.6)才能达到的效果。这对于计算资源有限的研究者来说,意义重大。
偏好学习:教Finch“品味好坏”
除了主要的监督微调,研究团队还探索了让Finch同时接触“改进轨迹”和“退步轨迹”,通过一种叫KTO的偏好学习算法,让模型学会判断哪些操作方向是有前景的,哪些是徒劳的。
从实验数据来看,这种偏好学习进一步提升了Finch的发现能力。以Finch-8B为例,仅做监督微调时在AC1任务上的得分是1.5154(越低越好),加上KTO偏好学习后进一步降低到1.5089,甚至超越了最佳人类记录(1.5097)。在AC2任务上,加入KTO的Finch-8B得分达到0.9146,同样超越了最佳人类记录(0.9015)。
这个发现意味着,除了“学会生成好解法”,让AI同时“学会区分好解法和坏解法”,也是内化发现能力的一条有效途径。
一个具体案例:Finch是如何优化2D卷积的
研究团队还提供了一个具体的案例研究,展示Finch在Convolve2D(二维卷积加速)任务上的行为。
二维卷积是图像处理和深度学习中的基础操作,优化它的计算速度具有广泛的实际意义。基础模型在这个任务上,搜索轨迹主要停留在用SciPy库进行实现,改来改去也难以突破性能瓶颈。
Finch-9B则展示出了完全不同的行为:它在搜索过程中逐步引入了JAX、XLA等工具,通过利用JAX的即时编译特性和零拷贝内存传输优化,将实现从SciPy框架迁移到了JAX框架。最终,Finch-9B在这个任务上取得了124.85的速度分,而基础模型只有121.96——提升约2.4%。
研究团队分析认为,这种行为来自Finch在训练时大量接触了JAX相关的轨迹,特别是来自不确定性不等式和矩阵乘法任务的经验,让它在面对卷积加速任务时,能够联想到用JAX来改写实现。
局限性与未来方向
当然,这项研究也有一些明显的不足,研究团队自己也坦诚地进行了讨论。
首先,目前Finch Collection的轨迹全部来自OpenEvolve这一个进化搜索脚手架,这意味着Finch学到的主要是“如何在OpenEvolve框架下进化”,在其他脚手架(如更先进的EvoX)中的泛化能力还有待验证。未来可以通过混合来自不同脚手架的轨迹来缓解这个问题。
其次,测试时强化学习的实验目前只在几个数学任务上进行了验证,而现实中更广泛的工程任务(如GPU内核优化)中,这种协同效果是否同样存在,还需要进一步研究。
另外,当前的框架是“单轮”的:每次生成一个新候选解法,都是在看完历史信息之后一次性输出。未来可以探索“多轮对话”式的进化——让模型能够不断回溯、反思、逐步改进,像人类研究者一样进行迭代思考。
最后,科学发现并不局限于文字和代码,许多领域(如生物学、化学)还需要解读图像和实验数据。EFT的思路理论上可以扩展到多模态场景,这是一个值得深入探索的方向。
说到底,这项研究做了一件很“朴素”但也很深刻的事:把AI在解题时积累的经验,从“用完即扔”变成了“融入血液”。就像一个经历了大量不同地形训练的马拉松运动员,不管是爬山还是下坡还是平路,都能调用相应的肌肉记忆——而不是每次跑步都从零开始学习如何迈步。
对于普通读者来说,这项研究的潜在意义在于:它让那些通常只有配备昂贵商业大模型才能运行的科学发现工具,开始变得对较小的开源模型也友好。这可能会让更多研究机构、初创公司乃至个人研究者,也能享受到AI驱动的科学发现能力,而不必依赖价格高昂的商业API服务。
关于这项研究的完整细节,感兴趣的读者可以通过arXiv编号2606.29082查阅原始论文,所有代码、数据集和模型权重也已经随论文一同开放。
Q&A
Q1:Evolution Fine-Tuning(EFT)和普通的大模型微调有什么区别?
A:普通微调是让模型学会“对某类问题给出正确答案”,而EFT训练的是“如何不断改进一个已有方案”这项元能力。EFT的训练数据不是问题-答案对,而是完整的进化搜索轨迹——记录了AI在一步步改进解法过程中的全部中间状态。这让模型学会的是“进化思维方式”,而不是某个特定问题的解法。
Q2:Finch Collection数据集中的371个任务都是哪些类型的问题?
A:Finch Collection涵盖了10个大类:数学发现(如厄多斯问题、圆形填充)、竞技编程(172道FrontierCS题)、数值算法优化(47个算法加速任务)、启发式优化(35个AtCoder竞赛题)、符号回归(物理振荡和化学反应的公式发现)、GPU内核优化、生物信息学(单细胞RNA去噪)和构造搜索等,跨越了计算科学的主要方向。
Q3:EFT训练出的Finch模型,在没有见过的新任务上表现怎么样?
A:在22个完全陌生的任务上,Finch系列模型平均比对应的基础模型提升了10.22%。最大的单任务提升发生在ahc058上,达到了290.59%。此外,经过EFT的较小模型有时能超过没有EFT的更大模型,比如参数量只有40亿的Finch-4B,在厄多斯问题上已接近参数量80亿的基础模型水平。
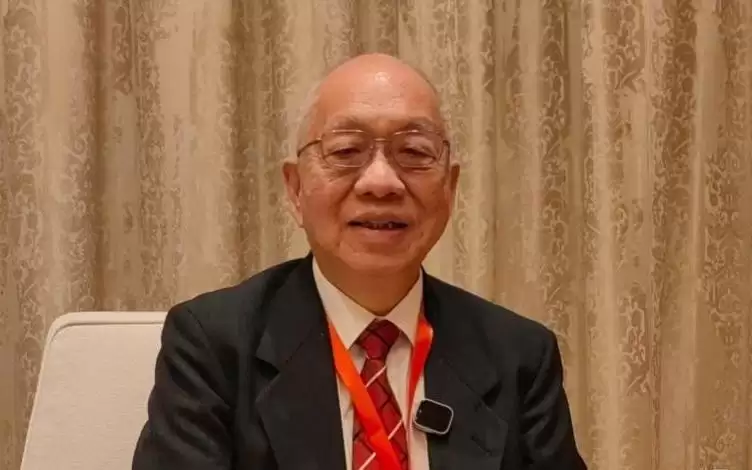
第三十六届国际弦理论大会首次在上海开幕,约700名学者参会。丘成桐指出,上海数学与交叉学科研究院已成为亚洲理论物理研究标杆。中国弦理论研究过去五年进步显著,有望在5到10年内追赶世界一流水平。
为纪念谷超豪先生百年诞辰,5月10日将在上海科技馆举办专题科普讲座。李大潜院士将回顾谷超豪从数学少年成长为学科开拓者的历程,展现其科学精神传承。沈维孝院士则以多项式求根为例,引领听众领略数学的深邃与精巧。这是一次与顶尖学者对话、感受数学魅力的难得机会。
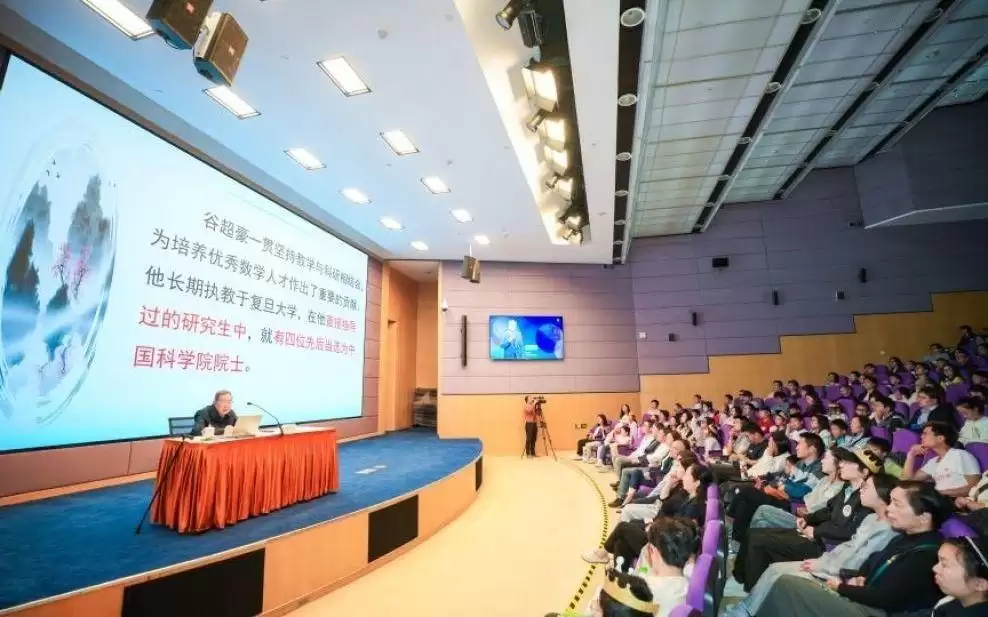
5月15日,是一个值得铭记的日子——著名数学家、中国科学院院士、2009年度国家最高科学技术奖获得者谷超豪先生诞辰一百周年。 为纪念这位科学巨擘的卓越贡献,弘扬其探索真理的科学家精神,并将基础研究的魅力传递给更广泛的公众,一场特别的科普活动于5月10日在上海科技馆报告厅举行。这便是第240期上海科普
AI能读懂孩子的数学草稿吗?这项研究给出了耐人寻味的答案 2026年3月,一份由李海大学、松鼠AI学习、中科院自动化所等五所知名院校联合完成的研究,被发布在arXiv预印本平台上(编号:arXiv:2603.24961v1)。这项研究做了一件挺有意思的事:它第一次系统地探究了那些“多才多艺”的多模态
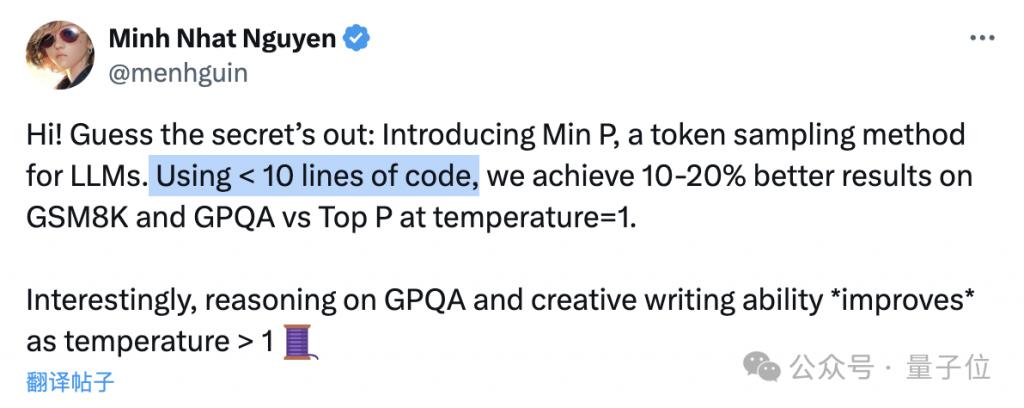
只要不到10行代码,就能让大模型数学能力(GSM8k)提升20%!几名独立学者提出了大模型采样的改进方案,引起了开源社区的关注。目前该方法已在Mistral-7B上取得成效,在Llama3-70B上的测试也正在进行。这种方法叫做最小p采样(min-psampling),目的是平衡生成文本的连贯性和多样性。简单说就是让模型在不同场合发挥不同的特性,例如在事实问题上保持性能稳定,在写作等场景中又能发挥创意。目前该方法已在Mistral-7B上取得成效,在Llama-70B上的测试也即将进行。在论文中作者提到,
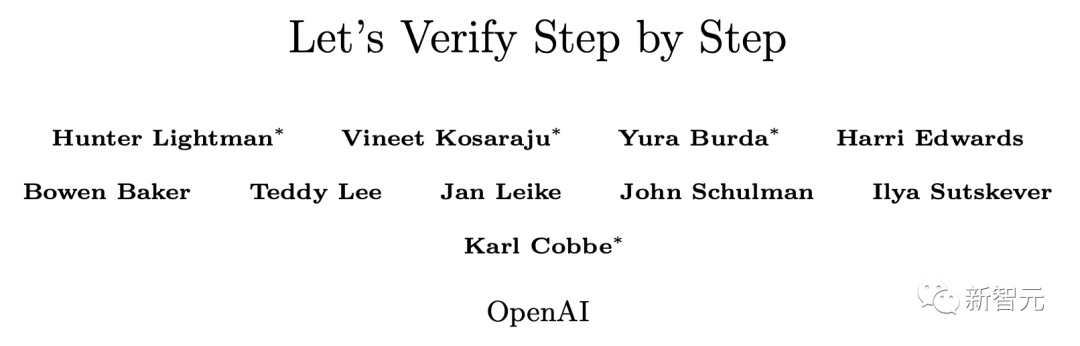
ChatGPT自发布以来,数学能力饱受诟病。就连「数学天才」陶哲轩曾表示,GPT-4在自己的数学专业领域,并没有太多的增值。怎么办,就一直让ChatGPT做个「数学智障」么?OpenAI在努力——为了提升GPT-4的数学推理能力,OpenAI团队用「过程监督」(PRM)训练模型。让我们一步一步验证!论文地址:https://cdn.openai.com/improving-mathematical-reasoning-with-process-supervision/Lets_Verify_Step_by
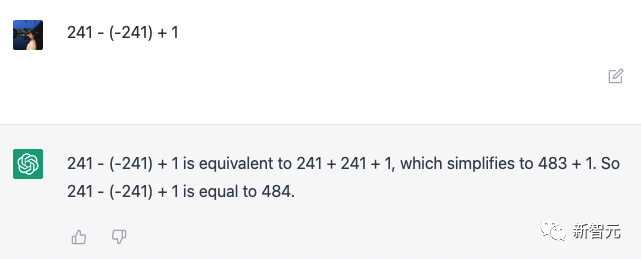
大型语言模型最为人诟病的缺点,除了一本正经地胡言乱语以外,估计就是「不会算数」了。比如一个需要多步推理的复杂数学问题,语言模型通常都无法给出正确答案,即便有「思维链」技术的加持,往往中间步骤也会出错。与文科类的自然语言理解任务不同,数学问题通常只有一个正确答案,在不那么开放的答案范围下,使得生成准确解的任务对大型语言模型来说更具挑战性。并且,在数学问题上,现有的语言模型通常不会对自己的答案提供置信度(confidence),让用户无从判断生成答案的可信度。为了解决这个问题,微软研究院提出了MathProm
2022年10月中旬,JustinGilmer从加利福尼亚飞往纽约,在东海岸拜访了他以前的导师MichaelSaks,一位罗格斯大学的数学家。叙旧期间,他们并未谈及数学。事实上,自从2015年在罗格斯大学获得博士学位后,Gilmer就再没认真思考过数学问题。那时候他决定不在学术界发展,同时开始自学编程。当他和Saks共同用餐时,Gilmer向导师讲述了自己在谷歌的工作:机器学习和人工智能。在校园的小路上,Gilmer边走边回忆,2013年,他花了一年多的时间走在这条路上,思考
ChatGPT可能是一位废话艺术家、错误信息的传播者,但它不是「数学家」!近日,一位Meta的数据科学家ColinFraser发现,ChatGPT并不能生成真正的随机数,而更像是「人类的随机数」。通过实验,Fraser得出的结论是:「ChatGPT非常喜欢数字42和7。」网友表示,意味着人类非常喜欢这些数字。ChatGPT也爱「宇宙终极答案」在他的测试中,Fraser输入的prompt如下:「Pickarandomnumberbetween1and100.Justreturnthe
MiniMax-H3-Image新增DiffSynth-Studio文档推荐后,配置选择应围绕具体推理配方和独立训练流程展开。文档中的24GB GPU方案分别配合32GB或8GB主机RAM,所用量化、CPU或磁盘卸载方式不同;新增文档入口本身没有发布模型新权重或标注一个新的框架版本。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



