

GPT-4数学能力大蹦极!OpenAI爆火研究「过程监督」突破78.2%难题,干掉幻觉
ChatGPT自发布以来,数学能力饱受诟病。就连「数学天才」陶哲轩曾表示,GPT-4在自己的数学专业领域,并没有太多的增值。怎么办,就一直让ChatGPT做个「数学智障」么?OpenAI在努力——为了提升GPT-4的数学推理能力,OpenAI团队用「过程监督」(PRM)训练模型。让我们一步一步验证!论文地址:https://cdn.openai.com/improving-mathematical-reasoning-with-process-supervision/Lets_Verify_Step_by
ChatGPT自发布以来,数学能力饱受诟病。
就连「数学天才」陶哲轩曾表示,GPT-4在自己的数学专业领域,并没有太多的增值。
怎么办,就一直让ChatGPT做个「数学智障」么?
OpenAI在努力——为了提升GPT-4的数学推理能力,OpenAI团队用「过程监督」(PRM)训练模型。
让我们一步一步验证!
论文地址:https://cdn.openai.com/improving-mathematical-reasoning-with-process-supervision/Lets_Verify_Step_by_Step.pdf
论文中,研究人员训练模型通过奖励每一个正确的推理步骤,即「过程监督」,而不仅仅是奖励正确的最终结果(结果监督),在数学问题解决方面取得最新SOTA。
具体来讲, PRM解决了MATH测试集代表性子集中78.2%的问题。
此外,OpenAI发现「过程监督」在对齐上有很大的价值——训练模型产生人类认可的思维链。
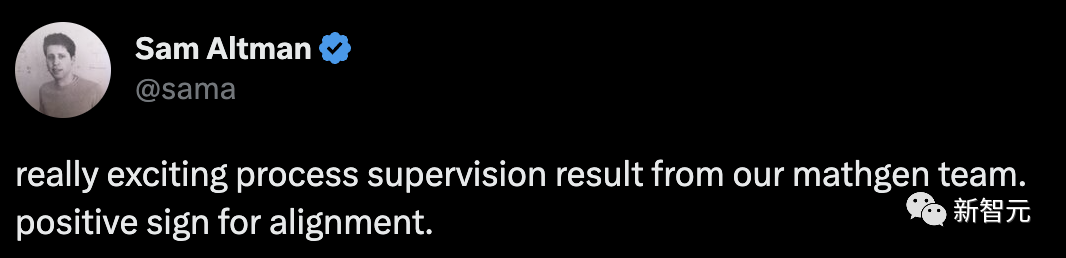
最新研究当然少不了Sam Altman的转发,「我们的Mathgen团队在过程监督上取得了非常令人振奋的结果,这是对齐的积极信号。」
在实践中,「过程监督」因为需要人工反馈,对于大模型和各种任务来说成本都极其高昂。因此,这项工作意义重大,可以说能够确定OpenAI未来的研究方向。
解决数学问题
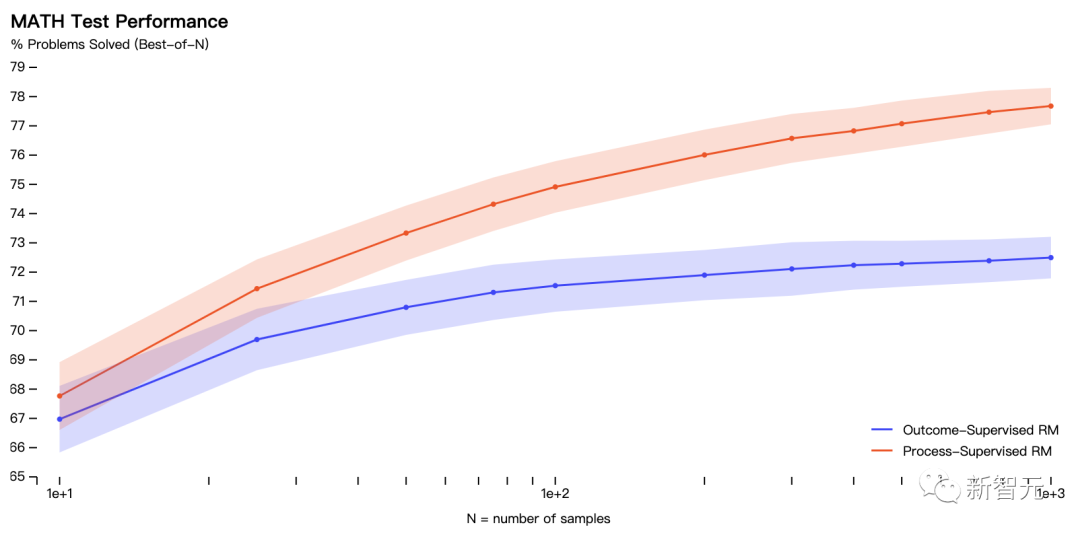
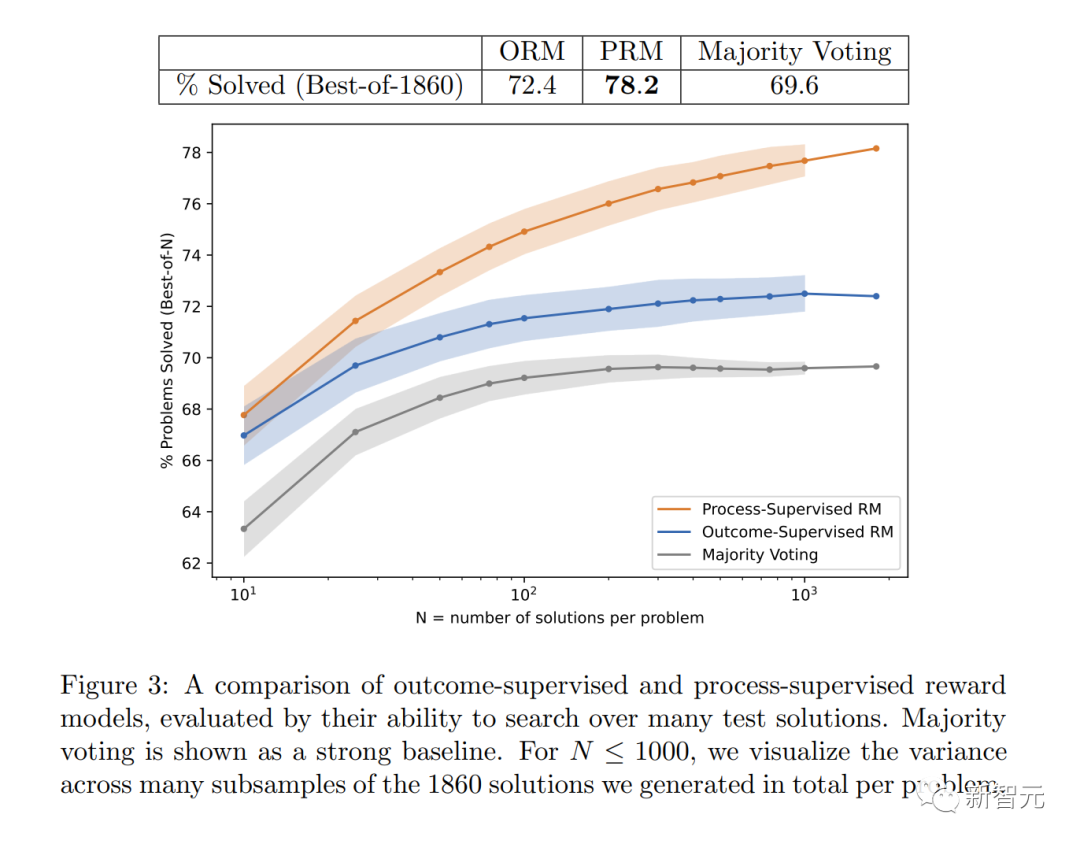
实验中,研究人员用MATH数据集中的问题,来评估「过程监督」和「结果监督」的奖励模型。
让模型为每个问题生成许多解决方案,然后挑选每个奖励模型排名最高的解决方案。
如图显示了所选解决方案中,取得正确最终答案的百分比,作为所考虑解决方案数量的函数。
「过程监督」奖励模型不仅在整体上表现更好,而且随着考虑每个问题的更多解决方案,性能差距也在扩大。
这表明,「过程监督」奖励模型更加可靠。
如下,OpenAI展示了模型的10个数学问题和解决方案,以及对奖励模型优缺点的评论。
从以下三类指标,真正(TP)、真负(TN)、假正(FP),对模型进行了评估。
真正(TP)
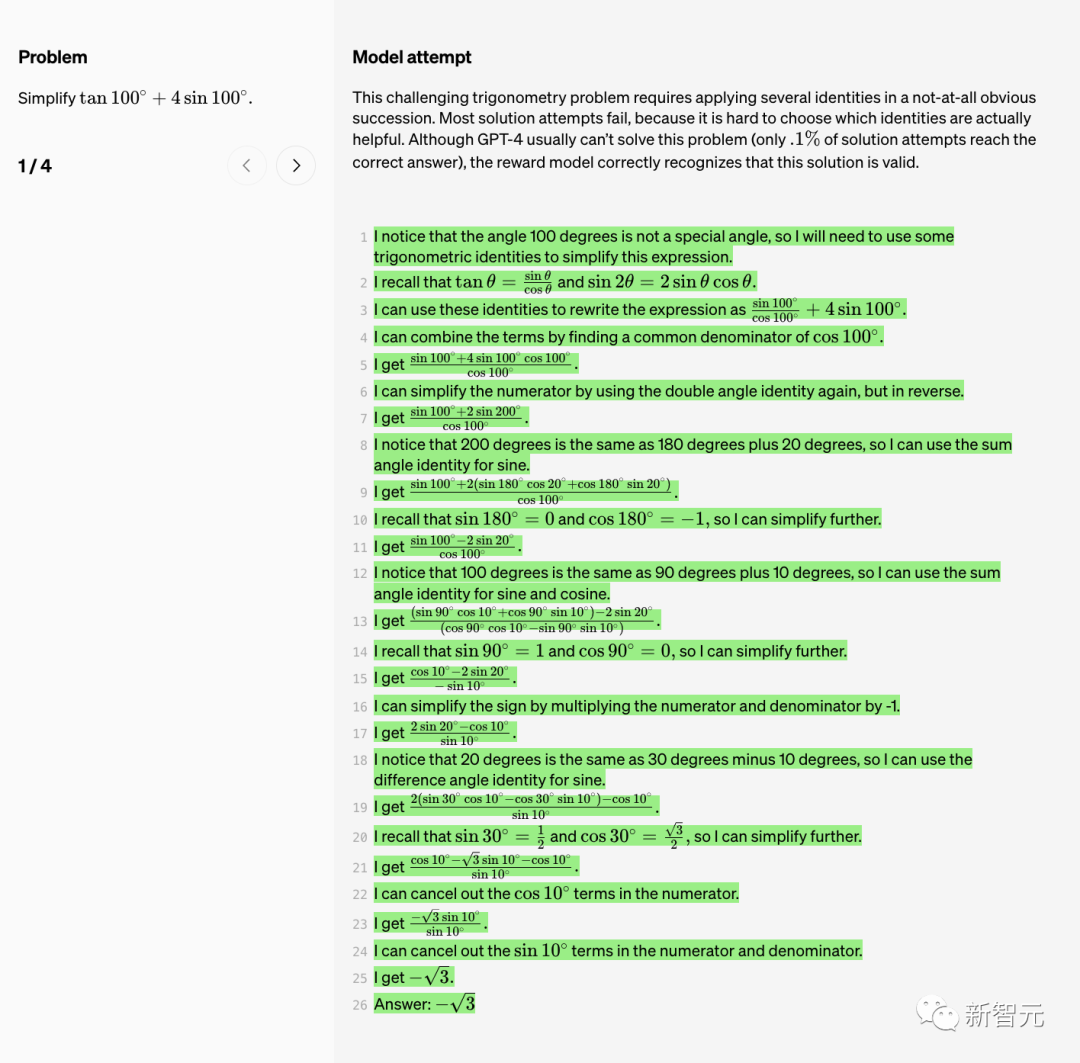
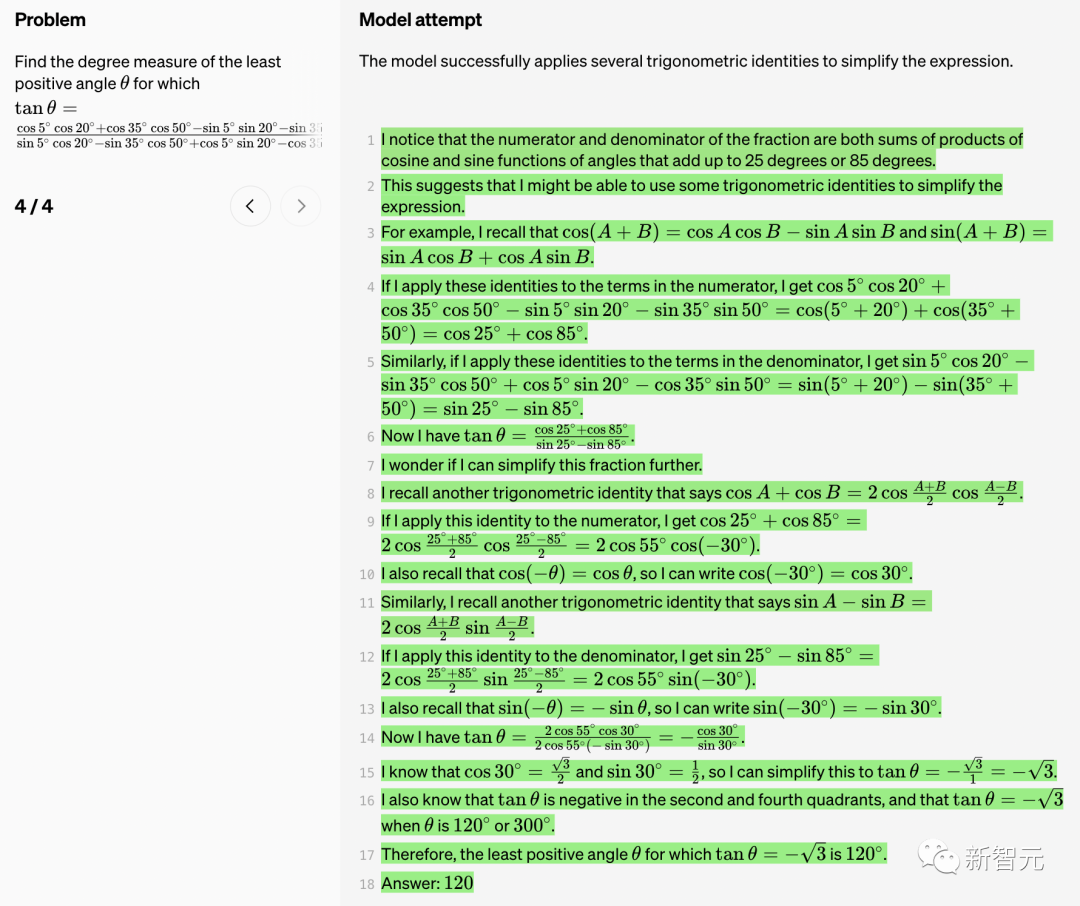
先来简化个三角函数公式。
这个具有挑战性的三角函数问题,需要以一种不明显的顺序应用几个恒等式。
但是大多数解决尝试都失败了,因为很难选择哪些恒等式实际上是有用的。
虽然GPT-4通常不能解决这个问题,只有0.1%的解决方案尝试实现正确答案,但奖励模型正确地识别出这个解决方案是有效的。
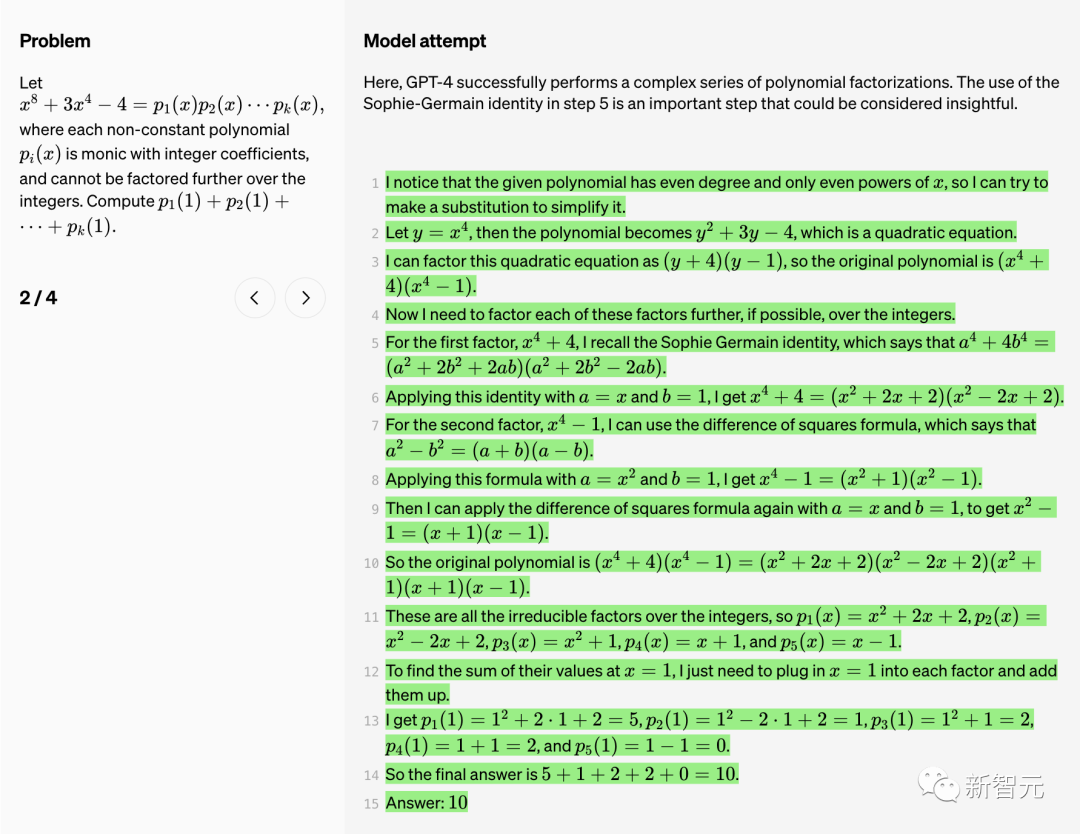
这里,GPT-4成功地执行了一系列复杂的多项式因式分解。
在步骤5中使用Sophie-Germain恒等式是一个重要的步骤。可见,这一步骤很有洞察力。
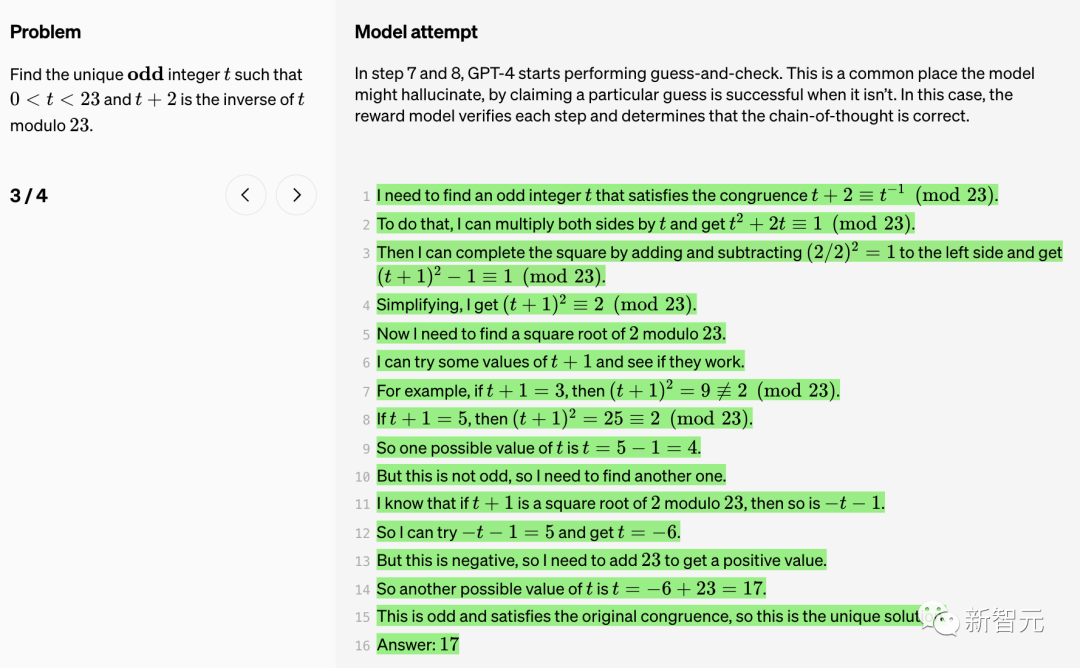
在步骤7和8中,GPT-4开始执行猜测和检查。
这是该模型可能产生「幻觉」的常见地方,它会声称某个特定的猜测是成功的。在这种情况下,奖励模型验证每一步,并确定思维链是正确的。
模型成功地应用了几个三角恒等式以简化表达式。
真负(TN)
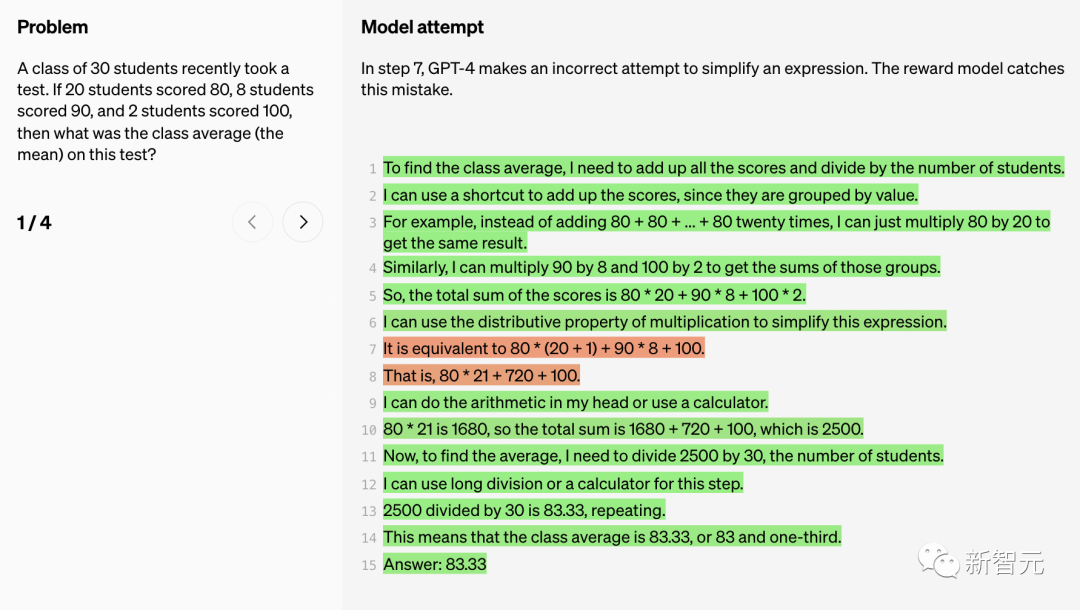
在步骤7中,GPT-4试图简化一个表达式,但尝试失败。奖励模型发现了这个错误。
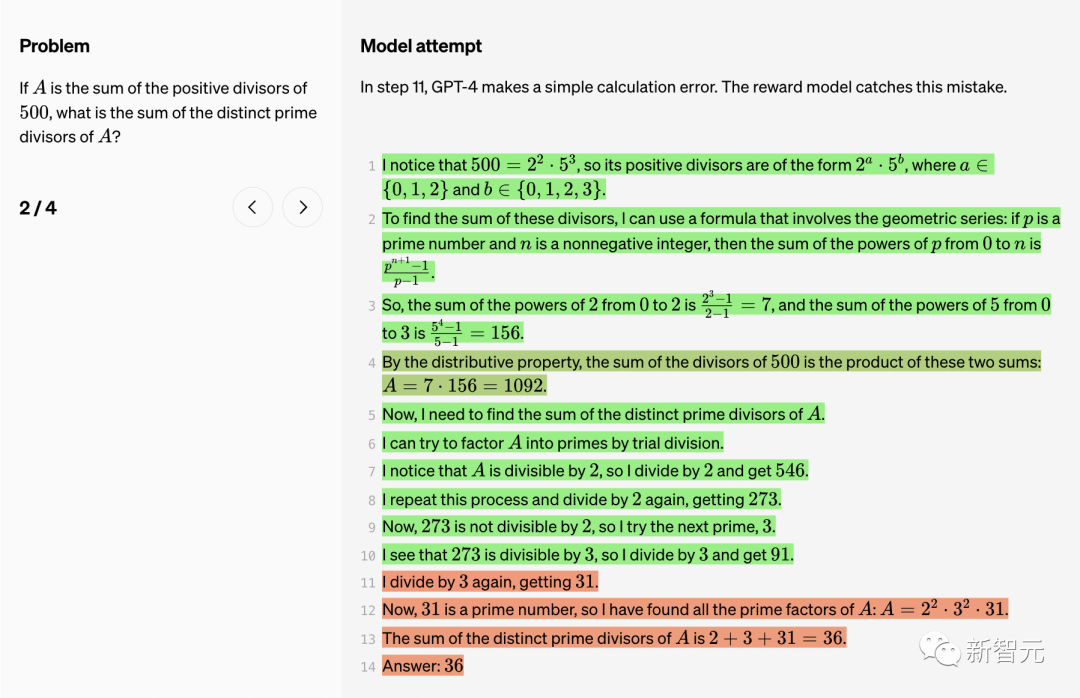
在步骤11中,GPT-4犯了一个简单的计算错误。同样被奖励模型发现。
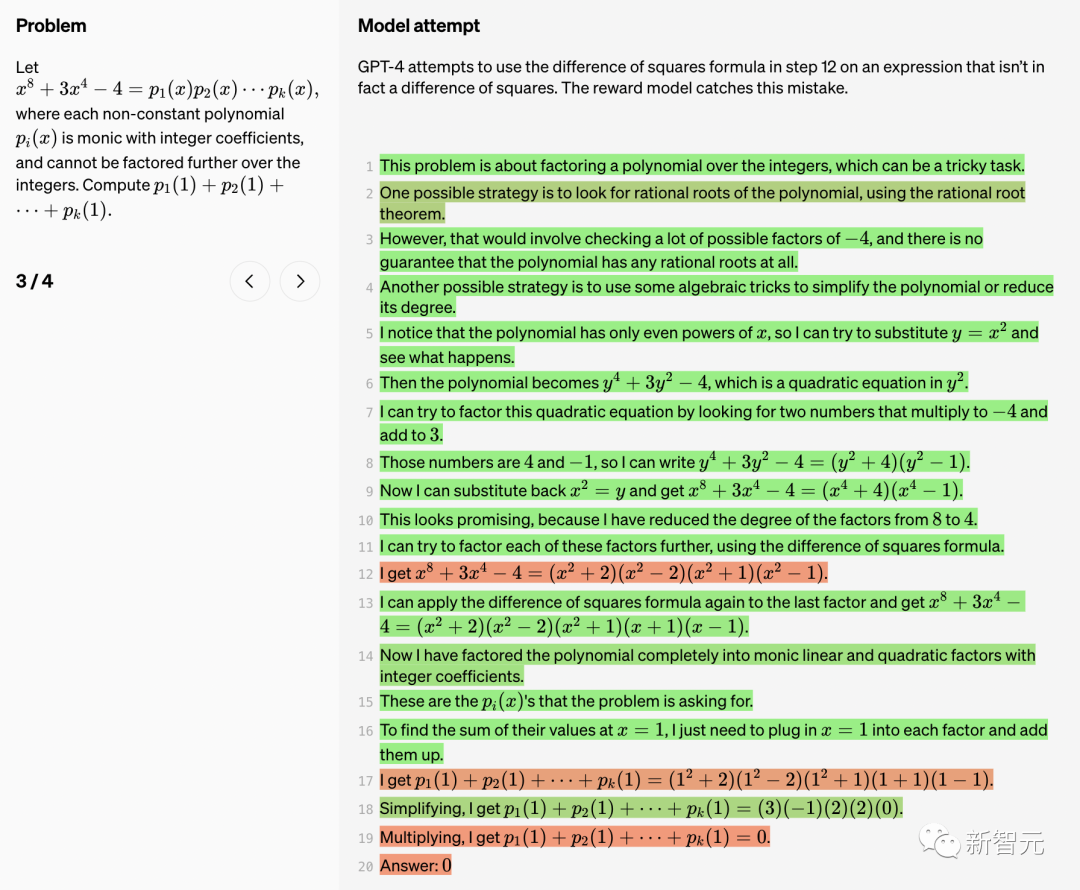
GPT-4在步骤12中尝试使用差平方公式,但这个表达式实际上并非差平方。
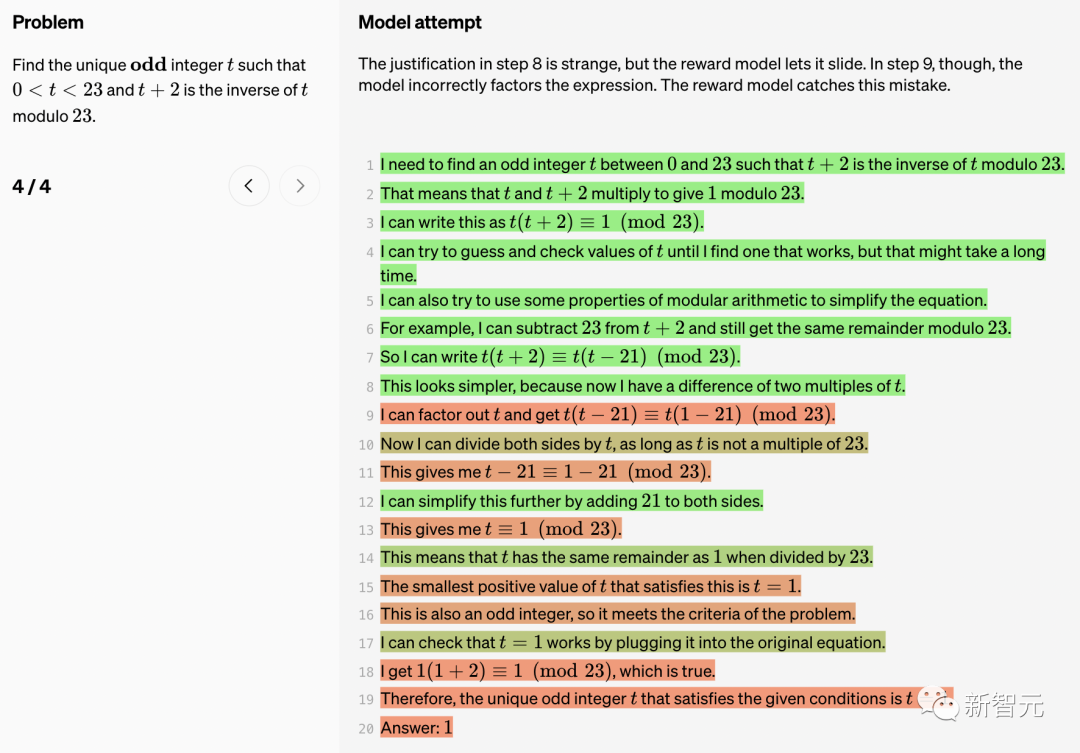
步骤8的理由很奇怪,但奖励模型让它通过了。然而,在步骤9中,模型错误地将表达式分解出因子。
奖励模型便纠出这个错误。
假正(FP)
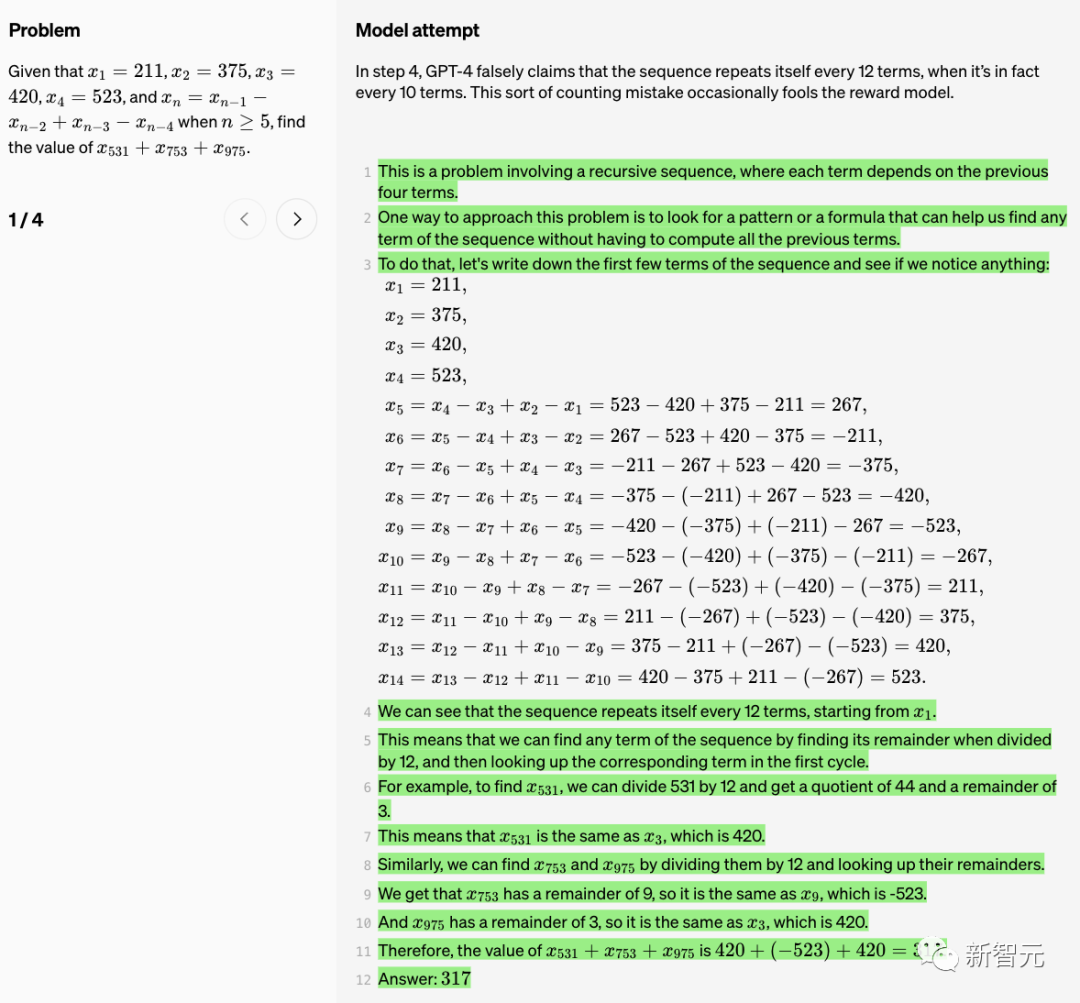
在步骤4中,GPT-4错误地声称「序列每12项重复一次」,但实际上每10项重复一次。这种计数错误偶尔会欺骗奖励模型。
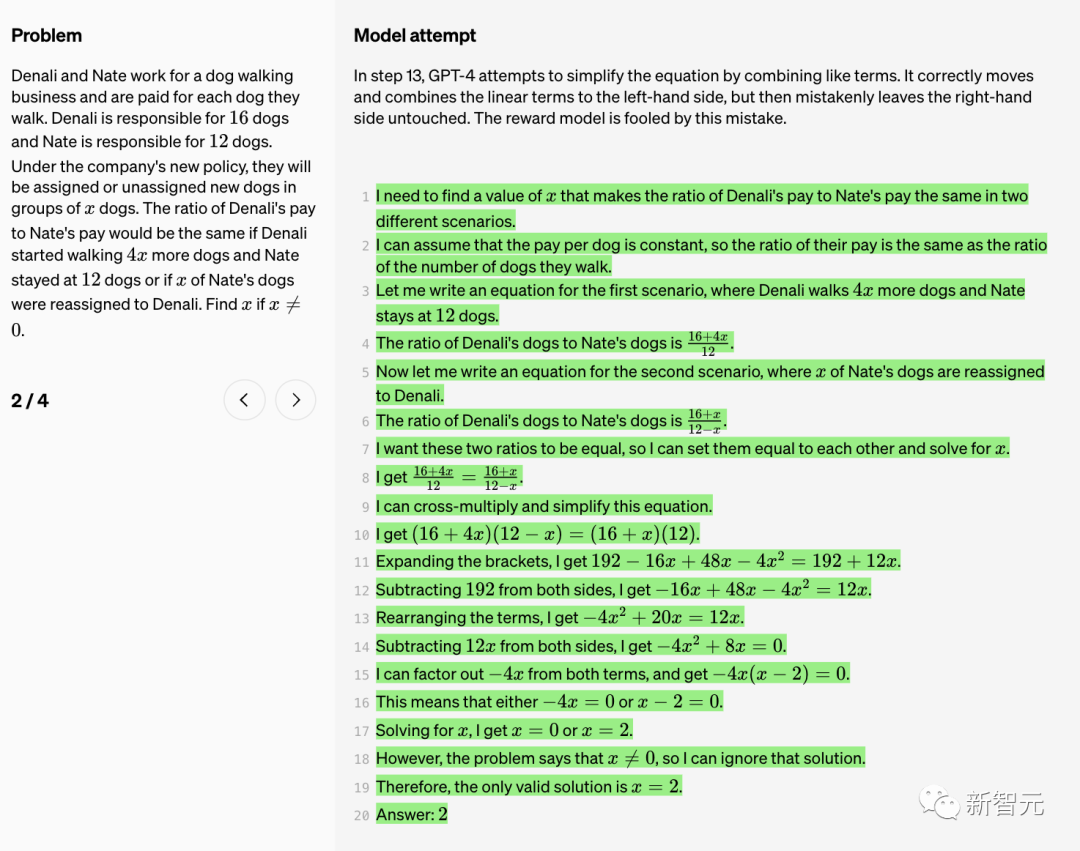
步骤13中,GPT-4试图通过合并类似的项来简化方程。它正确地将线性项移动并组合到左边,但错误地保持右边不变。奖励模型被这个错误所欺骗。
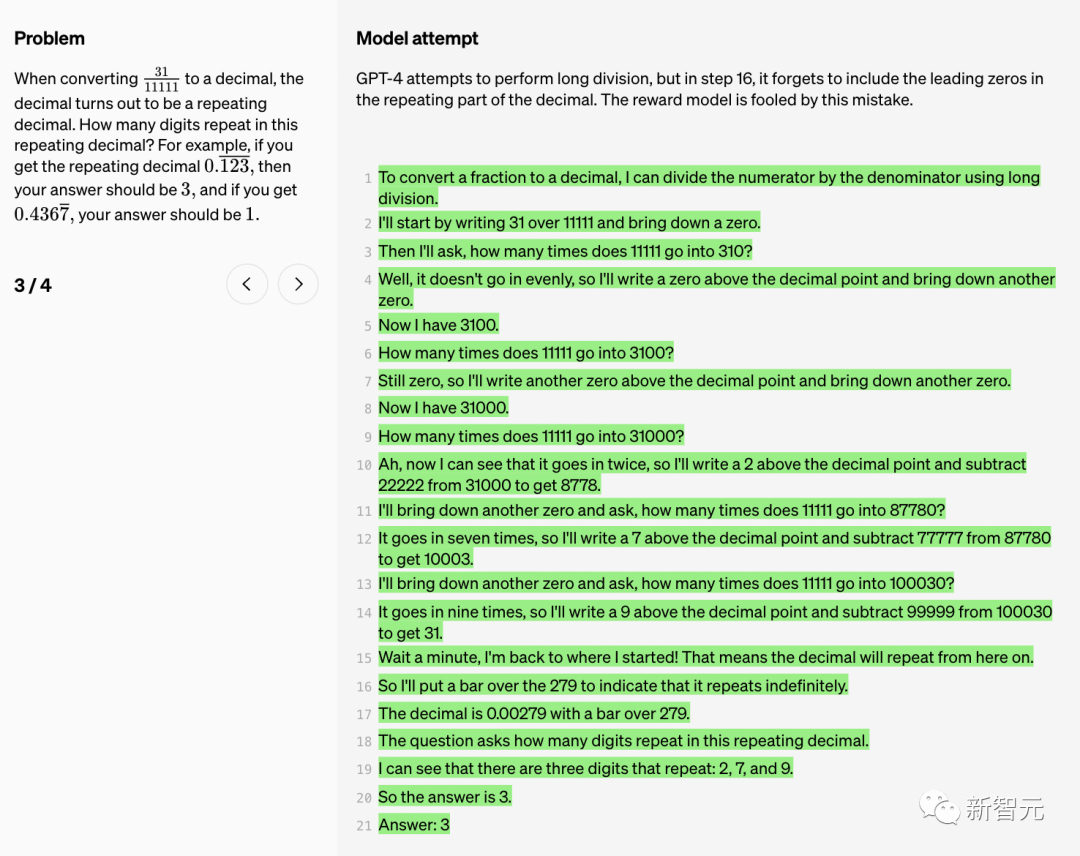
GPT-4尝试进行长除法,但在步骤16中,它忘记在小数的重复部分包括前面的零。奖励模型被这个错误所欺骗。
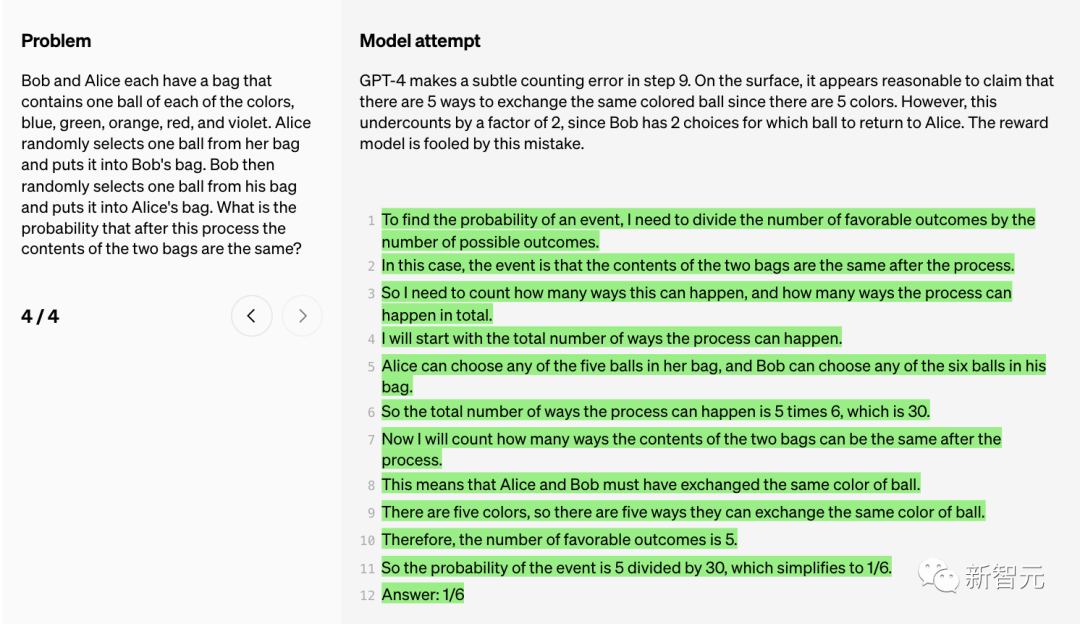
GPT-4在步骤9中犯了一个微妙的计数错误。
表面上,声称有5种方法可以交换同色的球(因为有5种颜色)似乎是合理的。
然而,这个计数低估了2倍,因为Bob有2个选择,即决定把哪个球给Alice。奖励模型被这个错误所欺骗。
过程监督
虽然大语言模型在复杂推理能力方面有了很大的提升,但即便是最先进的模型仍然会产生逻辑错误,或胡说八道,也就是人们常说的「幻觉」。
在生成式人工智能的热潮中,大语言模型的幻觉一直让人们苦恼不已。
马斯克说,我们需要的是TruthGPT
比如最近,一位美国律师在纽约联邦法院的文件中就引用了ChatGPT捏造出的案件,可能面临制裁。
OpenAI的研究者在报告中提到:“在需要多步骤推理的领域,这些幻觉尤其成问题,因为,一个简单的逻辑错误,就足以对整个解决方案造成极大的破坏。”
而且,减轻幻觉,也是构建一致AGI的关键。
怎么减少大模型的幻觉呢?一般有两种方法——过程监督和结果监督。
「结果监督」,顾名思义,就是根据最终结果给大模型反馈,而「过程监督」则可以针对思维链中的每个步骤提供反馈。
在过程监督中,会奖励大模型正确的推理步骤,而不仅仅是奖励它们正确的最终结论。这个过程,会鼓励模型遵循更多类似人类的思维方法链,因而也就更可能造就更好的可解释AI。
OpenAI的研究者表示,虽然过程监督并不是OpenAI发明的,但OpenAI正在努力推动它向前发展。
最新研究中, OpenAI把「结果监督」或「过程监督」两种方法都试了一遍。并使用MATH数据集作为测试平台,并对这两种方法进行了详细比较。
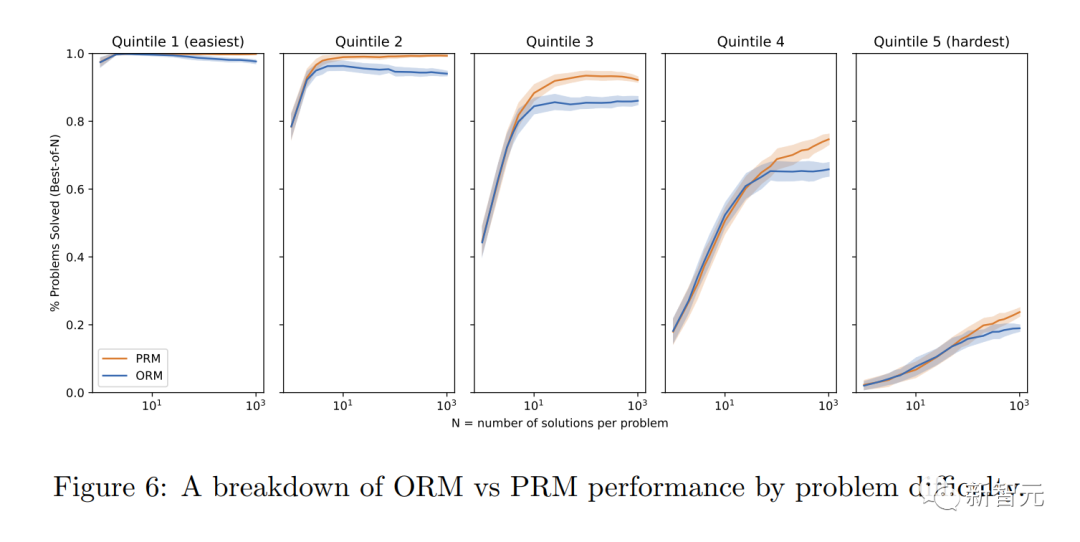
结果发现,「过程监督」能够明显提高模型性能。
对于数学任务,「过程监督」对大模型和小模型都产生了明显更好的结果,这意味着模型通常是正确的,并且还表现出了更像人类的思维过程。
这样,即使在最强大的模型中也很难避免的幻觉或逻辑错误,就可以减少了。
对齐优势明显
研究人员发现了「过程监督」比「结果监督」有几个对齐优势:
· 直接奖励遵循一致的思维链模型,因为过程中的每个步骤都受到精确的监督。
· 更有可能产生可解释的推理,因为「过程监督」鼓励模型遵循人类认可的过程。相比之下,结果监督可能会奖励一个不一致的过程,而且通常更难审查。
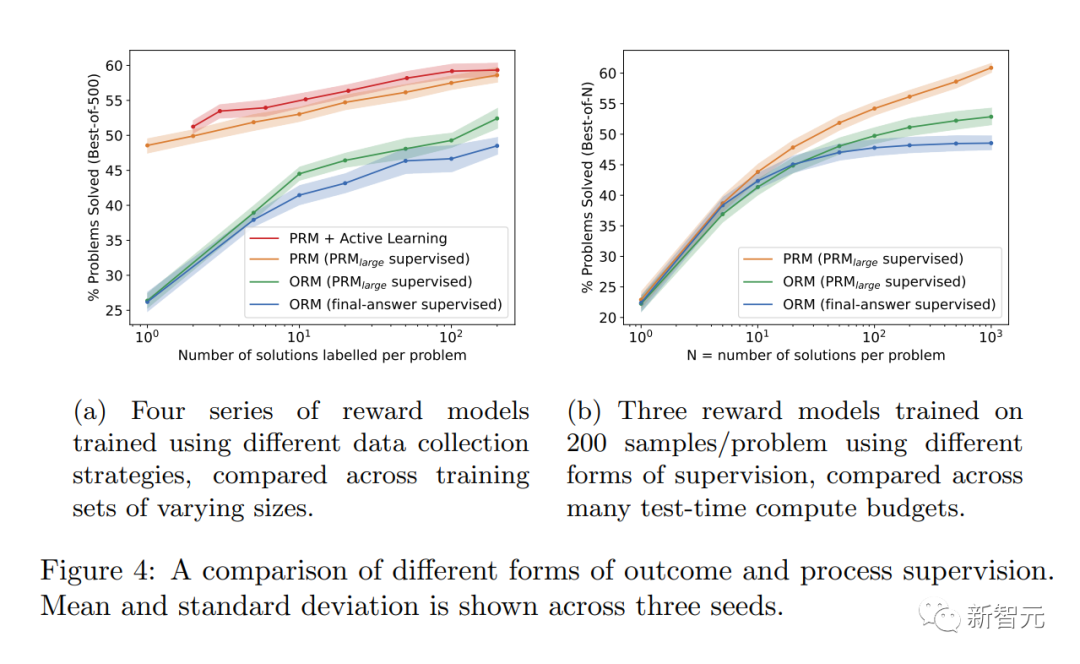
另外值得一提的是,在某些情况下,让AI系统更安全的方法可能会导致性能下降。这种成本被称为「对齐税」(alignment tax)。
一般来说,为了部署最有能力的模型,任何「对齐税」成本都可能阻碍对齐方法的采用。
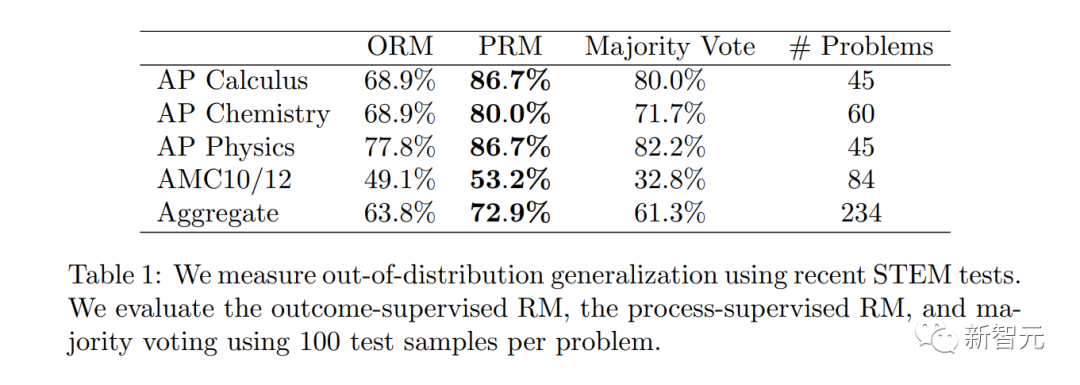
但是,研究人员如下的结果表明,「过程监督」在数学领域测试过程中实际上会产生「负对齐税」。
可以说,没有因为对齐造成较大性能损耗。
OpenAI发布80万人工标注数据集
值得注意的是,PRM需要更多的人类标注,还是深深离不开RLHF。
过程监督在数学以外的领域,具有多大的适用性呢?这个过程需要进一步探索。
OpenAI研究人员开放了这次人类反馈数据集PRM,包含800,000个步骤级正确标注:12K数学问题生成的75K解决方案
如下是一个标注的示例。OpenAI正在发布原始标注,以及在项目第1阶段和第2阶段给标注者的指示。
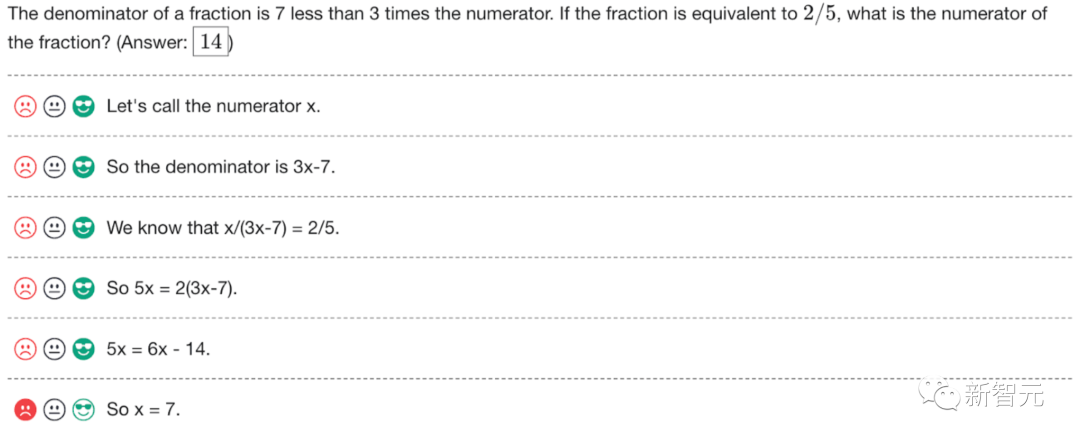
网友热评
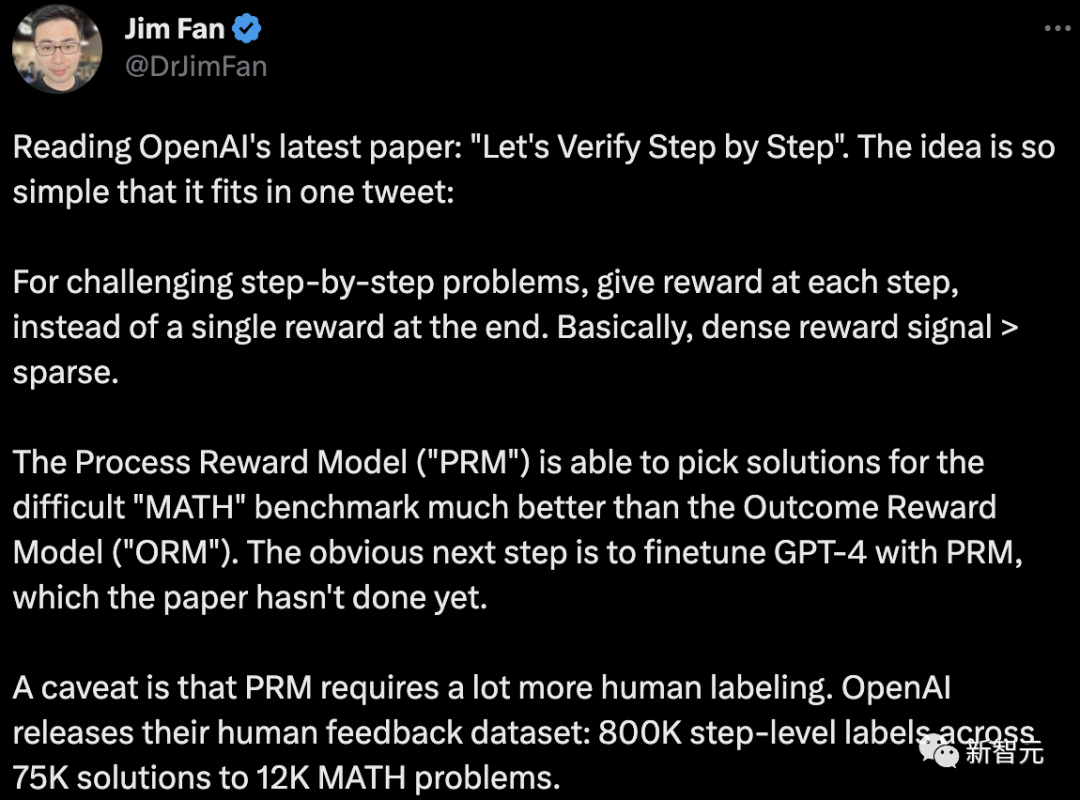
英伟达科学家Jim Fan对OpenAI最新研究做了一个总结:
对于具有挑战性的分步问题,在每一步都给予奖励,而不是在最后给予单一的奖励。基本上,密集奖励信号>稀疏奖励信号。 过程奖励模型(PRM)能够比结果奖励模型(ORM)更好为困难的MATH基准挑选解决方案。下一步显然是用PRM对GPT-4进行微调,而本文还没有这样做。 需要注意的是,PRM需要更多的人类标注。OpenAI发布了人类反馈数据集:在12K数学问题的75K解决方案中的800K步骤级标注。
这就像上学时常说的一句老话,学会如何去思考。
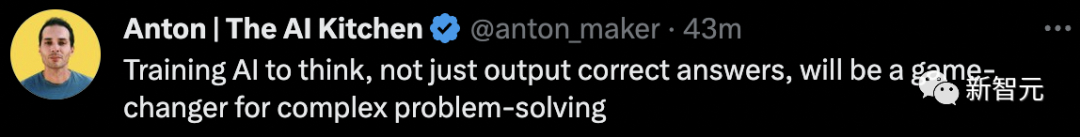
训练模型去思考,而不仅是输出正确的答案,将会成为解决复杂问题的game changer。
ChatGPT在数学方面超级弱。今天我试图解决一个四年级数学书上的数学问题。ChatGPT给了错误答案。我把我的答案和ChatGPT的答案,在perplexity AI、谷歌的答案,以及四年级的老师进行了核对。每个地方都可以确认,chatgpt的答案是错误的。
参考资料:https://openai.com/research/improving-mathematical-reasoning-with-process-supervision
第三十六届国际弦理论大会首次在上海开幕,约700名学者参会。丘成桐指出,上海数学与交叉学科研究院已成为亚洲理论物理研究标杆。中国弦理论研究过去五年进步显著,有望在5到10年内追赶世界一流水平。
明尼苏达大学等机构提出进化式微调(EFT),收集371个优化任务的17万条进化轨迹训练开源小模型,得到Finch系列。在22个陌生任务上平均提升10.22%,展现出跨领域知识迁移能力,较小模型可超越未训练的大模型。
为纪念谷超豪先生百年诞辰,5月10日将在上海科技馆举办专题科普讲座。李大潜院士将回顾谷超豪从数学少年成长为学科开拓者的历程,展现其科学精神传承。沈维孝院士则以多项式求根为例,引领听众领略数学的深邃与精巧。这是一次与顶尖学者对话、感受数学魅力的难得机会。
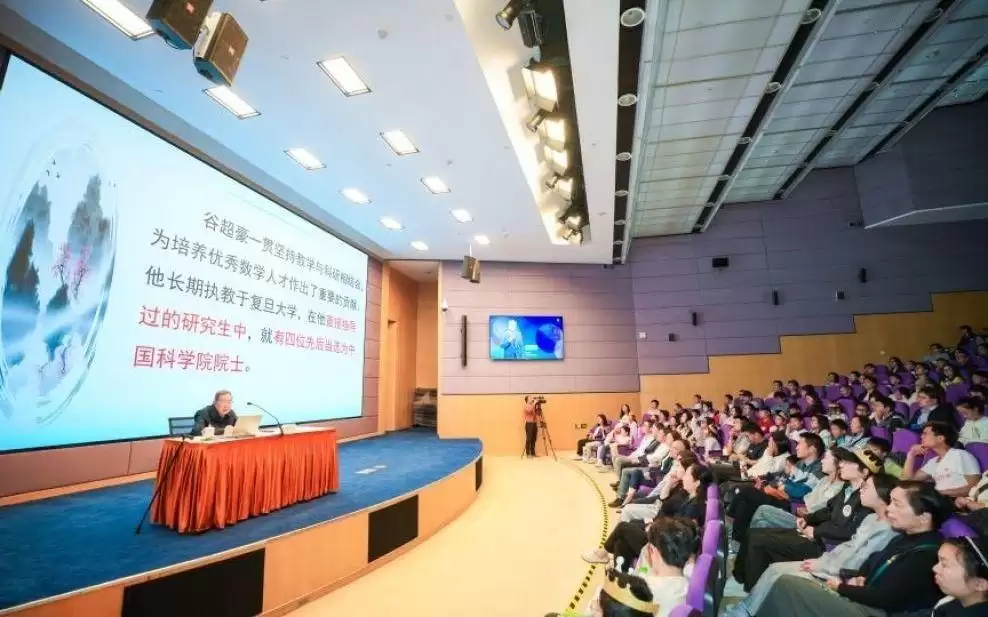
5月15日,是一个值得铭记的日子——著名数学家、中国科学院院士、2009年度国家最高科学技术奖获得者谷超豪先生诞辰一百周年。 为纪念这位科学巨擘的卓越贡献,弘扬其探索真理的科学家精神,并将基础研究的魅力传递给更广泛的公众,一场特别的科普活动于5月10日在上海科技馆报告厅举行。这便是第240期上海科普
AI能读懂孩子的数学草稿吗?这项研究给出了耐人寻味的答案 2026年3月,一份由李海大学、松鼠AI学习、中科院自动化所等五所知名院校联合完成的研究,被发布在arXiv预印本平台上(编号:arXiv:2603.24961v1)。这项研究做了一件挺有意思的事:它第一次系统地探究了那些“多才多艺”的多模态
智东西 编译 刘煜编辑 陈骏达 今天,AI界一则人事变动引发了广泛关注:被誉为“GPT-4o之母”的Joanne Jang宣布从OpenAI离职,结束了其长达四年半的任职。作为公司模型行为(Model Beha vior)领域的创始负责人及OpenAI Labs总经理,她的离开略显突然,目前并未透露
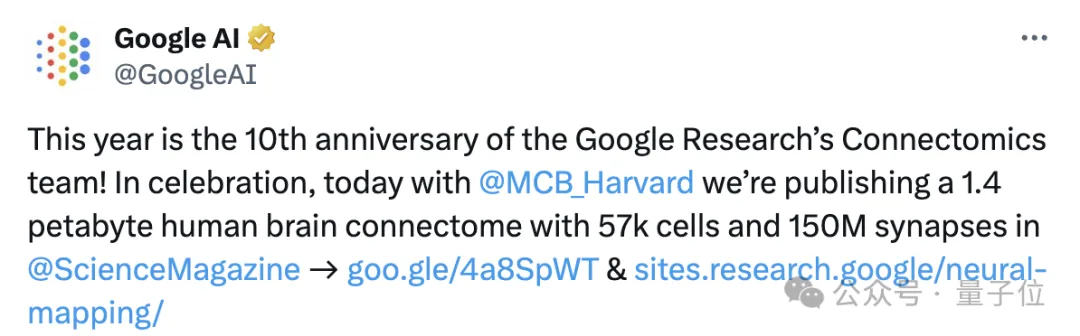
芝麻粒大小的人脑组织,突触规模就相当于一个GPT-4!谷歌与哈佛联手,对局部人脑进行了纳米级建模,论文已登Science。这是迄今为止最大、最详细的人脑复制品,首次展示出了大脑中的突触连接网络。凭借超高分辨率,这个名为H01的重建,已经揭示了一些以前未曾见过的关于人类大脑的细节。项目通讯作者、哈佛大学Lichtman教授介绍说,在此之前,没有人真正看到过这样复杂的突触网络。这一建模成果,将有助于深入地了解大脑的运作方式,启发人类对大脑功能和疾病的进一步研究。另外值得一提的是,该研究涉及了1立方毫米的人脑组
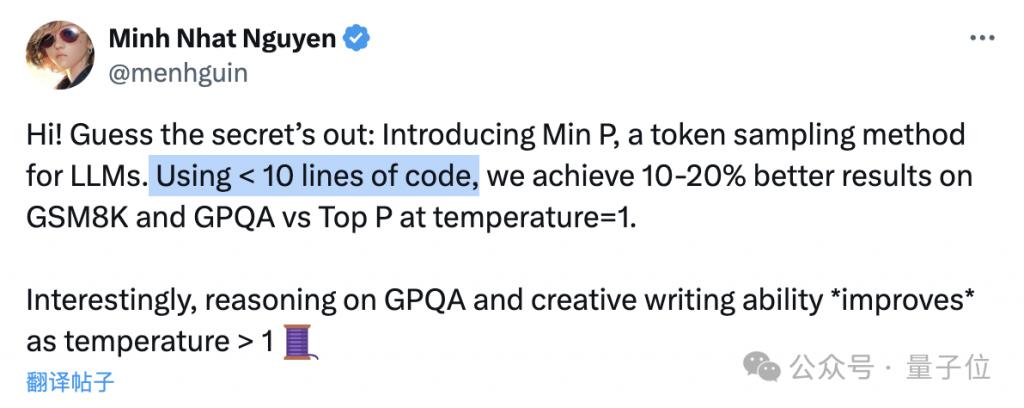
只要不到10行代码,就能让大模型数学能力(GSM8k)提升20%!几名独立学者提出了大模型采样的改进方案,引起了开源社区的关注。目前该方法已在Mistral-7B上取得成效,在Llama3-70B上的测试也正在进行。这种方法叫做最小p采样(min-psampling),目的是平衡生成文本的连贯性和多样性。简单说就是让模型在不同场合发挥不同的特性,例如在事实问题上保持性能稳定,在写作等场景中又能发挥创意。目前该方法已在Mistral-7B上取得成效,在Llama-70B上的测试也即将进行。在论文中作者提到,
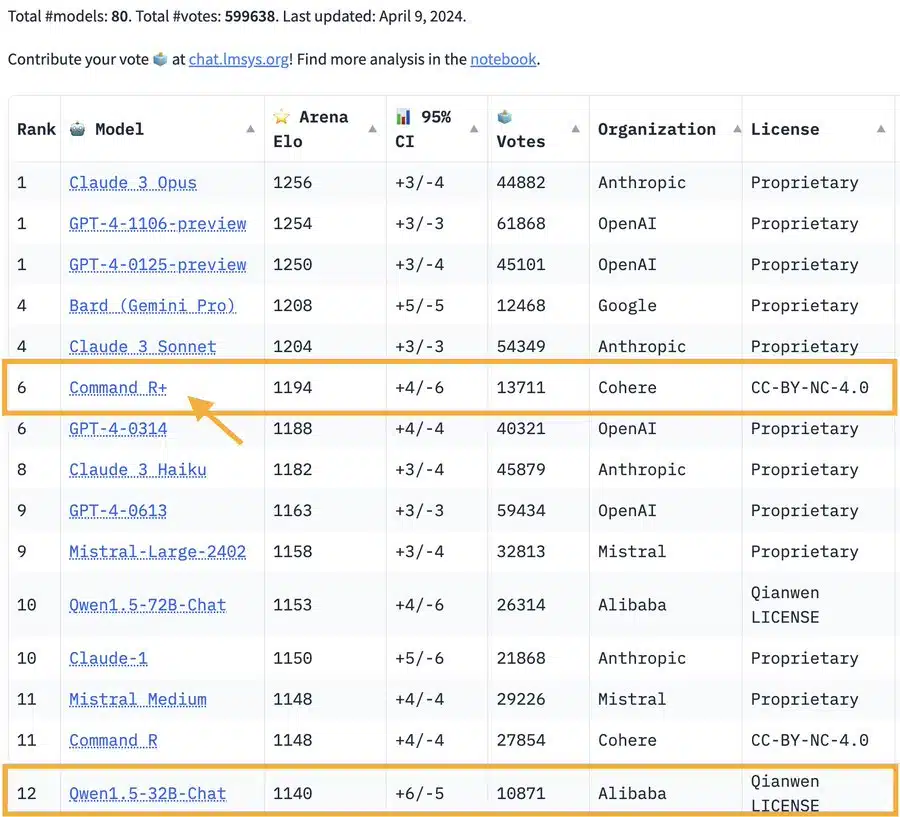
编辑|诺亚、伊风出品|51CTO技术栈(微信号:blog51cto)近日在开源模型界,CommandR+风头正劲。在Arena榜单上,按下Command+R键超过13000名支持者的票,一次跃升至第6位,其表现为GPT-4-0314旗帜相当!在一众对垒GPT-4的开放权重模型中,斩获该榜单有史以来的首胜。图源:https://twitter.com/lmsysorg/status/17776301337而Arena榜单,是近日用纯C语言手搓GPT-2的AI大神AndrejKarpathy提过的唯二信任的测
出品|51CTO技术栈(微信号:blog51cto)昨天,普林斯顿的CS/NLP硕士生JohnYang在Github上开源了一款比Devin更优秀的工具。不久之后,在Github上斩获了1.3k星,异常生猛。据悉,4月10日,详细的技术论文将会公开!图片1.让语言模型秒变编程Agent!SWE-agent是一款用于自主解决Github存储库问题的新系统,在SWE-bench上取得了与Devin相似的准确度,平均耗时只有93s,而且重要的是,开源!!图片此外,SWE-agent通过与专用终端交互来工作,这使





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



