

创建 Hive 表时如何解决“无效输入”错误
简介 Hadoop可是大数据处理领域的得力框架,Hive呢,作为类似SQL的热门接口,能让你轻松处理Hadoop分布式文件系统(HDFS)里的数据。然而,创建Hive表时,“无效输入”错误可能会不期而至,这可真是让人头疼。本教程将带你深入了解Hive表的基础,帮你识别“无效输入”错误,并提供切实可行
简介
Hadoop可是大数据处理领域的得力框架,Hive呢,作为类似SQL的热门接口,能让你轻松处理Hadoop分布式文件系统(HDFS)里的数据。然而,创建Hive表时,“无效输入”错误可能会不期而至,这可真是让人头疼。本教程将带你深入了解Hive表的基础,帮你识别“无效输入”错误,并提供切实可行的解决方案,助你在Hadoop环境中顺利解决此问题。
了解 Hive 表基础知识
Hive 是一个构建在 Hadoop 之上的数据仓库基础设施,旨在便于轻松进行数据汇总、即席查询以及对存储在 Hadoop 分布式文件系统(HDFS)中的大型数据集进行分析。Hive 的核心是表,它是用于存储和管理数据的主要数据结构。
Hive 表结构
Hive 表由以下关键元素组成:
- 列:Hive 表由一组列定义,每列都有特定的数据类型,如 CODE0、CODE1、CODE_2 等。
- 分区:Hive 表可以按一个或多个列进行分区,从而实现更高效的数据查询和管理。
- 桶:Hive 表可以根据一个或多个列的哈希值进一步划分为桶,从而实现更高级的数据处理和查询功能。
创建 Hive 表
Hive 表通常使用 CODE_0 语句创建。以下是创建 Hive 表的示例:
CREATE TABLE IF NOT EXISTS user_data (
  user_id INT,
  username STRING,
  email STRING,
  registration_date STRING
)
PARTITIONED BY (registration_date STRING)
STORED AS PARQUET;
在此示例中,我们创建了一个名为 CODE0 的表,它有四列:CODE1、CODE2、CODE3 和 CODE4。该表按 CODE5 列进行分区,并以 Parquet 文件格式存储。
Hive 表数据类型
Hive 支持多种数据类型,包括:
- 基本类型:CODE0、CODE1、CODE2、CODE3、CODE4、CODE5、CODE6、CODE7、CODE8、CODE9、CODE10、CODE11、CODE12、CODE13
- 复杂类型:CODE0、CODE1、CODE2、CODE3
应根据存储在 Hive 表中的数据特征选择合适的数据类型。
Hive 表操作
Hive 提供了各种用于管理表的操作,包括:
- CODE_0:创建一个新的 Hive 表
- CODE_0:修改现有 Hive 表的结构
- CODE_0:删除一个 Hive 表
- CODE_0:查看 Hive 表的模式
- CODE_0:列出当前数据库中的所有 Hive 表
了解这些基本的 Hive 表概念对于在 Hive 生态系统中处理数据至关重要。
识别 Hive 中的“无效输入”错误
在使用 Hive 时,你可能会遇到“无效输入”错误,这种错误通常在将数据加载到 Hive 表中时发生,原因是数据与预期的数据类型或格式不匹配。此错误可能由多种原因引起,了解如何识别和解决这些问题很重要。
“无效输入”错误的常见原因
- 数据类型不匹配:如果加载到 Hive 表中的数据与表列定义的数据类型不匹配,可能会发生“无效输入”错误。
- 数据格式不正确:Hive 期望数据采用特定格式,例如日期为 CODE_0 格式,或者 CSV 文件使用特定分隔符。如果数据与预期格式不匹配,可能会发生“无效输入”错误。
- 空值或空值:如果某列定义为非空数据类型,但加载的数据包含空值或空值,Hive 可能会引发“无效输入”错误。
- 不支持的字符:Hive 在处理数据中的某些特殊字符或非 ASCII 字符时可能会遇到问题,从而导致“无效输入”错误。
识别“无效输入”错误
你可以通过监控日志或 Hive 查询的输出来识别 Hive 中的“无效输入”错误。当发生“无效输入”错误时,Hive 通常会提供有关错误发生的特定列或行的信息,以及预期和实际的数据类型或格式。
以下是 Hive 中“无效输入”错误的示例:
FAILED: Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask. invalid input: '2023-04-31' for type date在此示例中,“无效输入”错误是由无效日期值“2023-04-31”引起的,该值与预期日期格式不匹配。
了解“无效输入”错误的根本原因以及如何识别它们对于成功使用 Hive 表和数据至关重要。
排查和解决“无效输入”错误
一旦你确定了 Hive 中“无效输入”错误的根本原因,就可以采取以下步骤来解决该问题:
验证数据类型和格式
- 验证列数据类型:确保加载到 Hive 表中的数据与列定义的数据类型匹配。你可以使用 CODE_0 命令查看表的模式,并将其与实际数据进行比较。
- 检查数据格式:确保加载到 Hive 表中的数据采用预期格式,例如日期为 CODE_0 格式,或者 CSV 文件使用正确的分隔符。
处理空值和空值
- 允许空值:如果你的数据包含空值或空值,你可以修改表定义,允许受影响的列有空值。
ALTER TABLE user_data CHANGE COLUMN email email STRING COMMENT 'Email address' NULL;- 使用默认值:或者,你可以为列设置默认值,以处理空值或空输入。
ALTER TABLE user_data CHANGE COLUMN email email STRING COMMENT 'Email address' DEFAULT 'unknown@example.com';清理数据
- 删除不支持的字符:如果“无效输入”错误是由数据中不支持的字符引起的,你可以在将数据加载到表中之前,使用 Hive 的内置函数清理数据。
CREATE TABLE user_data (
  user_id INT,
  username STRING,
  email STRING,
  registration_date STRING
)
PARTITIONED BY (registration_date STRING)
STORED AS PARQUET
AS
SELECT
  user_id,
  REGEXP_REPLACE(username, '[^a-zA-Z0-9_]', '_') AS username,
  REGEXP_REPLACE(email, '[^a-zA-Z0-9@._]', '_') AS email,
  registration_date
FROM source_table;
通过遵循这些故障排除和解决步骤,你可以有效地解决 Hive 中的“无效输入”错误,并确保你的数据正确加载到 Hive 表中。
总结
在本以 Hadoop 为重点的教程中,你将学习如何在创建 Hive 表时识别和解决“无效输入”错误。通过了解 Hive 表的基础知识和故障排除策略,你将能够在 Hadoop 生态系统中有效地管理数据摄入和处理工作流程。
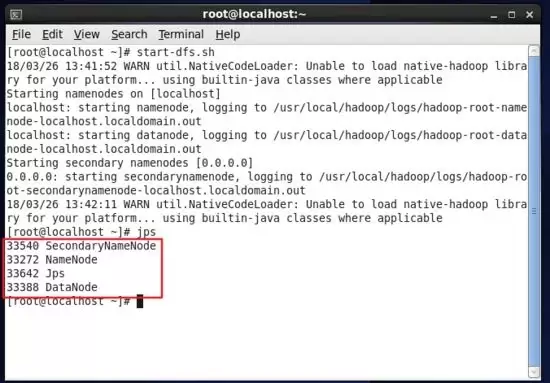
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
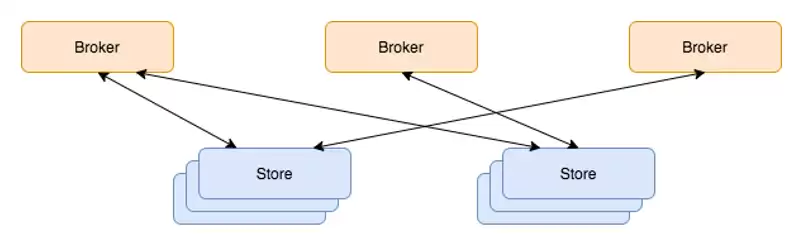
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
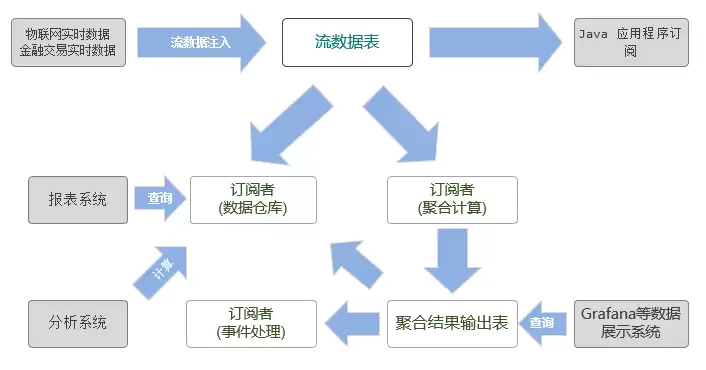
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
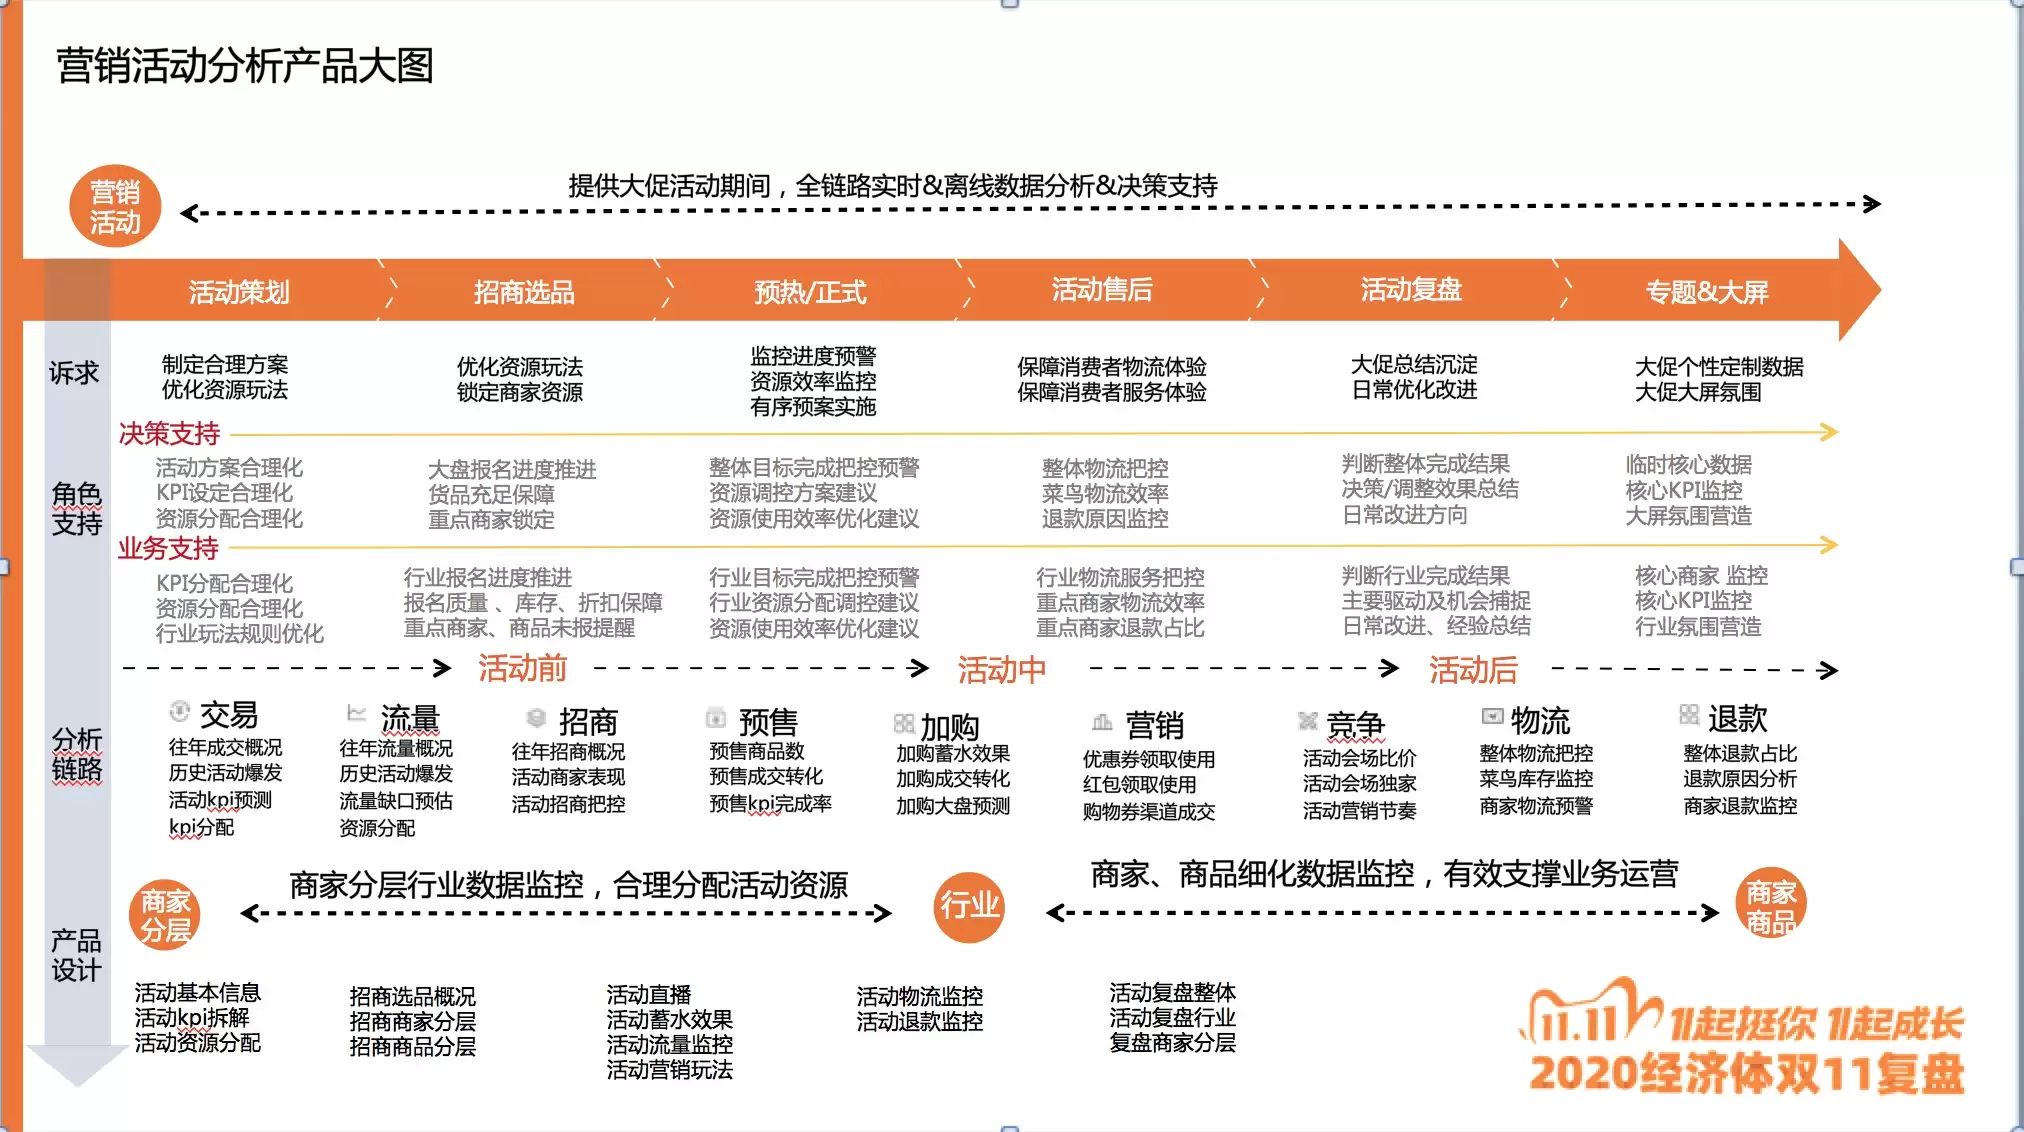
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
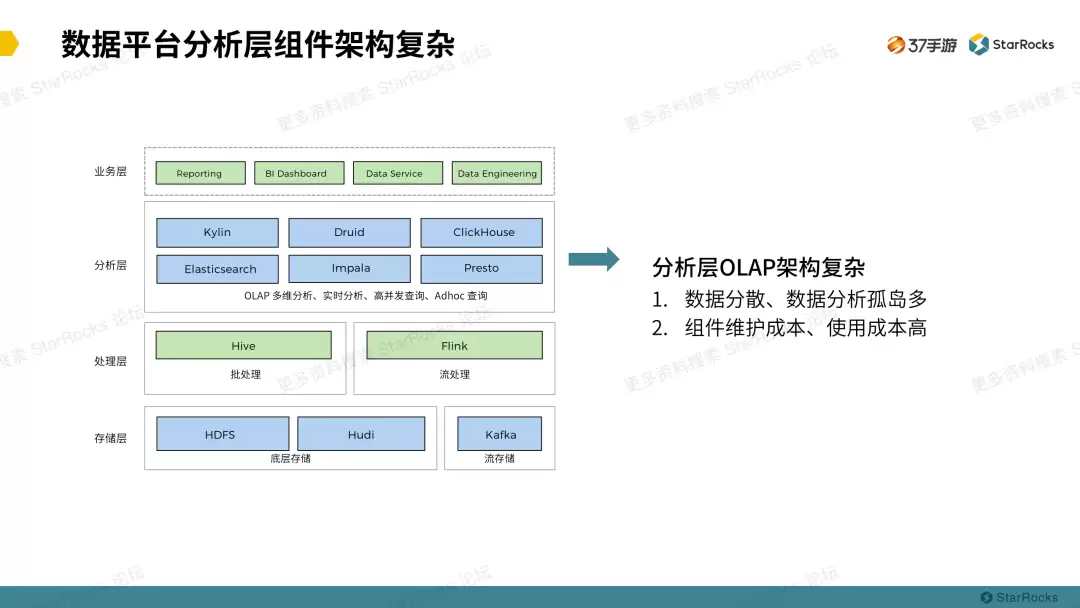
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



