

LinkedList源码理解
LinkedList是也是非常常见的集合类,LinkedList是基于链表实现的集合。它拥有List集合的特点:存取有序带索引允许重复元素还拥有Deque集合的特点:先入先出双端操作它本身的特点是:对元素进行插入或者删除,只需要更改一些数据,不需要元素进行移动。依然是通过源码来看看LinkedLis
LinkedList是也是非常常见的集合类,LinkedList是基于链表实现的集合。它拥有List集合的特点:
- 存取有序
- 带索引
- 允许重复元素
还拥有Deque集合的特点:
- 先入先出
- 双端操作
它本身的特点是:
- 对元素进行插入或者删除,只需要更改一些数据,不需要元素进行移动。
依然是通过源码来看看LinkedList如何实现自己的特性的。
Doubly-linked list implementation of the {@code List} and {@code Deque} interfaces. Implements all optional list operations,and permits all elements (including {@code null}).
对于List接口和Deque接口的双链表实现。实现了所有List接口的操作并且能存储所有的元素。
public class LinkedList extends AbstractSequentialList
                       implements List, Deque, Cloneable, ja va.io.Serializable
可以看到LinkedList实现了一个Deque接口,其实是说,LinkedList除了有List的特性,还有Deque的特性,那么Deque是什么呢?
public interface Deque extends Queue

        public interface Queue extends Collection
原来是继承了Collection集合的另一个接口。
Queue就是我们常说的队列,它的特性是FIFO( First In First Out )先进先出,它的操作只有两个:
- 把元素存进队列尾部
- 从头部取出元素
就像排队办事一样的。
而它的子接口Deque除了这两操作以外,还能比Queue队列有更多的功能
- 既可以添加元素到队尾,也可以添加元素到队头
- 既可以从队尾取元素,也可以从队头取元素
如此看来就像两边都可以当队头和队尾一样,所以Deque又叫双端队列 。
理所应当的,LinkedLisk也实现了这些特性,并且有Doubly-linked(双链表的特性)。
那么什么又是链表呢?
其实链表是一种线性的存储结构,意思是将要存储的数据存在一个存储单元里面,这个存储单元里面除了存放有待存储的数据以外,还存储有其下一个存储单元的地址。
双链表顾名思义,存储单元除了存储其下一个存储单元的地址,还存储了上一个存储单元的地址。每次查找数据的时候,就通过存储单元里存储的地址信息进行查找。
成员变量:
transient int size = 0;

transient Node first;

transient Node last;
只有三个,size代表LinkedList存储的元素个数。那这个Node是什么?
    private static class Node {
        E item;
        Node next;
        Node prev;

        Node(Node prev, E element, Node next) {
            this.item = element;
            this.next = next;
            this.prev = prev;
        }
    }
它是LinkedList内部的数据结构Node,作为LinkedList的基本存储单元,也最能体现LinkedList双链表的特性。
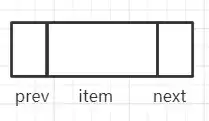 像这样的。
其中prev存储上一个节点的引用(地址),next存储下一个单元的引用,item就是具体要存的数据。
First和Last用来标明队头跟队尾。
添加数据:
public boolean add(E e) {
        linkLast(e);
        return true;
    }


void linkLast(E e) {
        final Node l = last;
        final Node newNode = new Node<>(l, e, null);
        last = newNode;
        if (l == null)
            first = newNode;
        else
            l.next = newNode;
        size++;
        modCount++;
    }
默认是调用添加到尾部的方法。前面说过,LinkedList的基本存储单元是Node,所以添加进来的数据会被封装进Node的item属性里,而且这个新Node的prev会指向前一个Node,前一个Node的next会指向这个新Node。
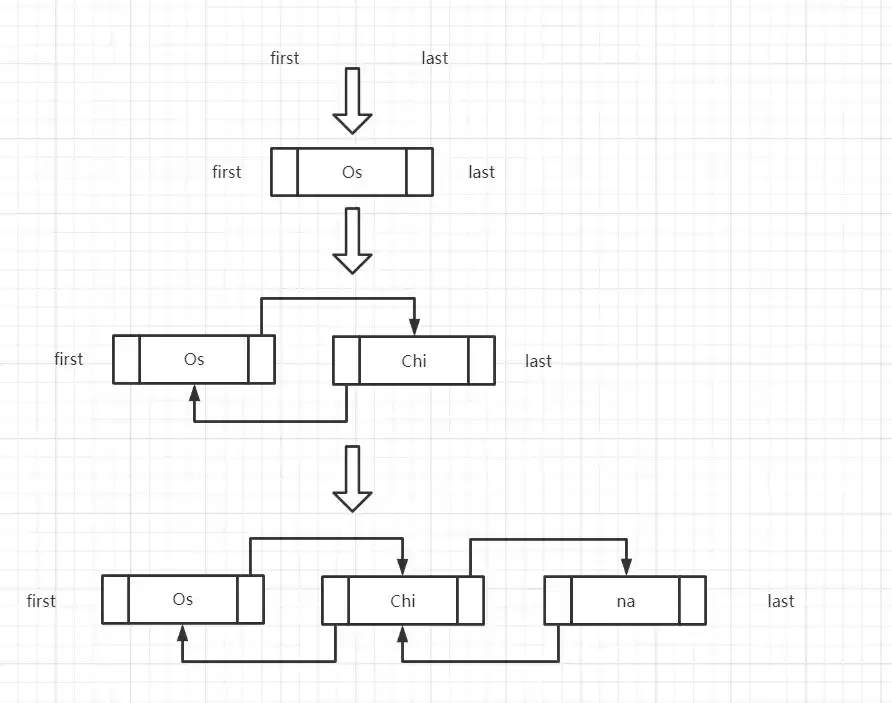
类似这样,但是注意画线只是一种形象的表达方法,就如上面所说,在Node里的prev属性和next属性是用来存储引用的,通过这个引用就能找到前一个Node或者后一个Node。
public void addFirst(E e) {
        linkFirst(e);
    }

private void linkFirst(E e) {
        final Node f = first;
        final Node newNode = new Node<>(null, e, f);
        first = newNode;
        if (f == null)
            last = newNode;
        else
            f.prev = newNode;
        size++;
        modCount++;
    }

public void addLast(E e) {
        linkLast(e);
    }

public boolean offerLast(E e) {
        addLast(e);
        return true;
    }
实际上,LinkedList有不少不同名称的方法,但其实现方式大多相似。这是因为LinkedList可用于表示多种不同的数据结构,即便都是在队首或队尾添加元素,清晰的方法描述对提升代码可读性也大有益处。例如,当使用LinkedList表示Stack(栈)数据结构时,可使用push()、pop()、peek()等方法来描述操作;而表示Queue(队列)数据结构时,则使用add()、offer()等方法来描述。(当然,采用多态的方式来实现会更好。)
删除数据:
//删除头Node
public E removeFirst() {
        final Node f = first;
        if (f == null)
            throw new NoSuchElementException();
        return unlinkFirst(f);
    }

//删除操作
private E unlinkFirst(Node f) {
        // assert f == first && f != null;
        final E element = f.item;
        final Node next = f.next;
        f.item = null;
        f.next = null; // help GC
        first = next;
        if (next == null)
            last = null;
        else
            next.prev = null;
        size--;
        modCount++;
        return element;
    }
//删除尾Node
public E removeLast() {
        final Node l = last;
        if (l == null)
            throw new NoSuchElementException();
        return unlinkLast(l);
    }

//删除操作
    private E unlinkLast(Node l) {
        // assert l == last && l != null;
        //拿到最后一个元素存放的数据
        final E element = l.item;
        //拿到最后一个元素的prev前元素的引用
        final Node prev = l.prev;
        //将它们赋值为null
        l.item = null;
        l.prev = null; // help GC
        //现在前元素是list(最后一个Node)
        last = prev;
        //如果前元素已经是null说明没有Node了
        if (prev == null)
            first = null;
        else
            //说明前面还有元素,那么前元素的next就存放null
            prev.next = null;
        size--;
        modCount++;
        return element;
    }
先看看简单的删除, 这里是指定删除最前跟最后的元素,所以只要判断删除后Node的prev或者next是否还有值,有就说明还有Node,没有就说明LinkedList已经为空了。
怎样才算删除了头/尾Node,只要它的next/prev为空,说明没有引用指向它了,那么我们就认为它从LinkedList里删除了,因为我们无法通过存储单元的引用找到这个Node,所以GC很快也会来回收掉这个Node。
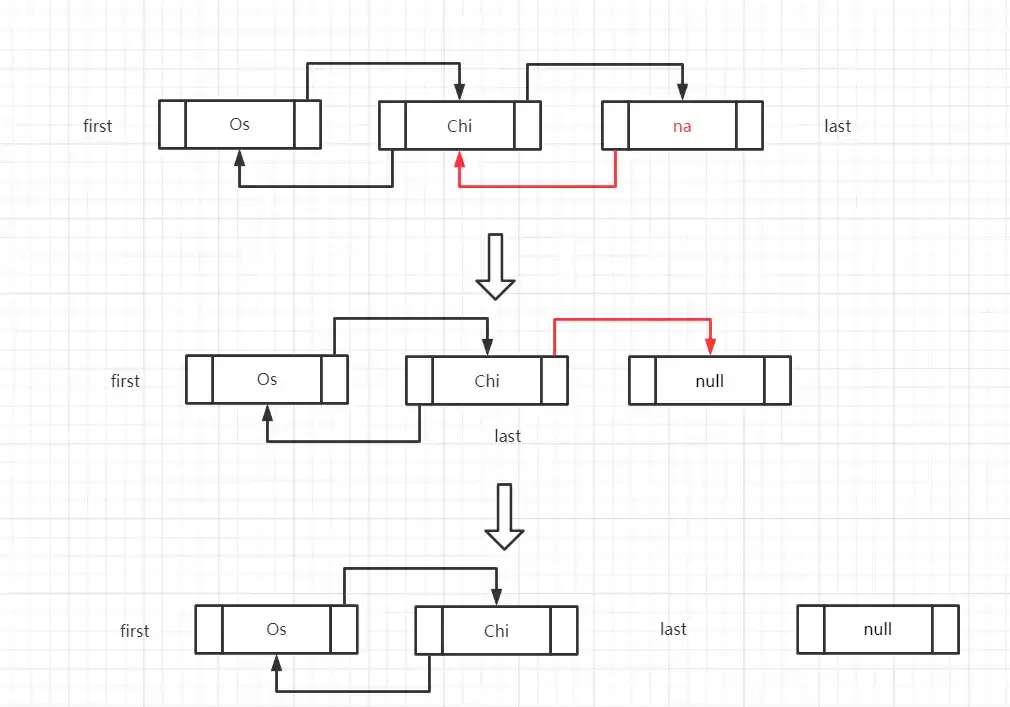
这只是删除头尾Node,那要是删除中间的Node呢?这要跟下面的查找和插入一起看。
查找元素:
public E get(int index) {
        checkElementIndex(index);
        return node(index).item;
    }


Node node(int index) {
        // assert isElementIndex(index);

        //如果索引小于元素个数的一半,就从前遍历
        if (index < (size >> 1)) {
            Node x = first;
            for (int i = 0; i < index; i++)
                x = x.next;
            return x;
        } else {//否则从后遍历
            Node x = last;
            for (int i = size - 1; i > index; i--)
                x = x.prev;
            return x;
        }
    }
数组默认是有下标的,可以一次就取出所在位置的元素,但是LinkedList底层可没有维护这么一个数组,那怎么知道第几个元素是什么呢?
笨方法,我有size个元素,我不知道你指定的index在哪,那我一个一个找过去不就完事了?毕竟我的存储单元Node记得它旁边的单元的引用(地址)。
如果你的index比我size的一半还大,那我就从后面找,因为我是双端队列,有Last的引用(地址),所以可以调换两头。
所以,在LinkedList里面找元素可不容易,最多可能要找size/2次才能找到。
只要找到了想要的位置,那么插入和删除指定的这个Node就很简单了。
public E remove(int index) {
        checkElementIndex(index);
        return unlink(node(index));
    }

E unlink(Node x) {
        // assert x != null;
    //拿到所要删除的Node的item
        final E element = x.item;
    //后一个Node
        final Node next = x.next;
    //前一个Node
        final Node prev = x.prev;

    //如果前一个Node为null(说明是第一个Node)
        if (prev == null) {
            //那么后一个Node作为first
            first = next;
        } else {//否则说明前面有Node
            //那前一个Node的下一个Node引用变为后一个Node
            prev.next = next;
            //当前的前引用变成null
            x.prev = null;
        }

    //如果后一个Node为null(说明是最后一个Node)
        if (next == null) {
            //那么前一个Node作为last
            last = prev;
        } else {//否则说明后面还有Node
            //那后一个Node的下一个Node引用变为前一个Node
            next.prev = prev;
            //当前的后引用变为null
            x.next = null;
        }

    //保存的元素也设为null
        x.item = null;
    //元素-1
        size--;
    //修改次数+1
        modCount++;
        return element;
    }

    public void add(int index, E element) {
        checkPositionIndex(index);

        if (index == size)
            linkLast(element);
        else
            linkBefore(element, node(index));
    }

    void linkBefore(E e, Node succ) {
        // assert succ != null;
        //要插入位置的前一个Node
        final Node pred = succ.prev;
        //新Node,前引用是前一个Node,后引用是当前位置的Node
        final Node newNode = new Node<>(pred, e, succ);
        //后一个Node的前引用变为这个新Node
        succ.prev = newNode;
        //如果没有前一个Node
        if (pred == null)
            //说明添加的就是第一个Node了
            first = newNode;
        else//说明前面还有Node
            //将前一个Node的后引用变为这个新的Node
            pred.next = newNode;
        //元素+1
        size++;
        modCount++;
    }
只是改变了存储单元Node里的prev和next,我们就可以认为这个Node被插入/删除了。
代码的注释配合着下图看,就会方便理解很多,其中注意区分源代码中的命名,最好拿笔记一下容易区分一些。
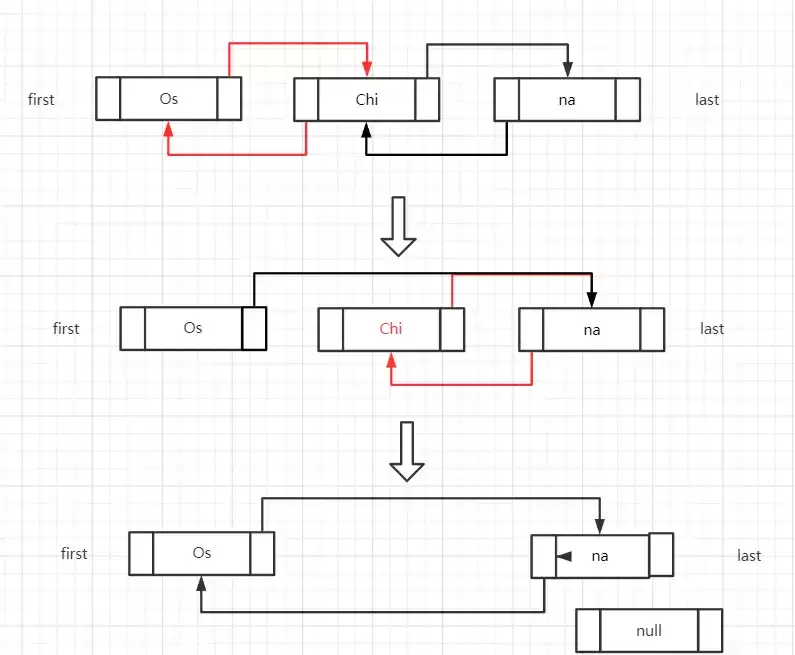
如果是插入元素,倒着看就可以了。
关于遍历:
我们可以了解到,LinkedList最大的性能消耗就在node(index)这步,这会需要去查找大量的元素。但是只要找到了这个元素所在的Node,插入跟删除就非常的方便了。
所以对于get(index)这个方法,我们需要非常小心的去使用,如果只想看一看这个位置的元素,可以用这个方法,但是如果是遍历LinkedList,千万不可以这样写:
for (int i = 0; i < linkedList.size(); i++) {
    linkedList.get(i).equals(Obj);
}
这样对于每次循环,get总会从前或者从后走i次,不考虑get方法中>>1的优化的话,这是一种O(n^2)时间复杂度的做法,效率十分低下。
所以LinkedList提供了内部的Iterator迭代器供我们使用:
private class ListItr implements ListIterator {
        private Node lastReturned;
        private Node next;
        private int nextIndex;
        private int expectedModCount = modCount;

        ListItr(int index) {
            // assert isPositionIndex(index);
            next = (index == size) ? null : node(index);
            nextIndex = index;
        }

        public boolean hasNext() {
            return nextIndex < size;
        }

        public E next() {
            checkForComodification();
            if (!hasNext())
                throw new NoSuchElementException();

            lastReturned = next;
            next = next.next;
            nextIndex++;
            return lastReturned.item;
        }
其实就是通过不断调用next()方法取得Node,然后再对Node做操作,这样时间复杂度就是O(n)了,不会有大量重复无用的遍历。
总结:其实LinkedList的特点插入、删除快,只是针对这次的操作而言的。
LinkedList做插入、删除的时候,慢在要找到具体的位置,快在只需要改变前后Node的引用地址
ArrayList做插入、删除的时候,慢在数组元素的批量赋值(前文里的System.arraycopy),快在搜索
当待插入或删除的元素位于数据结构的前半段,尤其是非常靠前的位置时,LinkedList的效率会远超ArrayList。这是因为ArrayList需要批量复制大量元素。不过,越往后,对于LinkedList而言,由于它是双向链表,在第2个元素后面插入一个数据与在倒数第2个元素后面插入一个元素,效率上几乎没有差别。而ArrayList由于要批量复制的元素越来越少,操作速度必然会逐渐追上甚至超过LinkedList。
不论怎么说,需要根据具体情况来选择对应的集合,最好做一下性能测试,这样才能有更高的效率。
彻底清理悟空浏览器的数据,通常有三个路径:通过手机系统设置能一次性清除所有配置和用户信息;利用浏览器内置功能,可以只清理缓存而保留个性化设置;最彻底的则是卸载重装,让应用回到初始状态。 悟空浏览器用久了,是不是偶尔会感觉变慢,或者出现一些难以解释的小毛病?有时候,与其一个个排查问题,不如来一次彻底的
漫蛙漫画首页登录入口https://www.manwamh.top/:一触即达的漫画世界核心枢纽 对于漫画迷而言,找到那个可靠的资源门户至关重要。漫蛙漫画的首页登录入口,正是这样一个核心渠道。通过它,你可以直接跳转到漫蛙2漫画APP的下载页面,轻松几步完成安装,马上就能投入到精彩纷呈的漫画之旅中。 漫蛙漫画首页登录入口: 官方入口地址已经为你备好
漫蛙漫画官方入口与核心功能解析 寻找一个稳定、资源丰富的漫画在线阅读平台,是许多漫画爱好者的共同需求。其中,漫蛙漫画官方入口及其免费全集服务,受到了不少关注。那么,这个平台究竟如何?下面,我们就来深入了解一下它的具体信息与特色功能。 平台的官方访问地址是:https://www.manwa123.c
对于动漫爱好者而言,找到一个资源全、体验佳的追番平台,常常是件头疼事。漫蛙动漫APP的定位很明确:就是要打造一个聚合全球正版动漫资源的专属乐园。无论是当季火爆的日漫新番、值得回味的经典国创,还是那些小众却精彩的优质动画,在这里基本都能一网打尽。平台底层采用了智能缓冲技术,最大程度保证了播放的流畅度,
想要获取正版manwa漫蛙APP?官方指定下载渠道就是漫蛙官网入口。 对于漫画迷而言,找到一款心仪的阅读神器至关重要。漫蛙APP正是这样一款专为全球漫画爱好者打造的平台,它汇聚了从日韩人气连载到本土原创精品的海量资源。说它“应有尽有”毫不为过。更重要的是,其界面设计清爽直观,搭配智能检索功能,能让用
想要畅享海量正版漫画资源?漫蛙漫画平台不容错过 对于漫画迷来说,找到一个资源丰富、体验流畅的正版平台实属幸事。漫蛙漫画凭借其优质的在线阅读服务,已经成为了许多资深读者的心头好。今天,我们就来详细拆解一下平台的访问方法与实用技巧,助你轻松开启漫画之旅。 漫蛙漫画网页入口页面指南 想立刻体验?官方在线观
漫蛙漫画网APP官方下载方法全解析 对于资深漫画迷来说,找到一个资源全、更新快、体验佳的阅读平台,就像淘到了宝藏。漫蛙漫画网APP,正是这样一个专为爱好者打造的精品集散地。它汇聚了全球优质的正版漫画,从火爆的日漫连载到崛起的国创佳作,平台都能做到实时同步更新。当然,第一步得先把它装到设备上。接下来,
漫蛙漫画APP:专业漫画阅读工具的全面革新 作为一款专业的漫画阅读工具,漫蛙漫画APP整合了全球优质漫画资源,其升级版漫蛙2在功能与体验上可谓全面革新。这款应用不仅囊括日漫经典与国漫新作,更通过简洁直观的界面设计和流畅操作,为用户打造沉浸式阅读环境,充分满足各类漫画爱好者的多样化需求。 漫蛙漫画特色
当下动漫圈热议的卖茶叶妈妈3d漫蛙下载,凭借其突破性的3D视觉技术成为焦点 最近动漫爱好者们都在讨论一个现象级产品——卖茶叶妈妈3d漫蛙下载。这款由漫蛙漫画平台倾力打造的3D作品专区,用立体建模与动态分镜彻底颠覆了传统二维漫画的阅读模式。你猜怎么着?现在只需通过专区提供的便捷下载通道,无论是热血冒险
漫蛙APP:资深漫画迷的移动图书馆与阅读利器 对于漫画爱好者来说,找到一个资源全、体验好的阅读平台,从来都不是件容易的事。而漫蛙APP,恰恰就是为这个需求而生的。它凭借海量的正版漫画库和极其便捷的离线下载功能,在圈内积累了相当不错的口碑。更重要的是,从经典的日本热血漫到新兴的国产原创作品,它几乎一网





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



