

阿里巴巴让AI图像生成模型"自我进化"
阿里Qwen团队提出Qwen-Image-2.0-RL,通过强化学习与人类反馈构建多维度奖励模型(图文对齐、美感、肖像),结合GRPO算法和混合CFG策略训练,并采用在线策略蒸馏合并文生图与编辑能力。在Qwen-Image-Bench总分提升2.61分,Elo评分文生图提升78分,图像编辑提升93分。
先说个结论:Qwen-Image-2.0-RL 的核心贡献,不是又造了一个新模型,而是给已有的 AI 画图系统装上了一套“人类评委”体系,让它真正学会什么才是用户眼中的“好图”。这篇来自阿里 Qwen 团队的技术报告(arXiv 编号 2606.27608)发布于 2026 年 6 月 25 日,属于计算机视觉领域(cs.CV)。
你肯定遇到过这种情况:用 AI 画图工具生成的作品,乍一看很惊艳,但仔细一瞧——手指数量不对、人脸表情有点诡异,或者画出来的内容和你的描述完全对不上号。这背后有一个深层矛盾:AI 模型在训练时遵循的优化目标,和人类真正在意的“好不好看、对不对题”之间,存在一条巨大的鸿沟。Qwen-Image-2.0-RL 要做的,就是填平这条沟。
最终效果很亮眼。在 Qwen-Image-Bench 这个专业评估体系下,模型总分从 55.23 直接跃升到 57.84,涨了 2.61 分。而在更反映真实用户偏好的 Elo 评分系统中,文生图任务从 1115 涨到 1193,提升了 78 分;图像编辑任务更是从 1256 飞升至 1349,提升了 93 分。这些数字背后,是真实用户在匿名盲选时,更倾向于选择 Qwen-Image-2.0-RL 生成的那一张。
一、为什么 AI 画图需要“人类反馈”来调教?
要搞清楚 Qwen-Image-2.0-RL 到底做了什么,得先明白一个基础问题:AI 图像生成模型最初是怎么学会画图的?
传统图像生成模型的核心技术是扩散模型或流匹配模型。你可以把这个过程想象成:先给一张清晰照片不断“撒沙子”,直到变成一堆杂乱噪点;然后训练 AI 学会反着来——把这堆噪点一点点清理干净,还原出清晰图像。这套方法在数学上叫“去噪分数匹配”。问题是,它的训练目标非常单一:只是“把噪点去掉”,而不是“画出人类觉得好看的图”。
这两者差距可不小。一张图片可以技术上完全“去噪成功”,但颜色搭配奇怪、人物比例失真、或者根本没按用户描述来画。关键就在于,“好不好看”和“对不对题”很难用一个简单公式来量化优化。
大语言模型(比如 ChatGPT)早就遇到过类似困境,解决方案正是“强化学习与人类反馈”(RLHF)。核心理念简单直接:先让人类评判哪些输出更好,据此训练一个“奖励模型”来替代人类打分,然后让 AI 不断产出内容、接受打分、根据分数自我调整——就像训练宠物一样,做对了给奖励,模型自然越来越往“人类喜欢”的方向靠拢。
但把这套方法从文字迁移到图像,绝不只是换个外壳那么简单。图像生成和文字生成在技术结构上天差地别,而且图像质量本身就是个多维度概念——对不对题是一个维度,好不好看是另一个,脸画得自然不自然又是一个。团队需要为这些维度分别设计奖励模型,还要解决多个模型同时工作时互相干扰的问题,更要在规模化的全参数训练中保持稳定性。真正让团队头疼的,是这些挑战。
二、打分系统:让 AI 学会“哪张图更好”的秘密武器
Qwen 团队精心搭建了一套评分体系,分别针对文生图和图像编辑两大任务,覆盖了多个质量维度。
在文生图任务中,团队设计了三种不同用途的奖励模型,层层递进。
最底层的是“图文对齐奖励”——它的唯一任务就是检查生成图像是否忠实反映了文字描述。它不管图片好不好看,只关心一句:用户要三只猫,你画了几只?用户要红色帽子,你给画成绿色?用户说人物坐着,你画出来是站着?这个模型会按照优先级依次检查:物体是否存在、数量是否正确、属性(颜色、大小、材质)是否准确、空间关系是否正确、动作和姿势是否到位。关键维度一出问题,分数立刻往下压,其他方面再好看也没用。
有了“对不对题”的保障,第二层是“美感奖励”——评估图像视觉质量,包括构图是否平衡、光影是否自然、纹理是否细腻、整体艺术风格是否统一协调。
第三层则是专门针对人像的“肖像奖励”。画人脸比画风景难太多了,而且人类对人脸的敏感度极高,普通美感评分模型根本不够用。这个专项模型重点盯着:面部比例是否准确、皮肤和头发纹理是否真实、手指数量对不对、五官是否协调。
对于图像编辑任务,评分体系变成两个方向。一个是“指令执行奖励”,判断 AI 有没有按照用户编辑指令正确修改——比如把衬衫改成蓝色、把背景换成海边、把表情调成微笑。这个模型会把指令拆成“核心要求”和“辅助要求”,分别评估是否完成,同时还要检查整体输出是否视觉连贯。另一个是专门针对人脸编辑的“人脸身份一致性奖励”——编辑涉及人像时,最大难题不是“有没有按指令改”,而是“改完之后这个人还认不认得出来”。团队发现视觉语言模型在这方面并不可靠,因此专门引入了一个基于人脸嵌入向量比对的模型,从特征层面精准衡量编辑前后人脸身份的保真度。
设计过程中,团队做了一个非常关键的方法论选择:放弃“两两对比”的打分方式,改用“绝对评分”。
区别很好理解:两两对比就像让裁判在两道菜之间选一道更好吃;绝对评分则是让裁判给每道菜单独打分,1到5分。团队为两种方式分别训练了奖励模型,然后用它们分别训练生成模型,对比结果。结论很清楚:用绝对评分训练出来的奖励模型,引导生成的图片质量更好、细节更丰富、伪影更少。
原因不复杂。两两对比只能告诉模型“A 比 B 好”,但没法传达 A 究竟好多少。绝对评分则给了一把真正的“标尺”,模型能知道一张图的绝对好坏,而不是只在两个选项中做相对判断。这种更丰富的监督信号,让训练出来的奖励模型对图像质量的感知更加精准。
这些奖励模型基于 Qwen 系列视觉语言模型微调,还引入了思维链推理能力,让模型打分时能像人类评委一样,先分析图像各个维度再综合给分,而不是直接输出一个无法解释的数字。
三、训练框架:如何稳定地让模型“越来越好”而不出问题
有了打分系统,下一步是训练流程。团队采用的核心算法是 GRPO(群体相对策略优化)。这套方法原本用于训练数学推理大模型 DeepSeekMath,现在被引入图像生成领域。
GRPO 的工作方式是这样:针对同一个文字描述,让模型同时生成一批图片(比如 8 张),然后用奖励模型给每张图分别打分,再通过这批图的平均分和方差来判断每张图相对于整体水平是好是差。明显高于平均水平的,会被“鼓励”,模型被引导去多生成类似的;低于平均水平的则相反。这样,模型每次训练都能从自己的成功和失败经历中学习,不断向更好方向调整。
但应用到图像生成时,团队遇到一个棘手问题:要不要在训练中使用“无分类器引导”(CFG)技术?
CFG 是现代图像生成模型的一个重要技术,可以理解为模型生成图像时的“自信心放大器”。正常情况下,模型推理时会同时运行两个版本:一个接收用户描述的“有条件版”,一个忽略用户描述的“无条件版”,然后放大两者差异,让最终输出更贴近描述、风格更鲜明。没有 CFG,模型往往表现得不够自信,生成的图像风格平淡、特征模糊。
但在强化学习训练中,引入 CFG 会带来奇怪效果。团队系统测试了三种方案:第一种是训练和生成都用 CFG,结果训练极不稳定,越训图像质量越差,最后崩成一堆混乱噪点;第二种是训练和生成都不用 CFG,虽然奖励分数稳步提升,但模型逐渐失去对特定风格的把控能力,连知名人物的长相也开始画不准;第三种是生成阶段用 CFG,训练阶段不用 CFG。
第三种方案——团队称之为“混合 CFG 策略”——被证明是最优解。生成时用 CFG,确保候选图像质量足够高,让奖励模型获得可靠信号;训练时不用 CFG,避免了同时优化“有条件”和“无条件”两个分支带来的不稳定性,梯度更新更干净,计算开销也大幅降低。
在多奖励信号的整合上,团队也做了细心设计。文生图任务同时使用三个奖励模型(对齐、美感、肖像),不同奖励模型的打分范围和数值特征各不相同。如果不做处理,某个奖励模型分值偏大,就会在训练中“带节奏”,导致模型只盯着这个维度优化。团队对每个奖励维度单独做了“组内归一化”(减去同组平均分除以标准差),让不同维度的信号处于同等尺度,再按权重加总成最终综合优势值。
训练中还有一个关于“时间步采样”的重要设计。图像生成本质上是一个从纯噪声一步步“清洗”到清晰图像的过程,总共会经过 40 步。最直接的想法是让模型在所有 40 步上都接受强化学习训练信号,但实践中发现这样做会让模型迅速“走捷径”——以极快速度找到能骗过奖励模型的模式,但实际图像质量快速下滑。团队解决方案是只在部分时间步上施加信号,重点关注靠近“纯噪声”那一端的高噪声时间步,因为这些步骤决定了图像整体布局和语义内容,对最终质量影响最大,且不容易被快速“钻空子”。
为了提升训练效率,团队还引入了“提示词筛选”机制。并非所有提示词都适合用于强化学习训练。如果一个提示词,模型每次生成的图质量都差不多(不管好坏),说明学习信号很弱,没有多少改进空间。筛选方法是:用基础模型对每个候选提示词生成一批图,计算这批图奖励分数的“极差”(最高分减最低分)。只有极差超过阈值的提示词才被保留,因为它们说明模型在这个提示词上的表现存在明显好坏差异,这正是可以学习的空间。
团队还针对不同类别的提示词(人像、风景、文字排版、通用场景等)分别设置了奖励权重。人像类提示词给肖像奖励分配更高权重,文字排版类则更强调对齐奖励,确保模型在各个视觉领域都得到有针对性的优化,而不是被某一类场景带偏。
工程实现上,由于奖励模型是远程 API 服务,网络请求会引入延迟,同步等待会严重拖慢训练速度。团队设计了异步奖励管道:模型完成一批图像生成后,立刻在后台线程异步提交给奖励 API,同时 GPU 继续进行下一批图像的推理计算。等奖励结果返回后,再汇总各个节点的分数、做归一化、计算优势值,然后进行策略梯度更新。这样一来,奖励计算的等待时间几乎被完全“隐藏”在推理计算背后,整体训练速度大幅提升。
四、在线策略蒸馏:把两个专家合并成一个全能选手
强化学习训练结束后,团队有两个模型:一个在文生图方面表现出色,一个在图像编辑方面表现出色。但实际部署时只能用一个模型,而且两者不兼容——各自的优化过程可能在另一个任务上有所退化。
最直接的合并方式,是用混合数据、混合奖励对一个模型进行联合强化学习训练,让它同时优化两个任务。但这种方式存在根本性问题:两个任务的优化目标之间存在竞争关系,模型试图同时讨好两套奖励系统时,往往两边都顾不全,最终落入“中庸但不出色”的状态。
团队提出了一种更聪明的方案:在线策略蒸馏(OPD)。
这个方法核心思想借鉴自大语言模型领域的知识蒸馏。在大语言模型训练中,常见方法是让一个较小的“学生模型”学习一个较大的“教师模型”的输出概率分布,从而获得接近教师模型的能力。在图像生成领域,输出不是词的概率,而是一系列“速度向量”——即模型在每个去噪步骤中预测的“清洗方向”。
在 OPD 中,学生模型(从基础预训练模型初始化)在自己的生成轨迹上学习:先由学生模型自己完整走一遍从噪声到图像的生成过程,记录每一步所处状态;然后针对这条轨迹上的每个点,分别问教师模型“在这个状态下,你会朝哪个方向走”,并让学生模型的预测方向向教师模型靠拢。
这个设计的巧妙之处在于:学生模型是在“自己跑出来的路径”上学习,而不是在教师模型跑出来的路径上学习。这意味着学生学习时的起点状态,和它未来推理时实际遇到的状态一致,避免了“训练状态”和“推理状态”之间的分布错位。
从更严格的数学角度看,论文推导部分证明了 OPD 的训练目标,本质上是在最小化学生模型输出分布和教师模型输出分布之间的 Wasserstein-2 距离(衡量两个概率分布差异的指标)的上界。这个上界可以被转化为在学生自己的生成轨迹上,逐步匹配教师的速度场预测——这正是实际训练中执行的操作。
多教师蒸馏的实现方式也很务实:每次训练一批数据,根据样本属于文生图还是编辑任务,动态切换激活哪个教师模型(将另一个暂时卸载到 CPU 内存,以节省 GPU 显存)。学生模型因此能从两位专家那里分别学习,完全避免了任务奖励之间的直接竞争。
教师模型在预测速度方向时会使用 CFG(因为它们原本就是用 CFG 推理的),而学生模型则不依赖 CFG 进行训练,完成后再将 CFG 集成回学生的推理流程中。
为了验证这种分步蒸馏策略的优势,团队做了对比实验:把一个同时在文生图和编辑混合数据上做联合强化学习的基线(Mix-RL)和 Qwen-Image-2.0-RL 的 OPD 结果进行比较。结果显示,Mix-RL 虽然比基础模型有所提升,但在文生图任务中细节锐利度和提示词遵从度都不如 OPD 结果;在图像编辑中,Mix-RL 对复杂指令仍然执行不完整,人脸身份保真度也较弱;而 OPD 产出的模型,在两个任务上全面超越了 Mix-RL 基线。
五、测试结果:这套系统到底让图像好了多少?
Qwen 团队从两个维度全面评估:自动化基准测试和人类偏好评分。
在 Qwen-Image-Bench 这个专业评估体系下,评分涵盖质量、美感、对齐、真实世界保真度和创意生成五个一级维度,底层共有 56 个三级指标。评分由专门训练的“评判模型”Q-Judger 执行,Q-Judger 本身是在超过 13 万个由 80 位专业艺术家人工标注的图文对上训练出来的,能模拟专业人类评委的判断。
经过强化学习训练,Qwen-Image-2.0-RL 的总分从 55.23 提升到 57.84。分项来看,进步最显著的是“创意生成”维度,提升了 6.72 分,“真实世界保真度”提升了 4.29 分。相比之下,“质量”、“美感”、“对齐”三个维度也都有稳定提升,但幅度相对温和。
在更能反映真实用户偏好的 Elo 评分体系中,结果更直观。Elo 评分来自真实用户在匿名对比中的投票——当用户在两张图之间选择时,胜出图的 Elo 分上升,落败图下降。文生图方向,总体 Elo 从 1115 升至 1193,提升 78 分。分解到子类别,3D 建模场景提升最多(+93),其次是写实摄影(+91),反映了模型在结构一致性和细节渲染能力上的明显进步。图像编辑方向,总体 Elo 从 1256 飞升至 1349,提升 93 分,在研究涵盖的产品、3D、卡通、写实、艺术、人像、文字排版、编辑八个子类别中全面提升,没有一个维度出现退步。
放到同期其他主流系统横向对比,Qwen-Image-2.0-RL 在 Qwen-Image-Bench 上取得的 57.84 分处于同类系统中上游水平,超过了 Imagen 4.0 Ultra、GPT Image 1、FLUX 2 Pro、FLUX 2 Max、Seedream 4.0 系列等,但仍落后于 GPT Image 2(64.69)以及 Nano Banana 系列。
说到底,这项研究用一个朴素比喻就能概括:就像厨师从学徒变成名厨的过程。学徒阶段学的是“怎么把食材做熟”,这是基础技术,对应扩散模型的预训练阶段。但真正让厨师越来越好的,是持续得到食客的反馈——“这道菜盐放多了”“摆盘很好看”“肉的火候刚好”。Qwen 团队做的,正是给这位 AI 厨师搭建了一套系统化的“食客反馈机制”,并设计了明智的训练方案,让它能真正从反馈中学习,而不是走偏、走捷径。
这对普通用户意味着什么?意味着当你用 AI 工具生成图片时,说“画一个戴眼镜的老人坐在图书馆里”,AI 更有可能真的按你说的画,而不是给你一个不戴眼镜的年轻人站在街上;人像的皮肤会更有质感,手指数量更可能正确;编辑图片时,改了发色之后原来那张脸还认得出来。这些变化虽然不像发布一个全新模型那样引人注目,却恰恰是用户每天在使用这类工具时真正在乎的那些细节。
有兴趣深入研究技术细节的读者,可以通过 arXiv 编号 2606.27608 查阅完整原文,其中对奖励模型训练数据的构建、OPD 损失函数的数学推导,以及各项超参数的设计选择,都有详细的展开说明。
Q&A
Q1:Qwen-Image-2.0-RL 的在线策略蒸馏(OPD)和直接混合任务强化学习训练有什么区别?
A:混合训练是让一个模型同时优化文生图和图像编辑两个任务,但这两个任务的优化目标会互相竞争,导致模型两边都顾不周全。OPD 的做法是先分别训练两个专精的教师模型,然后让学生模型在自己生成的轨迹上向对应的教师模型学习,完全避免了两个任务之间的直接竞争,最终效果全面优于混合训练方案。
Q2:训练图像生成模型时为什么不能在生成和训练两个阶段都使用 CFG?
A:CFG(无分类器引导)是图像生成时的“风格放大器”,让图像更符合描述、风格更鲜明。在强化学习训练时若两个阶段都用 CFG,需要同时优化“有条件”和“无条件”两个分支,会导致梯度计算混乱、训练极不稳定,生成图像质量反而迅速崩溃。而完全不用 CFG,模型会逐渐失去风格表达能力。因此团队采用了折中方案:生成时用 CFG 确保候选图像质量,训练时不用 CFG 保持稳定。
Q3:Qwen-Image-2.0-RL 的奖励模型为什么要用绝对评分而不是两两对比打分?
A:两两对比只能告诉模型“哪张更好”,但无法传达具体好到什么程度;绝对评分则给每张图一个独立的具体分数,就像用标尺量长度而非比较两根棍子的长短。研究发现,绝对评分提供了更丰富的监督信号,训练出的奖励模型对图像质量的判断更精准,最终引导生成的图片质量更好、细节更丰富、伪影更少。
发现显卡风扇不转先别慌,这很可能是正常的智能启停功能。本文详解如何区分待机静音与硬件故障,提供从软件检测到物理清理的完整解决思路。
笔记本加装新内存后遇到黑屏或无法开机?不要慌张,本文通过重新插拔、清洁金手指、单根测试等具体操作步骤,帮你快速判断是安装失误还是硬件不兼容,并给出相应解决办法。
针对电脑主机前置USB接口无法识别设备的问题,本文提供一套基于因果逻辑的排查流程。涵盖检查机箱内部USB针脚连接、验证BIOS中USB控制器状态、更新芯片组驱动以及排除供电不足等常见原因,帮助用户快速恢复接口功能。
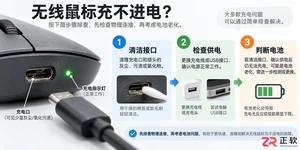
遇到无线鼠标充不进电的问题,不要急于更换设备。本文详解从清理接口氧化层、更换数据线到检测电池电压的完整排查流程,帮助你判断是临时故障还是硬件损坏。
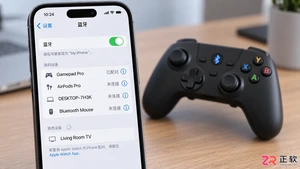
想知道如何用蓝牙手柄玩吃鸡游戏?本文详细讲解手机蓝牙手柄的连接步骤、主流映射软件的使用方法以及实战中的键位布局技巧,助你提升射击手感,同时解析外设玩家的匹配机制与注意事项。
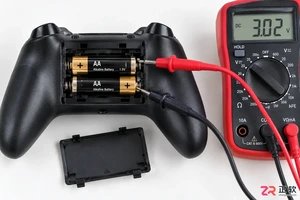
本文深入分析游戏手柄蓝牙频繁断开且需重连的根本原因,涵盖电池电压检测、操作系统电源管理策略及驱动冲突。通过具体的系统设置调整和固件更新步骤,解决蓝牙握手失败问题,恢复手柄的稳定连接状态。
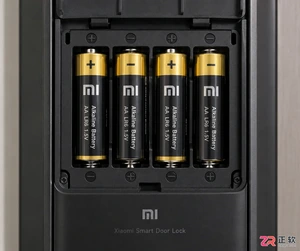
小米智能门锁更换新电池后无法开机或屏幕不亮?本文详解电池极性检查、金属触点清洁及强制重启方法,帮你快速解决供电问题,让门锁恢复正常使用。
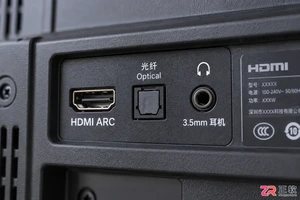
想让电视声音更震撼?本文详解如何通过HDMI ARC、光纤、蓝牙和3.5mm接口将电视连接至外置音响,包含具体设置步骤与常见问题排查,助你轻松打造家庭影院。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。