

复旦大学与阿里巴巴联手打造的"AI多面手"
复旦大学与阿里巴巴联合提出的UniAR框架,通过统一的二进制球形量化与多层特征融合,使单一自回归模型同时实现图片理解与生成。三阶段训练后,该模型在指令遵循、文字渲染等多项测试中超越GPT-4o等模型,并展现出直接理解自身生成内容的能力。
先抛个结论:复旦大学和阿里巴巴通义千问团队最近发布了一项新研究,直指多模态AI领域一个让人头疼的“老毛病”——视觉理解与视觉生成这两件事,在现有系统里基本是“分家”状态。这篇论文(arXiv:2606.18249)提出了一个叫UniAR的统一框架,目标就是让AI用同一套“语言”既看懂图像,又能画出来。效果如何?往下看。
一个让AI同时“看图”和“画图”的老难题
如果你用过能生成图片的AI,也用过那种能告诉你“照片里都有啥”的AI助手,你可能会觉得:这不都是处理图像吗,对计算机来说应该是一回事吧?
现实恰恰相反。对绝大多数现有AI系统来说,“看图”和“画图”本质上是两套完全独立的“大脑”在干活。它们用不同的“语言”描述同一张图片,就像一个人的左右手互相不认识对方。
这种割裂带来的后果挺尴尬的——你让AI先画张图,然后问它“你画的图里有几棵树”,它得把自己刚画出来的图重新“扫描”一遍,用另一套系统重新理解。打个比方,就像你自己写完一封信,转头就忘了,必须重新读一遍才知道写了什么。这不仅是效率问题,更从根本上阻碍了“真正统一的多模态智能”这个目标。
复旦大学和阿里通义千问的团队就是要解决这个问题。他们搞出了一个叫UniAR(Unified Auto-Regressive,统一自回归)的框架,核心思路一句话讲清楚:用一套统一的“翻译体系”,让AI既能看懂图、又能画图,而且画完以后可以直接回头理解自己画了什么,根本不用额外“重扫”一遍。
一、为什么“看图”和“画图”需要不同的能力,又为什么必须统一?
要搞清楚这项研究的意义,先得明白“看图”和“画图”对AI到底有啥两样。
当AI“看图”时,它关注的是图片的整体含义和高层语义。比如“这是一只狗”“这个人很开心”“背景里有座山”。这种理解依赖的是对宏观结构和语义关系的把握,好比你看一幅画时的整体感受。
当AI“画图”时,情况完全不同。要生成一张逼真的图片,AI必须关注像素级别的细节——毛发的纹理、光影的过渡、边缘的锐度。这就像一个画家不仅要“我想画只狗”,还得精确控制每一笔的粗细、颜色和位置。这种能力依靠的是低层次的、高频的视觉细节信息。
这两种需求在传统方法里是互相矛盾的。为了“看图”更准,AI需要能提取高层语义的编码器;为了“画图”更细,AI需要能保留低层细节的编码器。于是,几乎所有现有的“统一多模态模型”都采取了一个折中方案:在系统内部同时维护两套不同的视觉“词典”,一套用来看,一套用来画。
但这个折中方案引来了新麻烦。两套词典意味着两个独立的表示空间,图片在里面被描述成完全不同的形式——同一个故事用中文和法文各讲一遍,内容一致,但形式上互不相通。AI生成的图片,在“画图词典”里是一种表示,在“看图词典”里是另一种,两者之间没有直接对应关系。所以每次想理解自己画出来的图,它都得重新走一遍“看图”的完整流程。
UniAR的研究团队认为,这种割裂从根本上阻碍了真正的统一智能。他们的目标很明确:设计一套单一的视觉“词典”,既能满足看图对语义的需求,又能满足画图对细节的需求,实现真正的共享上下文——AI能直接理解自己生成的内容,无需任何中间转换。
二、解决问题的核心武器:一个能同时兼顾“意境”与“笔触”的视觉翻译官
UniAR团队为这个问题设计了一套精妙的方案,可以理解为“多层次融合的视觉翻译官”。
具体来说,这套方案的基础是一个叫SigLIP2的视觉编码器——相当于一位经验丰富的“图片理解专家”。这位专家在读一张图时,会在不同阶段产生不同层次的解读。早期(浅层)对细节纹理、颜色变化、边缘轮廓特别敏感;深度思考之后(深层),则更关注“整体是什么”“元素之间啥关系”这类宏观语义。
传统做法只用到这位专家“读完后的总结”(深层特征),这对看图理解来说够了,但对画图来说丢了太多细节。UniAR的创新在于:同时提取这位专家在多个阅读阶段的“笔记”——除了最终的深层特征,还额外融合了三个中间层的特征。这样一来,宏观语义和微观细节都保住了,两全其美。
但光融合多层特征还不够。AI处理语言用的是离散的“词语”(token),而图片特征是连续的数值,就像音乐的波形和乐谱的关系。要让语言模型能处理图片,必须把连续的图片信息转化成离散的“词语”。这个转化过程叫“量化”。
传统方法(向量量化,VQ)像给每种视觉特征分配一个固定编号,类似于图书馆的索引系统——每本书一个编号,查书就查号。但这有个严重限制:词典规模受限于你事先设定的编号数量,要扩大就得存大量编号,计算成本极高。
UniAR采用了一种更聪明的方式,叫“二进制球形量化”(Binary Spherical Quantization,BSQ)。不是给每个视觉特征分配固定编号,而是把每个特征转成一串由0和1组成的二进制代码,好比摩尔斯电码——用点和划的组合来表达任何信息。UniAR用的是64位二进制码,理论上有2的64次方种可能的视觉状态,大约1800亿亿种,远超任何传统词典的规模。而存储这套系统的成本极低——你只需要记住“0和1的规则”,不用存一个庞大的编号索引表。
这套“多层次融合+二进制量化”的视觉翻译官,就是UniAR整个系统的基石。它将图片转化成由0和1组成的数字代码,既包含高层语义,也保留低层细节,是真正能同时服务于“看图”和“画图”的统一表示。
三、让AI用同一套语言同时“读”和“写”图片:统一自回归模型
有了统一的视觉翻译官,下一步就是让AI真正学会用这套体系理解和生成图片。UniAR用的是自回归模型框架——可以理解为“接龙游戏”。
在文字接龙里,每个人根据前一个人说的词,预测并说出下一个词。大型语言模型(比如ChatGPT背后的技术)就是这样工作的:阅读所有已出现的词语,预测下一个最合适的词。UniAR把接龙游戏扩展到了图片领域:AI不仅能预测下一个文字词,还能预测下一个视觉“词语”(也就是那些由0和1组成的二进制代码)。
关键创新在于:UniAR用完全相同的接龙规则处理文字和图片,同一个系统里能无缝理解文字、理解图片、生成文字、生成图片——它们都是同一种接龙游戏的不同玩法。
不过,图片接龙面临效率挑战。一张512×512像素的图片,如果每个位置都要预测一个独立的视觉代码,总共得预测256步(压缩之后)。但UniAR引入了一个更巧妙的机制:并行位元预测。
传统接龙一次只说一个词。UniAR的方式是:一次同时说出一个2×2格子里多个位置的词,而且每个格子里还同时包含来自不同层次(浅层、中层、深层)的多个二进制代码。相当于把原本一个个完成的步骤,打包成一步完成。
经过这种压缩,原本需要大量步骤生成的图片,现在只需少得多的步骤。UniAR实现了32倍视觉压缩比——一张512×512的图只需256个预测步骤。如果再配合超分辨率技术,一张1024×1024的高清图也只要256步。而同样设定下的Janus-Pro和X-Omni需要4096步,速度差距非常明显。
在训练自回归模型时,研究团队还加入了一个有趣的“防错训练”技巧:随机翻转一部分二进制位。这是在模拟真实生成时可能出现的错误积累——接龙游戏里,前面说错一个词,后面可能越走越偏。通过在训练时故意引入错误,让模型学习在这种情况下仍能生成高质量图片,模型变得更健壮,即使在较高“随机性”(温度)下也能稳定输出优质结果。这项特性对后续的强化学习阶段尤其重要,因为强化学习需要模型在高随机性下进行广泛探索。
四、从“数字密码”到精美图片:视觉解码器的最后一棒
自回归模型生成的是一串由0和1组成的数字代码,但用户最终看到的是完整图片。把代码变成像素,这是视觉解码器的任务。
UniAR用的解码器基于扩散变换器(Diffusion Transformer,DiT),具体是Stable Diffusion 3.5 Medium。可以把这个解码器理解成一位精通还原工作的艺术家——给他一些关键的“草图指令”(即前面生成的视觉代码),他能据此还原出一张高质量的完整图片。
这位“艺术家”的工作原理是扩散过程:先从一张完全随机的噪声图片开始,一步步去除噪声,同时受到视觉代码的引导,最终还原出清晰的画面。视觉代码通过直接叠加到噪声图片的隐藏状态上来发挥引导作用,就像在一张白纸上轻轻描绘轮廓,然后让艺术家填充细节。
UniAR的解码器有一个重要设计特点:只依赖视觉代码,不需要任何文字提示作为输入。这与有些方法不同——那些方法的解码器同时接受文字和视觉代码输入。UniAR的核心理念是:所有语义信息和布局安排都应该在自回归模型阶段完成,解码器只负责“忠实地翻译”——把自回归模型已经规划好的视觉代码变成漂亮的图片,不需要也不应该在这个阶段引入新的语义干预。
此外,解码器还支持分辨率提升。自回归模型生成512×512分辨率的视觉代码,解码器可以通过插值技术放大到1024×1024的输出图片,在保持自回归阶段轻量高效的同时,最终呈现高分辨率结果。
五、三阶段修炼:从广博学习到精益求精
整个UniAR系统的训练分为三个递进阶段,就像学生从基础教育到专业培训再到实战演练。
第一阶段:大规模预训练。这是最耗时也最基础的阶段。团队准备了约1万亿词规模的训练数据,分为两个子阶段。第一子阶段用8000词的上下文窗口,处理最大512×512像素的图片,训练了约8000亿词;第二子阶段将上下文窗口扩展到32000词,图片分辨率提升到960×960像素,训练了约2000亿词。在这个阶段,视觉理解和视觉生成数据各占一半,模型在海量的“看图—说话”和“文字描述—生成图片”经验中建立起对世界的广泛认知。
第二阶段:监督微调。使用约500亿词规模的精心筛选高质量数据训练。数据来源于公开的合成数据集以及团队重新合成的数据,格式转化为更符合对话习惯的多轮交流形式,让模型学会更好地遵循复杂指令,处理多轮对话场景。
第三阶段:强化学习微调。这是最具创新性的阶段。基本思路是:让模型生成很多不同结果,然后根据质量打分,鼓励它往高分方向调整。团队设计了多个维度的打分标准。图片质量方面,用HPSv2和UnifiedReward两个工具评估美观度和自然度。文字渲染方面,用PaddleOCR识别生成图片中的文字,比较识别结果与目标文字的差距,差距越小分数越高。指令遵循方面,用一个基于目标检测的奖励系统,检查生成图片是否包含了提示词中要求的物体、数量、属性和位置关系。所有分数被归一化到0到1范围取平均值,作为最终奖励。
强化学习阶段分两步:先在512×512分辨率下训练500步,快速提升图片质量和指令遵循能力;然后在更高的960×960分辨率下再训练100步,重点提升长文本渲染质量。从实验数据来看,随着强化学习步数增加,模型在文字渲染的评测指标上稳步攀升——从监督微调结束时的71.1分,经过500步512分辨率训练后达到84.0分,再经过100步960分辨率训练后提升到87.3分,提升幅度相当显著。
需要说明的是,UniAR的强化学习目前仅针对图片生成任务,不涉及图片编辑和多模态理解任务——这是当前版本的一个阶段性选择。
六、实际表现:在多项测试中究竟做到了什么程度?
研究团队对UniAR进行了全面测试,覆盖图片生成、图片编辑和多模态理解三个主要方向。
指令遵循能力方面,使用GenEval基准测试。这个测试要求AI生成包含特定物体、数量、颜色、空间位置关系的图片,然后自动检测结果是否符合要求。UniAR(加入提示词重写)获得了0.86的综合分数,超越了GPT-4o(0.84)和专门用于生成的Flux.1-dev(0.82)。不加提示词重写时,UniAR也达到了0.85,在所有统一模型中处于领先位置。对比来看,BAGEL(另一个知名统一模型)加提示词重写后得0.88,是目前已知分数最高的统一模型,UniAR与它的差距不大。
文字渲染能力方面,这是让大多数图片生成AI头疼的能力——要在生成图中准确呈现指定文字,尤其是长文本。团队在OneIG-Bench(英文子集)和LongText-Bench(英文子集)上测试。在OneIG-EN上,UniAR取得0.873,超过GPT-4o的0.857;在专门针对长文本的LongText-EN上,UniAR取得0.917,超过Gemini 2.5 Flash Image的0.869。这两项成绩说明UniAR在文字渲染这个传统难点上取得了相当有竞争力的表现。
图片编辑能力方面,使用ImgEdit-Bench测试,涵盖添加物体、调整属性、提取元素、替换内容、移除物体、更换背景、改变风格、混合编辑和动作类编辑等多种任务。UniAR取得3.73的综合分数,超过了专门为图片编辑设计的Flux.1 Kontext Dev(3.71),以及BAGEL(3.20)、OmniGen2(3.44)等统一模型,仅低于GPT-Image-1 High(4.20)和专门的Qwen-Image-Edit(4.27)。
多模态理解能力方面,UniAR在OCR相关任务上表现突出:OCRBench得分833,DocVQA得分91.4,InfoVQA得分70.0,均超过了专门为理解优化的LLaVA-OV。在视频理解基准MVBench上,UniAR得分62.3,也超过了LLaVA-OV的56.7。不过,在MMMU这个侧重推理和广泛知识的综合测试上,UniAR得分44.3,与Qwen3-VL(69.6)等顶级理解模型相比仍有差距。团队分析,主要是预训练时没有引入纯文字数据,以及尚未对理解任务进行强化学习优化所致。
团队还专门测试了UniAR视觉编码器本身的理解能力,与其他主流编码器横向比较。结果显示,UniAR的视觉编码器(基于SigLIP2改造)在TextVQA、DocVQA和ChartQA三项文字相关的视觉问答任务上达到最优水平,分别得到63.1、38.0和26.8分,超过了原版SigLIP2、AIMv2和CoMP-SigLIP等竞争对手,验证了多层次特征融合策略的有效性。
七、一个意外惊喜:AI开始“对自己的创作负责”
在做各种消融实验(逐一测试各个设计选择的效果)时,团队发现了一个没有刻意设计但自然涌现的有趣能力。
由于UniAR使用了统一的视觉词典,它生成的图片和它理解的图片用的是完全相同的“语言”。这意味着,在同一个对话上下文中,UniAR可以直接“读懂”自己刚刚“写出来”的图片,不需要任何额外的重新编码步骤。
团队设计了一个测试:给UniAR一个模糊的描述,比如“一个漂亮的花瓶摆在桌子上,墙上挂着几幅画”,让它生成图片;然后在同一个对话中,紧接着问“花瓶和桌子之间有什么”“墙上挂了几幅画”这类关于生成图片细节的问题。
UniAR成功地回答了这些问题,答案完全符合它自己生成的图片内容——它回答“花瓶和桌子之间有一个圆形编织的餐垫”,而且“墙上挂了两幅画”。这两个细节是由UniAR在生成图片时自主决定的,既没有在原始提示词中指定,也没有经历任何重新编码过程。
这说明UniAR真正实现了“共享上下文”的目标:生成和理解在同一个表示空间中进行,AI可以像一个人回忆自己刚才做了什么一样,直接理解自己的生成结果。而Janus-Pro和BAGEL等依赖双重词典的模型无法做到——它们需要先把生成的图片重新用理解编码器编码,才能回答关于生成图片的问题。
八、系统有多快、训练成本怎样?
UniAR在推理效率上的优势很突出,主要得益于前面提到的并行位元预测和高压缩比设计。
在生成一张1024分辨率图片所需时间上,团队在相同的A100 GPU上(不使用分类器引导技术)进行了对比测试。Janus-Pro需要101.9秒,X-Omni需要119.7秒,而UniAR在不使用解码器超分辨率时只需要53.5秒,使用解码器超分辨率时更是只需要13.0秒——比Janus-Pro快了将近8倍。这种差异主要来自预测步骤数量的减少:Janus-Pro和X-Omni需要预测4096个视觉词语,UniAR只需要预测1024个(非超分辨率)或256个(超分辨率)。
在训练效率上,使用离散视觉词语(而非连续特征向量)还有一个附加优势:图片可以被预先处理成紧凑的二进制格式存储,无需每次训练时重新计算。这使得预训练的吞吐量比使用连续特征的方案提升了约30%(在8K上下文长度下,每次迭代时间从35.4秒降低到24.5秒)。
整个系统训练总耗费约3.3万GPU小时——其中预训练(8K阶段)约1.9万GPU小时,预训练(32K阶段)约1万GPU小时,监督微调约2000GPU小时,强化学习约1900GPU小时。
与最接近的竞争对手X-Omni相比,UniAR使用了更小的视觉编码器(4亿参数对比X-Omni的10亿参数)和更小的扩散解码器(25亿参数对比X-Omni的120亿参数),但在多数测试指标上仍能达到或超过X-Omni的水平,说明UniAR在参数效率上有一定优势。
九、还有什么没做到,未来往哪走?
团队在论文中坦率指出了当前版本的几个局限性。
由于资源限制,预训练阶段没有加入纯文字数据,导致在需要广泛语言知识和推理能力的任务(如MMMU)上表现不如专门的视觉语言模型。强化学习目前只针对图片生成任务,图片编辑和多模态理解任务尚未从中获益。此外,在美观度方面,UniAR的图片生成质量与GPT-Image-1等顶尖商业模型相比仍有差距。
对于未来,团队计划通过扩大训练数据规模和模型参数规模来进一步提升性能,探索更好的数据混合比例(特别是视觉数据和文字数据的搭配),开发针对不同领域(美观度、指令遵循、文字渲染)的专门奖励模型,以及将强化学习扩展到图片编辑和多模态理解任务上。
说到底,UniAR这项研究想做到的事情,就是让AI像人一样,用同一套感知体系去理解世界,又用同样的体系去表达和创造——看图和画图不再是两件事,而是同一种能力的两面。这个目标目前已经迈出了重要一步,但离真正完美的统一多模态智能还有相当的路要走。对于关注AI多模态能力发展的读者来说,这项来自复旦大学和阿里巴巴通义千问团队的研究提供了值得持续关注的技术方向。如果希望深入了解技术细节,可通过arXiv编号2606.18249查阅完整原文。
Q&A
Q1:UniAR为什么要用一个视觉词典同时处理看图和画图?
传统方法中,“看图”需要理解高层语义,“画图”需要保留低层细节,这两种需求不同,所以大多数系统用两套独立的视觉词典分别处理。但这样一来,AI画出来的图和它能看懂的图使用不同的“语言”,生成后必须重新编码才能理解自己画了什么。UniAR通过多层次特征融合和二进制量化,设计出一套同时保留高层语义和低层细节的统一词典,从根本上解决了这个割裂问题。
Q2:UniAR的并行位元预测是怎么提高速度的?
传统自回归方法每次只预测一个视觉词语,生成一张图需要大量步骤。UniAR的并行位元预测机制每次同时预测一个2×2格子中多个位置、多个层次的二进制代码,相当于把多个独立的预测步骤打包成一步完成。配合32倍的空间压缩比,一张512×512图片只需256步即可生成。若再使用解码器超分辨率,1024×1024的高清图片仍只需256步,比同类模型快近8倍。
Q3:UniAR在强化学习阶段具体是怎么打分的?
UniAR的强化学习使用了多维度的打分体系。图片质量方面用HPSv2和UnifiedReward评估美观度和自然度;文字渲染方面用PaddleOCR识别生成图片中的文字,与目标文字计算编辑距离;指令遵循方面用目标检测工具检查图片是否包含提示词中要求的物体、数量、属性和关系。所有分数归一化到0到1后取平均值,作为最终奖励信号来优化模型。
阿里巴巴2026财年ESG报告显示,AI成为效率与价值杠杆。自建数据中心PUE优化至1.187,清洁电力比例达73.6%,自身减排319.5万吨,带动客户避免排放约1亿吨。同时开源超400个模型,AI云教室覆盖400余所,平扫CT+AI筛查30万人次确诊800余例,高德鹰眼发布230亿次预警。
阿里巴巴发布视频生成模型HappyHorse1.1,在动态表现力、主体一致性、指令遵循能力、视觉质感和音频处理等维度实现系统升级,视频流畅度、稳定性和画质显著提升,已登陆阿里云百炼与千问云平台。
阿里Qwen团队提出Qwen-Image-2.0-RL,通过强化学习与人类反馈构建多维度奖励模型(图文对齐、美感、肖像),结合GRPO算法和混合CFG策略训练,并采用在线策略蒸馏合并文生图与编辑能力。在Qwen-Image-Bench总分提升2.61分,Elo评分文生图提升78分,图像编辑提升93分。
在企业内部,将云原生基础架构作为企业内部的统一架构已成为大势所趋。与此同时,也必然带来了由各种基础平台整合带来的兼容性问题,特别是规模越大、历史沉淀越多的企业,这种“技术债务”体现得越明显。本文分享的经验来自于阿里巴巴过去数年来在混合调度方面积累的生产实践积累,具有很强的生产实用价值。内容由浅入门,
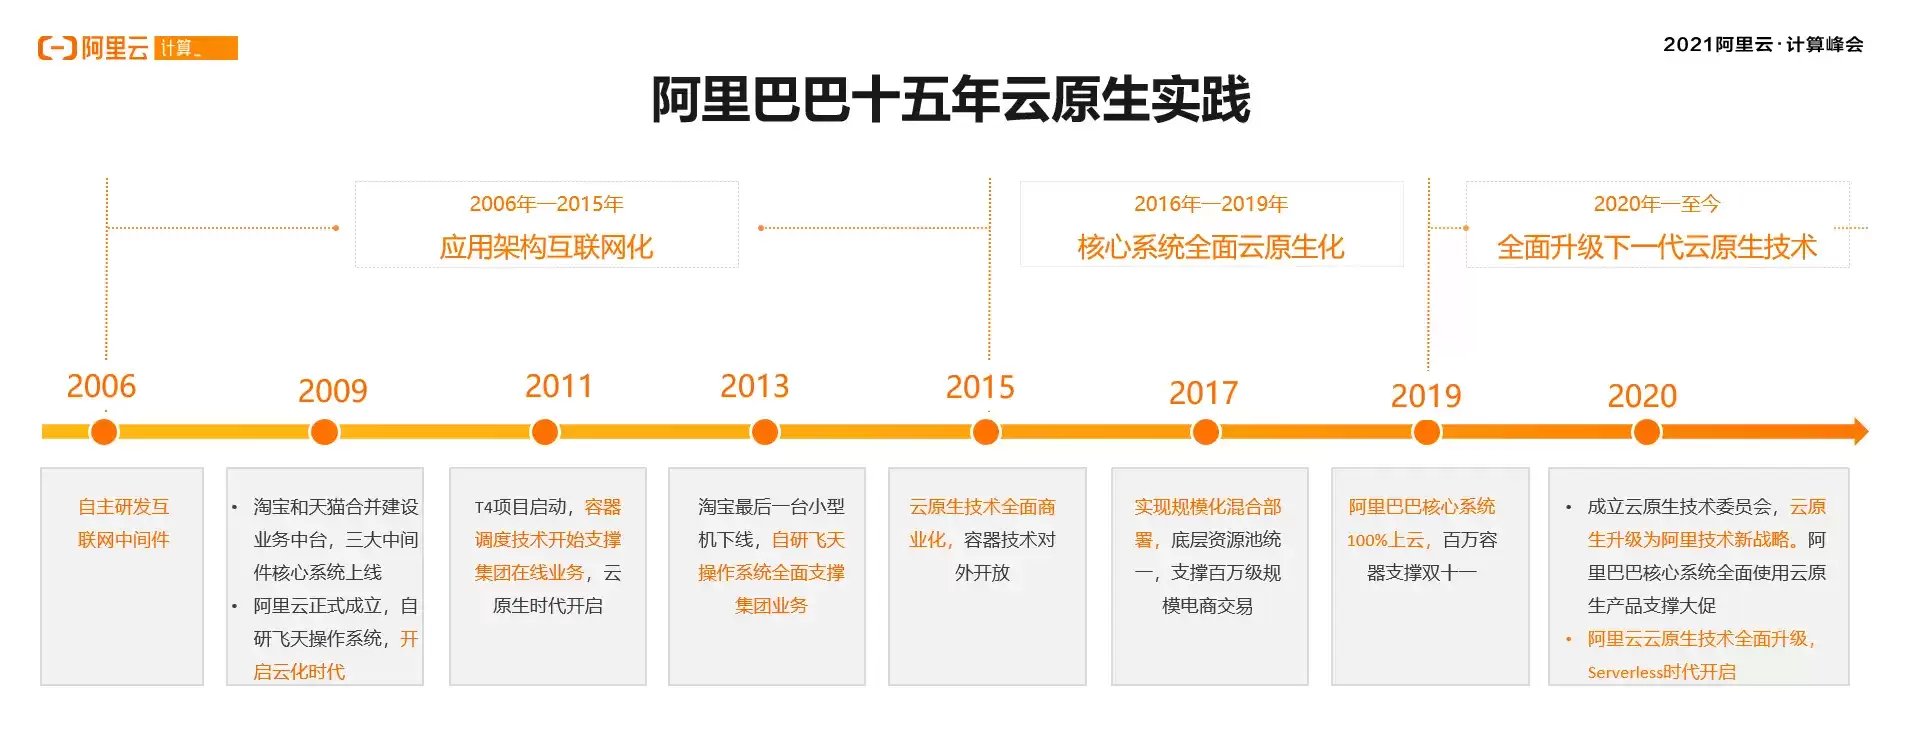
今天,数字化成为企业的核心竞争力,千行百业都在拥抱云计算,拥抱云原生。2020年我们认为是云原生的落地元年,那么2021年将是云原生加速推动企业数字创新的关键节点。在3月29日阿里云计算峰会上,阿里巴巴研究员、阿里云智能云原生应用平台负责人丁宇(叔同)发表了《云原生,企业数字创新的最短路径》主题演讲
简介: 目前 KubeNode 已经覆盖了阿里巴巴集团的所有的 ASI 集群,接下来,将随着阿里巴巴集团“统一资源池”的项目,推进 KubeNode 覆盖更大的范围、更多的场景,让云原生的容器基础设施运维架构发挥更大的价值。 阿里巴巴节点运维的挑战 在阿里巴巴的场景下,做节点运维面临的挑战主要来自于
技术的成熟度源自大规模的实践,在 Ja va 领域,阿里将自身的实践源源不断的反哺给微服务技术体系;在 Node.js 领域,阿里正掀起了前所未有的前端革命浪潮,将实践反哺给 Serverless 技术体系,并逐渐拓展到其他多语言体系和后端 BaaS 上。Serverless云研发平台,乃阿里巴巴集
受台风和强降雨影响,广西南宁、贵港出现险情。阿里巴巴启动防汛应急行动,首批调拨1万个应急照明设备紧急装车,菜鸟物流负责人连夜赶赴现场协调。同时,阿里公益与壹基金支持的首批2500份应急食品已发车驰援灾区。
对于从事批发采购或寻找源头工厂的朋友来说,一个高效、可靠的线上采购平台至关重要。今天,我们就来详细解析1688阿里巴巴官网——这个国内领先的B2B批发市场,看看它如何打通从选品到交易的每一个环节,成为众多生意人的首选采购通道。其官网地址是 https://www.1688.com/,您可以直接访问,
如果您正在寻找阿里巴巴1688的官方商家登录入口,请认准这个唯一的官方网址:https://www.1688.com。这里是所有商家进行采购、店铺管理与批发交易的核心官方通道。通过此入口,您可以安全、高效地开启数字贸易之旅。 网络上可能充斥着各种引导链接,例如“阿里巴巴批发网1688入口☜☜☜点击进





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



