

Python教程:用日志清洗脚本学会异常处理与生成器
这篇 Python 教程通过一个真实可运行的日志清洗工具,讲解自定义异常、异常链、生成器、Counter、严格模式和退出状态。
刚开始写 Python 脚本时,最容易获得成就感的是“文件读出来了”。真正麻烦的部分往往出现在第三步:日志里混进一条坏数据,整个程序直接停了。
全部忽略当然也能跑完,但你随后会遇到更难回答的问题:到底丢了多少行?为什么丢?自动化任务应该算成功还是失败?
这篇 Python 教程不再重复变量和循环,而是完成一个可运行的日志清洗工具。输入一个 timestamp|level|message 格式的 UTF-8 日志文件,它会逐行校验数据、保留有效记录、统计日志级别,并把坏行原因放进 JSON 报告。脚本还提供严格模式,方便接进 CI 或定时任务。
先把“正常”和“异常”写成规则
我们先约定每行日志包含三个字段:
2026-09-03T10:00:00|INFO|service started规则看起来很简单,但至少有四种输入不能悄悄放过:
- 缺少分隔符,拆不出三个字段;
- 时间不是 ISO 8601 格式;
- 日志级别不在允许列表中;
- 消息字段为空。
这一步很重要。异常处理不是看到报错就套一层 try...except,而是先划清哪些问题可以恢复,哪些问题应该让程序停下来。
当前工具把单条坏行视为“可恢复”:记录原因,继续处理后面的行。文件不存在、无权读取或者脚本自身出现未知错误,则不应该伪装成一次成功清洗。
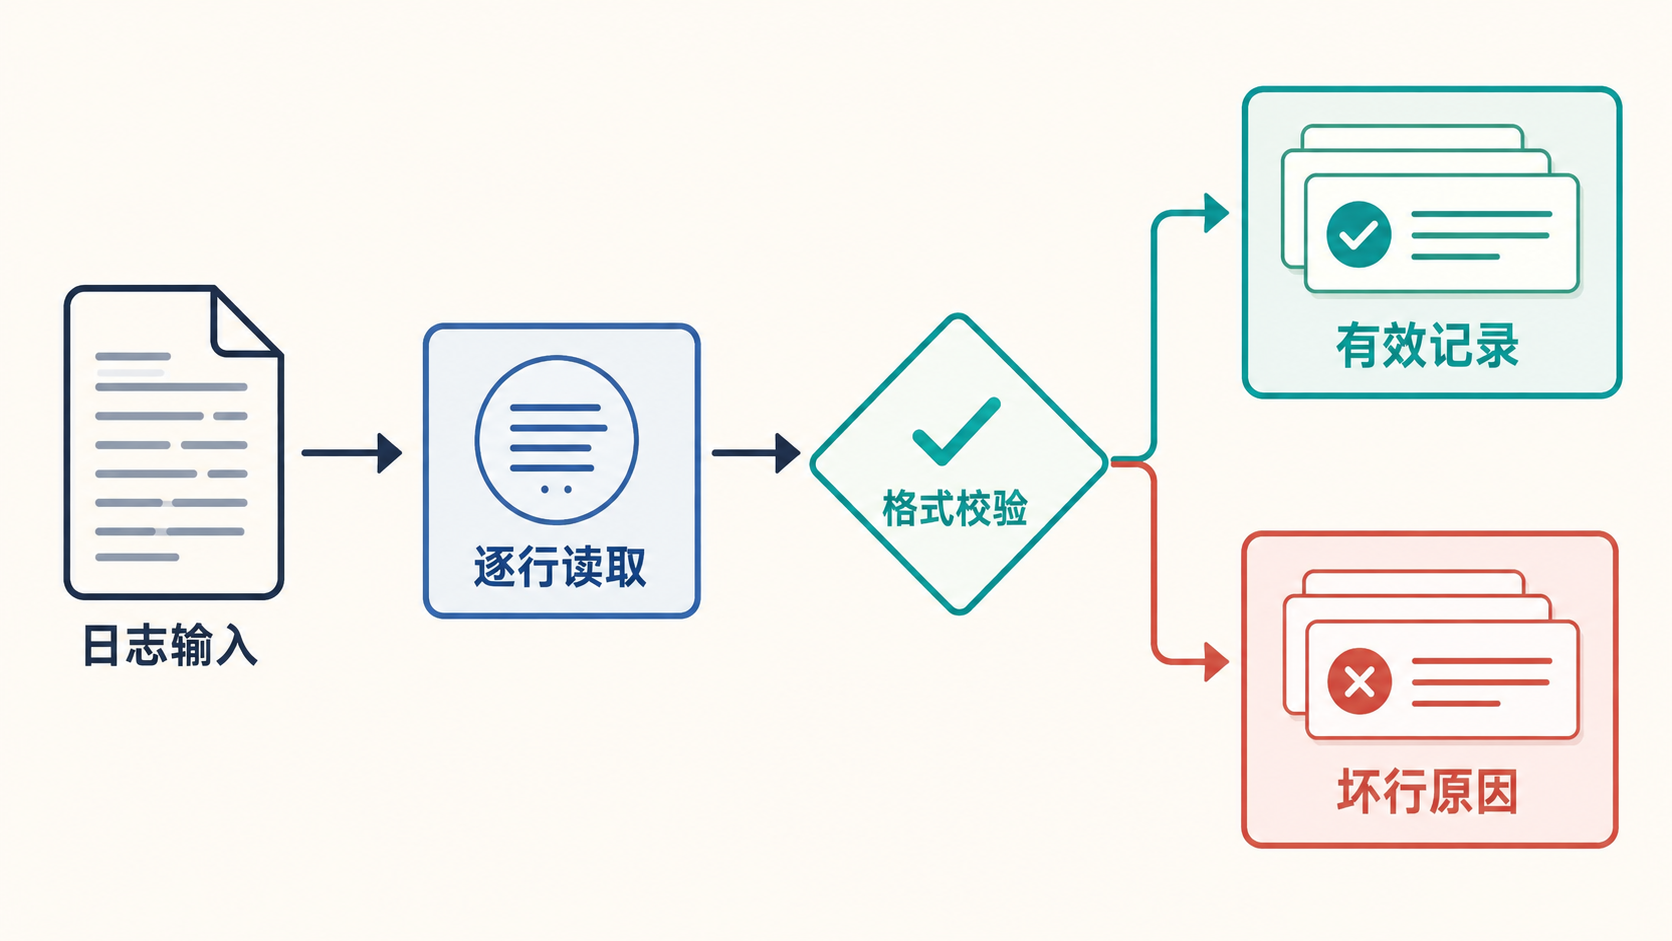
图:格式校验是分界点,有效记录继续参与汇总,坏行则保留具体原因。
用自定义异常表达数据错误
先实现一行日志的解析:
from datetime import datetime


VALID_LEVELS = {"DEBUG", "INFO", "WARNING", "ERROR", "CRITICAL"}


class LogFormatError(ValueError):
    """一行日志不符合 timestamp|level|message 约定。"""


def parse_line(line: str, line_number: int) -> dict[str, str]:
    parts = line.rstrip("\n").split("|", 2)
    if len(parts) != 3:
        raise LogFormatError(f"第 {line_number} 行:字段数量不是 3")

    timestamp, level, message = (part.strip() for part in parts)
    try:
        datetime.fromisoformat(timestamp)
    except ValueError as exc:
        raise LogFormatError(
            f"第 {line_number} 行:时间不是 ISO 8601 格式"
        ) from exc

    level = level.upper()
    if level not in VALID_LEVELS:
        raise LogFormatError(f"第 {line_number} 行:未知级别 {level!r}")
    if not message:
        raise LogFormatError(f"第 {line_number} 行:消息为空")

    return {"timestamp": timestamp, "level": level, "message": message}
这里有三个设计点。
第一,split("|", 2) 最多拆两次。这样消息正文里即使包含 |,剩余内容仍会留在第三个字段中;直接使用不带次数限制的 split("|") 反而容易误伤正常消息。
第二,输入中的 warning 会统一转换成 WARNING。这是可以恢复的格式差异,不需要把整行判坏。
第三,时间解析产生的 ValueError 被转换成更贴合业务含义的 LogFormatError,同时通过 raise ... from exc 保留原异常链。Python 官方异常教程建议尽量捕获具体异常,让未预料的问题继续暴露,而不是用一个宽泛的 except Exception 把所有错误吞掉。
为什么这里要用生成器
解析一行之后,还要遍历整个文件。最直观的写法是先把所有结果放进列表,但我们其实只需要“取一条、处理一条”。生成器正适合表达这种过程:
from pathlib import Path
from typing import Iterator


def iter_records(
    path: Path,
    errors: list[str],
) -> Iterator[dict[str, str]]:
    with path.open(encoding="utf-8") as log_file:
        for line_number, line in enumerate(log_file, start=1):
            if not line.strip():
                continue
            try:
                yield parse_line(line, line_number)
            except LogFormatError as exc:
                errors.append(str(exc))
函数中出现 yield 后,它返回的是生成器。调用方每请求下一条数据,函数才从上次暂停的位置继续执行。Python 官方教程把生成器描述为创建迭代器的一种紧凑方式,局部变量和执行位置会在两次取值之间保留下来。
这意味着代码不需要先构造“全部有效记录”的列表。需要克制一点:这并不自动证明脚本在任何场景都更快,它只是改变了数据产生方式,减少了为有效记录额外保存完整列表的需要。实际性能仍取决于日志大小、磁盘和后续处理。
errors 列表则是这版实现的现实取舍。它会保留所有错误文本,方便输出报告;如果坏行多到不可控,这个列表仍会占用内存。生产版本可以只保留前 N 条错误,再单独累计总数。
Counter 把汇总逻辑压缩到一行
有了有效记录流,就可以统计各级别出现次数:
from collections import Counter


def build_report(path: Path) -> dict[str, object]:
    errors: list[str] = []
    levels = Counter(
        record["level"]
        for record in iter_records(path, errors)
    )
    valid_lines = sum(levels.values())

    return {
        "file": str(path.resolve()),
        "valid_lines": valid_lines,
        "invalid_lines": len(errors),
        "levels": dict(sorted(levels.items())),
        "errors": errors,
    }
Counter 是一个专门计数可哈希对象的字典子类。生成器每交出一条有效记录,Counter 就给对应的日志级别加一。最后再转回普通字典,让 JSON 输出更直观。
为什么不把计数写进 parse_line()?因为解析函数应该只回答“这一行是否合法、解析结果是什么”。汇总是另一个层次的职责。两者拆开以后,后面改成按服务名或日期统计时,不必动底层格式校验。
同一份报告,为什么需要两种退出策略
交互运行脚本时,遇到几条坏行通常希望继续处理;接进数据流水线后,坏行又可能意味着上游格式已经变化,任务必须亮红灯。
因此命令行增加一个 --strict 开关:
import argparse
import json


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser(
        description="清洗 timestamp|level|message 格式的 UTF-8 日志。"
    )
    parser.add_argument("log_file", type=Path, help="待处理日志文件")
    parser.add_argument(
        "--strict",
        action="store_true",
        help="发现坏行时返回非零状态",
    )
    return parser.parse_args()


def main() -> int:
    args = parse_args()
    if not args.log_file.is_file():
        raise SystemExit(f"文件不存在:{args.log_file}")

    report = build_report(args.log_file)
    print(json.dumps(report, ensure_ascii=False, indent=2))
    return 2 if args.strict and report["invalid_lines"] else 0
默认模式始终输出报告,发现坏行后继续处理,程序正常结束。严格模式也会输出相同报告,但只要存在坏行就返回退出码 2。Shell、CI 或定时任务可以据此判断这次清洗是否满足质量要求。
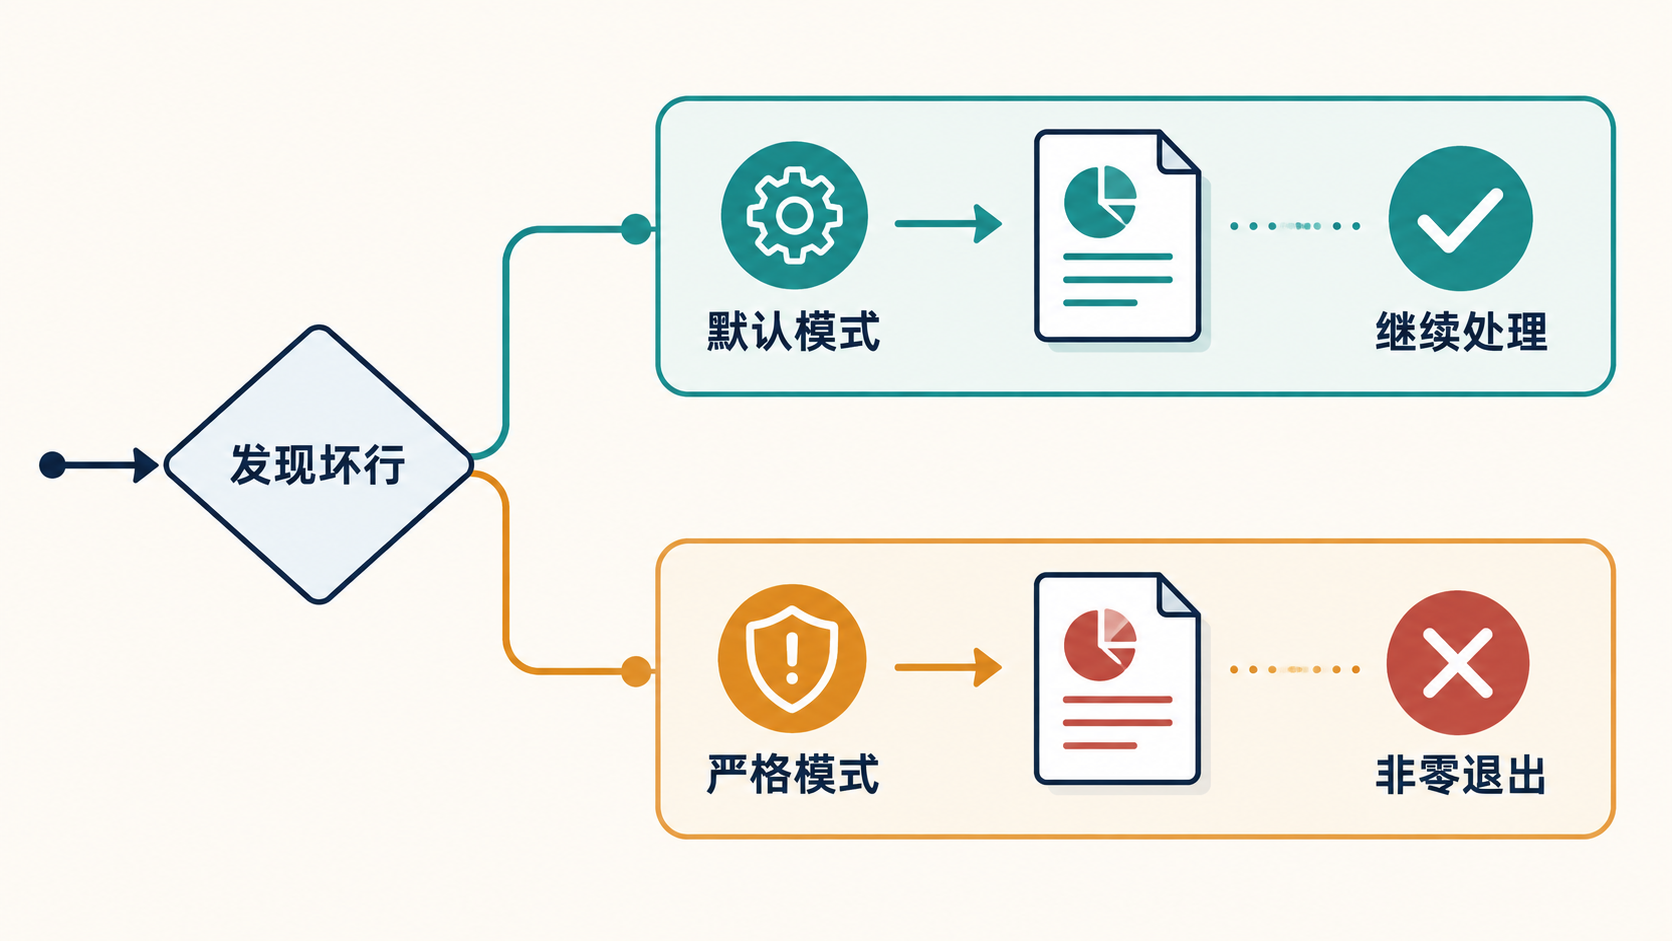
图:两种模式都保留报告,区别是严格模式会用非零退出状态通知自动化系统。
运行真实样例,别只看代码猜结果
把脚本保存为 log_cleaner.py,准备下面这份 sample-data/app.log:
2026-09-03T10:00:00|INFO|service started
2026-09-03T10:00:01|ERROR|database timeout
this line is malformed
2026-09-03T10:00:03|warning|queue depth high
2026-09-03T10:00:04|TRACE|cache lookup
2026-09-03T10:00:05|ERROR|retry exhausted
在脚本所在目录执行:
python3 log_cleaner.py sample-data/app.log本文示例在 Python 3.14.2 环境真实运行,关键输出如下:
{
  "valid_lines": 4,
  "invalid_lines": 2,
  "levels": {
    "ERROR": 2,
    "INFO": 1,
    "WARNING": 1
  },
  "errors": [
    "第 3 行:字段数量不是 3",
    "第 5 行:未知级别 'TRACE'"
  ]
}
绝对文件路径在上面的节选中省略,完整输出会保留 file 字段。
再运行严格模式:
python3 log_cleaner.py sample-data/app.log --strict
echo $?
实测退出码是 2。这不是异常崩溃,而是脚本按约定主动给调用方的质量信号。
测试要覆盖坏数据,而不只是正常路径
这类工具最值得测的恰恰是异常输入:
def test_report_separates_valid_and_invalid_lines(self) -> None:
    source.write_text(
        "2026-09-03T10:00:00|INFO|started\n"
        "bad line\n"
        "2026-09-03T10:00:01|error|timeout\n"
        "2026-09-03T10:00:02|TRACE|unknown level\n",
        encoding="utf-8",
    )

    report = build_report(source)

    self.assertEqual(report["valid_lines"], 2)
    self.assertEqual(report["invalid_lines"], 2)
    self.assertEqual(report["levels"], {"ERROR": 1, "INFO": 1})
完整示例还测试了严格模式的退出码。实际执行:
python3 -m unittest -v test_log_cleaner.py结果为 2 tests OK,脚本和测试文件也通过了 py_compile 语法检查。
这份脚本的边界在哪里
它适合学习和处理格式明确的小型文本日志,但还不是通用日志平台:
- 分隔格式是自定义约定,不支持多行消息;
- 只处理 UTF-8,其他编码会在文件读取阶段失败;
- ISO 时间只校验格式,没有统一时区;
- 所有坏行原因都会留在内存中;
- 统计结果只按日志级别聚合,没有时间窗口和服务维度。
下一步可以增加 --max-errors 限制错误样本数量,要求时间必须带时区,并把有效记录写成 JSON Lines。日志量继续增大后,再考虑批量落盘、压缩输入和并行处理;在没有测量数据前,不要先承诺性能提升。
这次真正要带走的不是某个固定日志格式,而是一条可复用的 Python 编程路径:把输入规则写清楚,用具体异常表达可预期错误,用生成器逐条交付数据,再通过退出状态把结果告诉外部系统。遇到下一个文件处理任务时,这套拆法仍然成立。
参考资料
解析 python编程游戏 的核心开发流程,提供基于官方文档的环境准备、依赖安装命令及验证方法,包含清晰的决策图与排错路径,适用于具备基础命令行能力的后端开发者。
面向后端开发者的 python自学实操指南。涵盖 Python 官方概念界定、虚拟环境创建、依赖安装验证及常见排错路径,提供可执行的 Bash 命令与决策流程图。
针对后端开发者的 python自动化 入门指南,涵盖 venv 虚拟环境创建、pip 依赖管理及官方文档依据的验证步骤,提供清晰的决策图与排错建议。
面向后端开发者的 python文档 实操指南。涵盖环境检查、venv创建、pip升级及依赖验证,提供清晰的决策图与命令示例,避免常见配置错误。
面向后端开发者的 python循环 实操指南。涵盖环境检查、虚拟环境创建、依赖安装及验证步骤,结合官方文档与决策图,确保操作可复现且边界清晰。
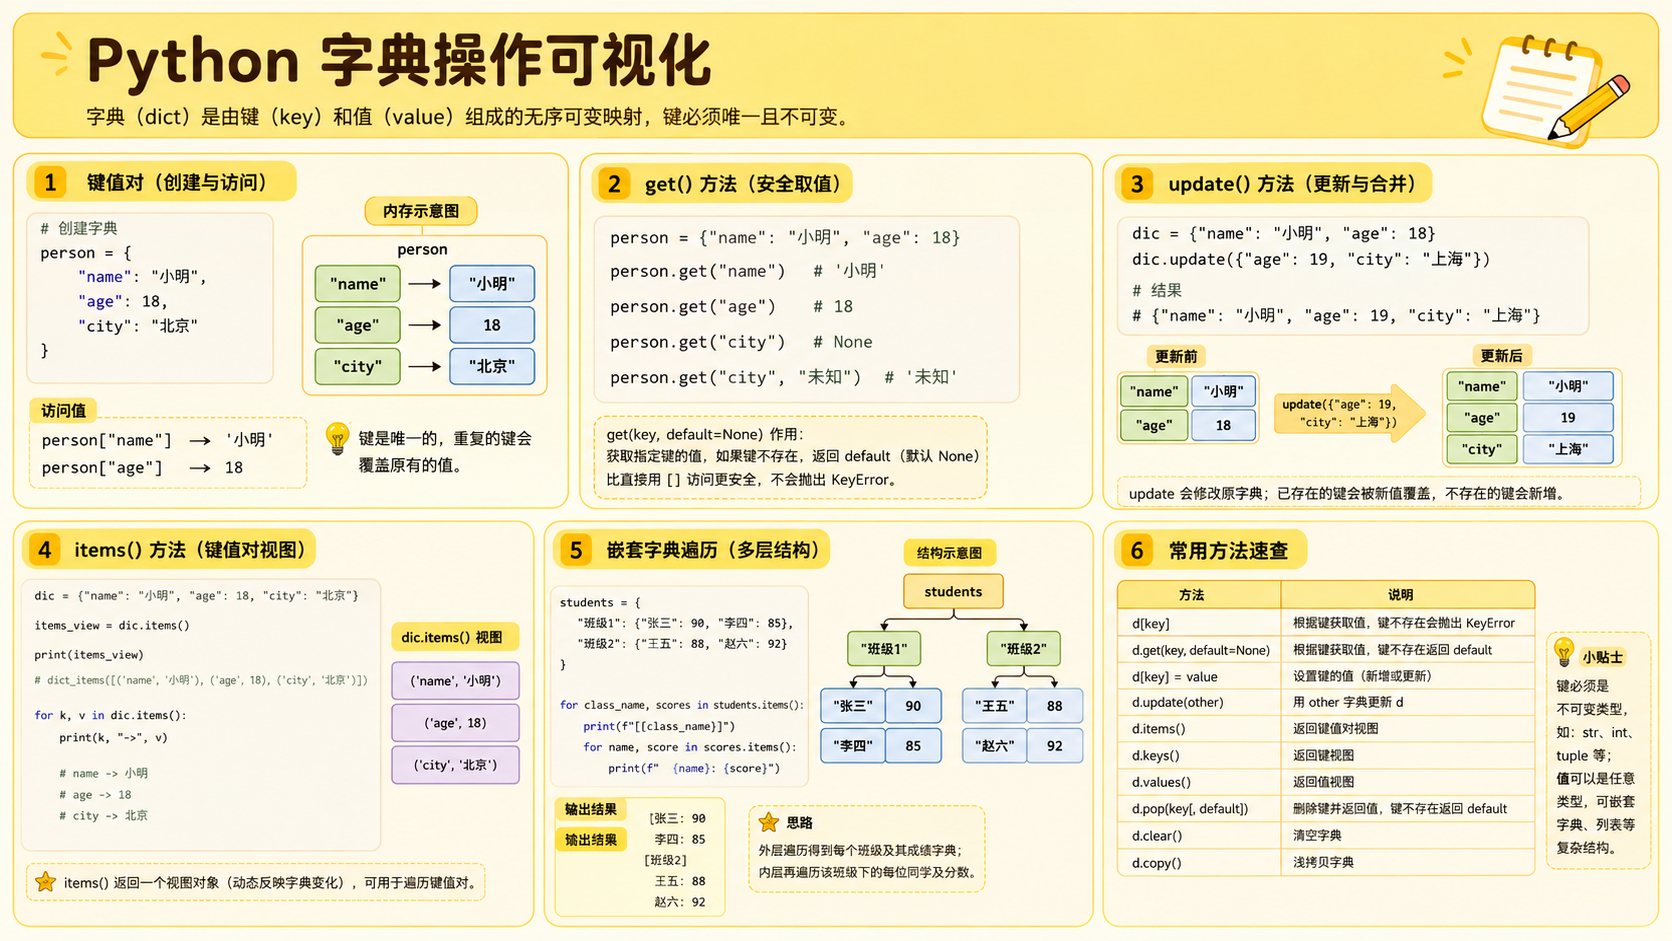
详解 Python 字典的键值访问、遍历与嵌套结构,并提供基于官方文档的 Python 环境搭建、虚拟环境隔离及依赖管理步骤,帮助开发者建立可复现的开发工作流。
针对后端开发者,详解 Python 编程基础的环境搭建、依赖隔离与验证方法。基于官方文档提供可复现命令,明确工具边界,帮助读者建立最小可测试代码闭环。
选择服务器类型对Python项目部署的影响在于性能、可伸缩性、维护成本和部署复杂性。1.VPS适合中小型项目,成本可控且环境可控,但需自行维护;2.云平台集成丰富服务,适合用户增长后的复杂架构,但学习成本高;3.PaaS部署简便,适合快速原型开发,但控制权受限;4.容器化适合大型项目,提供部署一致性和扩展性,但学习成本高。配置Nginx与Gunicorn实现稳定运行需:1.Gunicorn绑定Unixsocket并设置合理worker数;2.Nginx配置反向代理指向socket、处理静态文件和SSL;3
要禁止Python第三方库的控制台打印,需根据情况选择方法:1.全局屏蔽输出可通过重定向sys.stdout和sys.stderr到/dev/null(或Windows的nul)实现,但需保存原始流并在操作后恢复,避免影响后续输出;2.针对使用logging模块的库,可获取其logger并设置日志级别(如WARNING),从而屏蔽低级别日志输出,同时可配置handler和formatter控制输出行为;3.若库直接使用print函数,则可临时替换builtins.print为无操作函数,执行后再恢复原始p
搭建Selenium自动化测试环境步骤如下:1.安装Python并配置环境变量;2.确保pip已安装;3.使用pip安装selenium库;4.安装webdriver_manager库以自动管理浏览器驱动;5.安装目标浏览器如Chrome。使用Selenium进行元素交互和断言的方法包括:通过ID、Name、ClassName、TagName、LinkText、PartialLinkText、CSSSelector或XPath定位元素;执行click()、send_keys()、clear()等操作;利用




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


