

fastapi下载文件接口实现教程
深入解析在FastAPI框架中实现文件下载接口的完整方案,涵盖基于FileResponse的本地静态文件传输、基于StreamingResponse的分块流式传输、RFC 5987中文文件名编码规范、路径穿越安全防御及BackgroundTasks临时文件清理,并配备详细代码示例与架构解析图。
在 FastAPI 中构建文件下载接口,核心方案主要划分为两类:针对服务器本地已存在的实体文件,使用 FileResponse 是最直接高效的途径,框架会自动计算文件长度、推断 MIME 类型并支持断点续传;针对动态生成的大数据报表或海量文件,使用 StreamingResponse 配合异步分块生成器能够以极低的内存开销完成流式回传。结合规范的 Content-Disposition 中文文件名编码(RFC 5987)与 BackgroundTasks 临时文件回收,即可搭建出安全、稳定的生产级下载服务。
一、FastAPI 文件传输机制与响应选型
在基于 ASGI 架构的 FastAPI 中,文件下载本质上是通过 HTTP 响应头向客户端告知传输内容的类型、长度以及处置方式(作为附件下载还是由浏览器就地打开渲染)。FastAPI 自身构建于 Starlette 基础之上,为文件传输提供了两套成熟的专门响应类:
- FileResponse:专用于将服务器本地磁盘中的现有物理文件发送给客户端。它会调用底层的异步文件读取或操作系统高效的文件传输通道(如内核级零拷贝优化),并根据文件扩展名自动匹配正确的
Content-Type和Content-Length。 - StreamingResponse:专用于流式传输。它接收一个普通生成器或异步生成器(Generator),将数据按照切片块(Chunk)逐步推送给客户端,数据传输时采用分块传输编码(Transfer-Encoding: chunked)。
两者的核心区别在于数据是否需要在磁盘上落地,以及内存消耗模式的不同。理解它们的适用边界是开发高效文件下载服务的第一步。
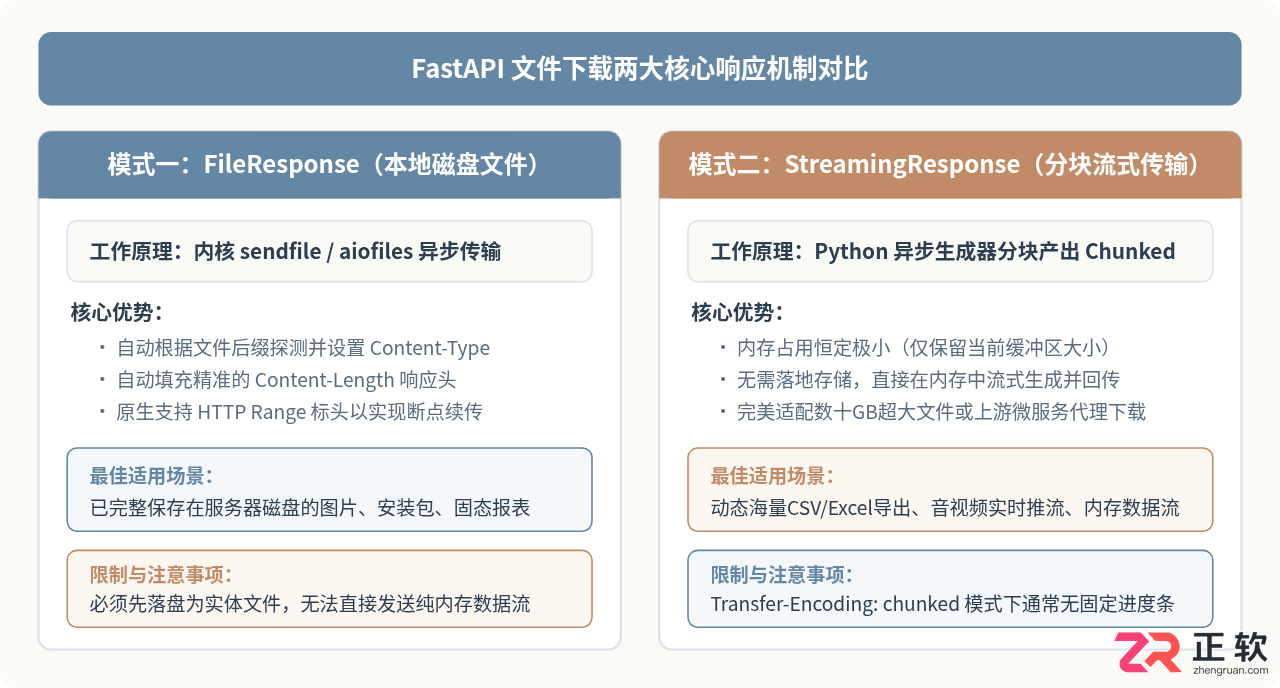
从技术权衡来看,如果文件已固化在磁盘上(如用户上传的合同、生成的静态图片),优先选用 FileResponse;如果需要实时将数据库中数十万条记录导出为 Excel 或 CSV,直接在内存中生成并使用 StreamingResponse 能够彻底避免写入磁盘与读取磁盘的双重 I/O 延迟。
二、基于 FileResponse 的本地文件下载实现
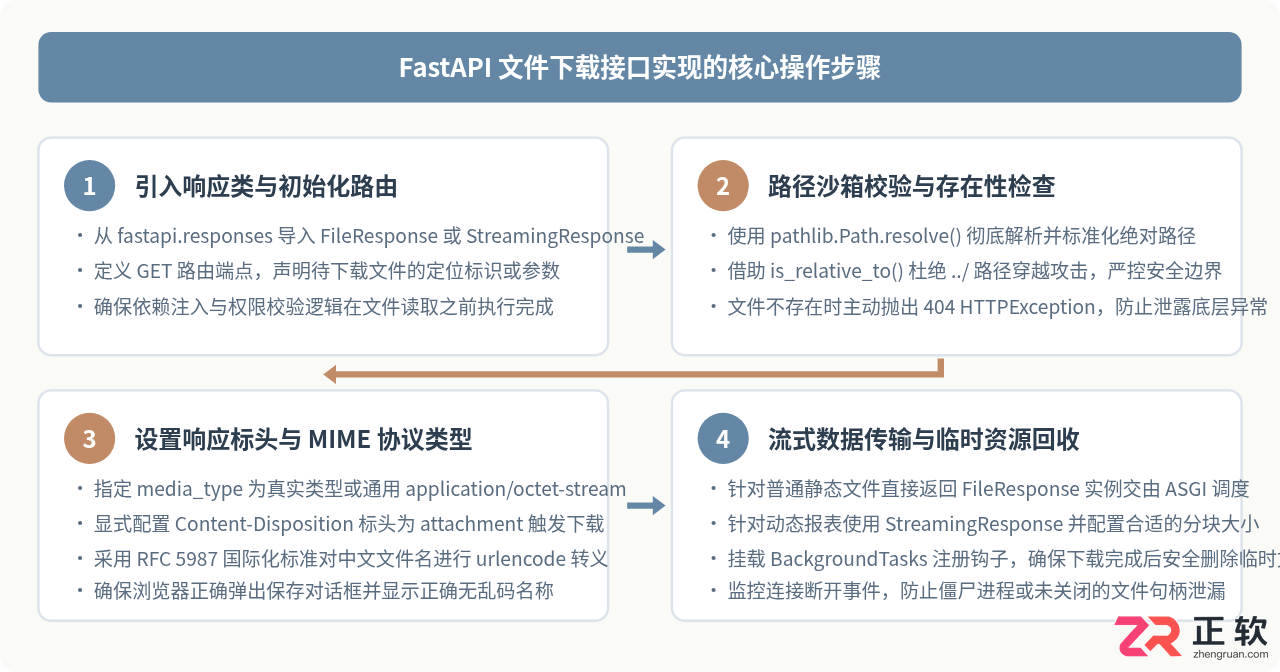
实现一个标准的本地文件下载接口,需要完成端点声明、物理路径安全检查以及响应参数装配。在实际 Web 应用中,最容易被忽视且后果严重的安全隐患是路径穿越漏洞(Directory Traversal),攻击者可能通过传入 ../../etc/passwd 等相对路径读取非授权目录。
2.1 标准接口代码实现
以下示例展示了如何在 FastAPI 中构建一个带沙箱路径校验的安全下载接口:
from pathlib import Path
from fastapi import FastAPI, HTTPException
from fastapi.responses import FileResponse

app = FastAPI(title="文件下载服务示例")

# 定义统一的受控存储根目录
STORAGE_DIR = Path("/data/app_storage/files").resolve()

@app.get("/api/v1/download/{filename}")
async def download_file(filename: str):
    # 严格解析目标文件的绝对物理路径
    target_path = (STORAGE_DIR / filename).resolve()

    # 路径安全沙箱校验:必须严格归属于 STORAGE_DIR 且为常规实体文件
    if not target_path.is_relative_to(STORAGE_DIR) or not target_path.is_file():
        raise HTTPException(status_code=404, detail="目标文件不存在或无法访问")

    return FileResponse(
        path=target_path,
        filename=filename,
        media_type="application/octet-stream"
    )
2.2 核心参数解析
在上述代码中,FileResponse 的三个参数承担着不同的协议任务:
path:服务器磁盘上的绝对或相对物理路径。FastAPI 会校验该路径并打开流进行传输。filename:通知客户端保存文件时的默认文件名。当提供此参数时,FastAPI 会自动在响应头中附加Content-Disposition: attachment; filename="...",促使浏览器弹出下载对话框。如果不设置该参数,浏览器可能会根据文件类型直接在窗口内预览(如 PDF 或常见图片)。media_type:响应的 MIME 类型。设置为application/octet-stream表示任意二进制流,强制客户端按文件流处理;如果不显式指定,FastAPI 会根据文件后缀名自动从系统 MIME 字典中推导(例如.pdf对应application/pdf)。
三、基于 StreamingResponse 的大文件与动态数据流
当需要下载的文件体积达到几百兆甚至数个吉字节,或者文件由业务程序动态拼装时,一次性将整个文件读取至服务器内存会导致系统内存突发暴涨,甚至引发宿主机 OOM 导致进程被强行杀死。此时必须采用分块迭代的流式响应。
3.1 读取大文件的异步分块迭代
借助 aiofiles 库,我们可以编写一个异步生成器,每次仅从磁盘读取固定大小(如 64KB)的数据块并输出:
from pathlib import Path
from fastapi import FastAPI, HTTPException
from fastapi.responses import StreamingResponse
import aiofiles

app = FastAPI()
MEDIA_ROOT = Path("/data/media").resolve()

async def chunk_generator(file_path: Path, chunk_size: int = 65536):
    async with aiofiles.open(file_path, mode="rb") as f:
        while chunk := await f.read(chunk_size):
            yield chunk

@app.get("/api/v1/download-large/{filename}")
async def download_large_file(filename: str):
    target_path = (MEDIA_ROOT / filename).resolve()
    if not target_path.is_relative_to(MEDIA_ROOT) or not target_path.is_file():
        raise HTTPException(status_code=404, detail="文件不存在")

    file_size = target_path.stat().st_size
    headers = {
        "Content-Disposition": f'attachment; filename="{filename}"',
        "Content-Length": str(file_size)
    }

    return StreamingResponse(
        content=chunk_generator(target_path),
        media_type="application/octet-stream",
        headers=headers
)技术要点:在 StreamingResponse 中手动添加 Content-Length 标头可以让客户端和浏览器的下载管理器准确显示下载进度百分比和剩余时间。如果省略该标头,响应将进入纯分块编码(Chunked Transfer),浏览器端只能显示已下载字节数,无法预估总体进度。
3.2 内存中动态导出数据流
在数据报表导出场景中,很多时候文件由数据处理库(如 Pandas、openpyxl 或 csv 模块)在内存中生成。此时可以直接使用 io.BytesIO 作为流对象,而无需先将其保存到服务器临时磁盘,从而节约宝贵的磁盘 I/O 资源:
import io
import csv
from fastapi import FastAPI
from fastapi.responses import StreamingResponse

app = FastAPI()

def generate_csv_stream():
    output = io.StringIO()
    writer = csv.writer(output)
    writer.writerow(["用户ID", "姓名", "注册时间", "账户状态"])
    yield output.getvalue().encode("utf-8-sig")
    output.seek(0)
    output.truncate(0)

    # 模拟从数据库分页查询并持续推送
    for batch_id in range(100):
        records = [
            [f"U{batch_id * 10 + i}", f"用户_{i}", "2026-09-30", "正常"]
            for i in range(10)
        ]
        for row in records:
            writer.writerow(row)
        yield output.getvalue().encode("utf-8-sig")
        output.seek(0)
        output.truncate(0)

@app.get("/api/v1/export/users.csv")
async def export_users():
    headers = {
        "Content-Disposition": 'attachment; filename="users.csv"'
    }
    return StreamingResponse(
        content=generate_csv_stream(),
        media_type="text/csv",
        headers=headers
    )
四、中文文件名编码与 RFC 5987 协议细节
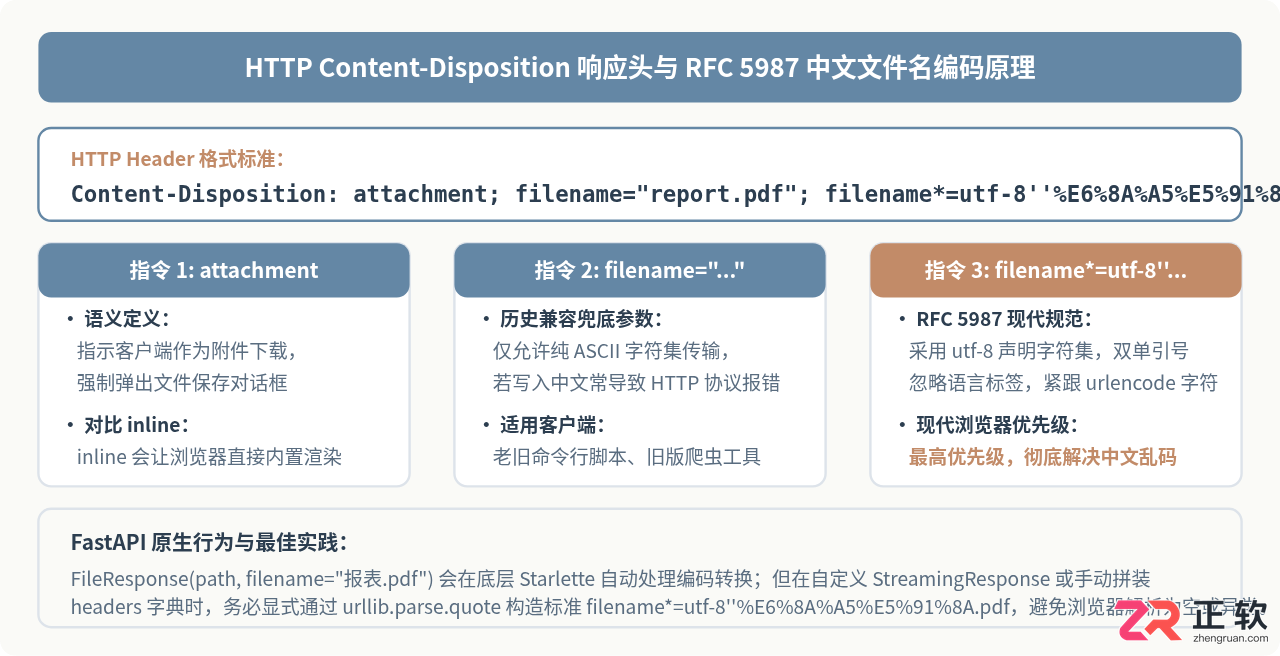
在 HTTP 协议规范(RFC 2616 / RFC 7230)中,HTTP 请求头与响应头必须严格遵循 ASCII 字符编码标准。如果直接在 Content-Disposition 的 filename 参数中填入中文字符(例如 filename="业务月度报表.xlsx"),ASGI 服务器(如 Uvicorn)在将标头编码为字节串时可能会抛出 UnicodeEncodeError,或者客户端浏览器解析到非标准字符时呈现出一串乱码。
4.1 RFC 5987 双标头编码兼容方案
为了让不同时期和类型的浏览器均能正确识别中文文件名,RFC 5987 定义了 filename* 语法规则。工业级实践通常采用“双重指定”:提供一个纯 ASCII 兜底名称给旧版爬虫或客户端,同时通过 filename*=utf-8''... 提供经过百分号编码(URL Encode)的 UTF-8 真实中文名称:
from urllib.parse import quote
from fastapi import FastAPI
from fastapi.responses import StreamingResponse

app = FastAPI()

def build_content_disposition(chinese_filename: str) -> str:
    # 对中文部分进行标准 URL 编码
    encoded_filename = quote(chinese_filename)
    # 构造同时满足基础标准与 RFC 5987 国际化标准的复合标头
    return f"attachment; filename=\"download\"; filename*=utf-8''{encoded_filename}"

@app.get("/api/v1/download-chinese")
async def download_chinese_file():
    real_name = "2026年第三季度财务审计决算报表.xlsx"
    headers = {
        "Content-Disposition": build_content_disposition(real_name)
    }
    # 演示返回空流
    return StreamingResponse(
        content=iter([b"mock data"]),
        media_type="application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
        headers=headers
    )
当现代主流浏览器(Chrome、Firefox、Safari、Edge 等)接收到该响应时,会自动检测并优先采纳 filename* 中的参数,将其按照 UTF-8 规则进行解码还原,从而保证用户下载弹窗中显示的是准确无误的中文名称。
五、后台任务清理与生产排错全景
在实际生产系统中,很多下载需求伴随着临时文件的产生,例如先将多份文件打包成 ZIP 压缩包,或者通过外部工具将图表渲染成 PDF。如果在生成响应后立即删除临时文件,FileResponse 或 StreamingResponse 将无法完成向客户端的数据读取;如果完全不清理,频繁的导出任务很快就会将宿主机磁盘耗尽。
5.1 借助 BackgroundTasks 实现传输后自动清理
FastAPI 内置的 BackgroundTasks 允许我们在 HTTP 响应成功发送完毕之后,由后台异步触发清理函数:
import os
from pathlib import Path
from fastapi import FastAPI, BackgroundTasks, HTTPException
from fastapi.responses import FileResponse

app = FastAPI()

def cleanup_file(file_path: Path):
    # 安全回收临时文件的后台回调任务
    try:
        if file_path.exists() and file_path.is_file():
            file_path.unlink()
    except OSError:
        pass  # 记录日志,避免后台清理异常影响主流程

@app.get("/api/v1/download-archive")
async def download_archive(background_tasks: BackgroundTasks):
    temp_zip = Path("/tmp/export_session_957c.zip")

    # 模拟生成归档压缩包
    temp_zip.write_bytes(b"PK...archive mock payload...")

    # 注册响应发送完毕后的清理任务
    background_tasks.add_task(cleanup_file, temp_zip)

    return FileResponse(
        path=temp_zip,
        filename="系统运行归档.zip",
        media_type="application/zip",
        background=background_tasks
    )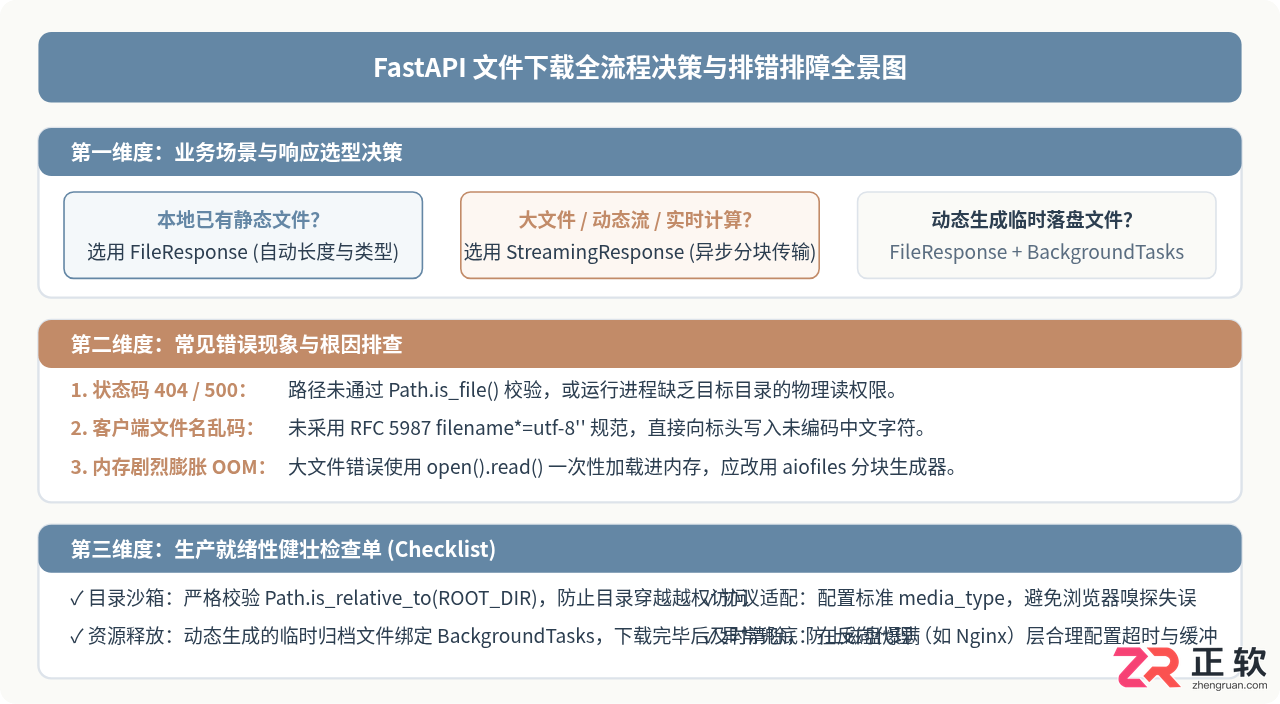
5.2 核心排查与生产保障对照
| 异常现象 / 关键指标 | 深层诱发原因 | 标准修复与防御手段 |
|---|---|---|
| HTTP 404 Not Found | 请求文件名在存储目录不存在,或未通过绝对路径沙箱校验 | 在代码中加入 target.is_file() 检查,并使用 is_relative_to 防范目录穿越 |
| 文件名保存乱码 | 未按照 RFC 5987 格式组装 filename* 标头,直接发送生编码字符串 |
使用 urllib.parse.quote 编码,构造标准的 filename*=utf-8''... 格式 |
| 内存暴涨与 OOM | 大文件读取时采用同步全量加载(如 f.read() 一次性装载几百 MB) |
切换至 StreamingResponse,使用 64KB/128KB 固定缓冲区按块分段推流 |
| BrokenPipeError 异常日志 | 客户端在未接收完整文件前主动取消下载或网络连接中断 | 在分块生成器中捕获 asyncio.CancelledError 并安全释放文件流指针 |
| 服务器磁盘空间耗尽 | 动态导出的临时压缩包或报表在回传后未被及时销毁 | 在 FileResponse 或路由中挂载 BackgroundTasks 注册删除清理钩子 |
综上所述,构建健壮的 FastAPI 文件下载接口,不仅要合理选择 FileResponse 与 StreamingResponse 以匹配不同的文件来源和体积特征,还要在安全沙箱、编码标准、网络分块与生命周期回收四个维度做好工程规范,以确保服务在高并发与海量数据场景下的高可靠运行。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。
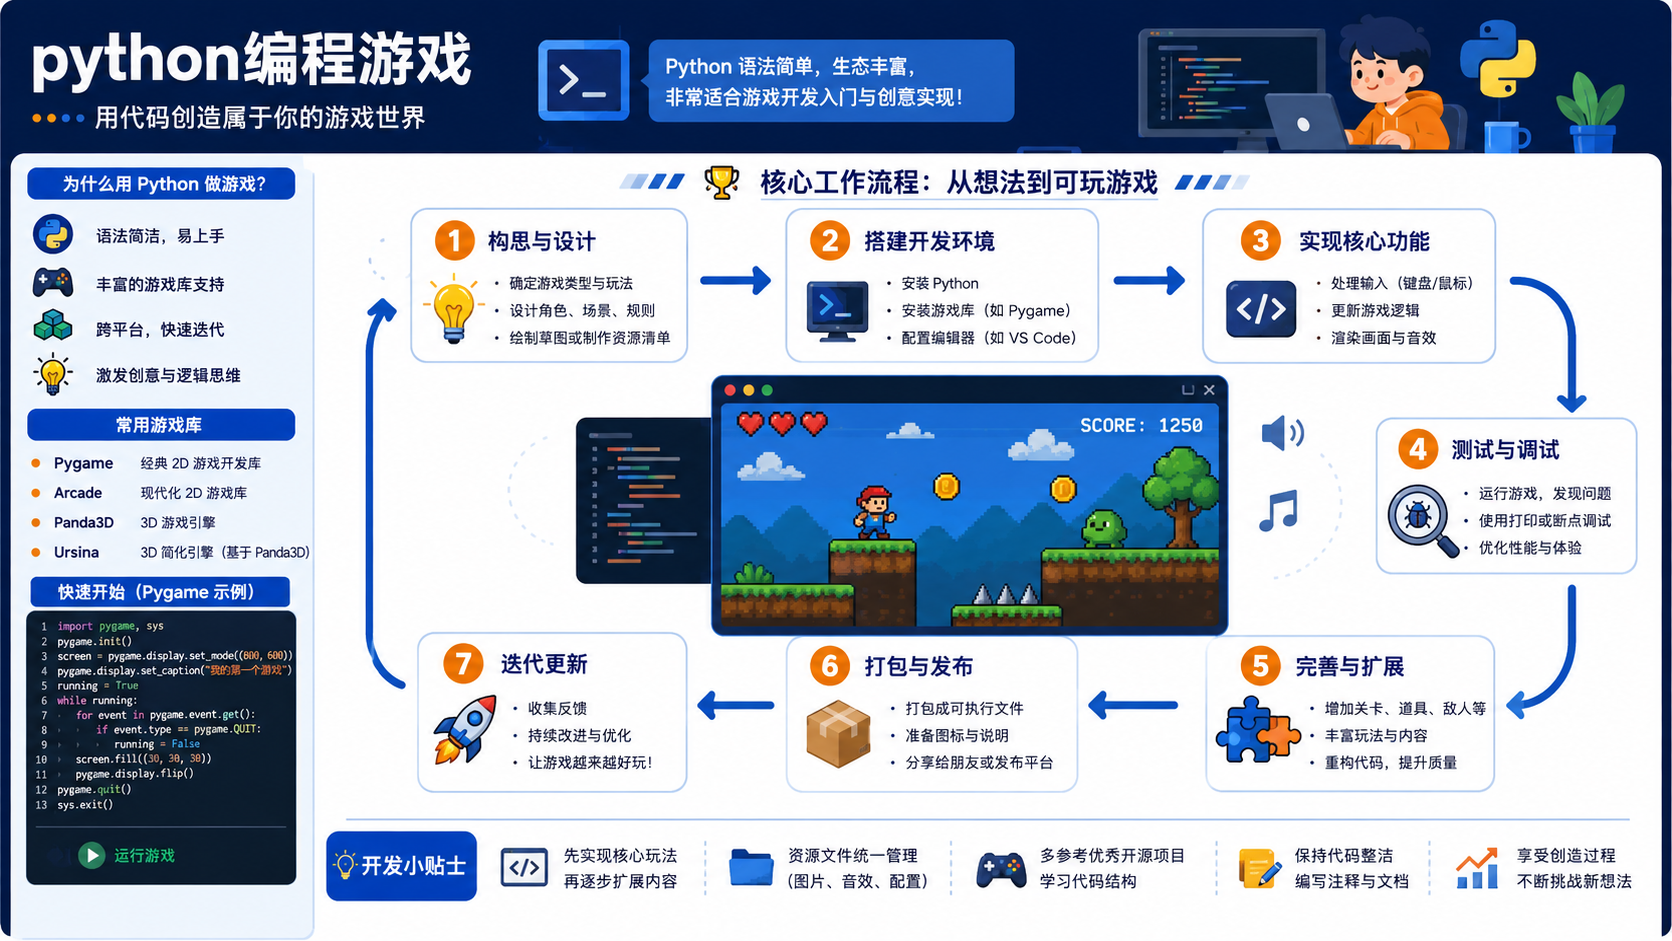
解析 python编程游戏 的核心开发流程,提供基于官方文档的环境准备、依赖安装命令及验证方法,包含清晰的决策图与排错路径,适用于具备基础命令行能力的后端开发者。
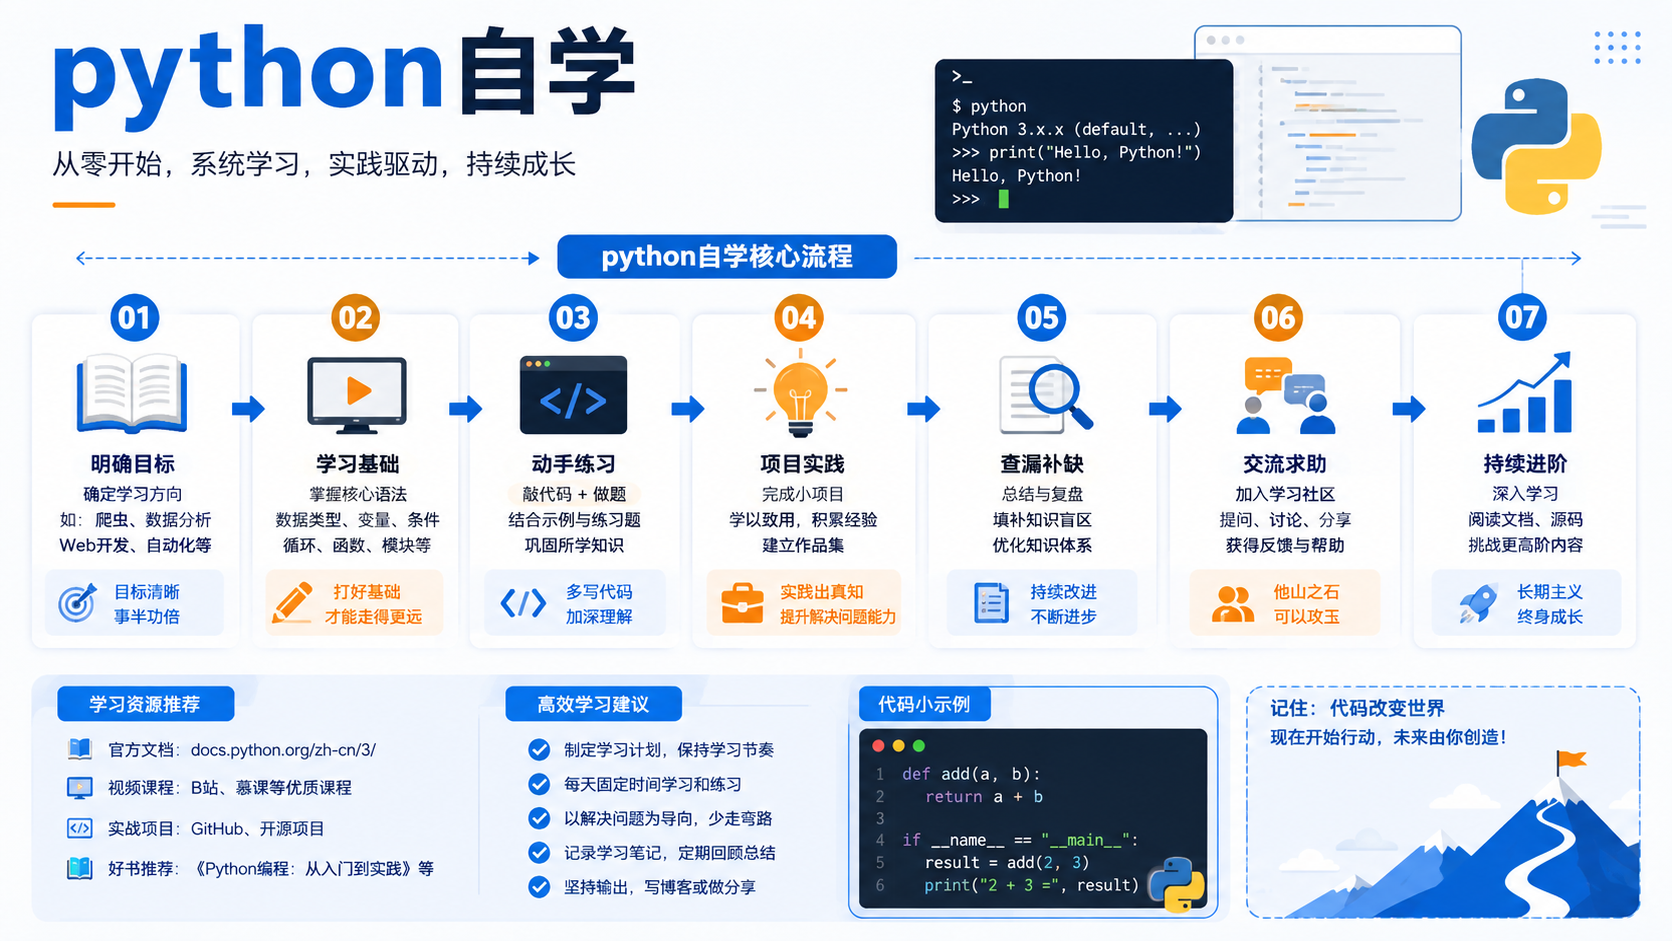
面向后端开发者的 python自学实操指南。涵盖 Python 官方概念界定、虚拟环境创建、依赖安装验证及常见排错路径,提供可执行的 Bash 命令与决策流程图。
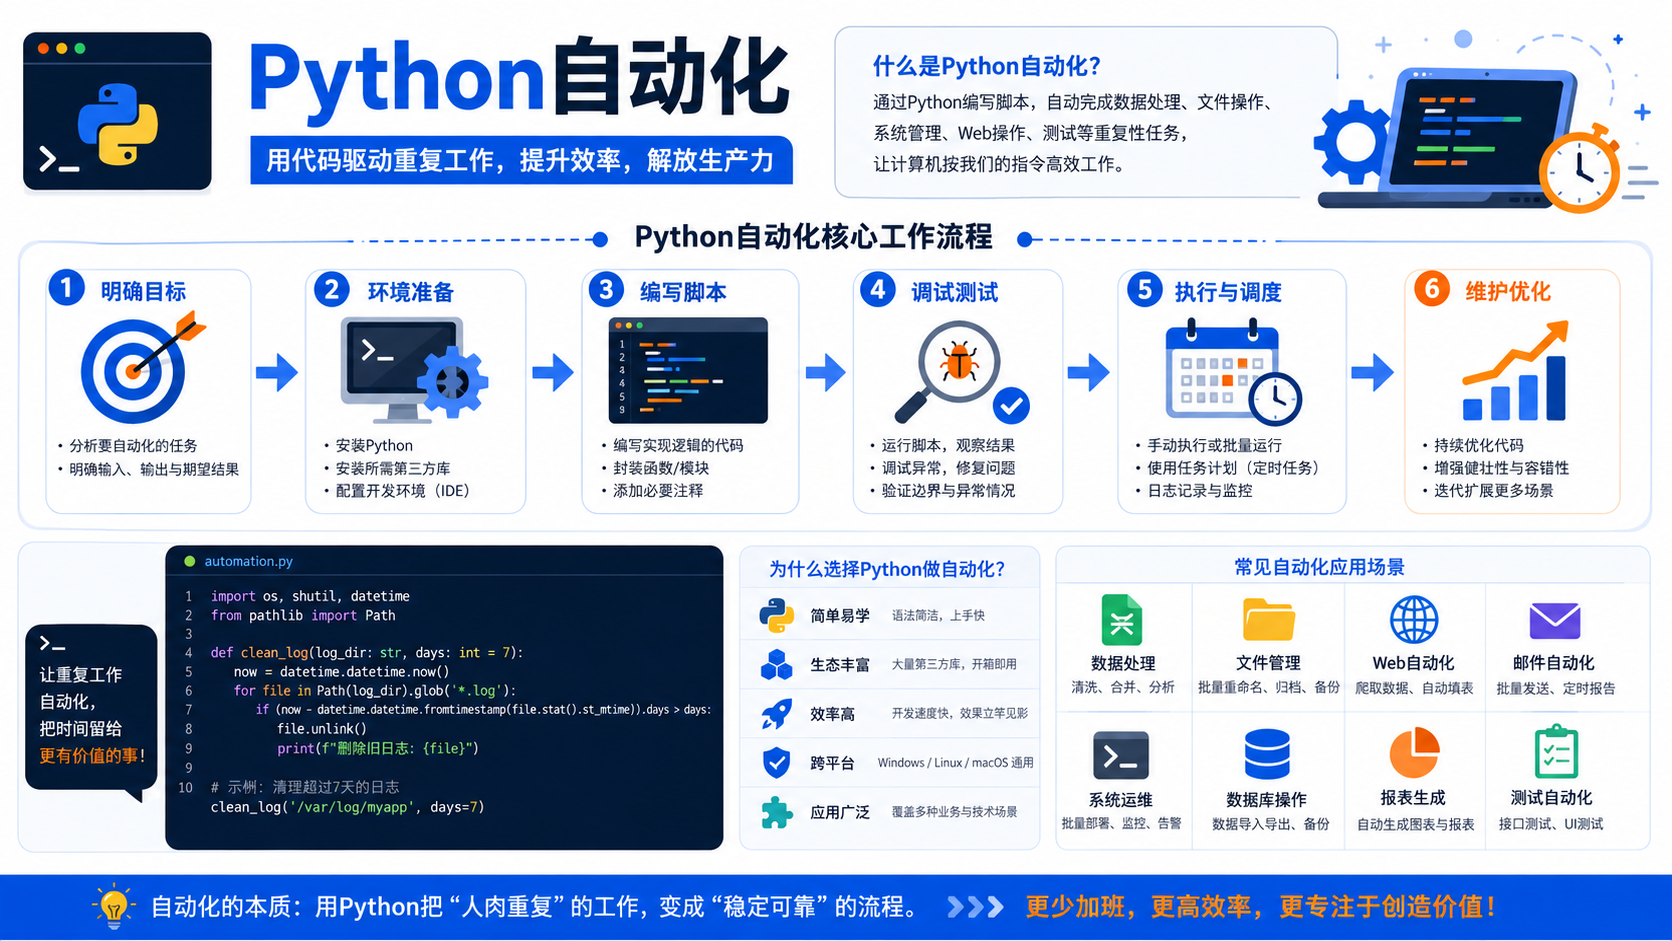
针对后端开发者的 python自动化 入门指南,涵盖 venv 虚拟环境创建、pip 依赖管理及官方文档依据的验证步骤,提供清晰的决策图与排错建议。
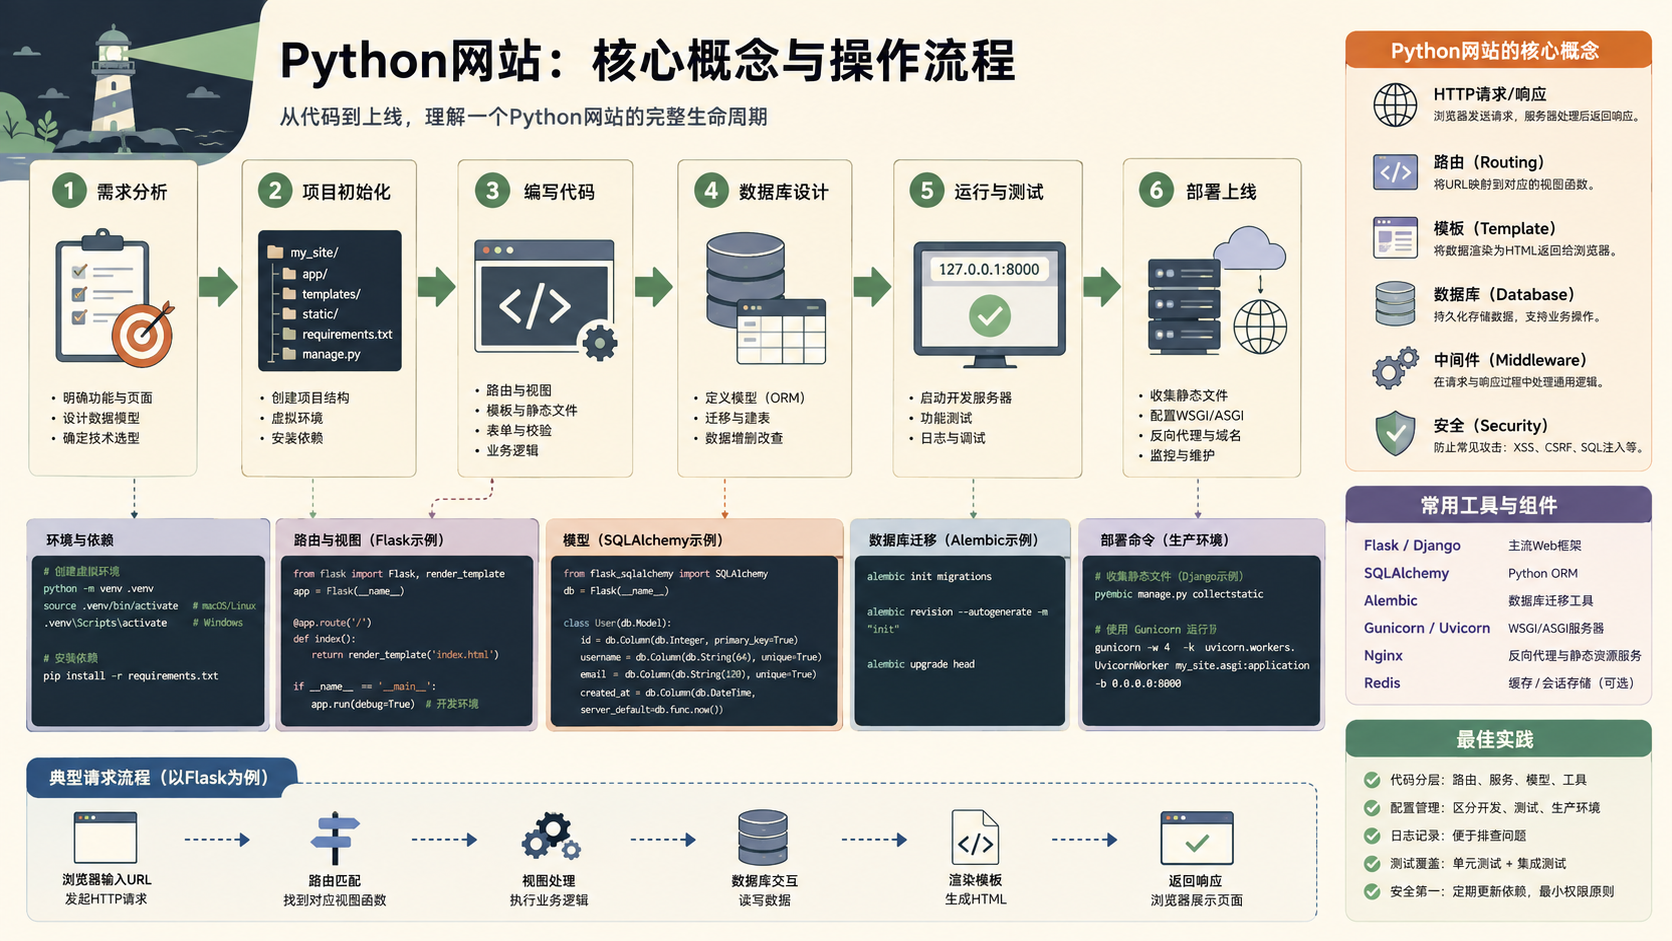
面向后端开发者的 python文档 实操指南。涵盖环境检查、venv创建、pip升级及依赖验证,提供清晰的决策图与命令示例,避免常见配置错误。
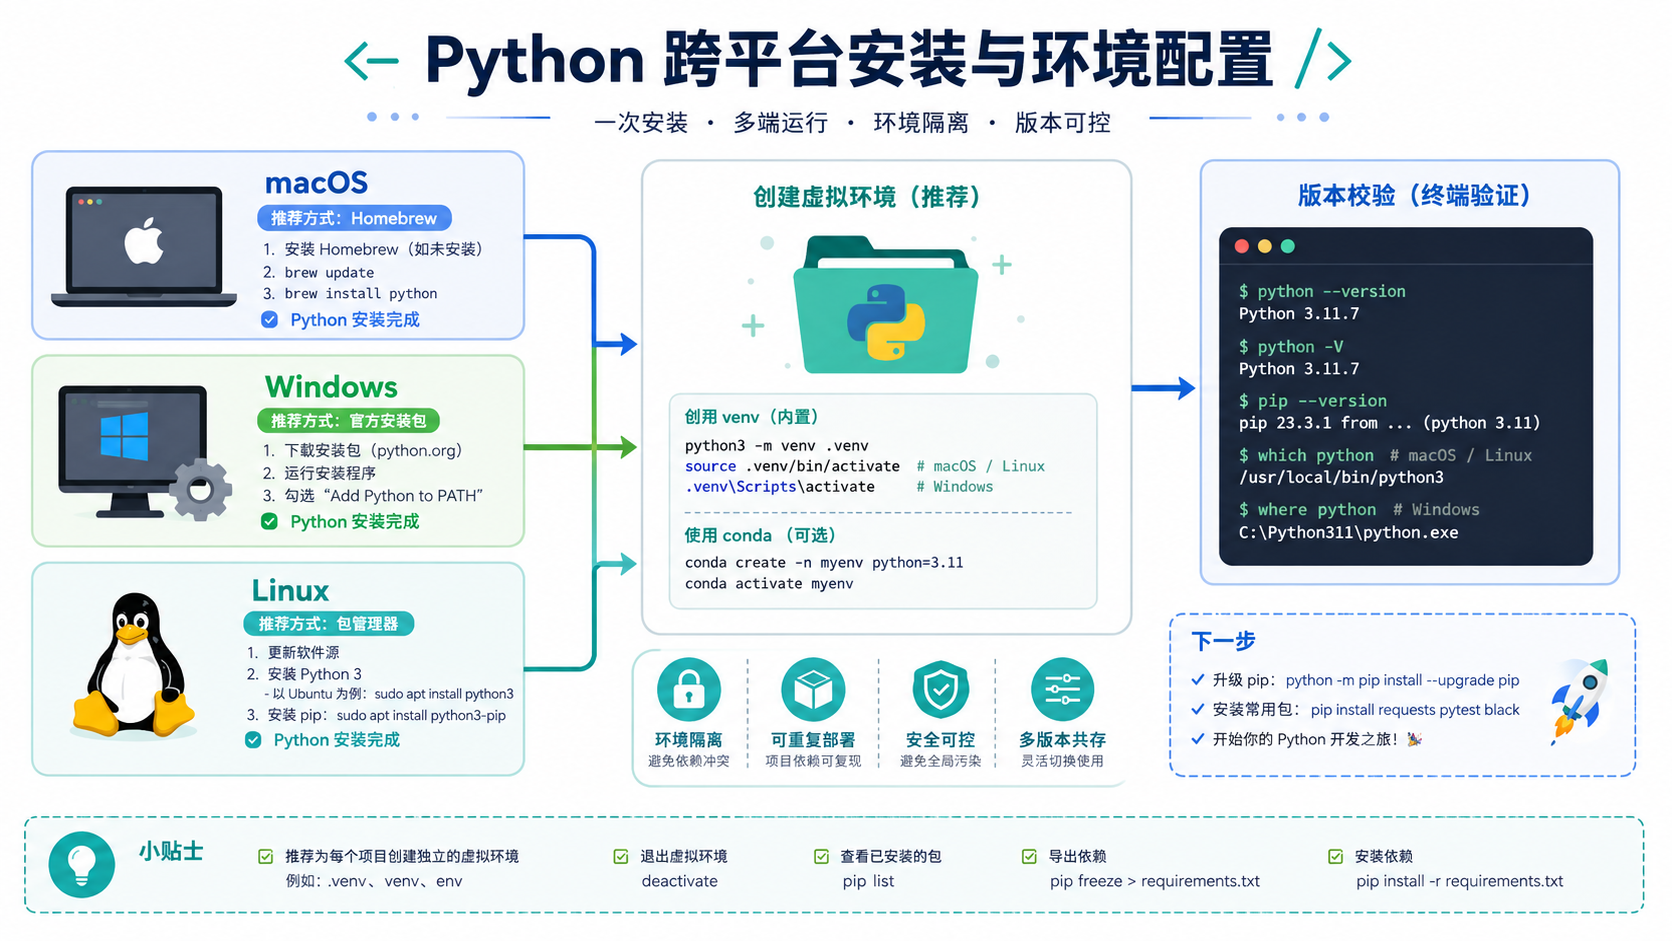
面向后端开发者的 python循环 实操指南。涵盖环境检查、虚拟环境创建、依赖安装及验证步骤,结合官方文档与决策图,确保操作可复现且边界清晰。
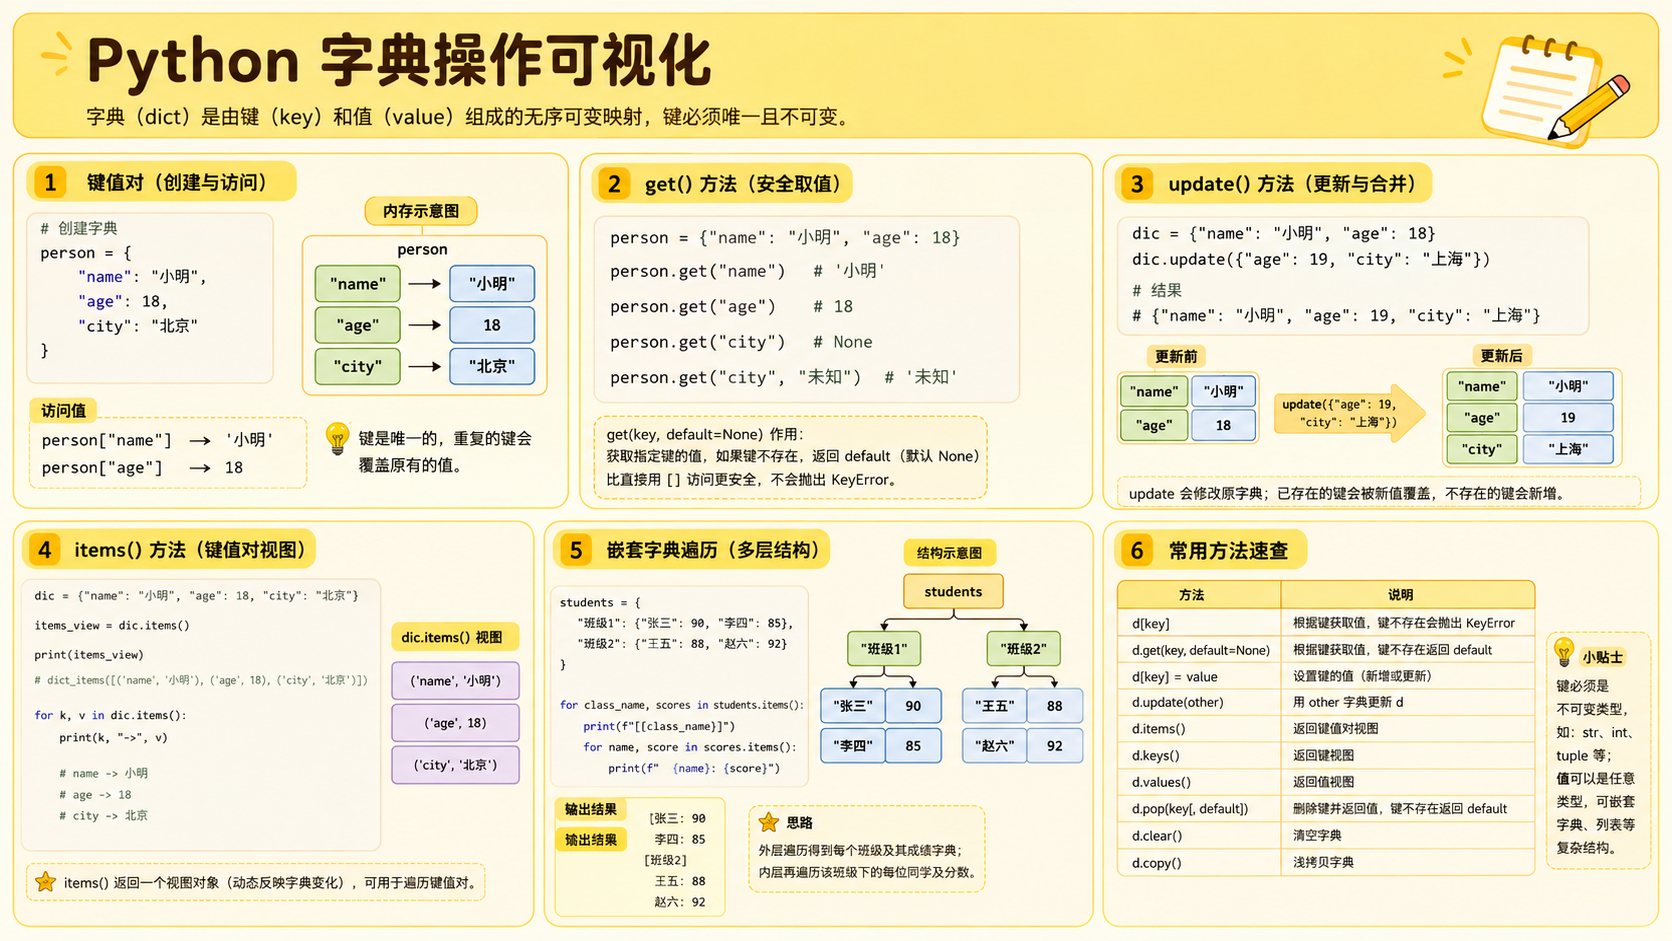
详解 Python 字典的键值访问、遍历与嵌套结构,并提供基于官方文档的 Python 环境搭建、虚拟环境隔离及依赖管理步骤,帮助开发者建立可复现的开发工作流。
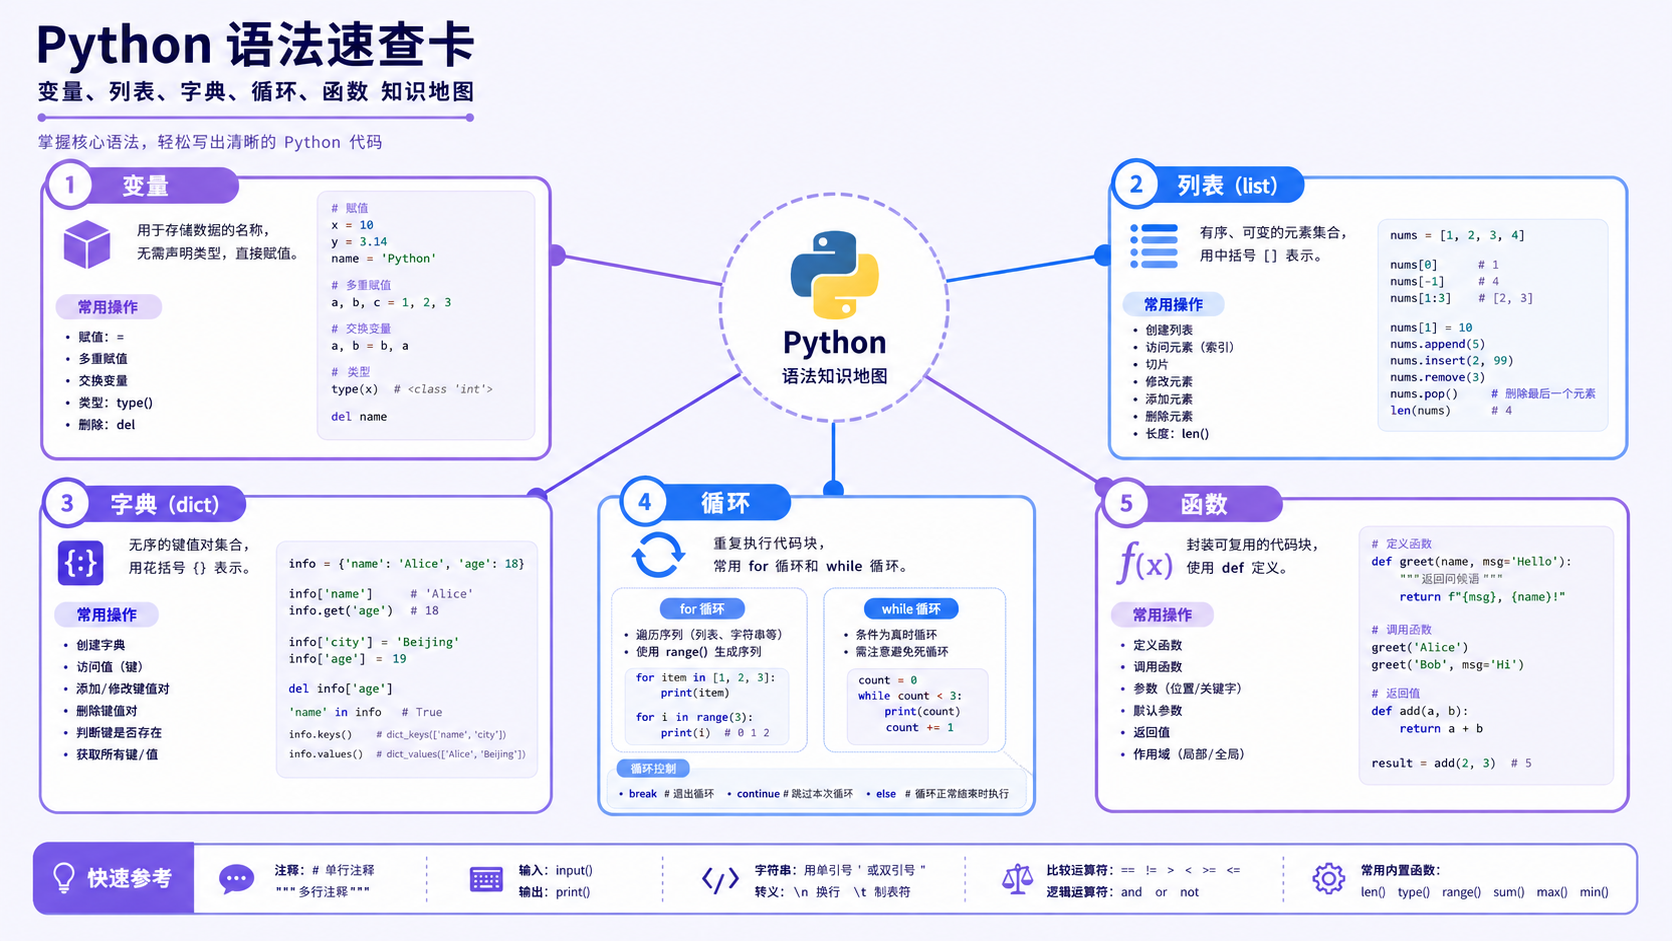
针对后端开发者,详解 Python 编程基础的环境搭建、依赖隔离与验证方法。基于官方文档提供可复现命令,明确工具边界,帮助读者建立最小可测试代码闭环。
这篇 Python 教程通过一个真实可运行的日志清洗工具,讲解自定义异常、异常链、生成器、Counter、严格模式和退出状态。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



