

SQL数据去重与空值处理:DISTINCT及NULL值判断技巧
深入解析SQL中DISTINCT去重原理与多列组合行为,剖析NULL值的三值逻辑、IS NULL判断技巧以及COALESCE等空值处理函数,避免查询踩坑。
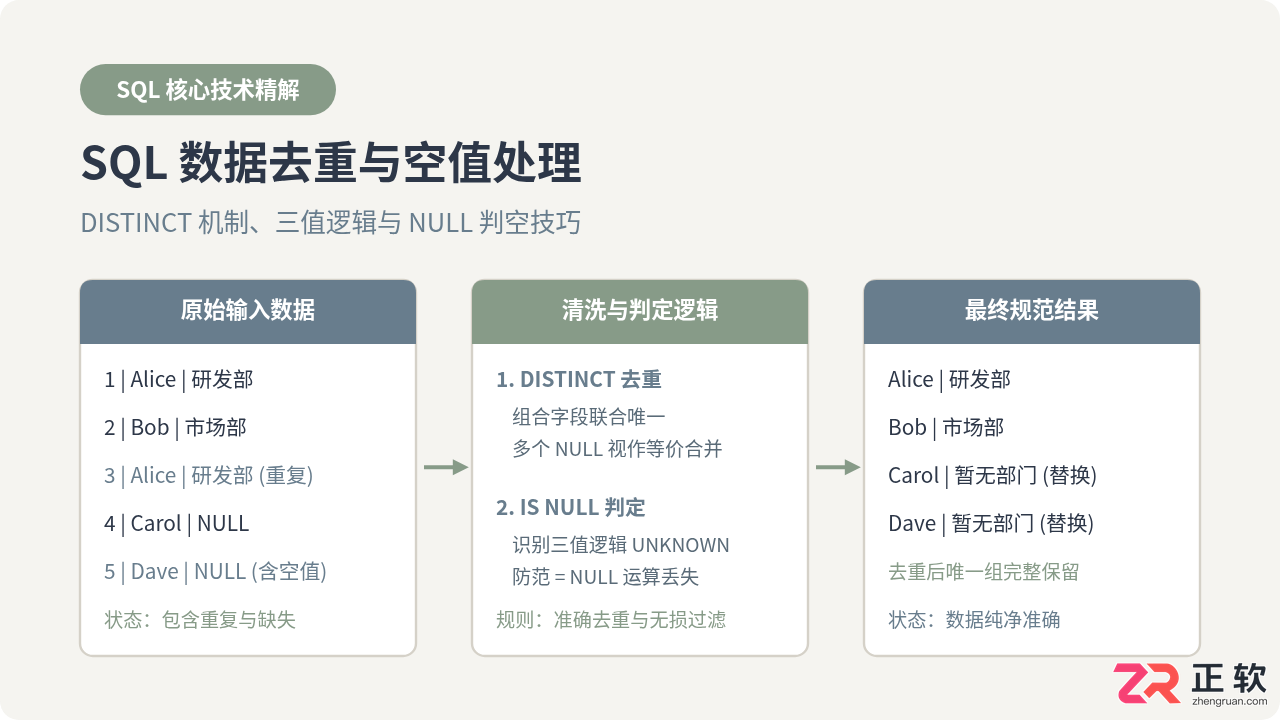
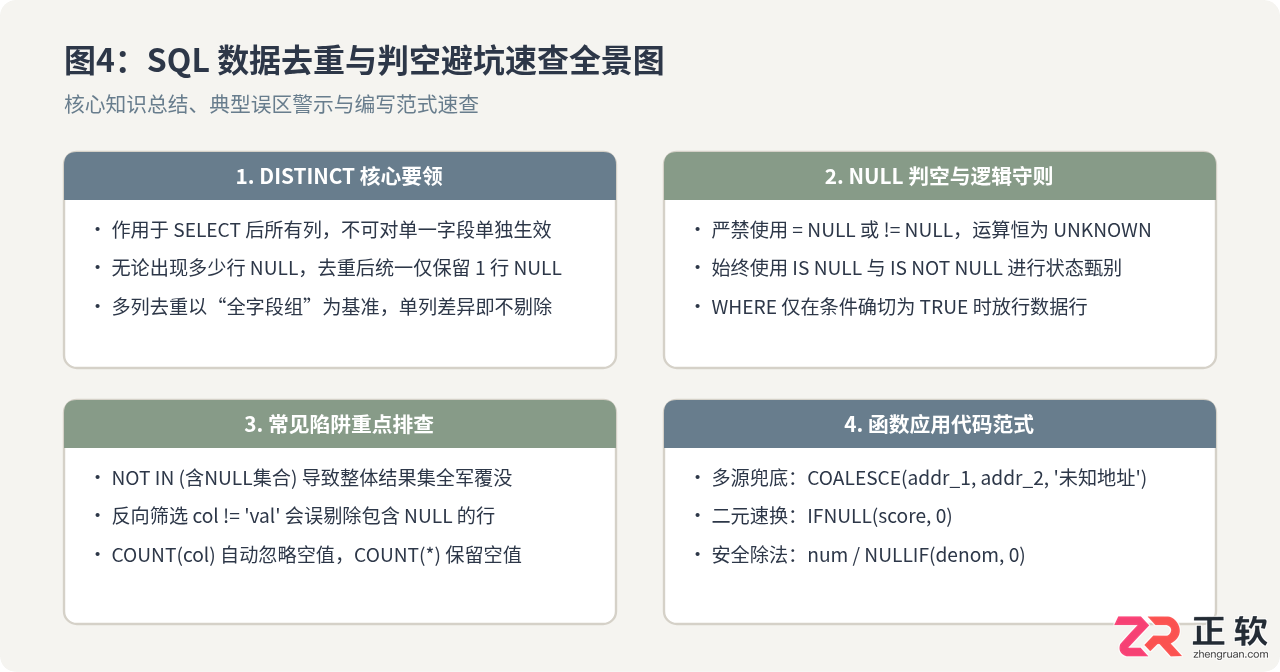
在 SQL 日常查询与数据清洗任务中,数据重复和空值(NULL)缺失是最基础也是最容易产生误判的两个环节。解决数据重复的核心在于理解 DISTINCT 作用于全行投影列而非单列的特性,以及多个 NULL 在去重时的等价折叠规则;而正确处理空值的关键在于掌握 SQL 独特的三值逻辑,彻底放弃用普通等于符号(=)判断空值的做法,改用 IS NULL、IS NOT NULL 以及 COALESCE 等专业处理函数。本文将结合实际场景与具体示例,系统讲解两者的运行原理与实战规避方案。
一、DISTINCT 关键字的去重原理与多列组合行为
DISTINCT 关键字用于从查询结果集中移除重复行。初学者常常产生一种误解,认为可以为某个特定的单列施加 DISTINCT,例如写成 SELECT col1, DISTINCT col2 FROM table。在 SQL 语法规范中,这是不合法的。DISTINCT 是一个修饰整个 SELECT 语句的修饰符,无论它后面紧跟一个字段还是多个字段,它都会对随后投影的所有列进行“联合唯一性”评估。
1. 单列去重与多列组合去重的差异
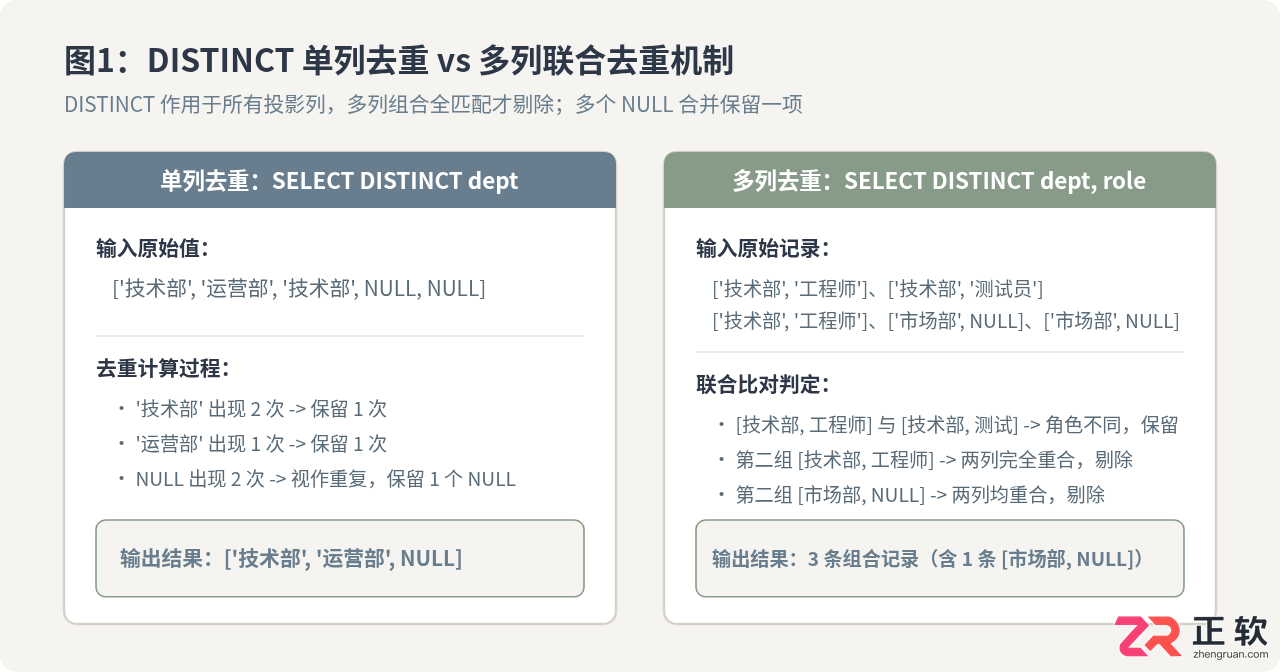
在单列去重时,只要该列的值相同,重复的记录就会被剔除只保留一行。而在多列查询中,只有当多个字段的值完全相同时,该记录才会被认定为重复行。如果其中某一列相同但另一列不同,SQL 会将它们判定为两条独立的数据行完整输出。
-- 示例 1:单列去重(提取公司现有所有部门)
SELECT DISTINCT department
FROM employees;

-- 示例 2:多列联合去重(提取现有部门及其岗位的组合)
SELECT DISTINCT department, job_title
FROM employees;
在示例 2 中,如果存在两条记录分别为“技术部、后端工程师”和“技术部、前端工程师”,即使两行的 department 均为“技术部”,由于 job_title 存在差异,两条记录都会被完整保留。
2. DISTINCT 对 NULL 值的去重逻辑
在很多 SQL 运算中,NULL 与 NULL 之间无法比较相等性。但在 DISTINCT 处理机制中,标准 SQL 明确规定:所有的 NULL 值在去重时被视为等价的同一组值。这意味着无论原始数据表中存在多少行该字段为 NULL 的记录,使用 DISTINCT 去重后,最终结果集里只会保留一行 NULL。
二、SQL 中的 NULL 特殊性与三值逻辑
在关系型数据库中,NULL 既不代表数字 0,也不代表空字符串 '',它的真实含义是“缺失的未知值(Unknown or Missing Data)”。因为未知,所以两个未知的值之间无法得出“相等”或“不相等”的确切结论。
1. 为什么 col = NULL 总是查不出结果?
这是 SQL 编写中最常见的错误之一。在普通编程语言中,我们经常使用 if (x == null) 来做空引用检查。但在 SQL 中,关系运算基于三值逻辑(Three-Valued Logic),运算结果不仅包含 TRUE(真)和 FALSE(假),还包含 UNKNOWN(未知)。
当执行以下运算时:
'Alice' = NULL计算结果为 UNKNOWN;NULL = NULL计算结果也是 UNKNOWN;col != NULL计算结果同样为 UNKNOWN。
在 SQL 的 WHERE 子句中,数据库规定只有判断结果为确切的 TRUE 时,该数据行才会被返回给用户。如果表达式求值结果为 FALSE 或 UNKNOWN,数据行都会被直接过滤掉。因此,书写 WHERE col = NULL 或 WHERE col != NULL 永远不会返回任何数据行。
2. 正确的判空语法:IS NULL 与 IS NOT NULL
为了能够准确检测数据是否为空,SQL 提供了专用的谓词 IS NULL 和 IS NOT NULL。这两个谓词执行的是“状态判断”而非“值比较”,它们的返回值只有二元确切值(TRUE 或 FALSE),永远不会返回 UNKNOWN。
-- 错误写法(永远返回空集):
SELECT * FROM orders WHERE ship_date = NULL;

-- 正确规范写法:
SELECT * FROM orders WHERE ship_date IS NULL;

-- 查找已发货订单:
SELECT * FROM orders WHERE ship_date IS NOT NULL;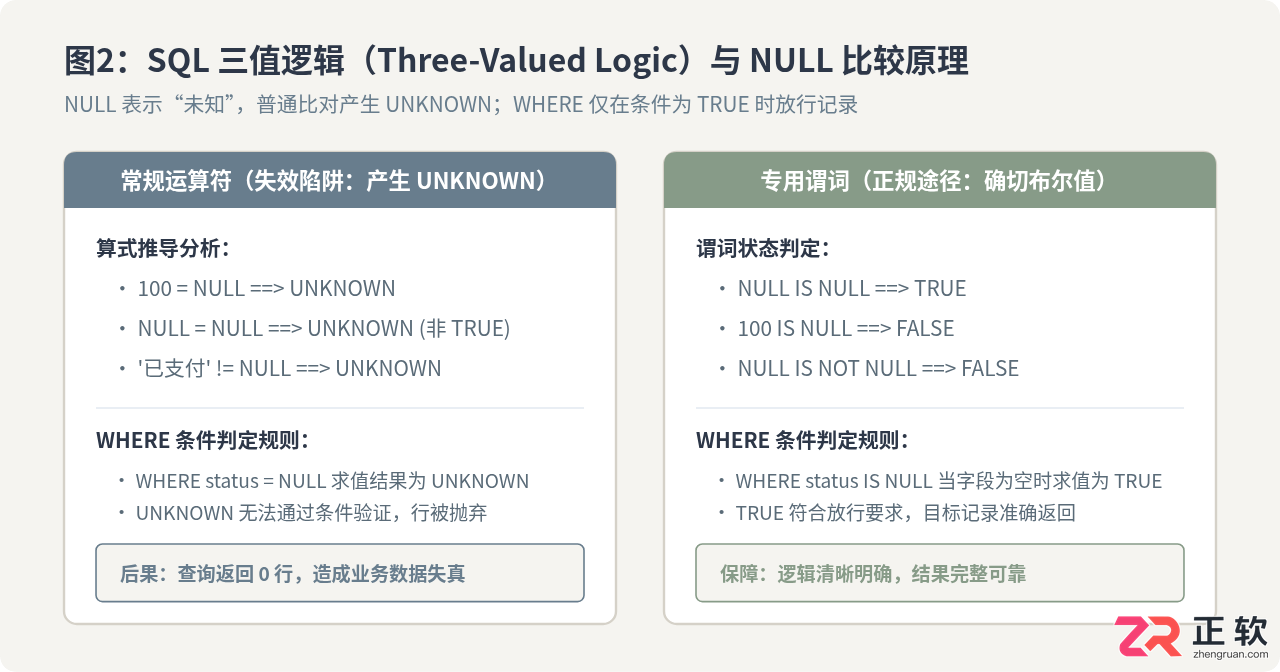
三、极易踩坑的 NULL 场景对比与规避技巧
由于三值逻辑的存在,在涉及反向筛选、子查询以及聚合函数时,NULL 值常常会产生意料之外的隐蔽错误。了解这些差异可以帮助我们在写 SQL 时主动防范漏洞。
1. 反向条件筛选丢失 NULL 记录
假设我们希望查询“状态不是已注销(inactive)的所有用户”。直觉上很多开发者会写成:
SELECT * FROM users WHERE status != 'inactive';然而,如果数据库中有部分新注册用户的 status 字段尚未填写、处于 NULL 状态,这部分用户完全不会出现在查询结果中。原因正如前文所述:NULL != 'inactive' 的计算结果为 UNKNOWN,该记录被条件抛弃。如果业务希望保留空值记录,必须显式补全条件:
SELECT * FROM users
WHERE status != 'inactive' OR status IS NULL;
2. NOT IN 子查询中包含 NULL 导致“全盘皆空”
当使用 NOT IN 操作符时,如果右侧列表或子查询的结果集中存在哪怕一个 NULL 值,整个 NOT IN 表达式对于所有记录的计算结果都会变成 UNKNOWN 或 FALSE,导致整个主查询返回 0 行结果。
val NOT IN (1, 2, NULL) 等价于展开为 val != 1 AND val != 2 AND val != NULL。根据三值逻辑,由于最后一项恒为 UNKNOWN,在 AND 运算下,任何条件与 UNKNOWN 相与都不可能得到 TRUE。
避坑方案:在子查询中始终排除 NULL,或者改用语义更清晰、不易出错的 NOT EXISTS:
-- 方案 A:在子查询中主动过滤 NULL
SELECT * FROM customers
WHERE customer_id NOT IN (
    SELECT customer_id FROM orders WHERE customer_id IS NOT NULL
);

-- 方案 B:使用 NOT EXISTS 替代(推荐)
SELECT c.* FROM customers c
WHERE NOT EXISTS (
    SELECT 1 FROM orders o WHERE o.customer_id = c.customer_id
);
3. 聚合函数对 NULL 值的忽略行为
在统计分析中,聚合函数(如 COUNT、AVG、SUM)对于 NULL 的处理方式与行计数存在明显差异:
| 统计表达式 | 对 NULL 的处理规则 | 典型影响与注意点 |
|---|---|---|
COUNT(*) |
计入全部行,无论字段是否为空 | 常用于统计表的总物理数据行数。 |
COUNT(column_name) |
自动忽略 NULL,只统计非空行 | 统计字段填充率或有效打卡次数时常用。 |
AVG(column_name) |
分母自动排除 NULL | 计算平均值时分母只算非空行;若需将 NULL 视为 0 计入分母,需用 COALESCE 转换。 |
SUM(column_name) |
忽略 NULL,但全表全为 NULL 时返回 NULL | 若希望全表无数据时返回 0,建议外层包裹 COALESCE(SUM(val), 0)。 |
四、常用空值处理函数及选择指南
在实际业务呈现与报表统计中,直接展示 NULL 既不友好也容易导致前端渲染异常。SQL 提供了几个核心函数,用于在查询过程中平滑替换或转换空值。
1. COALESCE:最稳健的多参数级联备选函数
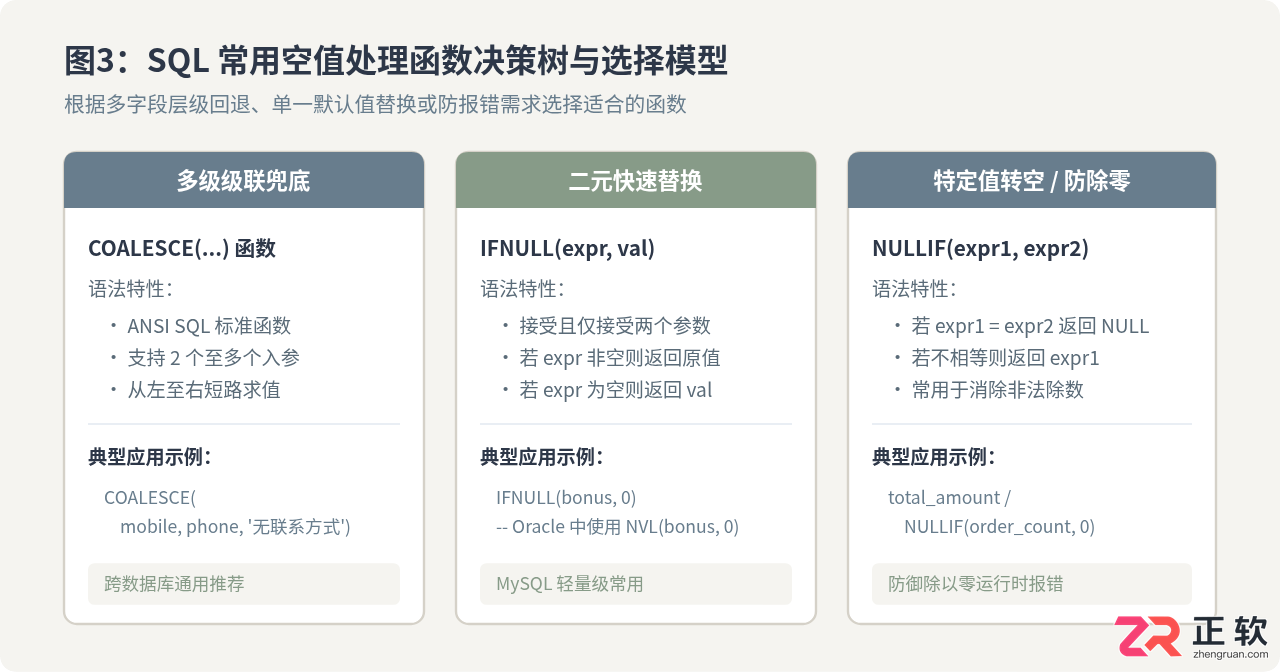
COALESCE(val1, val2, ..., valN) 是 ANSI SQL 标准函数,兼容绝大多数数据库(MySQL、PostgreSQL、SQL Server、Oracle、SQLite 等)。它接收一个参数列表,并从左向右依次检查,返回第一个不为 NULL 的参数值。如果所有参数全为 NULL,则返回 NULL。
-- 场景:用户可能有手机号、备用座机,若都未填则显示“无联系方式”
SELECT
    username,
    COALESCE(mobile_phone, landline_phone, '无联系方式') AS contact
FROM users;
2. NULLIF:防范“除以零”错误的神奇搭配
在报表统计中,除法运算非常普遍(例如计算客单价 total_sales / order_count)。如果 order_count 为 0,很多数据库会直接抛出致命错误(Division by zero)中断查询。利用 NULLIF(order_count, 0),当订单数为 0 时将其转换为 NULL,而在 SQL 中任何数值除以 NULL 都会平稳返回 NULL,不会抛出异常:
-- 安全的客单价计算:
SELECT
    dept_id,
    total_sales / NULLIF(order_count, 0) AS avg_order_price
FROM daily_summary;
五、DISTINCT 与 GROUP BY 的选择与性能对比
在很多纯粹去重的查询场景中,DISTINCT 和 GROUP BY 往往能输出完全一致的结果:
-- 写法 A:使用 DISTINCT 去重
SELECT DISTINCT category FROM products;

-- 写法 B:使用 GROUP BY 去重
SELECT category FROM products GROUP BY category;
在底层执行计划层面,现代数据库优化器在处理这两种简单查询时,通常都会采用哈希聚合(Hash Aggregate)或流式排序聚合(Stream Aggregate),其执行开销基本没有实质差异。但在选择使用哪一种写法时,有明确的权衡考量:
- 语义清晰度:如果查询目标纯粹是为了消除结果集中的重复记录,使用
DISTINCT语义最为直观,代码紧凑,没有多余的聚合歧义; - 可扩展性:如果后续需要附加聚合指标(如求各分类的平均价格
AVG(price))或需要使用HAVING子句进行过滤,则必须使用GROUP BY; - 索引利用:在有合适复合索引(如
category, status)的情况下,GROUP BY往往能更好地借由松散索引扫描(Loose Index Scan)完成高效去重,避免全量数据排序。
六、总结
编写高质量 SQL 的基石在于对数据状态有精确的掌控。通过掌握 DISTINCT 针对多列的联合判定机制,我们能够准确规避数据膨胀或错误剪裁;而通过理解 SQL 的三值逻辑本质,严格使用 IS NULL、IS NOT NULL 以及 COALESCE 处理空值,能够从根本上消除反向筛选漏数、子查询空集穿透以及除零崩溃等隐蔽缺陷,构建出稳健可靠的数据检索逻辑。
掌握SQL增删改核心规范:INSERT必须指定列清单以防结构变更错误;UPDATE和DELETE执行前务必通过SELECT确认WHERE条件范围;利用事务BEGIN/ROLLBACK机制实现误操作回滚。本文结合PostgreSQL语法与跨库差异,提供从语句编写到结果验证的完整安全操作流程,帮助开发者规避生产环境数据风险。
针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
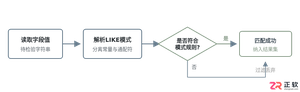
详细讲解SQL中LIKE模糊匹配的核心通配符使用规则、转义字符处理、与精确匹配的差异,以及索引失效场景与优化注意事项。
本文以PostgreSQL语法为主,讲解SQL基础SELECT查询与多表JOIN连接。通过users和orders表实例,演示WHERE过滤、ORDER BY排序、LIMIT限制,重点解析INNER JOIN与LEFT JOIN的结果差异、ON与WHERE条件放置对结果的影响,以及GROUP BY统计与结果异常排查方法。适合刚接触SQL的开发者快速掌握多表查询核心逻辑。
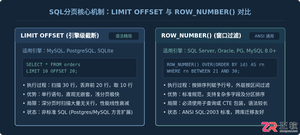
全面解析SQL分页查询的两种经典实现方案:LIMIT OFFSET语法与ROW_NUMBER()窗口函数。对比MySQL、PostgreSQL、SQL Server及Oracle的语法机制、执行流程与深分页优化实践。
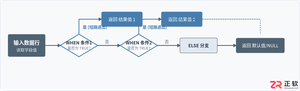
深入讲解SQL中CASE WHEN语句的工作机制、语法形式及在单维度区间离散化、多维度复合标记与条件聚合统计等数据分类场景中的具体应用与注意事项。

SQL中distinct的用法在SQL中,distinct是一个非常常用的关键字,用于查询结果中去除重复的数据。它能够保留查询结果中独一无二的记录,从而让查询结果更为简洁明了。下面将为大家详细介绍distinct的用法,并提供一些具体的代码示例。distinct的基本语法格式如下:SELECTDISTINCT列名FROM表名;在这个语法中,我们使用了
SQL中distinct用法,需要具体代码示例在SQL中,DISTINCT关键字用于去除查询结果中重复的行,只返回唯一的行。这对于需要统计不同值或者去重的情况非常有用。DISTINCT可以应用于SELECT语句中的一个或多个列。下面将详细介绍如何使用DISTINCT关键字,并提供一些具体的代码示例。基本用法使用DISTINCT关键字的基本语法如下:SELEC
SQL中distinct用法详解在SQL数据库中,我们经常会遇到需要去除重复数据的情况。此时,我们可以使用distinct关键字,它能够帮助我们去除重复数据,使得查询结果更加清晰和准确。distinct的基本使用方法非常简单,只需要在select语句中使用distinct关键字即可。例如,以下是一个普通的select语句:SELECTcolumn_name





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



