

SQL模糊匹配查询:LIKE通配符使用规则与注意事项
详细讲解SQL中LIKE模糊匹配的核心通配符使用规则、转义字符处理、与精确匹配的差异,以及索引失效场景与优化注意事项。
在SQL中进行数据检索时,精确匹配(例如 =)只能找到完全一致的文本。为了查找包含特定字符、具备固定格式或前后缀已知的数据,SQL提供了 LIKE 操作符与通配符机制。本文将讲解百分号 % 与下划线 _ 的使用规则、特殊字符的转义技巧,并通过对比与索引分析,说明在生产环境中编写高效模糊查询的注意事项。
一、LIKE模糊查询的基础原理与匹配流程
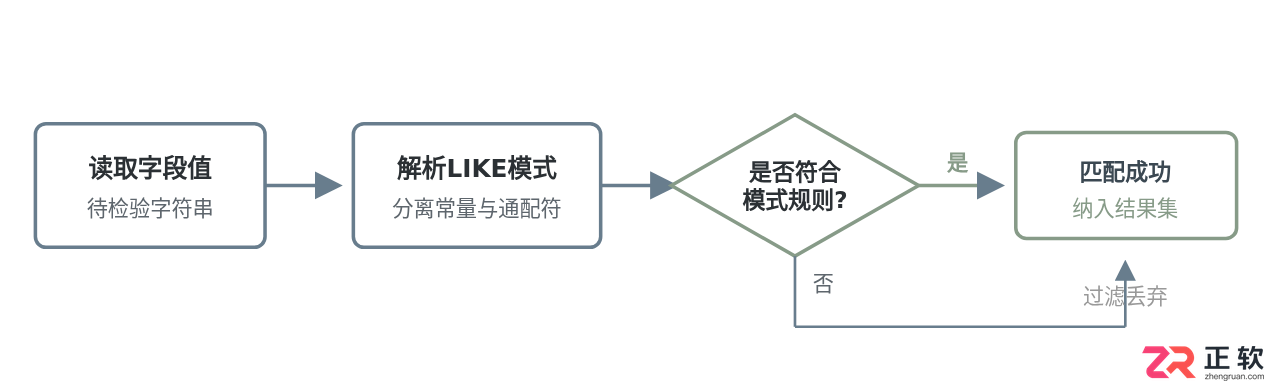
LIKE 是SQL中专用于字符串模式匹配的谓词。其工作机制是将目标字段中的文本与指定的模式字符串进行逐字符比对。如果字段中的字符序列符合通配符定义的排布规则,表达式即返回真值(TRUE),对应行被包含在查询结果集中。
为了理解查询引擎如何处理一个模式,我们可以通过匹配流程直观地看到字符比对的判定链条:
二、两大核心通配符的使用规则
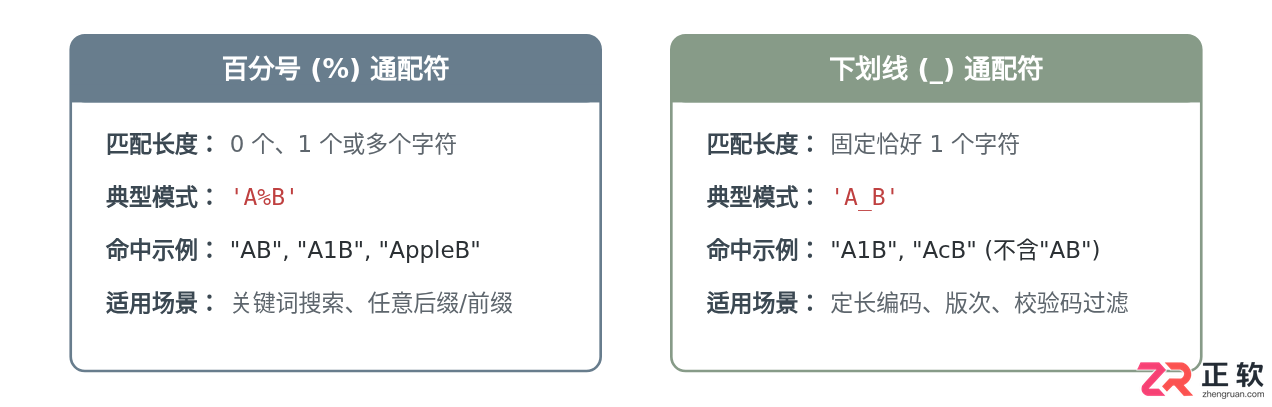
标准SQL为 LIKE 定义了两个核心通配符:百分号(%)和下划线(_)。它们在字符数量界定和位置约束上有严格区别。
1. 百分号(%):匹配任意个字符
% 代表零个、一个或多个连续的任意字符。它不对匹配的字符长度做任何限制。
- 前缀匹配(
'abc%'):匹配以 "abc" 开头的字符串,如 "abc"、"abcd"、"abc-123"。 - 后缀匹配(
'%xyz'):匹配以 "xyz" 结尾的字符串,如 "xyz"、"123xyz"。 - 包含匹配(
'%test%'):匹配任何包含 "test" 的字符串,位置不限。
2. 下划线(_):匹配恰好一个字符
_ 代表一个且仅一个任意字符。下划线所处的位置必须有字符存在,且必须完全对齐数量。两个连续的下划线 __ 则表示恰好匹配两个字符。
3. 实际语法示例
假设存在一张员工信息表 employees,包含字段 emp_name 与 phone:
-- 示例1:查询所有以 "张" 开头的员工姓名(姓张且名长度不限)
SELECT emp_name, phone
FROM employees
WHERE emp_name LIKE '张%';

-- 示例2:查询所有姓 "张" 且全名正好为两个字的员工姓名
SELECT emp_name, phone
FROM employees
WHERE emp_name LIKE '张_';

-- 示例3:查询手机号以 "138" 开头、后跟任意8位数字的记录
SELECT emp_name, phone
FROM employees
WHERE phone LIKE '138________';
三、两种查询方式的差异:精确匹配与模糊匹配
在SQL查询设计中,开发者常面临选择 = 还是 LIKE。在相同的数据集和查询目标下,两者的执行机制和设计目标存在显著差异:
| 对比维度 | 等值操作符 (=) | 模糊操作符 (LIKE) |
|---|---|---|
| 匹配机制 | 严格全值比对,要求整个字符序列完全一致。 | 逐模式解析比对,根据通配符展开动态比对。 |
| 尾部空格处理 | 在部分数据库(如MySQL默认排序规则)中可能忽略尾部空格。 | 严格计算字符本身与空格,空格也是被匹配的实体字符。 |
| 索引利用效率 | 总是可以通过B+树索引进行高效等值查找(O(log N))。 | 仅在前缀匹配(如 'abc%')时使用索引;首字符为通配符时失效。 |
| 意图与性能开销 | 用于精准查单行或明确集合,CPU计算成本低。 | 用于检索部分线索,需要逐行进行模式比较,CPU开销较高。 |
这种差异之所以重要,是因为滥用 LIKE 代替 = 会导致数据库优化器在规划执行路径时采取保守策略。如果明确已知完整字符串,应始终优先使用 =。
四、转义处理:如何匹配真正的“%”和“_”字符?
当查询的内容本身包含百分号或下划线时(例如查找折扣字符串 '20%' 或文件命名 'order_01.csv'),直接写入 LIKE '%20%%' 会导致解析混乱。
解决方式是通过 ESCAPE 关键字定义转义字符。任何跟随在转义字符后面的 % 或 _ 都会被视为普通字符。
-- 示例:查找折扣字段中包含字面量 "20%" 的商品记录
-- 使用斜杠 '/' 作为自定义转义字符
SELECT product_id, discount_label
FROM products
WHERE discount_label LIKE '%20/%%' ESCAPE '/';

-- 示例:查找订单编号以 "ORD_" 开头的单据
SELECT order_no
FROM orders
WHERE order_no LIKE 'ORD/_%' ESCAPE '/';\ 作为转义字符,但在不同数据库(如 PostgreSQL 的标准模式、SQL Server、Oracle)中,默认转义行为有所不同。显式使用 ESCAPE '/' 声明转义符是最具跨数据库移植性的安全写法。
五、LIKE 查询的索引生效与失效机制
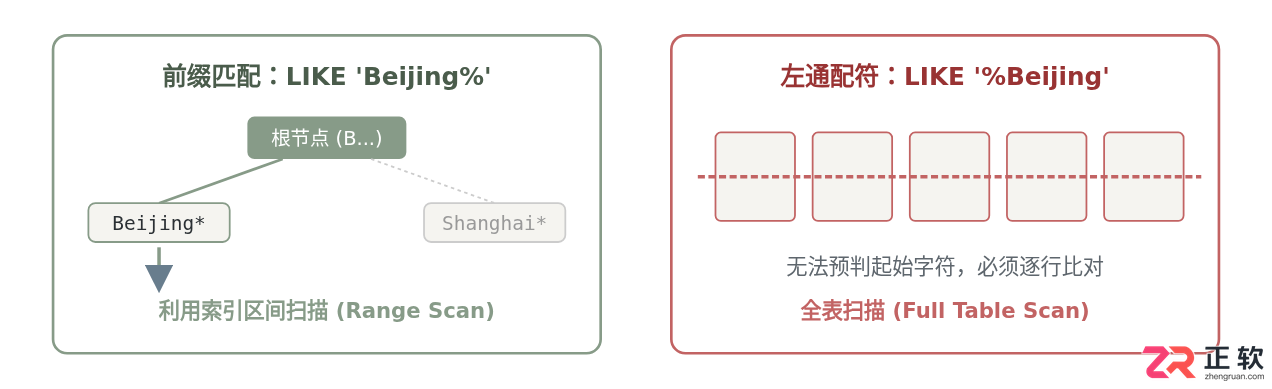
在生产环境中,使用 LIKE 最容易导致系统告警的问题就是全表扫描(Full Table Scan)。
关系型数据库大多使用 B+树 作为普通列索引的数据结构。B+树索引是按照键值的从左到右严格排序的。因此,索引查找必须依赖已知的前缀。如果模式字符串以通配符开头,B+树将无法确定起步搜索分支,只能逐页读取整张表的所有数据。
六、生产环境使用注意事项与优化清单
为了避免因为模糊匹配带来性能隐患或业务逻辑异常,在编写 SQL 语句时需要遵循以下准则:
-
谨防左侧模糊查询:形如
LIKE '%keyword'或LIKE '%keyword%'的查询会导致索引失效。当数据量达到数十万乃至数百万级别时,容易造成磁盘I/O飙升。对于高频的大文本搜索,应改用专用全文检索引擎(如 Elasticsearch)或数据库内置全文索引(如 MySQL Fulltext Index)。 -
注意 NULL 值的排他性:如果字段值为
NULL,无论是LIKE '%'还是NOT LIKE '%',其判断结果均为UNKNOWN,不会被选入结果集。若需要包含空值记录,必须显式加上OR col_name IS NULL。 -
大小写敏感性规则:
LIKE是否区分大小写取决于数据库类型及字段的排序规则(Collation)。例如,MySQL 默认的utf8mb4_general_ci(ci = Case Insensitive)不区分大小写,而 Oracle 或 PostgreSQL 默认严格区分大小写(PostgreSQL 可使用ILIKE执行不敏感查询)。 -
巧用反向索引解决后缀匹配:如果业务需求固定为匹配后缀(例如查找所有
'.org'结尾的域名),可以新增一个存储反转字符串的列并建立索引。查询时将输入条件反转为LIKE 'gro.%',从而把不可命中索引的后缀查询转换为前缀查询。
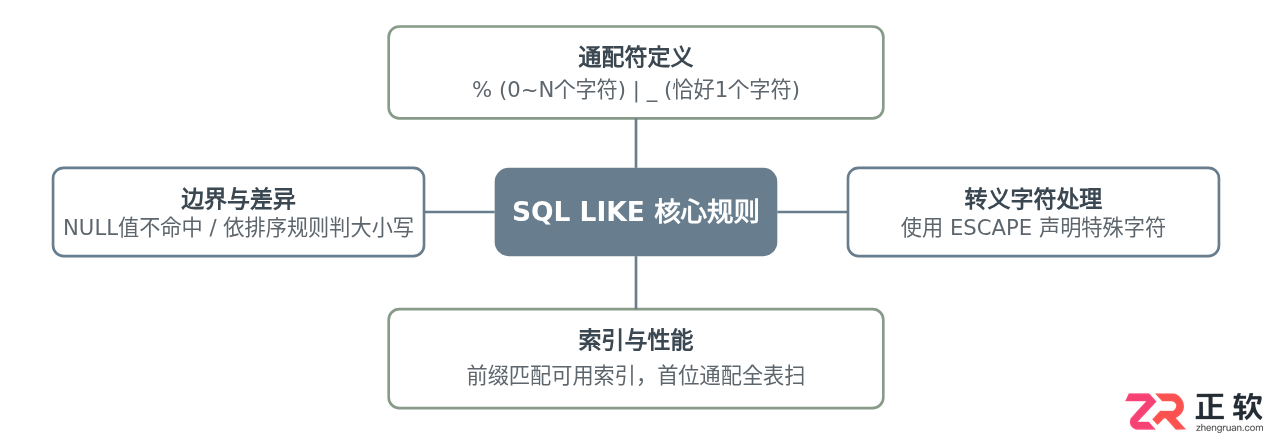
掌握通配符的长度属性、规范使用 ESCAPE 转义,并在编写查询条件时刻意保留固定的前缀常量,是保证 SQL 模糊查询兼顾灵活性与查询性能的关键基石。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。
本文以PostgreSQL语法为主,讲解SQL基础SELECT查询与多表JOIN连接。通过users和orders表实例,演示WHERE过滤、ORDER BY排序、LIMIT限制,重点解析INNER JOIN与LEFT JOIN的结果差异、ON与WHERE条件放置对结果的影响,以及GROUP BY统计与结果异常排查方法。适合刚接触SQL的开发者快速掌握多表查询核心逻辑。
全面解析SQL分页查询的两种经典实现方案:LIMIT OFFSET语法与ROW_NUMBER()窗口函数。对比MySQL、PostgreSQL、SQL Server及Oracle的语法机制、执行流程与深分页优化实践。
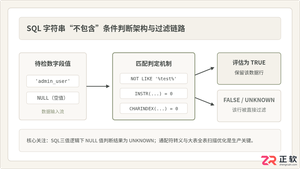
深入详解在SQL中进行条件判断字符串不包含某个子串的方法,涵盖标准NOT LIKE、各主流数据库(MySQL、PostgreSQL、SQL Server、Oracle)专有位置函数、正则表达式判断,剖析NULL值三值逻辑陷阱及全表扫描性能优化策略。
深入讲解SQL中CASE WHEN语句的工作机制、语法形式及在单维度区间离散化、多维度复合标记与条件聚合统计等数据分类场景中的具体应用与注意事项。
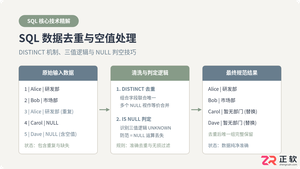
深入解析SQL中DISTINCT去重原理与多列组合行为,剖析NULL值的三值逻辑、IS NULL判断技巧以及COALESCE等空值处理函数,避免查询踩坑。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


