

pandas读取excel文件后无法合并数据集
打工人 Excel 插件是一款专为Office和WPS设计,支持数据提取、证件识别等功能。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
解决Pandas合并Excel数据报错或结果不对的问题。通过检查read_excel读取结果、统一列名与数据类型、清洗连接键空格及前导零,以及合理使用merge的how和indicator参数,确保数据合并准确无误。
使用Pandas读取多个Excel文件后,常见的下一步是将数据合并为一个DataFrame。当合并失败或结果不符合预期时,问题往往不在读取函数本身,而在于列名不一致、数据类型冲突、键值内容差异或合并方式选择不当。下面以Windows环境下常见的Python开发流程为例,从读取结果开始梳理需要检查的区域和信息,帮助初学者快速定位问题所在。
概述
一个典型的Excel合并过程主要涉及三个部分:代码编辑区负责写入读取和合并语句,运行输出区显示DataFrame的结构信息,而Excel文件本身提供原始数据。在调用合并函数之前,应先确认每张表能独立正确读入,再重点检查作为连接条件的列。
例如,先读取两个文件,并打印列名、数据类型和前几行数据,以便建立整体认知:
import pandas as pd
left = pd.read_excel('订单表.xlsx')
right = pd.read_excel('客户表.xlsx')
print(left.columns.tolist())
print(right.columns.tolist())
print(left.dtypes)
print(right.dtypes)
这一步骤的目的不是直接修复问题,而是将后续排查所需的关键信息显示出来。
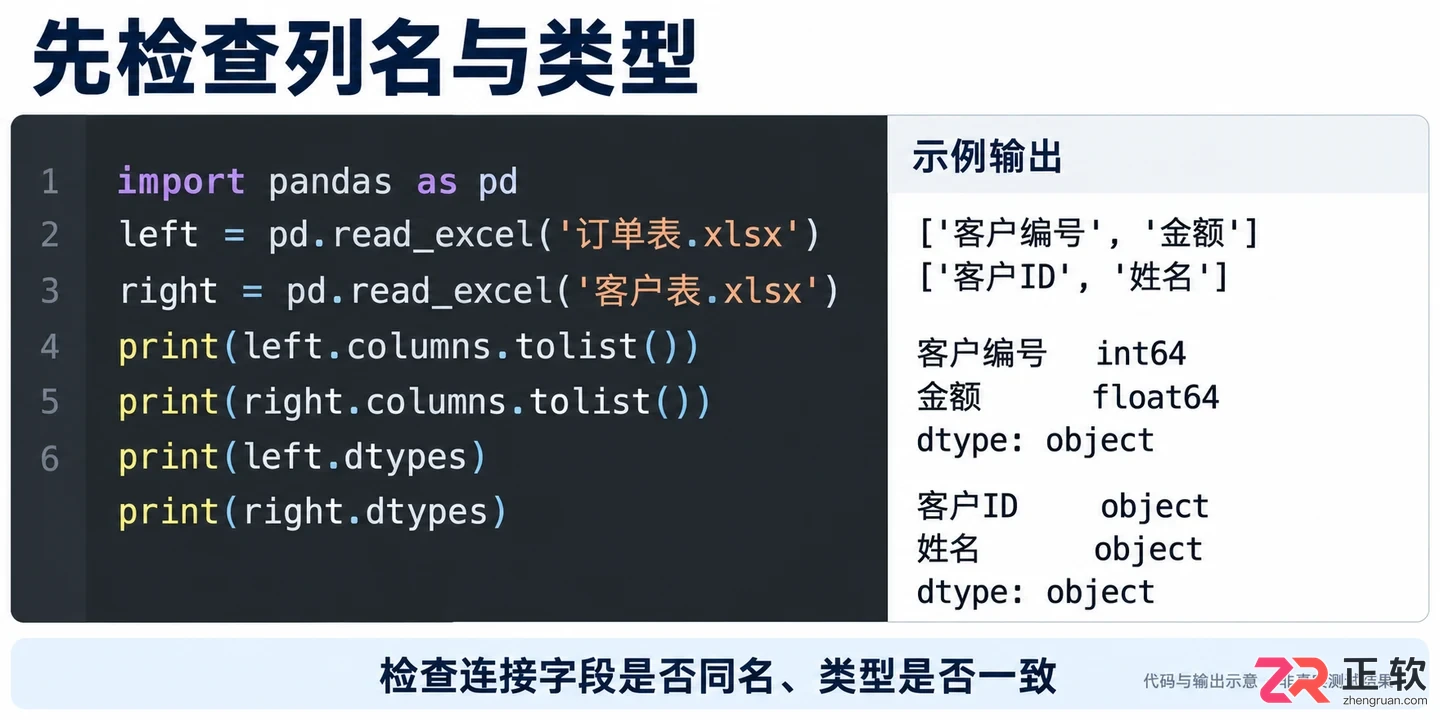
读取Excel文件后打印列名和数据类型
关于【Excel文件与工作表】
文件区域首先要确认路径、文件名和工作表名称。即使两个Excel文件看起来内容相似,也可能使用了不同的表名、首行标题位置或包含额外的说明行。如果表头不在第一行,需要在读取时调整header参数;如果目标数据位于特定工作表,则需使用sheet_name明确指定。
读取后应分别检查数据,而不是直接调用merge:
print(left.head())
print(right.head())
print(left.shape, right.shape)
如果发现其中一个对象为空、列数异常或第一列出现Unnamed: 0,应先回到读取阶段处理。保存Excel时也需检查表头是否重复、关键列前后是否存在空格,以及是否因合并单元格导致空值被误读。文件能成功读入,并不代表它已经适合直接进行连接操作。
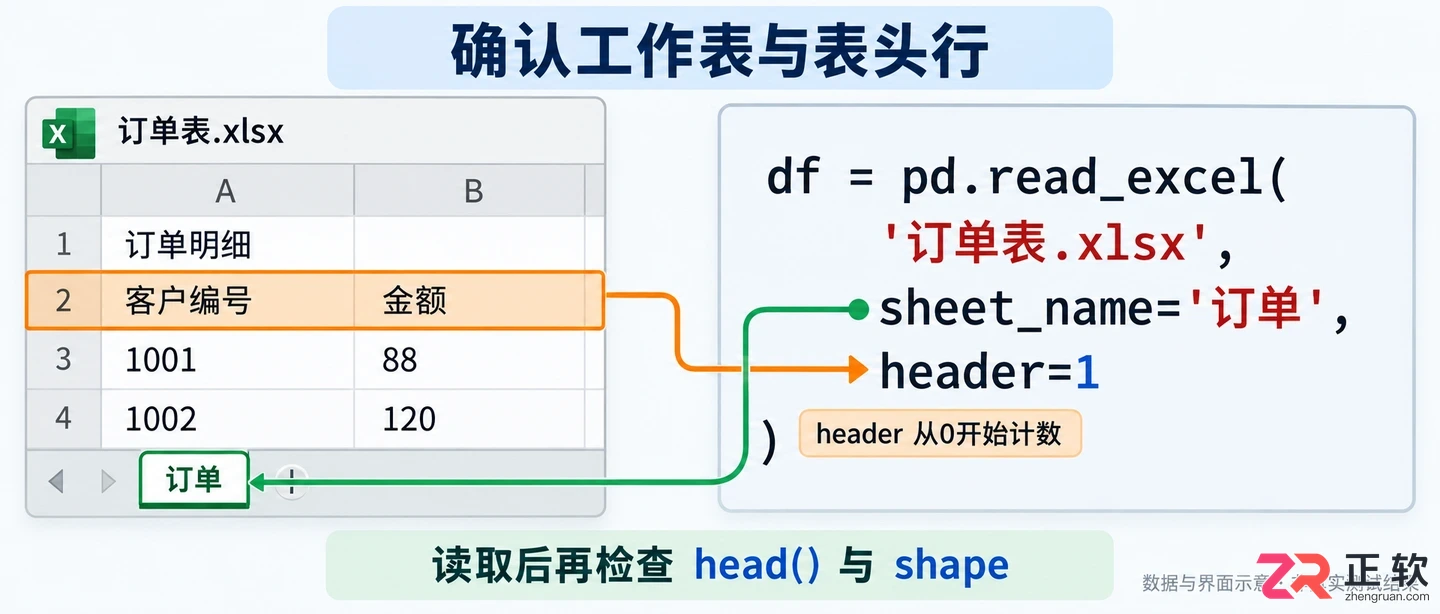
关于【Excel文件与工作表】
关于【列名和连接字段】
Pandas合并需要使用两张表中都存在的连接字段。最常见的情况是左表列名为“客户编号”,右表为“客户ID”,或者列名虽然相似但包含了不可见的前后空格。建议先打印列名,再通过rename统一字段名称:
left.columns = left.columns.astype(str).str.strip()
right.columns = right.columns.astype(str).str.strip()
right = right.rename(columns={'客户ID': '客户编号'})
merged = pd.merge(left, right, on='客户编号', how='left')
如果两张表的连接列名称无法统一,也可以显式指定left_on和right_on。需要注意的是,on参数只能用于两边都存在的同名列;写错列名时会直接报KeyError。不要为了消除报错而随意将无关列当成连接键,这会导致结果行数和业务含义出现严重偏差。
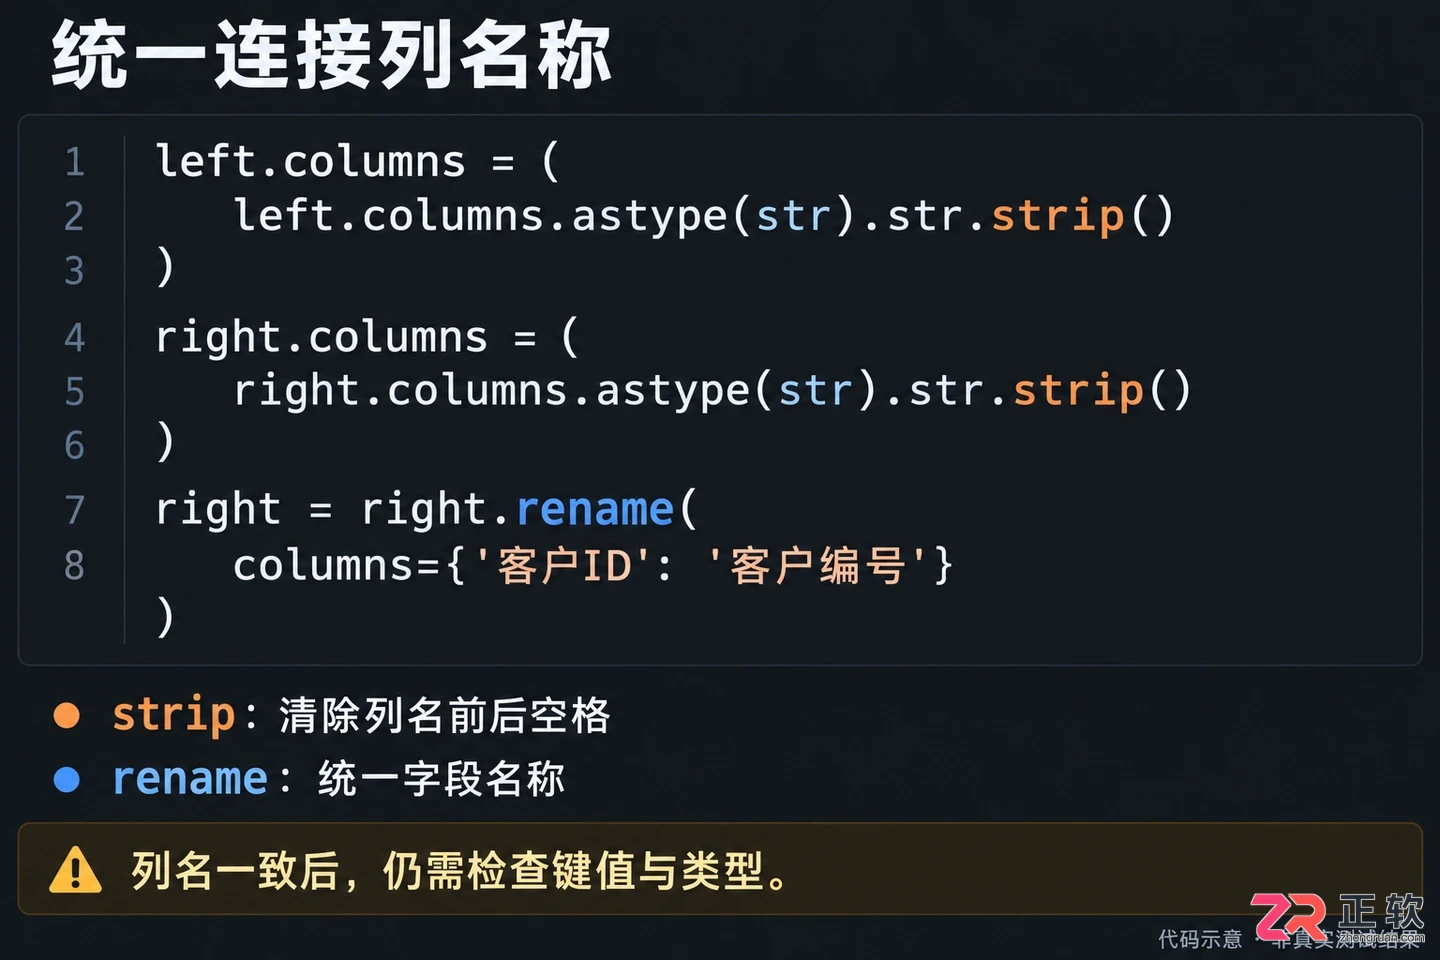
统一列名并去除前后空格
关于【数据类型和键值格式】
列名一致后仍然无法合并,重点应检查连接列的数据类型。例如,一张表将编号读为整数,另一张表读为字符串,或者一边保留了前导零,另一边已经丢失。先查看两列的dtype和示例值:
print(left['客户编号'].dtype)
print(right['客户编号'].dtype)
print(left['客户编号'].head().tolist())
print(right['客户编号'].head().tolist())
确认业务规则后再统一类型。对于编号这类不参与计算的字段,通常应按字符串处理,以免Excel中的前导零丢失:
left['客户编号'] = left['客户编号'].astype('string').str.strip()
right['客户编号'] = right['客户编号'].astype('string').str.strip()
如果字段中存在空值、不可见空格或不同格式的连字符,仅转换类型并不会自动修正这些内容,还需根据实际规则进行清洗。日期、金额等字段则要区分显示格式和实际存储类型,不能仅凭Excel单元格的外观判断两列一定相同。
关于【merge结果与连接方式】
连接键准备就绪后,再选择合适的合并方式。left保留左表全部记录,适合在订单表基础上补充客户信息;inner只保留两边都能匹配的记录;outer则会保留两边的所有键值。可以先使用indicator参数查看哪些记录匹配成功:
merged = pd.merge(left, right, on='客户编号', how='left', indicator=True, suffixes=('_订单', '_客户'))
print(merged['_merge'].value_counts())
如果结果中大量记录显示为left_only,通常说明键值格式仍有差异,或者右表确实没有对应记录。如果结果行数突然增多,要检查右表连接键是否重复;一对多或多对多连接会让同一个左表记录产生多行。需要约束关系时,可以根据实际业务使用validate参数进行检查,但不要在不了解数据关系时强行指定唯一关系。
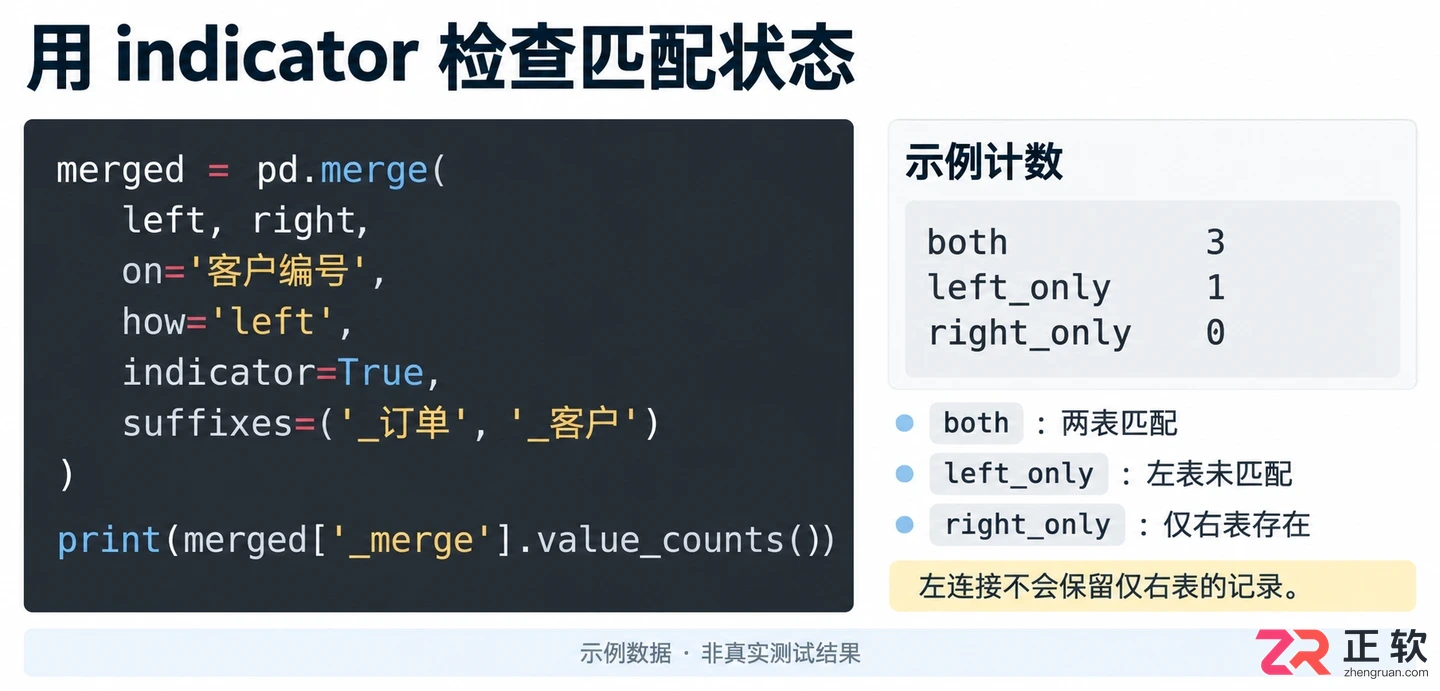
使用indicator参数查看匹配状态
关于【运行输出与文件保存】
合并成功后,先查看merged.head()、merged.shape和关键列,再决定是否导出。若要保存为新的Excel文件,可使用:
merged.to_excel('合并结果.xlsx', index=False)
保存时不要覆盖原始文件,避免后续无法对照。运行窗口里没有报错只代表代码执行完成,还应确认输出文件路径、行数以及关键字段是否存在。若结果为空或列名带有意外后缀,应回到连接字段和合并关系检查,而不是直接把空结果当成完成。
整个流程可以按先读每张表、再看列名、统一键值、选择how、检查结果、另存文件的顺序进行。这样,Pandas读取Excel后的合并问题就能被拆成清晰的数据区域分别定位,排查时也更容易判断是输入文件、连接字段还是合并关系造成的。
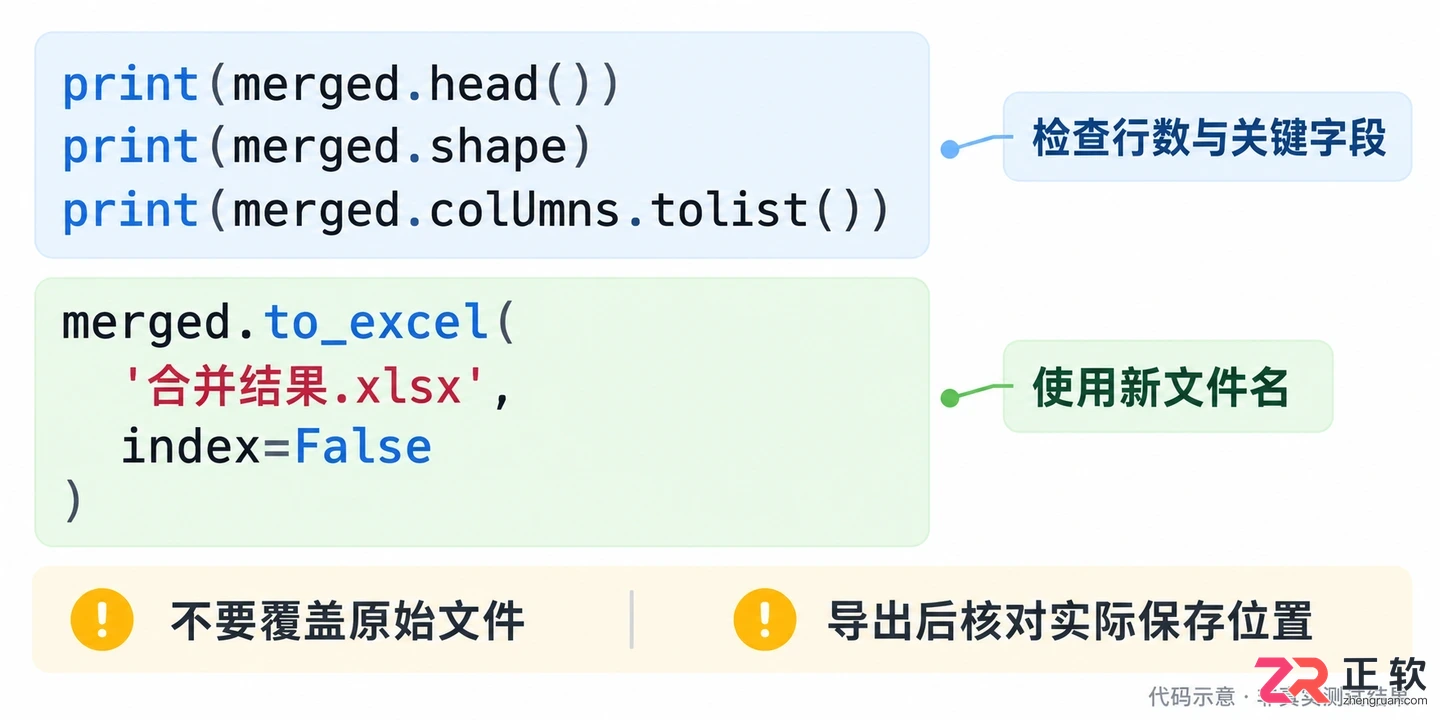
关于【运行输出与文件保存】
打开Excel后右侧自动跳出模板大全或打工人Excel插件面板?本文提供逐步操作指南:先关闭当前任务窗格,再进入选项停用对应COM或Excel加载项,最后重启验证,确保工作区清爽且不影响其他功能。
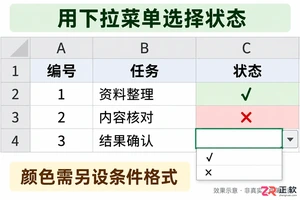
想在Excel中快速记录完成状态?本教程详解如何使用数据验证功能创建包含√和×符号的下拉列表,并配合条件格式实现颜色区分,提升表格录入效率与美观度。
想在Excel中快速统一填写规范?本文详解如何使用数据验证功能创建下拉菜单。从准备选项列表到设置序列来源,再到修改维护和常见问题解决,一步步教你实现标准化数据录入,提升表格处理效率。
想在Excel表格里做带勾的方框?本文提供Windows版Excel的详细实操步骤,包括插入可点击的复选框、输入静态√符号以及利用数据验证制作下拉选择。区分打印与交互场景,助你快速完成任务清单制作。
解决Excel打开文件后工作表区域全灰、无网格线的问题。涵盖取消隐藏窗口、调整视图、禁用硬件加速、安全模式排查打工人Excel插件等加载项,以及修复损坏文件的具体操作步骤。
调整Excel转PDF的纸张大小、方向、缩放比例和打印区域,可解决内容过小、横向表格被截断与多出空白页;同时通过定位空行、清除残留格式和重新设置使用区域,避免导出PDF出现大片空白。并补充分页预览、隐藏对象清理和最终文件体积检查。便于减少误操作和重复返工。
PDF转Excel准确度受表格结构和扫描质量影响。文章提供在线转换五步流程,并说明合并单元格、跨页表头、数字日期和错位数据的校对方法。
大家有没有遇到过PDF里的表格无法直接编辑的情况?这时候,将其转换为Excel再进行数据整理就会方便很多。下面,我给大家详细介绍3种完整的操作方法,每一步都配有对应的操作截图,同时还会说明普通PDF和扫描版表格在处理上的区别。 方法一:用极轻PDF转换Excel极轻PDF(pdf.cn)的PDF转E
Excel转PDF显示不完整通常与打印区域、方向和缩放有关。文章说明在线转换步骤,并给出一页显示、分页控制、空白页和内容截断的修复方法。
学习如何用 pandas 读取 Excel 并追加新数据。通过 pd.concat() 安全合并 DataFrame,检查列名与类型,最后使用 to_excel() 保存结果,避免直接修改原始文件。




火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




