

PDF怎么免费转成Word并保留内容?转换前后检查要点
围绕PDF免费转Word且尽量保留正文、图片与版式,文章分三条路线说明:使用PDF.cn在线转换、通过桌面转换器本地批量处理,以及为扫描件先做OCR再导出。同步列出上传前准备、页码与格式设置、转换后文字乱码、段落错位、图片缺失和表格变形的检查方法,便于按文件类型选择合适方案并减少返工。
可以免费把 PDF 转成 Word,但能否较完整地保留文字、图片、表格和段落位置,取决于原文件是文字型 PDF、扫描件,还是包含复杂分栏与特殊字体。普通文字型文件可先使用 PDF转Word 在线处理;涉及多文件、扫描页或复杂版式时,再根据文件类型选择本地转换或 OCR 路线。
方法一:使用 PDF.cn PDF转Word 在线处理
这条路线适合可正常选中文字、文件体积适中、希望快速获得 DOCX 文档的情况。开始前建议关闭密码保护,并确认原文件可以完整打开。扫描件可以尝试转换,但识别质量和版式恢复通常不如文字型文件稳定。
步骤一:找到转换入口。进入首页后,在常用工具区域找到对应入口,先核对转换方向,避免误入 Word 转 PDF 或其他工具。
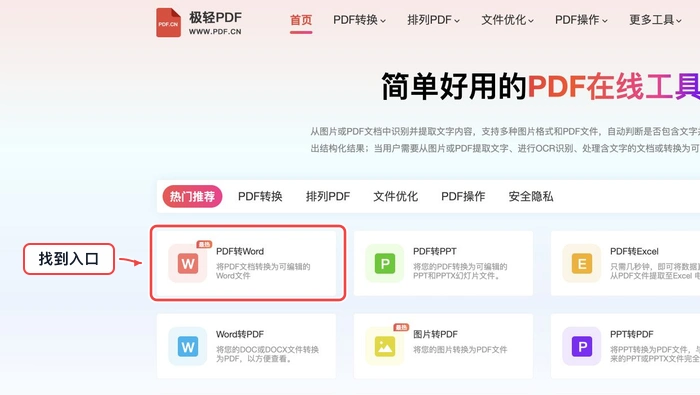
找到工具入口
步骤二:选择并上传文件。点击页面中的文件选择区域,添加需要处理的 PDF。上传前再次确认文件内容、页数和版本,避免选中同名旧文件。
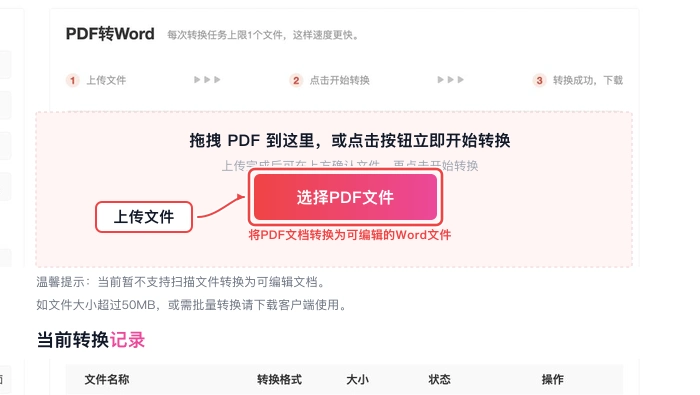
选择并上传文件
步骤三:核对上传状态。文件进入列表后,检查文件名、大小和上传状态是否正确。如果名称相近,应打开原文件核对首页内容后再继续。
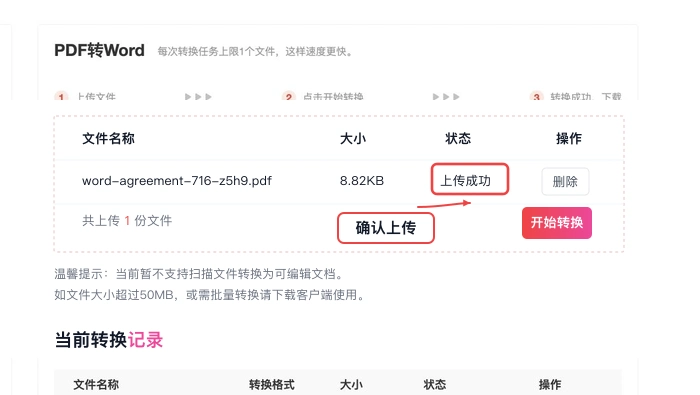
核对上传状态
步骤四:开始处理。确认上传完成后再启动转换,处理中不要重复提交同一文件。页面未给出额外参数时,保持当前设置即可。
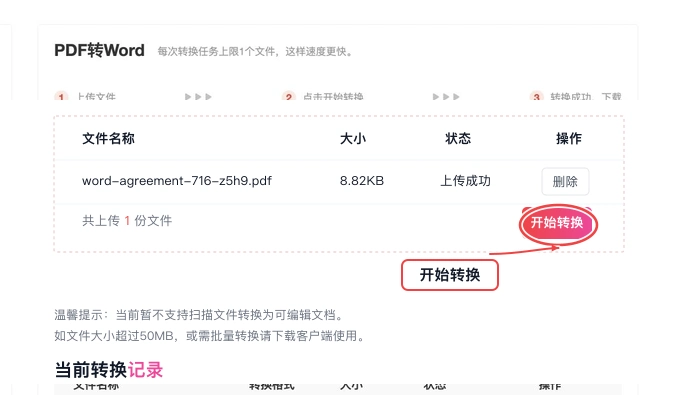
设置参数并开始处理
步骤五:下载并检查结果。状态显示完成后下载 Word 文件,先保存到容易找到的位置,再打开核对正文、图片、表格和页码。不要只看到文件能够打开就结束检查。
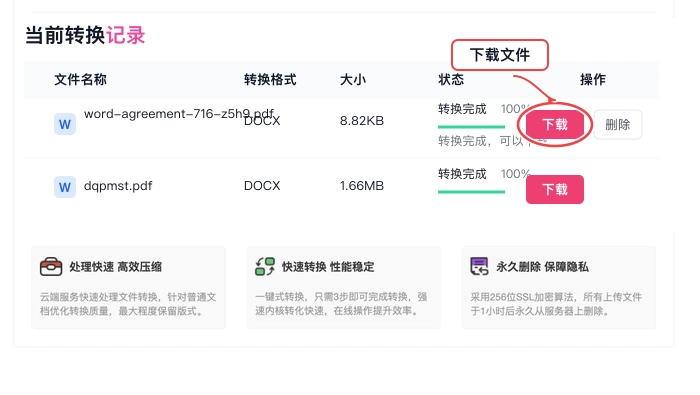
下载结果并检查
完成后重点检查:复制一段中文确认没有乱码;查看跨页段落是否断开;比较图片数量和位置;逐个检查表格是否出现错列。分栏、公式、艺术字和嵌入字体可能需要手动调整,不能仅凭页面外观判断内容已经完整恢复。
方法二:用桌面转换器进行本地批量处理
当文件较多、需要连续处理,或不方便反复上传时,可以使用桌面 PDF 转换器。它更适合文字型 PDF 的批量任务,但仍应先用一份代表性文件试转,确认版式结果符合要求后再处理其余文件。
步骤一:用样稿建立对照基准。选择一份同时包含标题、正文、图片和印章的文件进行试转,并将 PDF 原稿与 Word 结果并排查看。先记录标题位置、段落层级、图片数量和分页位置,后续才能快速发现偏差。
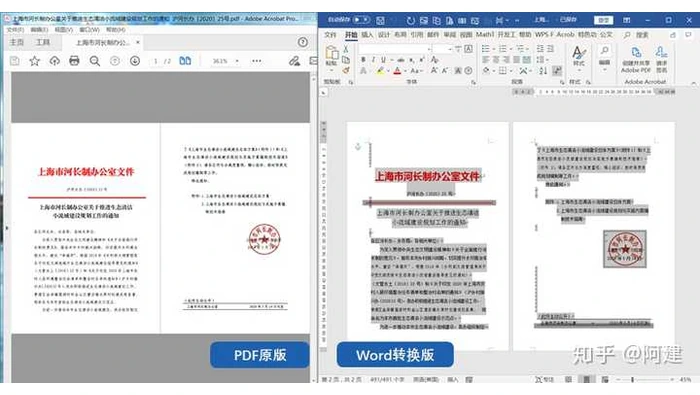
对照 PDF 原稿与 Word 转换结果
步骤二:配置本地转换任务。将文件加入桌面转换器的任务列表,核对输出格式和保存目录;批量文件应先统一命名,并避免把结果写回原文件所在位置。确认设置后再执行任务。
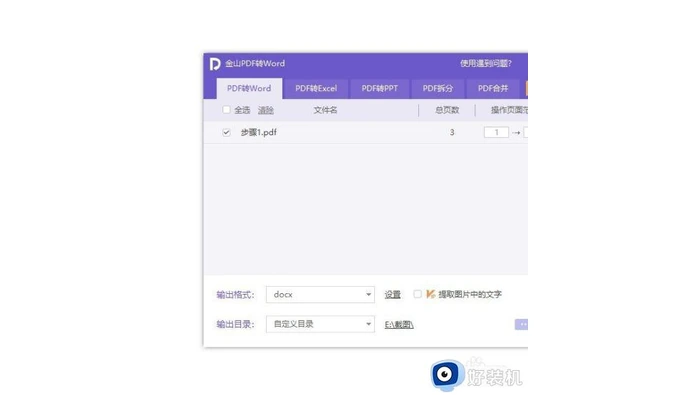
设置输出格式与保存目录
适用限制与检查方法:本地转换便于批量处理,但不同软件对字体、表格和多栏页面的解析方式可能不同。任务完成后可按文件数量、输出文件名和页数进行第一轮核对,再随机抽查首页、中间页及末页;发现整批文件出现相同错位时,应先调整一份样稿的处理方式,而不是逐份修改。
方法三:扫描件先做 OCR,再按页导出 Word
如果 PDF 页面无法选中文字,放大后能看到明显像素或整页都是图片,应先进行 OCR 文本识别,再转换为 Word。这条路线适合扫描合同、票据和纸质资料电子版;手写字、模糊页、倾斜页及复杂表格仍可能需要人工校对。
步骤一:确认应用具备 OCR 或文本识别能力。打开扫描件后,先检查所用 PDF 应用是否提供 OCR、识别或文档处理功能。识别前可旋正倾斜页面,并确认正文语言,以减少错字和错误分段。
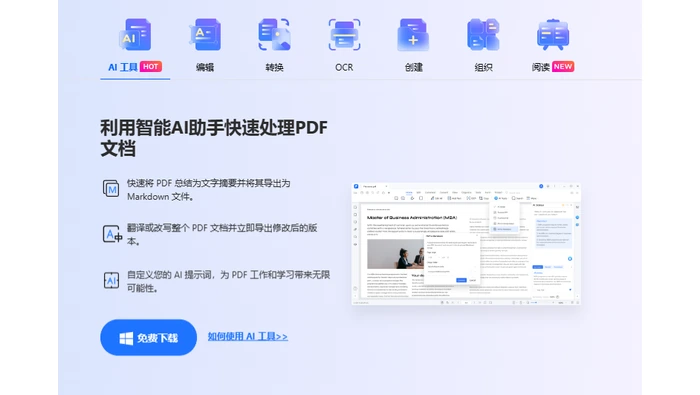
确认 OCR 与文档识别功能
步骤二:选择页码范围并输出 DOCX。识别完成后,将处理后的 PDF 加入本地转换任务,根据需要选择全部页面或指定页码范围,核对输出格式后再开始。长文档可以先转换少量页面,确认识别结果后再扩大范围。
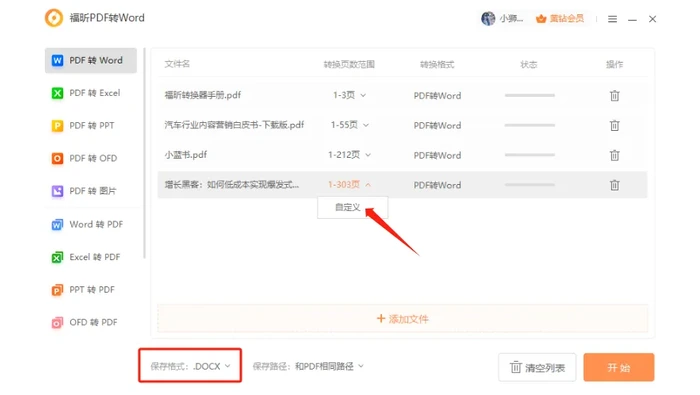
设置页码范围和 DOCX 输出格式
完成后重点检查:逐段查看人名、金额、日期、编号和标点;表格要核对行列关系,印章与签名只检查图片是否保留,不把 OCR 文字当作原始凭证。对于模糊或低分辨率页面,OCR 只能提高可编辑性,无法保证复杂排版和所有字符完全还原。
转换前先判断 PDF 类型
| 文件特征 | 建议路线 | 主要检查点 |
|---|---|---|
| 文字可选择、页数不多 | 在线转换 | 段落、图片、表格和分页 |
| 多个文字型文件,需要集中处理 | 桌面批量转换 | 文件数量、命名、输出目录和抽样结果 |
| 无法选中文字,页面为扫描图 | OCR 后再导出 | 姓名、数字、日期、表格行列和错别字 |
| 分栏、公式或特殊字体较多 | 先试转一部分再决定 | 阅读顺序、字体替换、公式和对象位置 |
转换结果按这个顺序验收
- 先比较总页数和正文是否完整,确认没有缺页或空白页。
- 搜索原稿中的姓名、金额或编号,检查关键文字能否准确找到。
- 查看段落、标题层级、分栏顺序和跨页内容是否错位。
- 逐个核对图片、印章、公式和表格,必要时回到原稿手动修正。
- 另存一份修改后的 DOCX,保留原始 PDF 作为最终校对依据。
常见问题
转换后为什么出现乱码?常见原因包括原文件使用嵌入字体、字符映射异常或扫描识别错误。可先确认原 PDF 能否复制正常文字;不能复制时,应改走 OCR 路线。
为什么表格变成了文本框?PDF 保存的是页面视觉结果,不一定保留原始表格结构。转换工具可能按位置重建对象,复杂表格通常需要在 Word 中重新整理行列。
免费转换后还需要人工检查吗?需要。即使正文看起来正常,也应复核关键数字、分页、图片和表格;合同、财务资料及正式文件尤其不能跳过逐项校对。
参考来源
真正省时间的关键不是只完成格式转换,而是先判断文件类型,再按固定顺序验收结果。后续遇到扫描识别、版式修复或其他 PDF 处理问题,也可以继续关注极轻 PDF 网站的工具与实用教程。
处理PDF转Word每个字带独立文本框,需先独立文本框说明转换器在模拟PDF中的字符坐标,而非重建连续段落。本文结合真实步骤图说明复制一页纯文字到新文档,判断能否保持正确阅读顺序、使用仅保留文本或重新OCR导出,不要逐个拖动数百个文本框、按标题、正文、列表和表格重建样式,再清理硬换行,并补充多。
将PDF文件转换成Word,可根据文件类型选择PDF.cn在线转换、Microsoft Word直接打开或OCR识别三种方法。本文按步骤说明上传、导出与保存,并从字体、段落、表格、图片和页码五个方面检查转换后的排版,减少错位和返工。同时补充容易出错的细节和最终验收要点。
文章围绕已知密码解除PDF保护,分别介绍PDF.cn在线解锁、极轻PDF在线编辑器安全清理,以及本地安全设置配合备用解除页三条路线,逐步说明上传、密码校验、处理、下载与结果检查,并补充适用场景、限制、常见失败原因和源文件备份建议,帮助新手根据文件状态选择更稳妥的处理方式。
针对扫描PDF无法直接翻译、文字识别不准和版式易错位的问题,本文介绍三种可落地路线:用PDF.cn处理已完成OCR的文件,先转为可编辑文档再翻译,以及通过桌面工具本地OCR后提交文档翻译,并说明语言设置、结果下载、原文对照和表格图片复核要点,帮助兼顾翻译效率、隐私需求与格式保留。
处理PDF不能复制文字,需先先判断PDF是否存在可搜索文字层。本文结合真实步骤图说明用搜索或文字选取测试区分扫描图与真实文字、查看文档属性中是否禁止复制,权限限制需由文件所有者处理、纯扫描件在副本上执行中文OCR,再复制识别后文字,并补充对照原页抽查人名、金额、日期和编号的处理要点,避免覆盖原。
围绕两个PDF合并成一个的实际操作,介绍PDF.cn在线合并、极轻PDF在线编辑器排序合并,以及适合临时设备的网页拖放路线,覆盖文件上传、顺序调整、开始处理、结果下载和页序检查,并提示敏感文件、复杂表单与大文件处理时的限制,帮助按场景选择稳妥方案。
手机删除PDF页面可按三种路线处理:优先使用PDF.cn在线工具逐页勾选并下载;需要直观看页序时,可用极轻PDF在线编辑器确认剩余页面;主工具不便使用时,再选PDF365专用删除页。文中说明单页、多页删除、文件保存、结果核对及常见异常排查,适合临时处理与跨设备操作。
围绕Excel转PDF提速,文章对比PDF.cn在线转换、本地桌面批量处理,以及Excel/WPS另存与虚拟打印三条路线,说明上传、分页、输出和下载检查要点,帮助按单文件、多文件和版式控制需求选择更省时间的做法,并排查页面截断、字体变化与结果文件打不开等常见问题。
处理PDF文件显示0KB打不开,需先0KB表示文件没有可供修复的实际数据。本文结合真实步骤图说明不要在0KB副本上反复修复,先停止覆盖和同步、回到邮箱、微信、网盘或下载页重新取得文件、查找本地备份、历史版本或发送方保留的原件,并补充新文件下载后先比较字节大小,再改名并打开的处理要点,避免覆盖原。
本文围绕合并PDF后的页面顺序调整,分别介绍PDF.cn在线合并、极轻PDF在线编辑器拖动排序,以及本地PDF编辑器先合并再移动页面三种路线,并说明上传顺序、排序确认、下载后逐页核对、页码与内容完整性检查及常见异常排查方法,便于按文件数量、隐私需求和操作环境选择合适方案。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,


