

音述AI生成歌曲出现杂音该怎么调参

音述AI生成的歌曲出现底噪或失真怎么办?本教程演示如何在自定义创作中优化【风格提示】并设置【排除风格】,通过调整生成条件改善音质。注意这是重新生成而非原曲降噪,适合希望获得更干净人声和伴奏的用户参考。
在音述AI中遇到生成的歌曲带有沙沙底噪、人声发毛或乐器失真时,直接对原音频进行“降噪”并不可行,因为该工具的核心机制是基于文本提示重新生成音频。解决此类问题的关键在于调整创作条件,通过更精准地描述想要的声音质感,并明确排除不需要的听觉元素,来引导模型输出更干净的结果。
下面以一首追求干净听感的钢琴抒情歌为例,展示如何通过调整【风格提示】和【排除风格】来改善音质。
在作品详情页反复试听,定位杂音出现的具体时间段
1. 先找出原歌曲需要改善的位置
打开已生成的作品,点击播放并仔细聆听。记录不满意的声音具体出现在哪个时间段,以及属于哪种听感异常。例如,是整段伴奏都有持续的沙沙底噪,还是某一句人声突然变得尖锐失真,亦或是只有吉他部分听起来有破损感。
建议反复试听同一小段,避免仅凭一次卡顿或网络波动就判定为生成质量问题。如果可能,更换耳机或扬声器再次确认,确保问题是可以复现的听感缺陷。这一步的目的是明确修改方向,而不是盲目调整参数。在本例中,假设目标是获得清晰的钢琴与人声,而当前版本存在非预期的失真感,请保留原作品作为对照,不要直接删除。
1. 先找出原歌曲需要改善的位置
2. 在【风格提示】中明确干净的声音目标
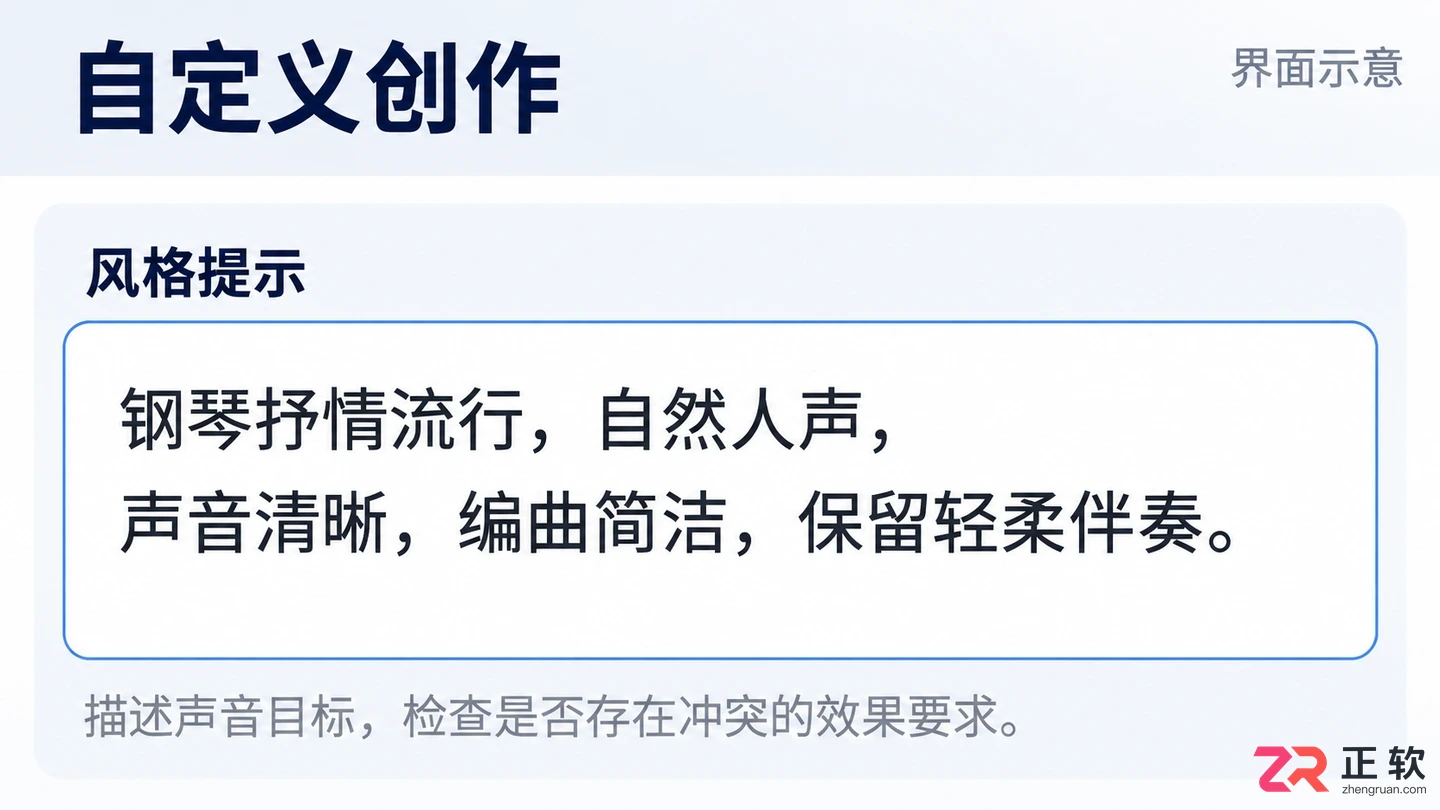
进入【创作】页面,选择【自定义创作】模式。将原先使用的歌词填入歌词区域,然后重点检查【风格提示】输入框。这个字段用于描述曲风、乐器配置、情绪氛围等,它决定了生成的基调,但不能当作后期效果器面板使用。
针对钢琴抒情歌,可以将声音目标写得更具体。例如:
钢琴抒情流行,自然人声,声音清晰,编曲简洁,保留轻柔伴奏。
这并非官方的降噪预设,而是通过强调“清晰”“简洁”来引导模型减少复杂的混响或过度的效果处理。如果原有的提示词中包含了“老唱片噪声”“强失真”“电话滤波”等可能与“干净”冲突的描述,请先删除这些不必要的效果指令,消除相互矛盾的生成要求。
2. 在【风格提示】中明确干净的声音目标
3. 展开【排除风格】填写不希望出现的元素
在自定义创作区域找到【排除风格】选项,点击展开该区域。在输入框中填写你希望避免出现在歌曲中的元素。系统默认的提示示例通常包含“嘈杂、失真、跑调、低质量”等词汇,可以直接参考使用。
针对本例的杂音问题,可以在排除栏中填入“嘈杂、失真”。这样做的目的是让模型在生成过程中主动避开这些特征,与前面【风格提示】中的正面描述形成配合。填写完成后,界面通常会显示【已填写】状态,确保该项设置生效。
需要注意的是,排除项应与歌曲的整体目标相符。如果原本就需要摇滚风格的失真吉他,则不宜为了处理人声问题而排除所有“失真”。此外,无需堆砌大量否定词,只保留与当前问题最相关的描述即可,以便后续追踪调整效果。
4. 保留歌词与曲风,提交一次新的创作
确认本次使用的歌词与之前一致,主要曲风仍为钢琴抒情流行,且仅改变了声音目标和排除项后,点击【创作】按钮生成新版本。此时系统会根据新的提示条件重新计算音频,账号权限、模型选择及消耗信息请以当前页面显示为准。
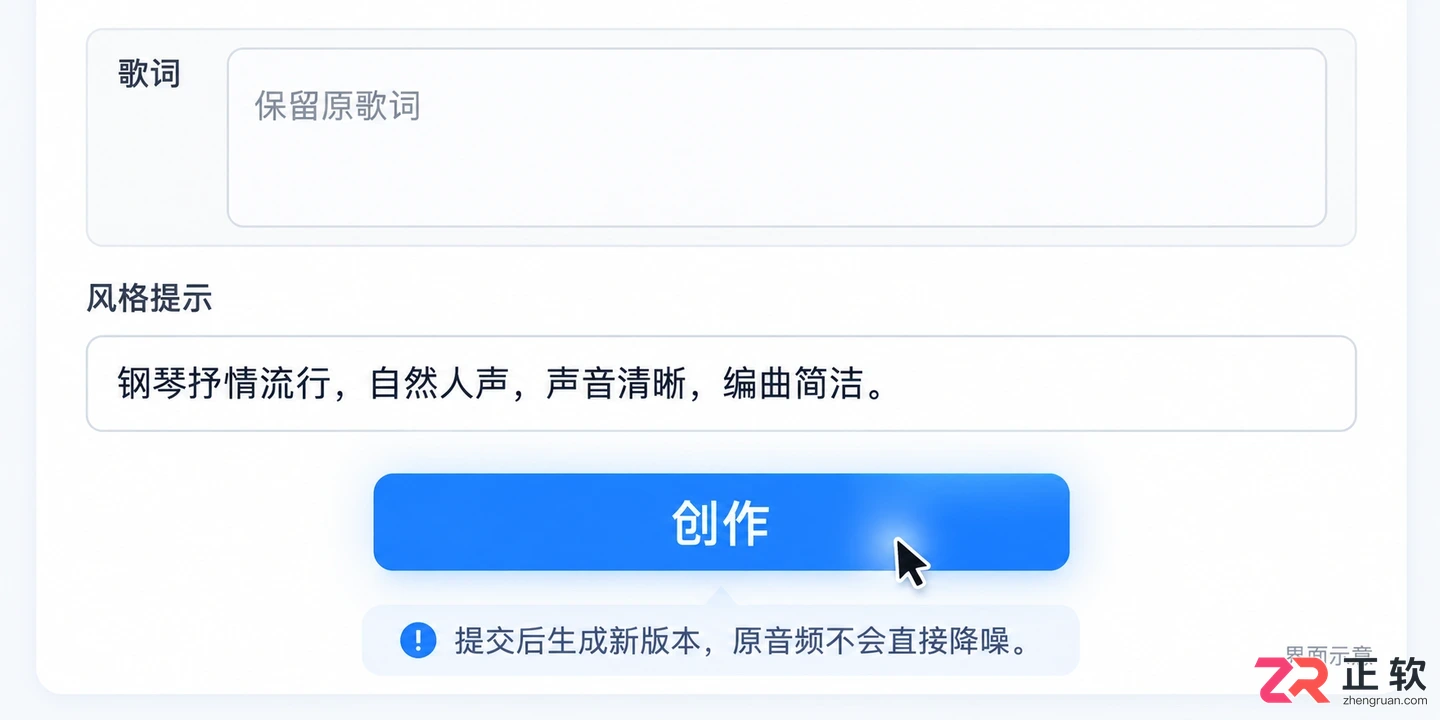
确认提示词调整后,点击创作生成新音频
必须明确的是,这一操作产生的是一个全新的生成结果,而不是在原音频基础上应用了一组降噪参数。即使歌词和描述非常接近,新版本在旋律走向、演唱细节和编曲结构上也可能发生变化。因此,不能期望只有杂音消失而其他所有声音元素完全保持不变。
5. 对照试听,保留确实更合适的版本
新作品生成完成后,首先关注人声的清晰度和伴奏是否符合预期,再检查之前关注的杂音或失真现象是否减轻。对比试听时,尽量保持播放音量和设备一致,避免因音量差异误判音质变化。
对比新旧版本的听感,选择更干净的一版保存
【排除风格】表达的是生成的倾向性,并不保证每次都能完美排除某种声音。如果新版本仍不满意,可以保留这次的提示词记录和试听感受,作为进一步调整的参考。由于该路径没有降噪强度、采样率或增益值等具体数值控制,无法通过微调数字来精确控制效果。确认采用哪一版后,再保存对应的音频文件,并保留原版供后续比较或回溯。
音述AI创作中途卡住或提示网络异常?本教程指导你在Windows环境下先备份歌词与提示词,再检查网络连接,通过刷新页面和查询创作历史来确认任务状态,避免盲目重试造成资源浪费。
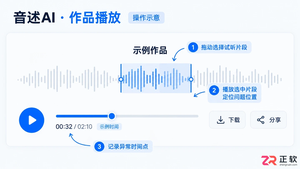
音述AI生成的歌曲人声听起来有杂音或机械感?本文教你通过检查播放设备、优化歌词排版、调整风格提示词以及使用“排除风格”功能,有效减少人声失真,提升AI音乐生成质量。
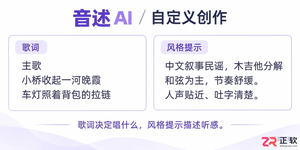
想用电音述AI写出一首有木吉他、有故事感的民谣?别只输入“伤感”,试试把故事缩成具体场景,用短句控制呼吸,并在风格提示中明确“稀疏伴奏”。本文以“离开小镇”为例,演示从歌词整理到微调生成的完整流程。
学习在音述AI中运用GETI提示词框架,将“雨夜独白”拆解为场景、流派、人声和编曲细节。通过具体案例演示如何调整速度、留白和乐器比重,解决人声被遮盖或节奏混乱问题,提升AI音乐生成的可控性。
想在电脑上把歌曲变成纯伴奏?本教程详解如何使用音述AI网页版进行音轨分离。只需上传MP3或WAV文件,选择“人声+伴奏”方案,即可单独下载伴奏音轨。步骤包含上传、生成、独奏试听及本地保存,助你轻松获取高质量卡拉OK伴奏。
想了解音述AI分轨导出是否免费?本文解析其积分扣费机制,说明会员权益与分轨任务的区别,指导用户如何查看余额、选择分离模式及正确下载人声伴奏文件。
音述AI提示词过长是否影响生成质量?本文通过实际案例演示如何清理矛盾指令、保留关键音色细节,并指导用户通过试听反馈迭代优化,确保音乐生成符合预期。
想知道如何用音述AI写出孩子爱唱的儿歌?本教程分享如何缩小创作主题、编写易记短句、设置清晰的音乐风格描述,以及试听时的关键检查点,助你生成高质量的儿童歌曲。
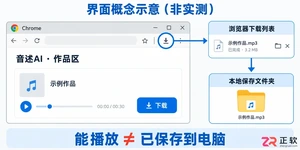
音述AI作品下载失败时,请勿急于重新生成。本文基于Windows环境,指导您通过检查作品生成状态、浏览器下载列表(Ctrl+J)及本地文件夹权限,快速定位是网络中断、安全拦截还是保存路径问题,并提供规范的官方反馈建议。
想了解音述AI自定义创作怎么填?本文基于官方网页版界面,逐步解析模型选择、5000字歌词区、1000字风格提示、人声及排除风格的设置要点,助你清晰表达创作意图。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,


