

DeepSeek V4.1 Flash 1017:Agent榜单指标与编程评测表现
了解DeepSeek V4.1 Flash 1017的Agent Arena指标、约0.20美元任务成本中位数,以及Terminal-Bench 4.0和ProgramBench成绩变化与适用边界。
看模型榜单时,最忌讳把某一天的快照当成永久结论。DeepSeek V4.1 Flash(1017更新版)在Agent任务和编程评测上的数据很有参考价值,但必须分清版本后缀、榜单日期和统计口径。官网首页已确认这一版本更新,访问 https://deepseek.com/ 可获取最新信息。以下区分10月19日的榜单快照与官方更新日志中的基准测试结果。
Agent榜单中的版本与净改善
10月19日的榜单快照将DeepSeek-V4.1-Flash-20261017(Max)列在第11名,标注约7500次真实使用会话、综合净改善约5.1%。这些数值属于当时的记录,不能作为当前动态排名。
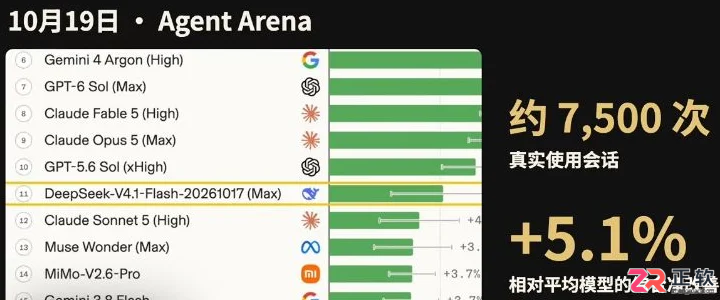
10月19日榜单截图中的模型版本、名次和净改善指标
这里的5.1%是一个相对指标,反映的是在特定样本集下的综合表现优化,不能直接等同于所有任务的成功率,也不是相对于上一代模型的统一提升幅度。Agent Arena官方榜单(https://arena.ai/leaderboard/agent)是动态榜单,当前统计可能与历史截图不同。因此,核对数据时必须同时确认模型后缀和榜单日期,避免将历史截图与当前动态排名混淆。
单任务成本中位数的统计边界
这组成本数据给出的单任务成本中位数约为0.20美元,同时注明实际费用随任务变化。
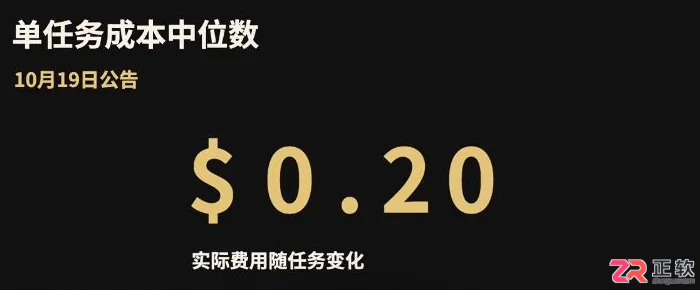
单任务成本中位数及实际费用随任务变化的说明
中位数是样本按成本排序后的中间位置统计量,不能等同于平均成本。它不是每次调用的固定收费,也不能直接用于线性推算大型项目的总预算。实际费用受具体任务及使用条件影响,现有数据不能直接确定每一类任务的费用。在评估经济性时,应结合具体业务场景的任务复杂度分布,而非仅看这一个中间值。
编程评测的具体提升幅度
在编程能力方面,官方更新日志(https://api-docs.deepseek.com/zh-cn/updates/)提供了更精确的基准测试对比。以9月10日为基准,10月17日的更新带来了显著变化:
Terminal-Bench 4.0:从31.2提升至42.3
ProgramBench:从20.3提升至29.1
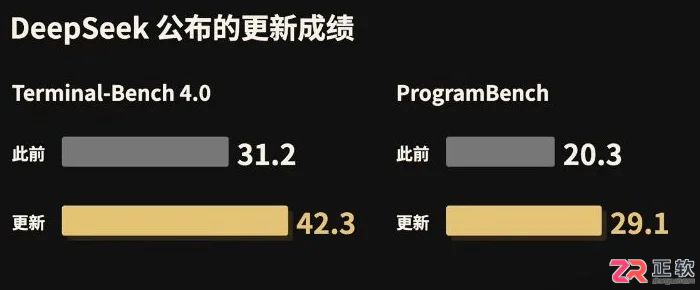
Terminal-Bench 4.0与ProgramBench更新前后的成绩对照
除了分数提升,官方还提到任务运行时间与输出长度有所缩短。这些数字反映了在标准化评测环境下的性能演进,不代表某个真实项目一定能完成或耗时一定减少。选择模型时,应将榜单排名、成本中位数和编程评测分数作为多维参考,最终仍需通过实际业务任务进行适用性检验。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
了解 Kimi K3.1 Pro 案例费用、SKY-001 零件构建耗时和 Mercury 3 测试表的限定条件,查看经核实的官方产品说明入口。
想了解Laper AI的真实工资待遇?本文教你如何通过多渠道交叉验证岗位薪资,识别招聘话术中的水分,获取更准确的收入预期参考。
解析字节旗下豆包App、火山引擎、Seedance、TRAE及飞书的定位差异。通过官方文档核对云服务、视频模型、编程工具与办公AI的功能边界,帮助读者准确选择适合的产品入口。
认识AI Agent、Genie 4与机器人的区别:任务输入不等于完成结果,世界模拟不等于现实执行,装载机动作展示也不能替代完整工程验收。
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。
本周AI领域热点集中在DeepSeek编程效率、可灵30秒视频生成及特斯拉Roadster飞行演示。本文不罗列参数,而是从普通用户视角出发,分析如何正确评估编程助手的真实成本、视频生成的控制能力以及硬件展示的落地限制,助你透过现象看本质。
了解 Harness Engineering 的核心定义及其与提示词工程、上下文工程的关系。文章通过分层视角,解释如何从问题表达、信息组织到系统搭建,全面理解智能体的运行机制。
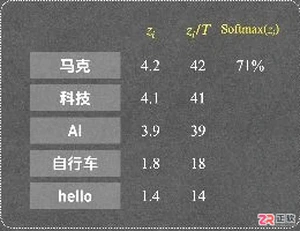
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



