

接口日志记录表怎么做?字段设计与填写方法
深入解析接口日志记录表的字段设计原则,涵盖请求头、参数、响应体、耗时等关键数据的采集与存储方法,提供可直接落地的建表代码与性能优化建议,解决线上问题排查难、数据追溯缺失的痛点。
接口日志不是简单的“把数据存下来”,而是为了在故障发生时能还原现场。很多团队设计的日志表要么字段冗余导致写入阻塞主业务,要么关键信息缺失导致无法复现Bug。日志表的核心价值在于因果链的完整性,即通过一次请求的唯一标识,串联起入口参数、处理逻辑耗时和最终出口结果。如果缺少其中任何一环,排查就变成了猜谜。
为什么你的日志表查不出问题
常见的错误设计是只记录“成功”或“失败”的状态,而忽略了上下文。当用户反馈“点击按钮没反应”时,如果日志里只有status: 500,而没有记录传入的user_id或具体的error_message,开发人员就无法判断是数据权限问题还是代码空指针。
更严重的是性能陷阱。
如果在高并发接口中同步写入包含完整Response Body的日志,数据库IO会成为瓶颈,甚至拖垮主服务。因此,字段设计必须在“信息密度”和“写入性能”之间做取舍。通常建议异步写入,且对大字段进行截断或压缩。
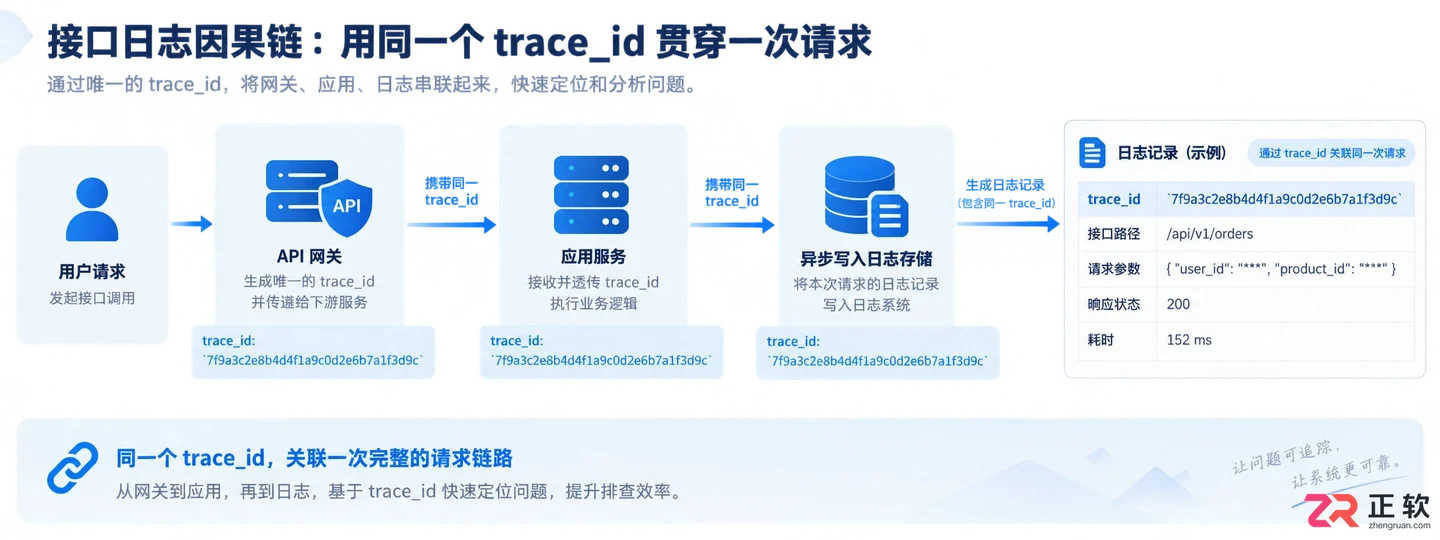
接口日志因果链示意图
核心字段设计与因果映射
一个合格的接口日志表,应当能回答“谁、在什么时候、调了什么、传了什么、回了什么、花了多久”这六个问题。以下是经过实战验证的最小必要字段集:
trace_id:全链路追踪ID。这是日志的灵魂,用于将网关日志、应用日志和数据库日志串联起来。没有它,分布式系统中的问题几乎无法定位。
api_path:接口路径。如
/api/v1/order/create,用于快速筛选特定接口的异常率。method:请求方法。GET、POST等,不同方法的参数解析方式不同,记录它有助于还原请求构造。
request_params:请求参数。对于GET请求是Query String,对于POST通常是Body。注意:需对敏感信息(如密码、身份证)进行脱敏处理,且建议限制最大长度,防止超大Payload撑爆磁盘。
response_result:响应结果。记录返回给前端的数据。同样需要脱敏和截断,通常保留前2000字符即可满足大部分排查需求。
status_code:HTTP状态码或业务状态码。区分是网络层错误(502/504)还是业务层错误(400/401)。
cost_time:耗时(毫秒)。这是性能优化的直接依据,能快速识别慢接口。
create_time:发生时间。精确到毫秒,用于时序分析。
client_ip:客户端IP。用于排查恶意攻击或特定地域的网络问题。\n\n这些字段构成了完整的因果链:
trace_id锁定范围 ->api_path定位接口 ->request_params还原输入 ->cost_time判断性能 ->response_result确认输出。
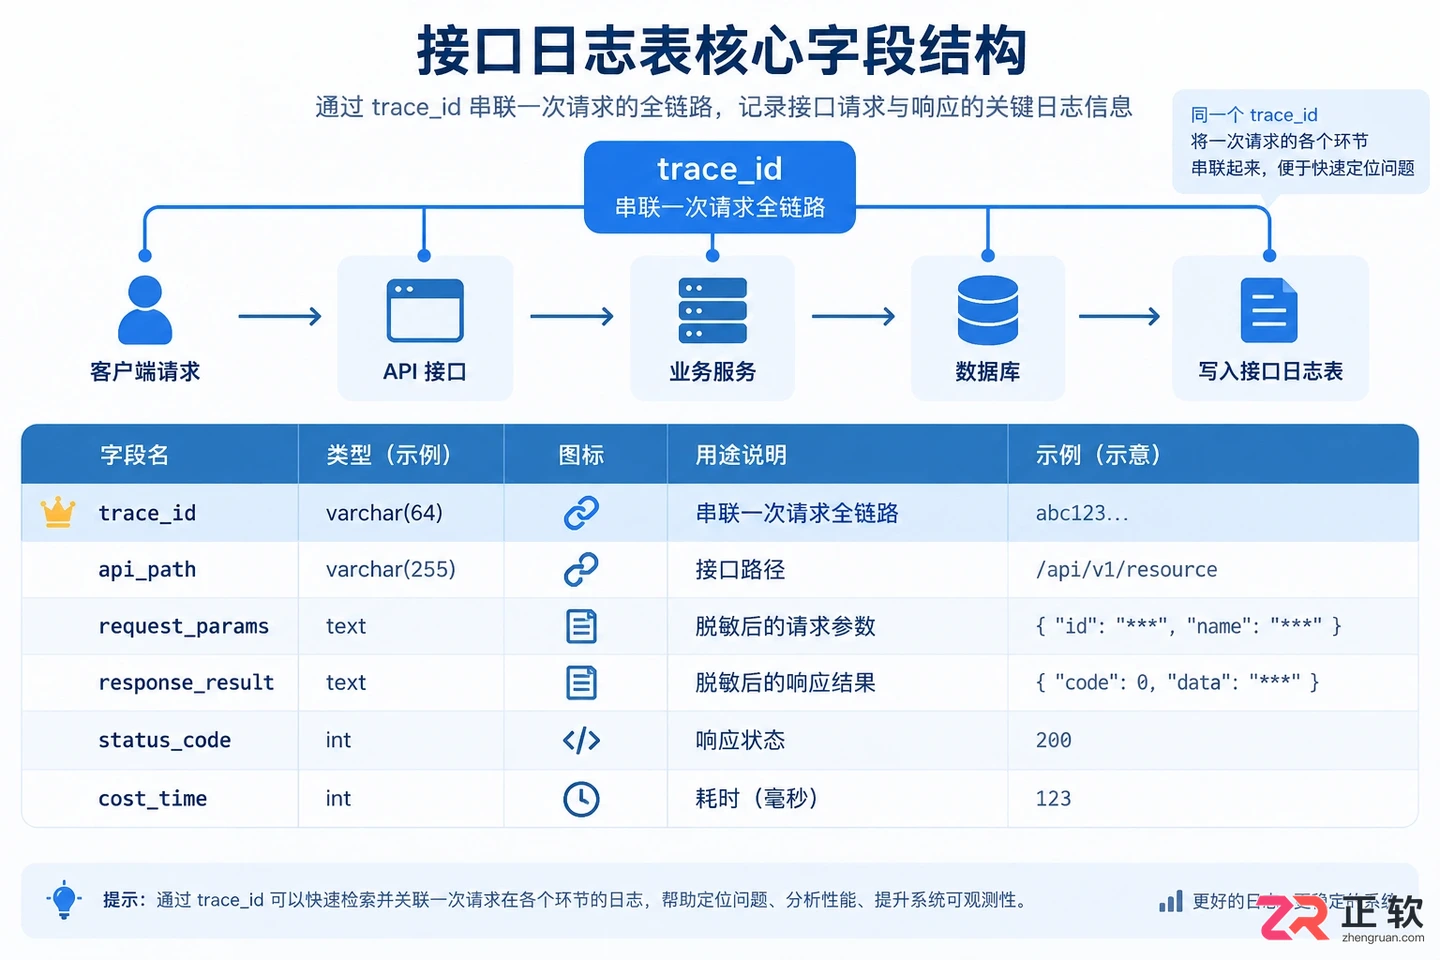
接口日志表核心字段结构图
建表语句与写入策略
基于上述设计,以下是MySQL环境下的建表示例。为了兼顾查询效率和存储空间,我们对大文本字段使用了TEXT类型,并建立了组合索引以加速常见查询。
sql
CREATE TABLE `api_request_log` (
`id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '主键ID',
`trace_id` VARCHAR(64) NOT NULL COMMENT '链路追踪ID',
`api_path` VARCHAR(255) NOT NULL COMMENT '接口路径',
`method` VARCHAR(10) NOT NULL DEFAULT 'GET' COMMENT '请求方法',
`request_params` TEXT COMMENT '请求参数,JSON格式,已脱敏',
`response_result` TEXT COMMENT '响应结果,JSON格式,已脱敏',
`status_code` INT NOT NULL COMMENT '状态码',
`cost_time` INT NOT NULL DEFAULT 0 COMMENT '耗时(ms)',
`client_ip` VARCHAR(45) DEFAULT NULL COMMENT '客户端IP',
`error_msg` VARCHAR(1000) DEFAULT NULL COMMENT '异常信息',
`create_time` DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '创建时间',
PRIMARY KEY (`id`),
KEY `idx_trace_id` (`trace_id`),
KEY `idx_api_create` (`api_path`, `create_time`)
)
ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='接口请求日志表';
在代码层面,切忌在主业务流程中同步插入这条记录。正确的做法是使用消息队列(如Kafka、RabbitMQ)或本地线程池进行异步落库。以下是一个Java Spring Boot中的简易异步写入逻辑示意:
java
@Aspect
n@Component
public class ApiLogAspect {
@Autowired\n private LogService logService;
@Around("execution(* com.example.controller.*.*(..))")
public Object recordLog(ProceedingJoinPoint joinPoint) throws Throwable {
long start = System.currentTimeMillis();
String traceId = MDC.get("traceId"); // 从MDC获取追踪ID
Object result = null;
Exception exception = null;
try {
result = joinPoint.proceed();
return result;
} catch (Exception e) {
exception = e;
throw e;\n } finally {
long cost = System.currentTimeMillis() - start;
// 异步发送日志,不阻塞主线程
logService.asyncSave(traceId, joinPoint, result, exception, cost);
}
}
}
这种设计确保了即使日志服务宕机,也不会影响核心业务的可用性。同时,通过AOP切面统一收集,避免了在每个Controller中重复编写日志代码,保持了业务逻辑的纯净。
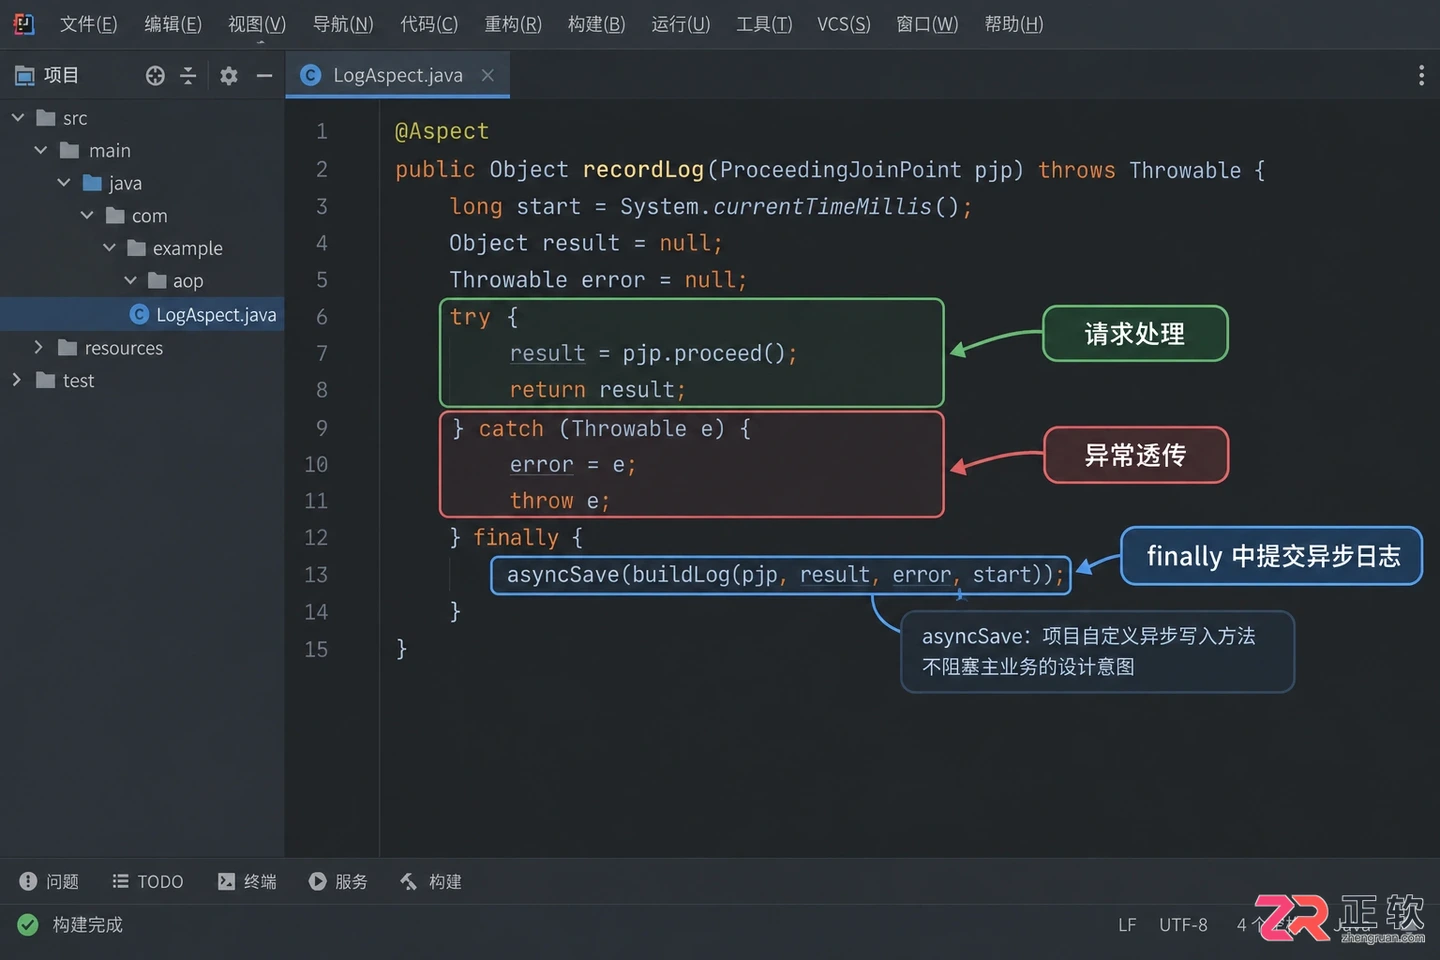
异步日志写入流程代码截图
什么时候不该这样改
虽然全量日志很有用,但并非所有场景都适用。对于高频心跳接口、文件上传下载接口或每秒万级以上的QPS接口,记录完整的Request和Response会导致存储成本激增和数据库压力过大。
在这种情况下,应采取采样策略或仅记录元数据。例如,只记录trace_id、status_code和cost_time,而不保存具体的参数和返回值。或者,将日志直接写入Elasticsearch或ClickHouse等专门的大数据存储引擎,而不是关系型数据库。
记住,日志是为了服务排查,而不是为了存储数据。 如果日志表变成了第二个业务库,那就是设计的失败。保持字段的精简和写入的异步,是让日志系统长期稳定运行的关键。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。
掌握SQL增删改核心规范:INSERT必须指定列清单以防结构变更错误;UPDATE和DELETE执行前务必通过SELECT确认WHERE条件范围;利用事务BEGIN/ROLLBACK机制实现误操作回滚。本文结合PostgreSQL语法与跨库差异,提供从语句编写到结果验证的完整安全操作流程,帮助开发者规避生产环境数据风险。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。
遇到接口分页数据对不上?本文解析page和size参数的核心设置规则,包括起始索引选择、默认值配置及异常处理,助你避开常见的分页陷阱。
深入解析Java发送JSON格式POST请求的实现机制,对比原生API与第三方库的代码差异,提供可复制的代码示例,并探讨超时设置、编码处理及微服务场景下的例外情况。
本文详解PHP中json_decode处理嵌套JSON数据的机制,对比对象与数组模式的取值差异,提供防止空指针错误的健壮代码示例,帮助开发者快速定位解析失败原因。
遇到需要给现有MySQL表增加新列的情况?本文详细解析ALTER TABLE ADD COLUMN语句的标准写法,包括如何在指定位置插入字段、设置默认值以及批量操作的技巧,助你避开锁表风险,轻松完成结构变更。
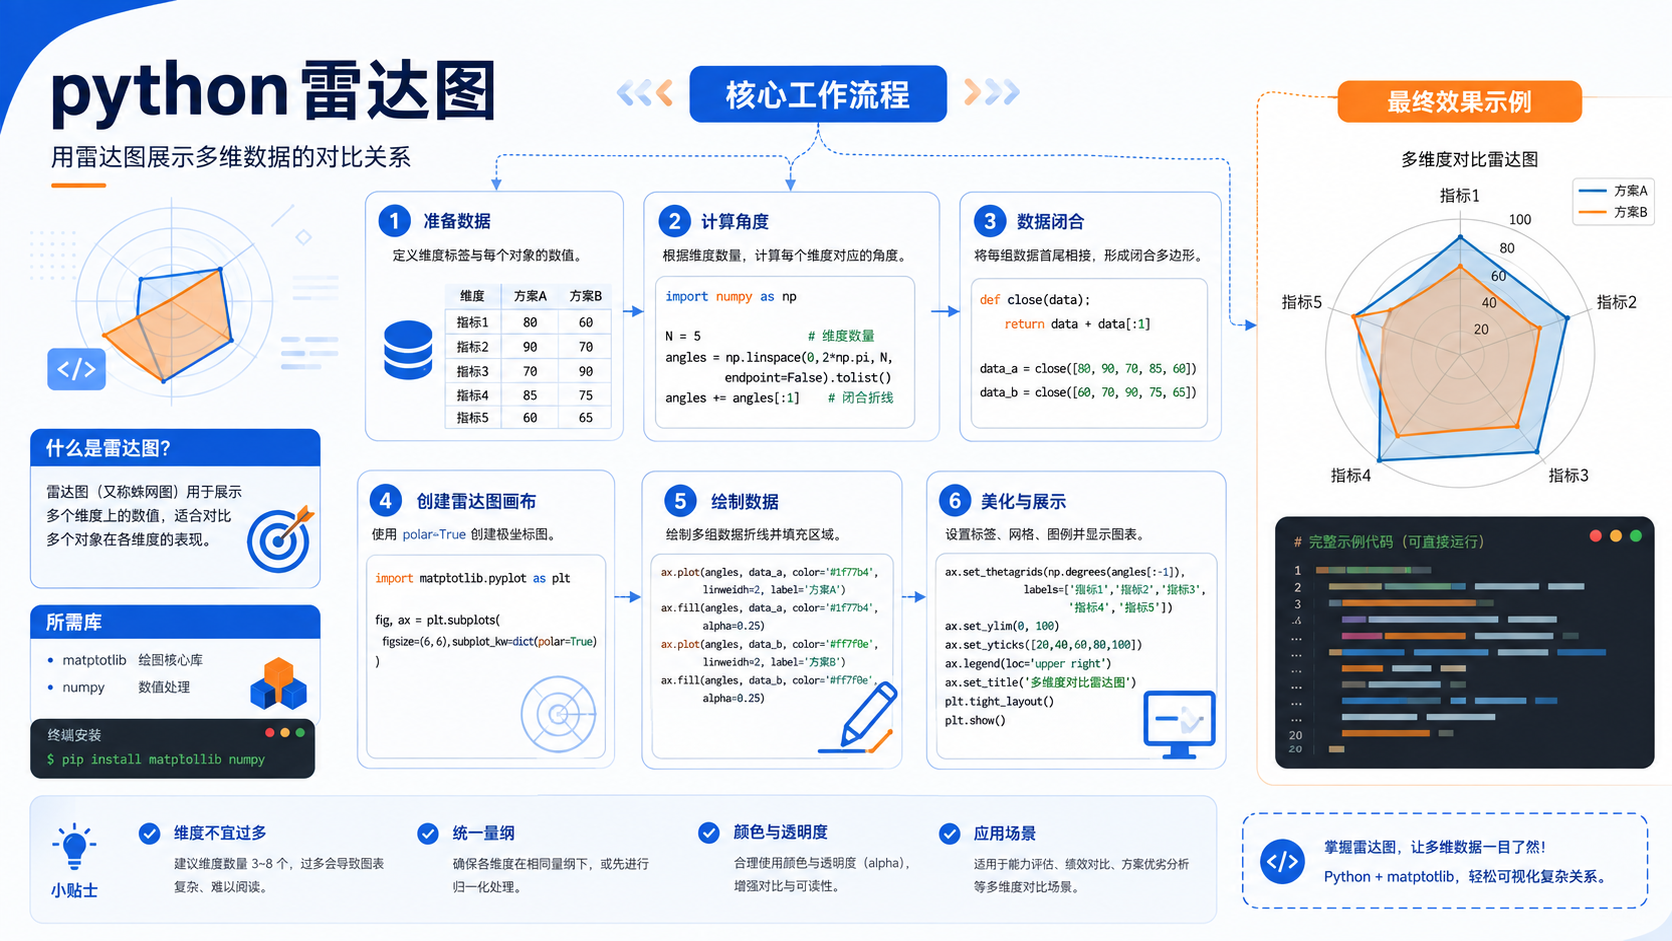
针对后端开发者的 python 雷达图实操指南。包含基于官方文档的环境准备、venv 虚拟环境创建、pip 依赖管理及验证命令,提供清晰的排错决策图与适用边界说明。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



