

NVIDIA Auto Ontology部署指南:Python服务配置与自然语言查询入门
面向希望利用NVIDIA Auto Ontology实现数据库自然语言查询的开发者,本文详解基于Docker Compose的本地部署流程。针对初次配置常遇到的环境依赖复杂、数据库连接错误及语义未编译导致查询失效等痛点,文章提供从Git克隆、.env环境变量配置、PostgreSQL连接设置到语义编译启用的完整步骤。重点强调使用独立测试库隔离生产数据风险,并通过SQL核对机制验证查询准确性,帮助用户安全搭建包含前端、后端及模型接口的全套应用服务。
先准备容器与测试数据
NVIDIA Auto Ontology 可以通过 Docker Compose 搭建本地服务,将数据目录、业务术语关系和自然语言查询整合在同一套应用中。需要注意的是,它不仅仅是一个安装后即可直接查询全部业务数据的 Python 包,首次运行还需要完成数据库、模型接口和管理账户的配置。
后端使用 Python 服务,完整应用还包括网页前端、数据导入服务和 PostgreSQL 等组件。在入门阶段,建议使用独立的测试库,避免直接连接生产业务数据库并赋予写入权限,以确保数据安全。在开始之前,请确保本地已安装 Git、可正常运行的 Docker Compose,以及符合所选模型要求的 API Key。
首先克隆项目并创建配置文件:
git clone https://github.com/NVIDIA/auto-ontology.git
cd auto-ontology
cp .env.example .env
接下来编辑 .env 文件,配置模型密钥、登录密钥、数据库密码和管理账户密码。请注意,示例中的占位值不能直接用于真实部署,各模型角色的配置也需要与实际可用的接口保持一致。
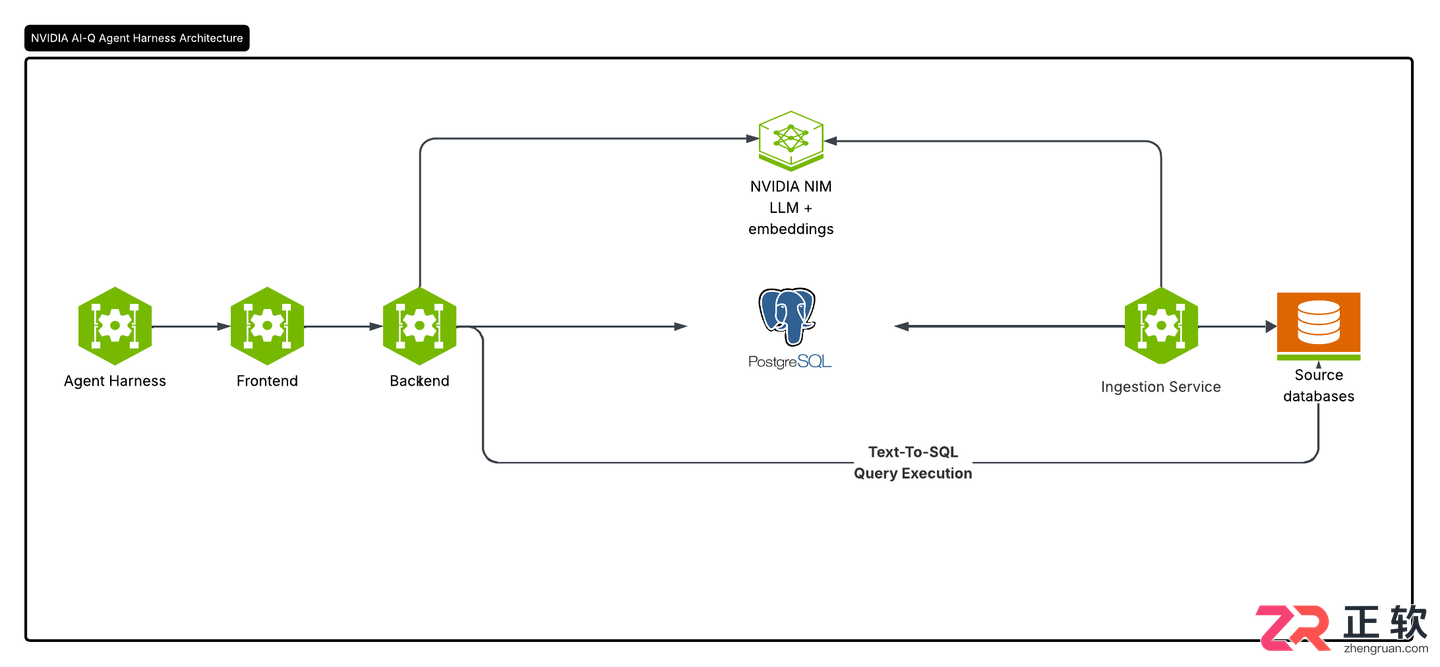
应用前端、后端、模型与数据源的关系示意
配置数据库连接再启动服务
CONNECTION_STRINGS 用于指定数据连接,需要分别核对示例数据源与自行准备的数据源配置。特别注意,容器中的 postgres 主机名、宿主机地址和远程数据库地址不能混用,否则会导致连接失败。
如果已有可用于演示的独立测试库,请先确认表结构和少量样例数据可读,然后再启动整套服务:
docker compose up -d --build
如果需要使用项目配套的示例库,应按照其数据准备流程导入到专用的空库中。严禁在已有业务库中直接运行带有清理或重建数据的命令,以免造成数据丢失。

Python Hardener
完成语义准备后再提问
服务启动后,打开本地 3000 端口对应的网页,使用 .env 中配置的管理账户登录。在 Settings 中的 Semantic Compilation 选项下启用语义编译,等待页面出现 “Semantic compilation is ready” 提示后,再进入 Chat 界面输入与测试数据有关的问题。
语义编译的作用是将字段、术语和关联关系整理为查询可用的信息。如果准备工作尚未完成,即使页面能正常打开,也不代表自然语言查询已具备可靠的数据基础。
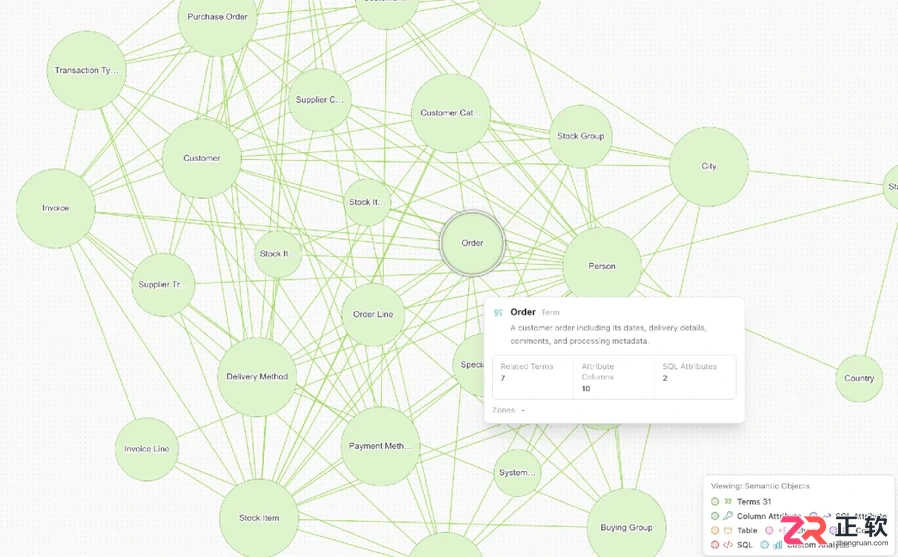
业务术语与数据关系的语义图示例
用SQL和原始记录核对答案
在进行首次提问时,问题应具体明确,例如限定时间、商品或地区,不要直接要求系统总结所有业务数据。收到回答后,务必检查返回的 SQL 语句、涉及的表和筛选条件,并与测试库中的实际结果进行比较。
数据库权限应按实际需求收紧,同时需要对模型生成的 SQL 进行审查。只有在确认样例查询可重复得到正确结果后,再逐步扩大数据范围。这种循序渐进的方式比一开始就导入完整生产数据更容易发现术语映射和连接配置中的问题。
深入解析接口日志记录表的字段设计原则,涵盖请求头、参数、响应体、耗时等关键数据的采集与存储方法,提供可直接落地的建表代码与性能优化建议,解决线上问题排查难、数据追溯缺失的痛点。
针对SQLite数据库日常查看与维护需求,详解开源主流工具DB Browser for SQLite中文绿色版的获取、解压运行、中文界面设置及核心操作验证流程。
掌握Oracle imp工具导入DMP文件的完整流程。从核对文件来源、配置连接环境,到使用参数文件预览和执行导入,最后通过SQL查询验证数据完整性。适用于Windows平台下的Oracle 19c测试环境,帮助开发者安全恢复单表数据。
学习在火山引擎 EMR 控制台中使用 AI 助手优化 SQL。涵盖如何提供准确的上下文信息、解读代码改写建议、核对业务口径以及在测试环境验证执行效率的完整流程。
详解火山引擎EMR控制台AI助手的使用流程:从对话框输入SQL与需求,获取修正建议,到在Serverless Spark SQL编辑器中验证执行结果。帮助开发者高效排查语法错误并确认业务逻辑。
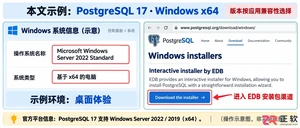
详解在 Windows Server 2022 上安装 PostgreSQL 17 的步骤,包括下载安装包、配置超级用户密码、验证 Windows 服务状态及使用 psql 进行本机连接测试,适合新手快速搭建本地数据库环境。
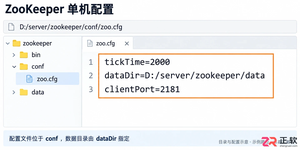
学习如何在 Windows 上部署 ZooKeeper 单机模式,通过 zkCli 命令行工具完成节点的创建、读取与删除,掌握分布式应用配置管理的基础操作流程。
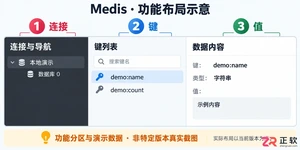
新手如何使用 Medis 管理 Redis?本文详解 Medis 界面布局,包括连接设置、键值浏览及中文语言切换步骤,帮助你快速上手这款 Redis 图形化管理工具。
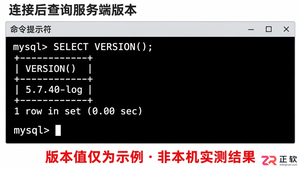
逐步指导在Windows系统上安装MySQL 5.7社区版。包括Visual C++运行库准备、MySQL Installer组件选择、服务器端口与Root密码配置、Windows服务设置及命令行连接验证。适合需要维护旧版本兼容性的开发环境。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



