

Amazon Bedrock四项请求级成本选择:缓存时长、服务层级、思考力度与输出上限
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
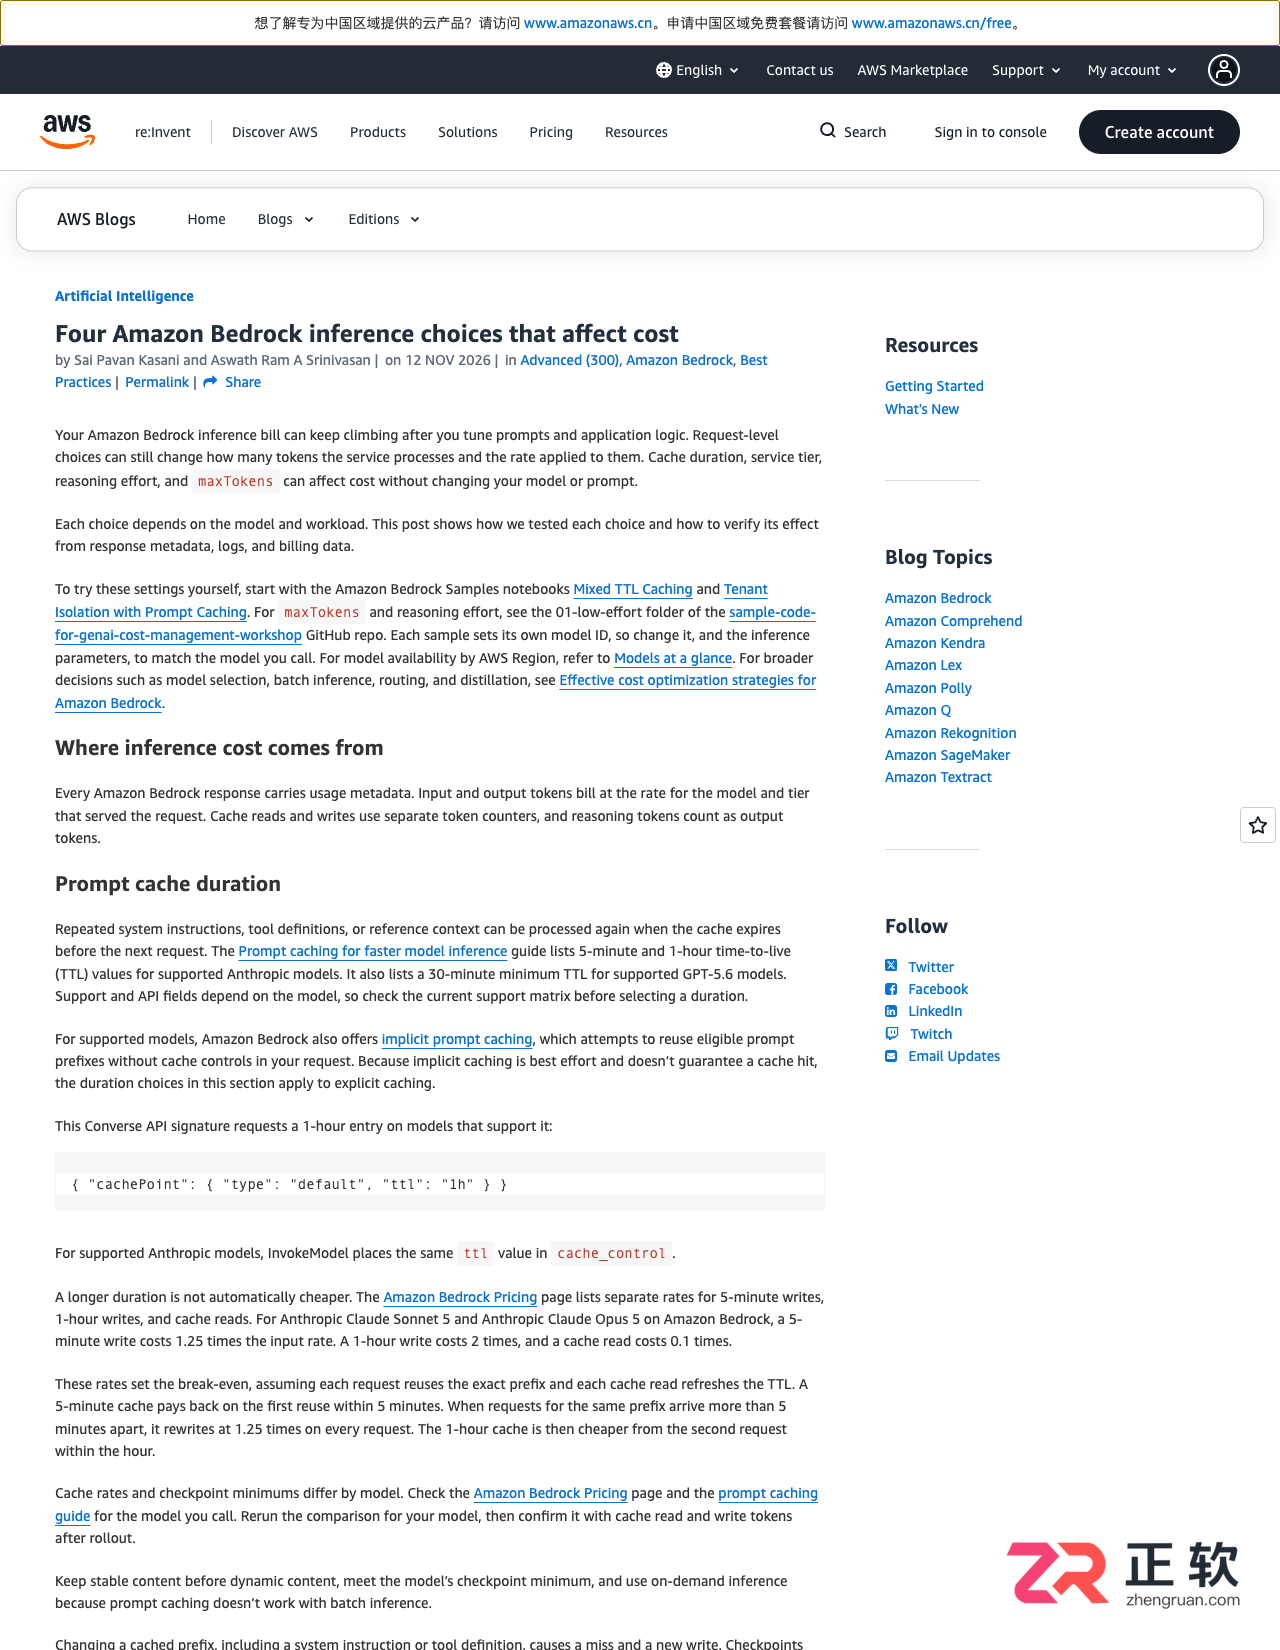
AWS新指南说明Bedrock缓存时长、服务层级、思考力度与maxTokens会怎样改变推理成本。每项均受模型和任务条件限制,应逐项比较费用、延迟与任务通过率;输出上限也可能截断正常回答,不能保证降Token而质量不变。
AWS新指南说明Bedrock缓存时长、服务层级、思考力度与maxTokens会怎样改变推理成本。每项均受模型和任务条件限制,应逐项比较费用、延迟与任务通过率;输出上限也可能截断正常回答,不能保证降Token而质量不变。
公告时间:2026年11月13日 04:51:55(北京时间)。本文记录截至2026年11月13日05:18(北京时间)的官方信息。
Bedrock为什么在提示词不变时费用也会变化
官方新指南聚焦四项请求配置:提示词缓存有效期、服务层级、思考力度和输出Token上限。它们会改变处理的Token数量或所适用费率,但效果取决于模型和工作负载。这是方法说明,不是宣布所有模型统一降价;比较时需要把完成任务的质量和延迟一起纳入。
缓存有效期怎样与复用节奏匹配
缓存收益依赖相同前缀是否在有效期内再次使用,还需核对模型支持和缓存写入、读取的计费规则。若每次上下文都变化,单纯延长有效期并不保证收益。应观察应用自己的复用间隔与成本遥测,再决定时长,不能把示例工作负载的结果套到所有请求。
依据:官方原文
服务层级应怎样兼顾费用与延迟
对能够容忍延迟的任务,可按模型支持情况评估相应服务层级;延迟敏感流量应保留适合的默认路径。官方建议核对响应中的serviceTier和CloudWatch的ResolvedServiceTier,避免只根据请求中想要的层级推断实际服务。费率应查当前官方价格页,本篇不编造固定折扣。
降低思考力度为什么必须同时测任务质量
推理Token会影响输出计费,调整effort可能减少用量,也可能影响复杂任务完成率。官方示例的成绩只对应其模型和任务,不是所有场景质量不变的证明。对于例行、边界清晰的任务,可以在代表性测试中比较较低力度;困难任务则保留能满足质量要求的配置。
maxTokens怎样控制风险又避免无效截断
maxTokens是输出上限,开启自适应思考时也需计入思考Token。过高的预留可能影响并发,过低则可能使回复因max_tokens停止,并破坏后续智能体步骤。官方建议按任务类别观察P95或P99输出分布再留余量,监控停止原因;该上限不是内容安全或提示注入防护的替代品。
如何安排一轮可解释的成本评估
先固定模型、任务集合和质量验收标准,记录基线费用、延迟、输出Token与通过率,再一次只改一个参数。检查缓存命中、实际服务层级、思考用量和截断情况,最后结合账单验证。只有任务仍达标时的成本下降才有意义;本文没有替读者运行付费试验或承诺固定节省幅度。
依据:官方原文
Amazon Bedrock四项请求级成本选择常见问题解答
降低effort就一定质量不变吗?
不能,必须用接近真实任务的样本评估完成率和错误。
设置很低的maxTokens是不是最省?
虽然可限制输出,但可能截断正常结果,导致重试或后续流程失败,需比较完整任务成本。
AWS发布按IAM主体归属Amazon Bedrock成本的原生方案,结合成本分配标签、CUR 2.0和AWS Budgets动作。预算数据每天最多刷新三次,不能视为实时硬封顶;本文说明独立角色、共享网关、标签延迟和预算执行的适用边界。
LiteLLM 1.108.7 LTS对桥接到Chat Completions的Responses专属字段返回400,除非启用drop_params或停止发送这些字段;同时修复流式MCP续轮、事件序号与Gemini计费,并增加Bedrock知识库图像检索及Gemini批处理支持。
llama.cpp b12327预发布构建加入SpacemiT Q4_1内核,b12323也从源码标签推进为可下载Release。b12324源码另调整工具运行时参数优先级;本文分别说明硬件后端、分发阶段、配置影响和升级验证,避免扩写为全平台性能提升。
Google公布五款由创作者参与打造的Flow工具,覆盖角色海报、角色年龄变化、像素风格、折射视觉与单镜头多机位。它们是创作工作流入口,不是五个新基础模型;本文说明各工具用途、适用任务和订阅、额度及一致性的核对边界。
Devin Desktop 3.12.57修复非UTF-8文件损坏、后台Markdown预览崩溃和多处模型选择及计划审批问题,同时更新Electron 43.8.8与Node 24.22.1安全版本。本文按官方更新日志说明影响范围和升级后应核对的文件、审批与模型行为。
Google GenAI Python与JavaScript SDK 3.3.0、Java SDK 2.3.0补充XHIGH思考级别、终止原因枚举和Gemini 4 Hydrogen模型枚举。SDK类型支持不等于所有模型都接受该参数;本文说明各语言差异、v3迁移和调用验证边界。
OpenAI Python 3.50.0等五种语言SDK新增Responses推理输入变换相关类型。已核实字段input_transformations记录未交给模型的推理输入及移除原因,不是请求改写开关;本文列出语言版本、字段含义和多轮应用升级核对方法。
Codex 0.170.0-alpha.3已出现官方GitHub预发布Release和下载资产,新增事实是从源码标签进入可分发阶段。它仍是Alpha预发布,官方正文没有详细功能列表;本文说明下载阶段、平台选择、校验与升级回退边界。
GitHub已于2026年11月13日03:33:54北京时间确认Webhooks API事件解决,先前约1%客户流量出现超时与错误。本文说明恢复时间线、CI与智能体工作流的投递核对方法,以及尚未公开的根因边界。
GitHub邮件投递事件已进入监控,登录和邮箱验证出现恢复,但部分上游邮件供应商托管的邮箱仍可能延迟。截至2026年11月13日05:18北京时间,官方未宣布完全恢复;本文说明受影响流程、最新范围与登录排查边界。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



