

FFmpeg Skill 3.10.2、3.11.0、3.11.1 如何选择字幕与时长处理方式?
FFmpeg Skill 3.10.2、3.11.0、3.11.1 分别修复叠词断行、增加大幅变速提醒和调整测试夹具。以 3.11.1 的命令说明裁剪与变速,避免混淆技能包和 FFmpeg 版本。
字幕叠词与大幅变速要分开处理:3.10.2 修复重复汉字的内部断行,3.11.0 为明显的整段变速增加提醒,3.11.1 则修正导出测试夹具。需要指定成片时长时,应先明确要裁掉内容,还是保留全片并改变速度。
FFmpeg Skill 三个版本的适用范围
这里介绍的 FFmpeg Skill 3.10.2、3.11.0、3.11.1 来自 kajisho5/ffmpeg-skill。它是通过本地 ffmpeg、ffprobe 工作的技能与工具脚本,并非底层 FFmpeg 程序使用了这三个版本号。三个 GitHub Release 的预发布标记都为否,但不能由发布状态推断客户端已经自动升级。
这组发布记录包含源码归档入口,自定义发布附件列表为空。源码版本与已经分发到安装渠道的包需要分别判断,不能只凭标签就宣称所有渠道到位。下文参考的是 3.11.1 完整源码,要求 Python 3.10+、FFmpeg 6.1+ 和对应的编解码器、滤镜能力,命令从源码根目录执行;单独拿到一个 fit.py 文件不等于具备整套环境。
“看看”“试试”断到两行,3.10.2 改了什么?
旧的宽度边界可能把相邻重复汉字从中间断开。修复后,重复汉字按两字成对保留,更长的连续同字可以在字对之间换行。这个变化落在共享断行逻辑上,改善的是字幕和相关文本的换行位置。
它没有承诺通用中文分词。官方合并说明明确把 V一V、AABB、ABAB 等结构排除在此次范围之外,所以不应把成对同字的修复外推到全部中文词组,更不能解释成语音识别或字幕文字纠错功能的升级。
large_speed_change 实际在提醒什么?
3.11.0 增加了这条变速诊断。fit.py 仍默认用 speed 处理目标时长;源码以原片时长除以目标时长得出倍率,严格大于 1.15 或严格小于 1/1.15 时提醒。倒数界限约为 0.8696,不是简单的 0.85。
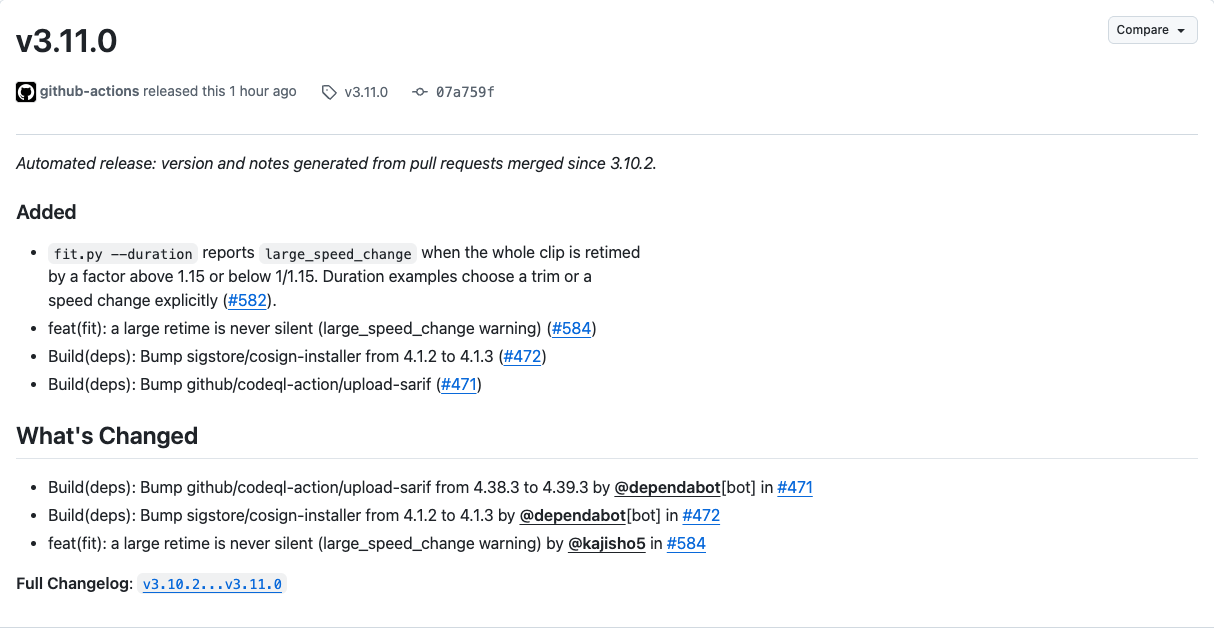
它要说明的是整段画面和声音发生了变速,没有通过删减内容来达到目标秒数,也不会自动切换成裁剪。例如 60 秒到 30 秒为 2 倍,60 秒到 90 秒约为 0.667 倍,按规则都会提醒。倍率按源时长除以目标时长计算。
两种目标分别怎样写命令?
目标是只保留前 60 秒
在 3.11.1 源码根目录使用 trim。把 input.mp4 换成实际本地视频路径;对时长超过 60 秒的有效素材,预期保留开头一分钟,而不是压缩整段播放时间。
python3 scripts/fit.py input.mp4 --duration 60 --method trim
目标是整段调整到 30 秒
确实需要全片变速时,再显式写 speed。以下命令仍从源码根目录执行,input.mp4 是素材路径占位,--json 请求结构化结果。对于有效的 60 秒输入,按源码规则应给出 large_speed_change;实际运行仍依赖输入和环境,不能把这个预期当作已经成功生成的视频。
python3 scripts/fit.py input.mp4 --duration 30 --method speed --json
若原意是删掉尾部而看到了变速提醒,可以按上一组 trim 命令明确截取目标。提醒阈值还需与 --max-speed 区分:后者默认值为 4,超出允许的倍率范围会拒绝处理;出现大幅变速提醒本身,并不能判定超过这一限制或导出一定失败。
为什么 3.11.1 不等于导出性能提升?
3.11.1 的说明仅指出为文件大小、响度测试夹具设置种子。它支持“测试夹具修正”的结论,没有提供成片更小、转码更快或响度算法增强的证据。对使用者,这组版本最直接的判断点仍是叠词断行是否符合预期,以及目标时长应该通过裁剪还是变速取得。
ffmpeg-skill 3.10.0与3.10.1对应两个连续维护版本。多片段项目的渲染与时间线导出现在按一致的画幅和帧率规则处理。遇到容器不接受的数据流时,新版会尽量只移除受影响的数据流,让符合条件的字幕仍能保留。

如何在服务器上安装PHPFFmpeg扩展?在服务器上安装PHPFFmpeg扩展可以帮助我们在PHP项目中处理音视频文件,实现音视频文件的编解码、剪辑、处理等功能。本文将介绍如何在服务器上安装PHPFFmpeg扩展,以及具体的代码示例。首先,我们需要确保服务器上已经安装了PHP以及FFmpeg。如果没有安装FFmpeg,可以按照以下步骤安装FFmpe
PHPFFmpeg扩展是用于处理音视频文件的功能强大的工具,它可以让我们在PHP中处理各种音视频格式的文件,比如截取视频、合并音视频等。本文将分享PHPFFmpeg扩展的安装技巧以及注意事项,帮助读者更好地使用这个强大的工具。一、安装FFmpeg要使用PHPFFmpeg扩展,首先需要在服务器上安装FFmpeg。安装FFmpeg的步骤如下:使用SSH登
php如何使用PHP的ffmpeg扩展?随着互联网的发展和视频技术的不断完善,视频在我们的生活中扮演着越来越重要的角色。但是,当前视频处理和编辑的需求也在不断增加,这就需要我们使用到一些专业的工具来帮助我们完成这项工作。其中,ffmpeg是一个非常流行的视频处理工具,它支持多种视频编解码格式,可以对视频进行编辑、剪切、转码等操作。而PHP的ffmpeg扩展则
PHPFFmpeg扩展安装指南:简单易懂的教程在网站开发的过程中,有时候我们需要处理各种多媒体文件,比如音频、视频等。而FFmpeg是一个功能强大的多媒体处理工具,它可以处理音频、视频等多种格式,并且支持各种转码、剪切等操作。PHPFFmpeg扩展则是在PHP中调用FFmpeg功能的扩展库,使用它可以很方便地处理多媒体文件。下面我们将详细介绍PHPF
在现代互联网时代,视频内容已经成为人们生活中不可或缺的一部分。而对于开发人员来说,处理视频文件是经常遇到的工作之一。PHP语言作为一种广泛应用于Web开发的语言,在处理视频文件时也发挥着重要作用。而要更高效地处理视频文件,使用FFmpeg扩展是一种常见的选择。本文将介绍如何从零开始学习安装PHPFFmpeg扩展,并提供具体的代码示例。1.什
随着网络视频的流行,视频处理成为了重要的技术之一。而FFmpeg作为一个跨平台的开源多媒体框架,能够处理音频、视频和图片等多种格式的文件,是视频处理方面的利器之一。本文将介绍如何在PHP中使用FFmpeg进行视频处理。一、安装FFmpeg在使用FFmpeg之前,需要先安装它。在Linux系统下,可以通过终端输入以下命令进行安装:sudoapt-getin
要使用python中的FFmpeg库,可以使用ffmpy库或subprocess库。使用ffmpy库的示例代码如下:fromffmpyimportFFmpeginput_file='input.mp4'output_file='output.avi'ff=FFmpeg(inputs={input_file:None},outputs={output_file:'-c:vmpeg4-b:v800k'})ff.run()使用subprocess库的示
Golang与FFmpeg:如何实现音频混音和分离,需要具体代码示例摘要:音频处理是许多多媒体应用程序中必不可少的一部分。在Golang中,我们可以使用FFmpeg库来实现音频的混音和分离。本文将介绍如何使用Golang调用FFmpeg库来实现音频混音和分离,并提供了具体的代码示例。通过学习本文,读者将了解到如何使用Golang和FFmpeg来实现音频处理





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



