

抖音IP属地查询方法详解
1.背景最近发现抖音上线了IP属地功能,用户在发表动态、评论和聊天时会显示自己的IP属地信息。这个功能的核心意义是增加用户真实性,减少虚假欺骗。正好我最近在开发获取客户端IP的功能,用于接口限流、黑白名单等需求。顺便研究了一下如何解析IP获取归属地的问题。接下来,就着重讲解一下Java后端怎么实现IP归属地的功能,其实只需要以下两大步骤:2.获取客户端ip接口做过web开发的人都明白,不管是移动端还是pc端,请求接口都会被封装成HttpServletRequest对象。这个对象包含了客户端请求的各种信息,

1.背景
最近发现抖音上线了IP属地功能,用户在发表动态、评论和聊天时会显示自己的IP属地信息。这个功能的核心意义是增加用户真实性,减少虚假欺骗。正好我最近在开发获取客户端IP的功能,用于接口限流、黑白名单等需求。顺便研究了一下如何解析IP获取归属地的问题。
接下来,就着重讲解一下Java后端怎么实现IP归属地的功能,其实只需要以下两大步骤:
2.获取客户端ip接口
做过web开发的人都明白,不管是移动端还是pc端,请求接口都会被封装成HttpServletRequest对象。这个对象包含了客户端请求的各种信息,比如请求地址、参数和提交的数据等等。
如果服务器直接把IP暴漏出去,那么request.getRemoteAddr()就能拿到客户端ip。
目前流行的架构中,大多数服务器都不直接暴露自己的IP地址,而是通过一层或多层反向代理来处理请求。常见的反向代理工具是nginx。通过引入代理,服务器和客户端之间会增加一层,因此使用request.getRemoteAddr()方法获取的IP地址将是代理服务器的IP地址,而不是客户端的IP地址。为了追踪原始客户端的IP地址,通常会在转发头中添加X-Forwarded-For等信息。这些信息可以用来确定请求的真实来源。
X-Forwarded-For是一个由Squid开发的字段,在通过HTTP代理或负载均衡服务器时才会添加。它的格式为X-Forwarded-For:client1,proxy1,proxy2。通常情况下,第一个IP地址是客户端的真实IP,后面的IP地址是经过的代理服务器的IP。根据上面的代码注释,可以直接截取第一个IP地址。 Proxy-Client-IP/WL-Proxy-Client-IP是经过Apache HTTP服务器请求时才会存在的头部。当使用Apache HTTP做代理时,通常会添加Proxy-Client-IP请求头,而WL-Proxy-Client-IP是WebLogic插件添加的头部。在这种情况下,也可以直接获取到这些头部信息。 HTTP_CLIENT_IP是一些代理服务器可能添加的请求头。 X-Real-IP通常是由Nginx使用的请求头。
日常开发中未明确规定用哪个头信息跟踪客户端,需逐一尝试,直到获取到为止。下为相应代码:
ini
复制代码
@Slf4jpublic class IpUtils { private static final String UNKNOWN_VALUE = “unknown”; private static final String LOCALHOST_V4 = “127.0.0.1”; private static final String LOCALHOST_V6 = “0:0:0:0:0:0:0:1”; private static final String X_FORWARDED_FOR = “X-Forwarded-For”; private static final String X_REAL_IP = “X-Real-IP”; private static final String PROXY_CLIENT_IP = “Proxy-Client-IP”; private static final String WL_PROXY_CLIENT_IP = “WL-Proxy-Client-IP”; private static final String HTTP_CLIENT_IP = “HTTP_CLIENT_IP”; private static final String IP_DATA_PATH = ”
/Users/shepherdmy/Desktop/ip2region.xdb”; private static byte[] contentBuff; /** * 获取客户端ip地址 * @param request * @return */ public static String getRemoteHost(HttpServletRequest request) { String ip = request.getHeader(X_FORWARDED_FOR); if (StringUtils.isNotEmpty(ip) && !
UNKNOWN_VALUE.equalsIgnoreCase(ip)) { // 多次反向代理后会有多个ip值,第一个ip才是真实ip int index = ip.indexOf(“,”); if (index != -1) { return ip.substring(0, index); } else { return ip; } }ip = request.getHeader(X_REAL_IP); if (StringUtils.isNotEmpty(ip) && !
UNKNOWN_VALUE.equalsIgnoreCase(ip)) { return ip; } if (StringUtils.isBlank(ip) ||
UNKNOWN_VALUE.equalsIgnoreCase(ip)) {ip = request.getHeader(PROXY_CLIENT_IP); } if (StringUtils.isBlank(ip) ||
UNKNOWN_VALUE.equalsIgnoreCase(ip)) {ip = request.getHeader(WL_PROXY_CLIENT_IP); } if (StringUtils.isBlank(ip) ||
UNKNOWN_VALUE.equalsIgnoreCase(ip)) {ip = request.getRemoteAddr(); } if (StringUtils.isBlank(ip) ||
UNKNOWN_VALUE.equalsIgnoreCase(ip)) {ip = request.getHeader(HTTP_CLIENT_IP); } if (StringUtils.isBlank(ip) ||
UNKNOWN_VALUE.equalsIgnoreCase(ip)) {ip = request.getRemoteAddr(); } return ip.equals(LOCALHOST_V6) ? LOCALHOST_V4 : ip; } }
项目推荐:基于SpringBoot2.x、SpringCloud和SpringCloudAlibaba企业级系统架构底层框架封装,解决业务开发时常见的非功能性需求,防止重复造轮子,方便业务快速开发和企业技术栈框架统一管理。引入组件化的思想实现高内聚低耦合并且高度可配置化,做到可插拔。严格控制包依赖和统一版本管理,做到最少化依赖。注重代码规范和注释,非常适合个人学习和企业使用
Github地址:github.com/plasticene/…
Gitee地址:gitee.com/plasticene3…
微信公众号:Shepherd进阶笔记
交流探讨群:Shepherd_126
3.获取ip归属地
通过上面我们就能获取到客户端用户的ip地址,接下来就可以通过ip解析获取归属地了。
如果我们在网上搜索资料教程,大部分都是说基于各大平台(eg:淘宝,新浪)提供的ip库进行查询,不过不难发现这些平台已经不怎么维护这个功能,现在处于“半死不活”的状态,根本不靠谱,当然有些平台提供可靠的获取ip属地接口,但是收费、收费、收费。
本着作为一个程序员的严谨:“能白嫖的就白嫖,避免出现要买的是你,不会用也是你的尴尬遭遇”。扯远了言归正传,为了寻求可靠有效的解决方案,只能去看看github有没有什么项目能满足需求,果然功夫不负有心人,发现一个宝藏级项目:ip2region,一个准确率 99.9% 的离线 IP 地址定位库,0.0x 毫秒级查询,ip2region.db 数据库只有数 MB的项目,提供了众多主流编程语言的 xdb 数据生成和查询客户端实现,这里只能说:开源真香,开源万岁。
3.1 Ip2region 特性
标准化的数据格式
每个 ip 数据段的 region 信息都固定了格式:国家|区域|省份|城市|ISP,只有中国的数据绝大部分精确到了城市,其他国家部分数据只能定位到国家,其余选项全部是0。
数据去重和压缩
xdb 格式生成程序会自动去重和压缩部分数据,默认的全部 IP 数据,生成的 ip2region.xdb 数据库是 11MiB,随着数据的详细度增加数据库的大小也慢慢增大。
极速查询响应
即使是完全基于 xdb 文件的查询,单次查询响应时间在十微秒级别,可通过如下两种方式开启内存加速查询:
vIndex 索引缓存 :使用固定的 512KiB 的内存空间缓存 vector index 数据,减少一次 IO 磁盘操作,保持平均查询效率稳定在10-20微秒之间。xdb 整个文件缓存:将整个 xdb 文件全部加载到内存,内存占用等同于 xdb 文件大小,无磁盘 IO 操作,保持微秒级别的查询效率。IP 数据管理框架
v2.0 格式的 xdb 支持亿级别的 IP 数据段行数,region 信息也可以完全自定义,例如:你可以在 region 中追加特定业务需求的数据,例如:GPS信息/国际统一地域信息编码/邮编等。也就是你完全可以使用 ip2region 来管理你自己的 IP 定位数据。
99.9% 准确率
数据聚合了一些知名 ip 到地名查询提供商的数据,这些是他们官方的的准确率,经测试着实比经典的纯真 IP 定位准确一些。
ip2region 的数据聚合自以下服务商的开放 API 或者数据(升级程序每秒请求次数 2 到 4 次):
01,>80%,淘宝IP地址库,ip.taobao.com/%5C02,≈10%,GeoIP,geoip.com/%5C03,≈2%,纯真 IP 库,www.cz88.net/%5C备注:如果上述开放 API 或者数据都不给开放数据时 ip2region 将停止数据的更新服务。
3.2 整合Ip2region客户端进行查询
提供了众多主流编程语言的 xdb 数据生成和查询客户端实现,已经集成的客户端有:java、C#、php、c、python、nodejs、php扩展(php5 和 php7)、golang、rust、lua、lua_c,nginx。这里讲一下java的客户端。
首先我们需要引入依赖:
xml
复制代码
org.lionsoulip2region2.6.5
接下来我们需要先去下载数据文件ip2region.xdb到本地,然后基于数据文件进行查询,下面查询方法文件路径改为你本地路径即可,ip2region提供三种查询方式:
完全基于文件的查询
java
复制代码
import
org.lionsoul.ip2region.xdb.Searcher;import java.io.*;import
java.util.concurrent.TimeUnit;publicclassSearcherTest {publicstaticvoidmain(String[] args) {// 1、创建 searcher 对象StringdbPath=”ip2region.xdb file path”;Searchersearcher=null;try { searcher = Searcher.newWithFileOnly(dbPath); } catch (IOException e) { System.out.printf(“failed to create searcher with `%s`: %s\\n”, dbPath, e);return; }// 2、查询try {Stringip=”1.2.3.4″;longsTime= System.nanoTime();Stringregion= searcher.search(ip);longcost=
TimeUnit.NANOSECONDS.toMicros((long) (System.nanoTime() – sTime)); System.out.printf(“{region: %s, ioCount: %d, took: %d μs}\\n”, region, searcher.getIOCount(), cost); } catch (Exception e) { System.out.printf(“failed to search(%s): %s\\n”, ip, e); }// 3、关闭资源 searcher.close();// 备注:并发使用,每个线程需要创建一个独立的 searcher 对象单独使用。 }}
缓存 VectorIndex 索引
我们可以提前从 xdb 文件中加载出来 VectorIndex 数据,然后全局缓存,每次创建 Searcher 对象的时候使用全局的 VectorIndex 缓存可以减少一次固定的 IO 操作,从而加速查询,减少 IO 压力。
java
复制代码
import
org.lionsoul.ip2region.xdb.Searcher;import java.io.*;import
java.util.concurrent.TimeUnit;publicclassSearcherTest {publicstaticvoidmain(String[] args) {StringdbPath=”ip2region.xdb file path”;// 1、从 dbPath 中预先加载 VectorIndex 缓存,并且把这个得到的数据作为全局变量,后续反复使用。byte[] vIndex;try { vIndex =
Searcher.loadVectorIndexFromFile(dbPath); } catch (Exception e) { System.out.printf(“failed to load vector index from `%s`: %s\\n”, dbPath, e);return; }// 2、使用全局的 vIndex 创建带 VectorIndex 缓存的查询对象。 Searcher searcher;try { searcher =
Searcher.newWithVectorIndex(dbPath, vIndex); } catch (Exception e) { System.out.printf(“failed to create vectorIndex cached searcher with `%s`: %s\\n”, dbPath, e);return; }// 3、查询try {Stringip=”1.2.3.4″;longsTime= System.nanoTime();Stringregion= searcher.search(ip);longcost=
TimeUnit.NANOSECONDS.toMicros((long) (System.nanoTime() – sTime)); System.out.printf(“{region: %s, ioCount: %d, took: %d μs}\\n”, region, searcher.getIOCount(), cost); } catch (Exception e) { System.out.printf(“failed to search(%s): %s\\n”, ip, e); }// 4、关闭资源 searcher.close();// 备注:每个线程需要单独创建一个独立的 Searcher 对象,但是都共享全局的制度 vIndex 缓存。 }}
缓存整个 xdb 数据
我们也可以预先加载整个 ip2region.xdb 的数据到内存,然后基于这个数据创建查询对象来实现完全基于文件的查询,类似之前的 memory search。
java
复制代码
import
org.lionsoul.ip2region.xdb.Searcher;import java.io.*;import
java.util.concurrent.TimeUnit;publicclassSearcherTest {publicstaticvoidmain(String[] args) {StringdbPath=”ip2region.xdb file path”;// 1、从 dbPath 加载整个 xdb 到内存。byte[] cBuff;try { cBuff =
Searcher.loadContentFromFile(dbPath); } catch (Exception e) { System.out.printf(“failed to load content from `%s`: %s\\n”, dbPath, e);return; }// 2、使用上述的 cBuff 创建一个完全基于内存的查询对象。 Searcher searcher;try { searcher = Searcher.newWithBuffer(cBuff); } catch (Exception e) { System.out.printf(“failed to create content cached searcher: %s\\n”, e);return; }// 3、查询try {Stringip=”1.2.3.4″;longsTime= System.nanoTime();Stringregion= searcher.search(ip);longcost=
TimeUnit.NANOSECONDS.toMicros((long) (System.nanoTime() – sTime)); System.out.printf(“{region: %s, ioCount: %d, took: %d μs}\\n”, region, searcher.getIOCount(), cost); } catch (Exception e) { System.out.printf(“failed to search(%s): %s\\n”, ip, e); }// 4、关闭资源 – 该 searcher 对象可以安全用于并发,等整个服务关闭的时候再关闭 searcher// searcher.close();// 备注:并发使用,用整个 xdb 数据缓存创建的查询对象可以安全的用于并发,也就是你可以把这个 searcher 对象做成全局对象去跨线程访问。 }}
3.3 springboot整合示例
首先我们也需要像上面一样引入maven依赖。然后就可以基于上面的查询方式进行封装成工具类了,我这里选择了上面的第三种方式:缓存整个 xdb 数据
ini
复制代码
@Slf4jpublic class IpUtils { private static final String IP_DATA_PATH = ”
/Users/shepherdmy/Desktop/ip2region.xdb”; private static byte[] contentBuff; static { try { // 从 dbPath 加载整个 xdb 到内存。contentBuff =
Searcher.loadContentFromFile(IP_DATA_PATH); } catch (IOException e) { e.printStackTrace(); } } /** * 根据ip查询归属地,固定格式:中国|0|浙江省|杭州市|电信 * @param ip * @return */ public static IpRegion getIpRegion(String ip) { Searcher searcher = null; IpRegion ipRegion = new IpRegion(); try {searcher = Searcher.newWithBuffer(contentBuff); String region = searcher.search(ip); String[]info = StringUtils.split(region, “|”); ipRegion.setCountry(info[0]); ipRegion.setArea(info[1]); ipRegion.setProvince(info[2]); ipRegion.setCity(info[3]); ipRegion.setIsp(info[4]); } catch (Exception e) { log.error(“get ip region error: “, e); } finally { if (searcher != null) { try { searcher.close(); } catch (IOException e) { log.error(“close searcher error:”, e); } } } return ipRegion; }}
本文指导After Effects新手完成从打开软件到制作简单动画的完整流程。内容涵盖新建合成、导入素材、添加关键帧及预览验证,适用于AE基础学习。读者可依据步骤快速完成首个可播放的动效项目。
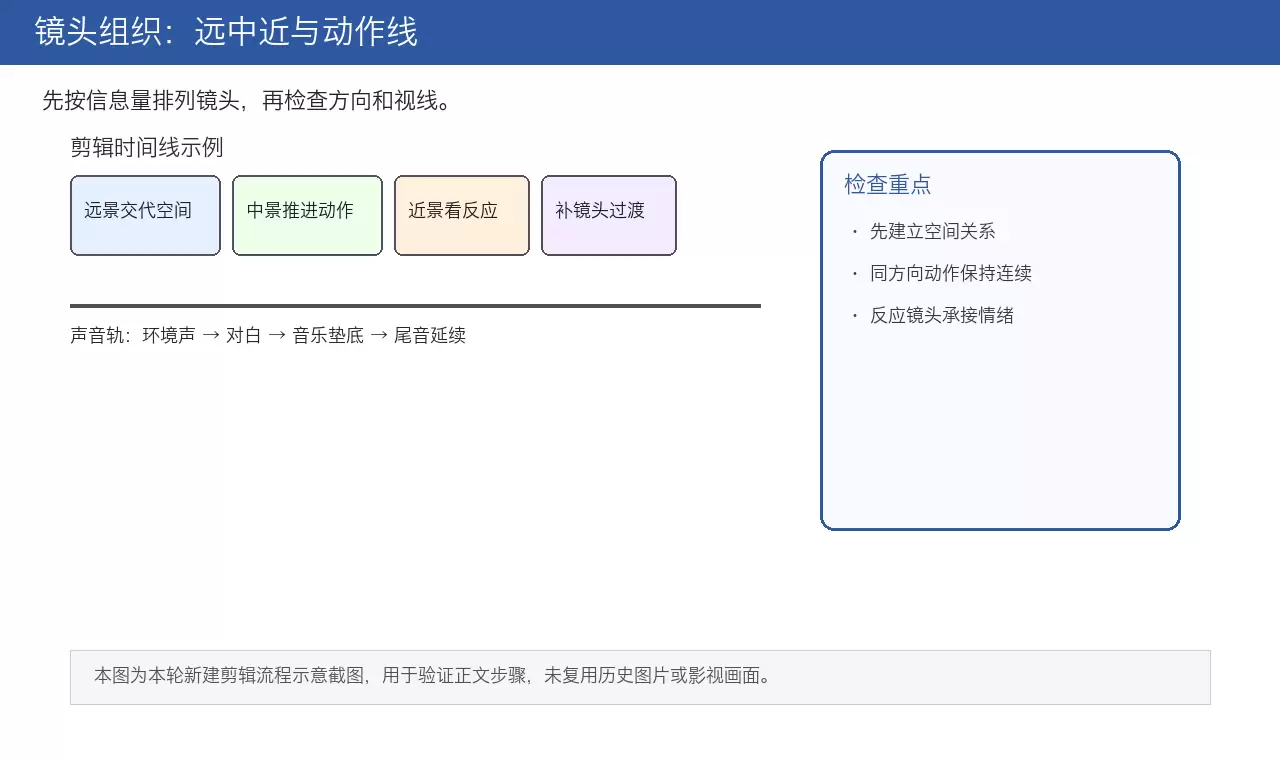
本文详解电影剪辑核心流程,从素材整理、镜头空间组织到叙事节奏压缩,再到J-cut/L-cut声音衔接技巧。通过粗剪保逻辑、精剪压停顿、反应镜头缓冲及电平统一检查,帮助创作者打造空间清晰、情绪连贯且听感自然的成片。
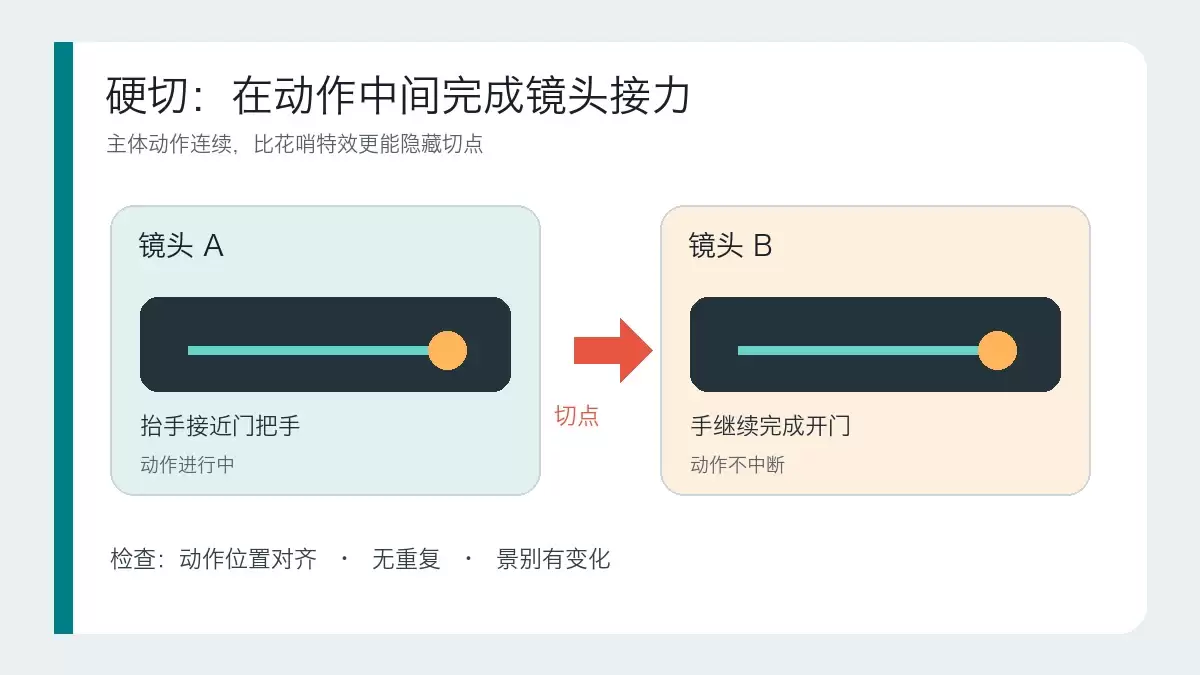
本文详解硬切、遮挡转场和运镜转场的适用场景与操作逻辑。通过对比三种转场的核心区别,提供基于素材条件和叙事目的的判断标准,帮助剪辑师避免滥用特效,掌握自然衔接画面的实战技巧。
本文指导GitLab新手完成创建项目并推送第一次提交的最小闭环。涵盖远程项目创建、本地仓库初始化、添加远程地址及执行git push。重点说明HTTPS与SSH认证差异、分支名(master/main)核对及提交验证标准,确保远程仓库真正建立。
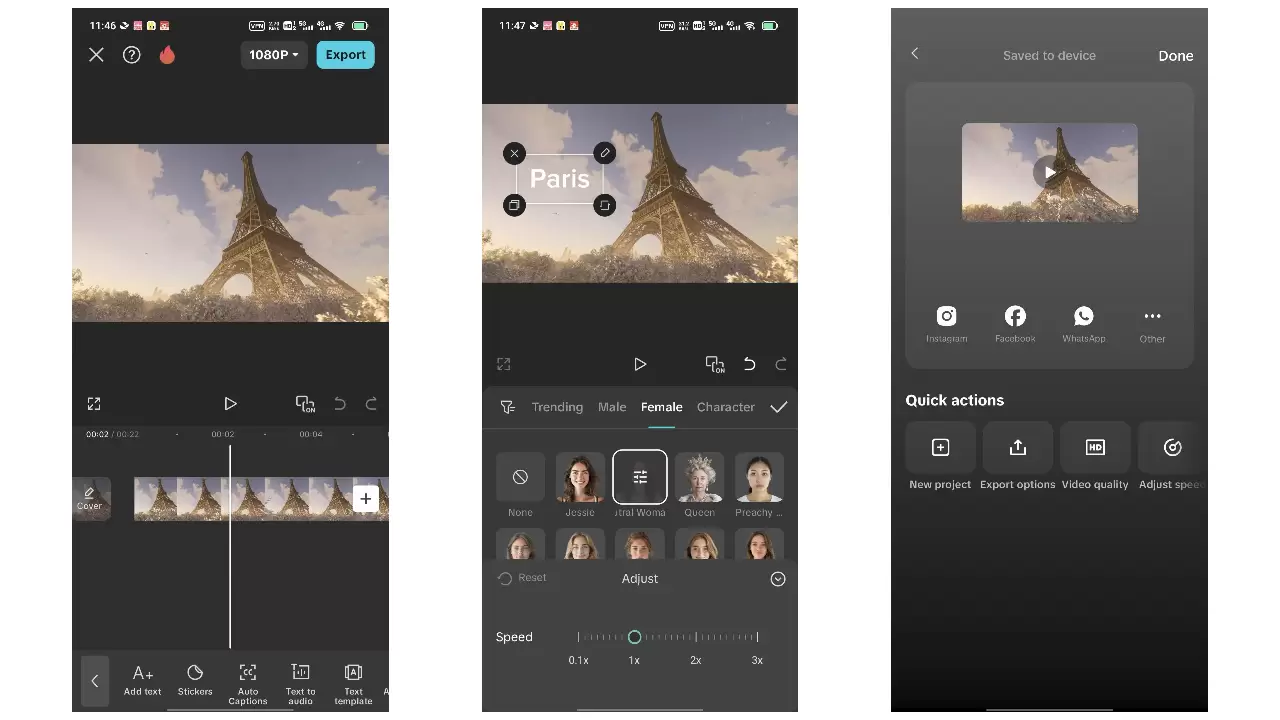
本教程针对抖音竖屏视频制作,涵盖拍摄前构思、稳定运镜、粗剪筛选、音乐卡点及导出检查全流程。重点在于拍摄时预留字幕空间、利用动作节点辅助剪辑,以及通过鼓点对齐画面。适用于新手快速完成第一条完整成片,强调素材质量与节奏自然,避免过度特效与版权风险。
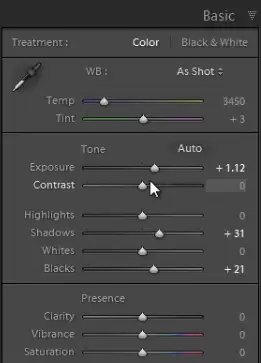
针对饭圈舞台照光线乱、噪点多、背景抢眼的痛点,本文提供“保脸、控光、突出主体”的修图方案。核心步骤包括:利用Lightroom降噪面板处理高ISO颗粒,控制曝光避免高光死白或脸部死黑;通过压低背景色彩、提升人物亮度与对比度来修正舞台灯光导致的肤色偏差;最后通过裁剪去除杂乱元素,确保人物主体清晰且肤色自然。
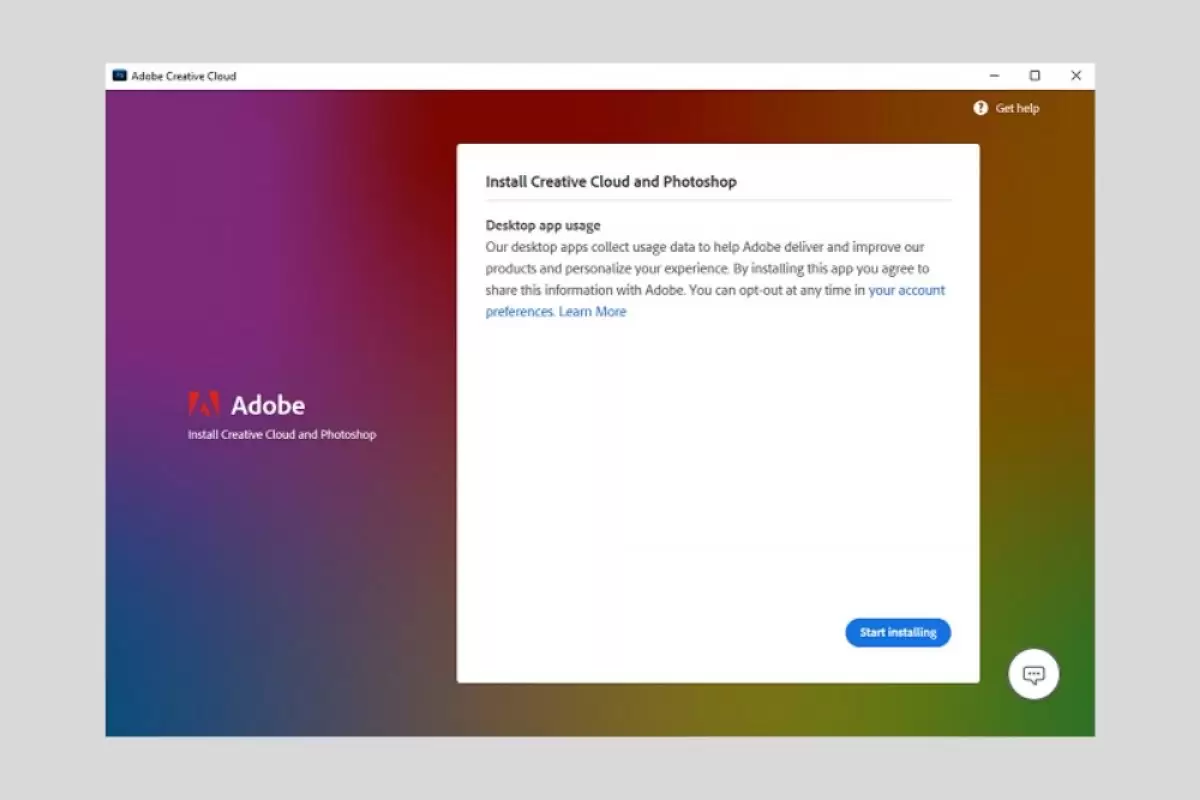
本文提供Photoshop完整安装指南,涵盖Windows/macOS系统要求、Creative Cloud客户端部署及常见启动故障排查。通过安装前磁盘与账号检查、安装中网络监控、安装后功能测试三步法,解决安装中断、登录失败及启动卡顿问题,确保软件稳定可用。
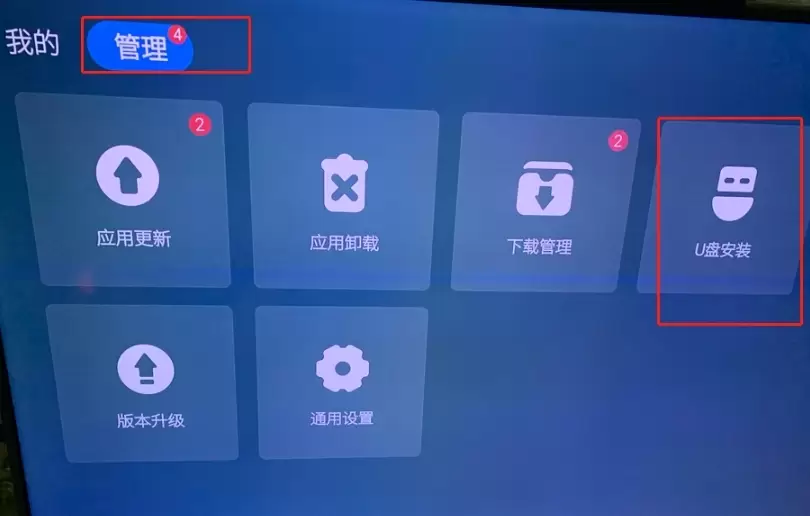
本文提供创维电视通过U盘安装第三方APK的完整操作指南。核心步骤包括:准备格式化的U盘与正规APK文件,在酷开系统“应用管理”中找到安装入口,临时开启“允许安装未知来源应用”权限,以及安装后的功能测试与权限关闭。适用于解决电视无法识别U盘、提示解析失败或权限受限等问题,确保安装安全且不影响系统稳定。
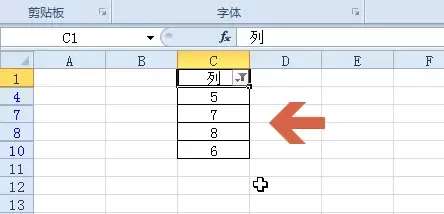
本教程演示如何在Excel中筛选大于指定数值的数据。核心步骤包括:确保数据连续、选中表头、通过“开始→排序和筛选”开启筛选,并在“数字筛选”中选择“大于”输入阈值。筛选仅隐藏不符合条件的行,不删除数据。完成后需逐行验证可见数据是否均大于阈值,并可通过取消筛选恢复全部数据。
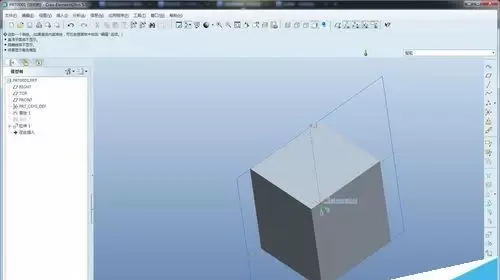
本教程指导Creo初学者完成首个拉伸实体建模。通过新建零件、选择mmns_part_solid模板、定义草绘平面及绘制封闭轮廓,生成三维实体。内容涵盖操作路径、参数设置及常见错误排查,帮助新手建立正确的建模逻辑与单位概念。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
