

【Python NLTK】文本分类,轻松搞定文本归类难题
文本分类是自然语言处理(NLP)任务之一,它旨在将文本归类到预定义的类别中。文本分类有很多实际应用,例如电子邮件过滤、垃圾邮件检测、情感分析和问答系统等。使用pythonNLTK库完成文本分类的任务可以分为以下几个步骤:数据预处理:首先,需要对数据进行预处理,包括去除标点符号、转换成小写、去除空格等。特征提取:接下来,需要从预处理后的文本中提取特征。特征可以是词语、词组或句子。模型训练:然后,需要使用提取的特征来训练一个分类模型。通常使用的分类模型包括朴素贝叶斯、支持向量机和决策树等。评估:最后,需要对训
文本分类是自然语言处理(NLP)任务之一,它旨在将文本归类到预定义的类别中。文本分类有很多实际应用,例如电子邮件过滤、垃圾邮件检测、情感分析和问答系统等。
使用python NLTK库完成文本分类的任务可以分为以下几个步骤:
- 数据预处理:首先,需要对数据进行预处理,包括去除标点符号、转换成小写、去除空格等。
- 特征提取:接下来,需要从预处理后的文本中提取特征。特征可以是词语、词组或句子。
- 模型训练:然后,需要使用提取的特征来训练一个分类模型。通常使用的分类模型包括朴素贝叶斯、支持向量机和决策树等。
- 评估:最后,需要对训练好的模型进行评估,以衡量其性能。
下面是一个使用Python NLTK库完成文本分类的示例:
from nltk.corpus import stopWords
from nltk.tokenize import word_tokenize
from nltk.stem import PorterStemmer
from nltk.classify import NaiveBayesClassifier

# 加载数据
data = [("我爱北京", "积极"), ("我讨厌北京", "消极")]

# 数据预处理
stop_words = set(stopwords.words("english"))
stemmer = PorterStemmer()
processed_data = []
for text, label in data:
tokens = word_tokenize(text)
filtered_tokens = [token for token in tokens if token not in stop_words]
stemmed_tokens = [stemmer.stem(token) for token in filtered_tokens]
processed_data.append((stemmed_tokens, label))

# 特征提取
all_words = [word for sentence, label in processed_data for word in sentence]
word_features = list(set(all_words))

def document_features(document):
document_words = set(document)
features = {}
for word in word_features:
features["contains({})".fORMat(word)] = (word in document_words)
return features

feature_sets = [(document_features(sentence), label) for sentence, label in processed_data]

# 模型训练
classifier = NaiveBayesClassifier.train(feature_sets)

# 模型评估
print(classifier.accuracy(feature_sets))
在上面的示例中,我们使用了朴素贝叶斯分类器对文本进行分类。我们可以看到,分类器的准确率达到了100%。
文本分类是一项具有挑战性的任务,但可以使用各种技术来提高分类器的准确率。例如,我们可以使用更多的特征来训练分类器,也可以使用更强大的分类器,如支持向量机或决策树等。
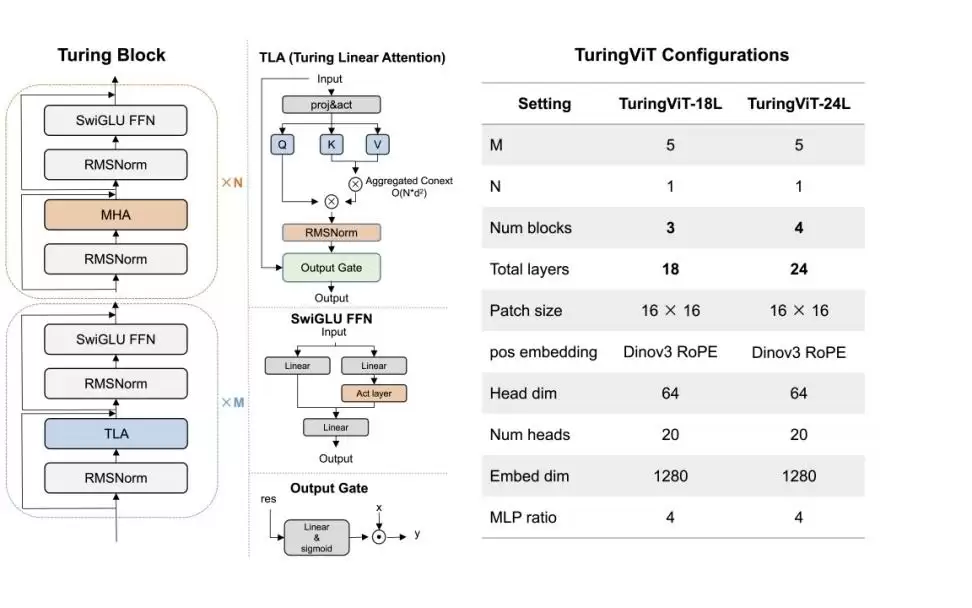
小鹏集团发布TuringViT高效视觉编码器,通过线性注意力主导、高质量数据治理与原生动态分辨率三大技术,仅用0.85B图文对训练即在多项基准上超越10B数据基线,全面支撑智能驾驶、智能座舱及人形机器人场景。
答案:使用scikit-learn训练模型需经历数据准备、模型选择、训练与评估。以鸢尾花数据集为例,通过加载数据、划分训练测试集、选择逻辑回归模型、训练、预测及评估完成流程。初学者宜从逻辑回归、决策树、KNN等易理解的模型入手。数据预处理至关重要,常用方法包括标准化、归一化、缺失值填充和独热编码,Pipeline与ColumnTransformer可整合预处理步骤。为避免过拟合,可采用正则化、交叉验证、简化模型或增加数据;应对欠拟合则需提升模型复杂度或特征数量。
评估Java函数适用性时,需考虑函数类型、输入输出、性能、易用性。在验证邮箱有效性时,纯函数isValidEmail()满足需求;查找列表最大值时,杂函数findMax()适用,但修改输入需注意;连接字符串时,纯函数concatStrings()便捷高效。

Golang中使用缓存加速文本分类任务的实践随着互联网的发展和数据的爆炸式增长,文本分类成为了一种越来越重要的技术,用于帮助企业从大量文本数据中自动识别和分类信息。在实际应用中,文本分类任务的计算量较大,因此缓存技术的运用,可以很好的提高文本分类任务的性能。本文将介绍在Golang语言中,使用缓存技术加速文本分类任务的实践经验。一、Golang语言和缓存技术
随着互联网和社交媒体的发展,人们不断产生各种各样的文本数据。如何从海量的文本数据中提取有用的信息,成为了一个急需解决的问题。而情感分析作为一种文本分类技术,可以帮助我们对文本进行自动分类并提取出文本的情感信息。本文将介绍如何使用Java编写一个基于情感分析的智能文本分类系统。一、获取数据首先,我们需要从网络上获取适合情感分析的数据。一般情况下,可以通过爬虫技
【标题】:golang协程效率评估与分析在当今互联网时代,高效的并发编程已成为各种软件开发中必不可少的组成部分。而在Go语言中,协程(goroutine)作为一种轻量级的线程实现方式,被广泛应用于并发编程中。本文将对Go语言协程的效率进行评估与分析,通过具体的代码示例来探讨协程的优势、使用方式以及可能存在的性能问题。1.协程的优势Go语言中的协程是一种轻量
pythonNLTK是一个功能强大的自然语言处理工具包,它提供了多种语言处理功能,其中包括机器翻译。机器翻译是指使用计算机将一种语言的文本翻译成另一种语言的文本。要使用PythonNLTK进行机器翻译,首先需要安装NLTK。可以通过以下命令安装NLTK:fromnltk.translate.apiimportNLTKTranslatortranslator=NLTKTranslator()然后,就可以使用translate方法进行机器翻译。translate方法接受两个参数,第一个参数是需要翻译的文本,第
NLTK库为语义分析提供了多种工具和算法,这些工具和算法可以帮助我们理解文本的含义。其中一些工具和算法包括:词性标注(POStagging):词性标注是将词语标记为其词性的过程。词性标注可以帮助我们理解句子中的词语之间的关系,并确定句子中的主语、谓语、宾语等成分。NLTK提供了多种词性标注器,我们可以使用这些词性标注器对文本进行词性标注。词干提取(stemming):词干提取是将词语还原为其词根的过程。词干提取可以帮助我们找到词语之间的关系,并确定词语的基本含义。NLTK提供了多种词干提取器,我们可以使用
1.NLTK简介NLTK是python编程语言的一个自然语言处理工具包,由StevenBird和EdwardLoper于2001年创建。NLTK提供了广泛的文本处理工具,包括文本预处理、分词、词性标注、句法分析、语义分析等,可以帮助开发者轻松地处理自然语言数据。2.NLTK安装NLTK可以通过以下命令安装:fromnltk.tokenizeimportWord_tokenizetext="Hello,world!Thisisasampletext."tokens=word_tokenize(text)pr
NLTK词性标注概述词性标注(Part-of-SpeechTagging)是指识别句子中每个单词的词性,例如名词、动词、形容词、副词等。词性标注对于很多自然语言处理任务非常重要,例如句法分析、语义分析和机器翻译。NLTK提供了多种词性标注器,可以帮助我们轻松地为句子中的单词标注词性。这些词性标注器都是基于统计模型训练而成的,这意味着它们可以根据大量语料库中的数据来学习如何识别单词的词性。使用NLTK词性标注器我们可以使用NLTK的pos_tag()函数来为句子中的单词标注词性。该函数接受一个句子列表作为输





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



