

大规模模型的缩放规律是否适用于下游任务表现?最新研究揭示了斯坦福和谷歌的发现
大模型的成功主要归功于ScalingLaw的存在,这一定律量化了模型性能与训练数据规模、模型架构等要素之间的关系。ScalingLaw为模型开发、资源分配和选择适当的训练数据提供了重要的指导。过去的研究主要关注于上游复杂度或交叉熵损失的Scalinglaw,即在预训练数据上的评估。然而,在实际应用中,模型往往需要经历迁移学习的阶段:首先在无监督数据上进行预训练,然后再针对具体的下游任务(如编码或翻译)进行微调。那么,ScalingLaw能不能用于预测下游任务性能?这个关键问题很大程度上仍未得到解答。在最近
大模型的成功主要归功于 Scaling Law 的存在,这一定律量化了模型性能与训练数据规模、模型架构等要素之间的关系。Scaling Law 为模型开发、资源分配和选择适当的训练数据提供了重要的指导。
过去的研究主要关注于上游复杂度或交叉熵损失的 Scaling law,即在预训练数据上的评估。然而,在实际应用中,模型往往需要经历迁移学习的阶段:首先在无监督数据上进行预训练,然后再针对具体的下游任务(如编码或翻译)进行微调。
那么,Scaling Law 能不能用于预测下游任务性能?这个关键问题很大程度上仍未得到解答。在最近的一项工作中,斯坦福大学和谷歌的研究者探索了迁移学习的 Scaling Law。
论文标题:Scaling Laws for Downstream Task Performance of Large Language Models
论文链接:https://arxiv.org/pdf/2402.04177.pdf
任务性能指的是准确率和 BLEU 得分等衡量任务相关的指标,这些指标不同于交叉熵等下一个 token 预测指标。研究者聚焦于机器翻译任务,具体讨论了预训练数据集大小与任务微调后下游任务性能之间的关系,发现除了微调数据大小和性能指标的选择外,这种关系从根本上取决于预训练数据和下游任务之间的一致性。虽然迁移学习方面的诸多工作在不同情况下也有类似的观察结果,但本文为 LLM 的下游性能提供了新的见解和具体的 Scaling Law。
研究者在多语言无监督数据集上对 LLM 进行了预训练,然后在多个机器翻译任务中对其进行微调。在整个实验中,研究者改变了预训练数据的类型(以控制与下游任务的分布一致程度)和微调数据的规模。
本文研究了两个指标:下游 BLEU 得分和下游交叉熵。
研究表明,在分布完全相同的情况下,随着预训练次数的增加,BLEU分数和下游交叉熵都呈现出单调提高的趋势。实验证实了BLEU得分可以很好地遵循对数定律,随着预训练次数的增加,BLEU得分也相应地增加。
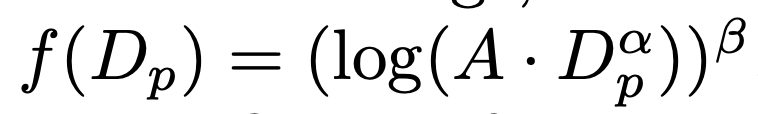
其中 D_p 表示预训练数据的大小,A、α、β 是要拟合的系数。随着预训练数据的增加,研究者进一步提出了下游交叉熵的幂律
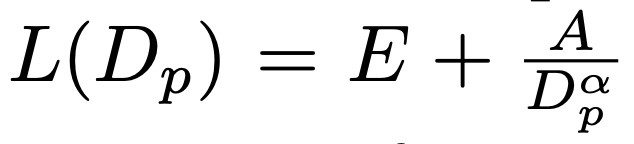
这与「上游交叉熵随预训练数据集大小变化而变化」的类似规律以及「下游交叉熵随微调数据集大小变化而变化的类似规律」如出一辙。
然而,当分布不够一致且微调数据量相对较小时,在某些情况下,BLEU 得分会表现出不明确的非单调行为,而下游的交叉熵仍会按照幂律单调地提高。这一观察结果表明,如果将交叉熵作为 BLEU 得分等任务相关指标的替代指标来决定预训练数据与下游任务的「相关性」或下游目标性能所需的预训练数据大小,在实践中可能会导致严重的误判。
最后的实证研究表明,当微调(迁移)数据集已经足够大时,预训练对 BLEU 得分几乎没有改善。
用于迁移学习的 Scaling Law
适用于 BLEU 得分的 Scaling Law
与遵循幂律缩放行为的交叉熵和困惑度不同,研究者发现 BLEU 得分更接近于对数律(log-law),这从图 1、图 2 和图 3 中显而易见。因此,研究者提出以下公式作为预训练数据集大小 D_p 的函数的 BLEU 得分的 Scaling Law:
其中 A、α 和 β 为拟合系数。研究者注意到,这些系数取决于预训练数据集与下游目标任务(从语言 1 翻译到语言 2)的对齐程度,以及微调(翻译)数据集的规模。通过对多个翻译任务和多语言预训练模型的大量实验,研究者证明 (1) 中的定律确实很好地描述了 BLEU 得分的缩放,而且预测误差较小。
交叉熵损失总是一个好的指标吗?
研究者还将下游交叉熵损失和 BLEU 得分从实证角度进行了比较,因为先前的工作假设上游或下游交叉熵损失是模型下游任务性能的一个好指标。遵循对预训练数据集规模的函数中的上游交叉熵损失的缩放行为的深入理解,研究者展示了同样的 Scaling Law 也可以描述下游交叉熵损失,如下:
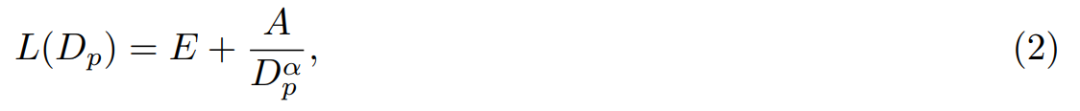
其中 E、A 和 α 是需要优化的系数。在整篇论文中,研究者将 BLEU 得分和交叉熵放在一起报告,以便进行直接比较,发现在一些情况下,这两个指标的相关性并不好。这支持了 Ghorbani et al. (2021) 的一些发现,即 BLEU 得分和交叉熵之间不一致,但也表明 Gordon et al. (2021) 所提出的(两个指标之间的)指数关系并不总是成立的。更具体地说,本文的实证结果表明,随着预训练数据集规模的增加,交叉熵损失总是单调递减(在适当的学习率下),而当预训练数据与任务不够一致时,BLEU 得分可能会呈现非单调趋势。
例如,在图 3(右上)中,增加 en-MC4、de-MC4 或 ro-MC4 预训练数据集的大小有时会降低 WMT-15 英法(en-fr)翻译任务的 BLEU 得分。尽管对于较小的预训练数据集来说,它们最初可能遵循(1)中的规律,但对于这些数据集和任务来说,数据越大,Scaling Law 就会打破。总体而言,与其他包含一定量法语的预训练数据集相比,BLEU 得分从未达到一个很好的值,这表明不包含法语的预训练数据集与这一特定翻译任务的匹配度不够。但是,如果只看图 3(右下)中的交叉熵损失,就会得出结论:所有预训练数据集都会给模型带来明显的改进,它们都值得添加到预训练数据中,而这会是一个错误的决定。
McKenzie et al. (2023) 对任务相关指标与交叉熵之间的不匹配进行了 remotely related 观察,研究了下游任务性能如何随着模型的增长而变化,结果表明 LLM 可能会随着模型规模的增加而显示出更差的任务性能,但与本文研究结果类似的是,单调递减的交叉熵损失并未反映出这一点。
迁移学习中的 Scaling Law 何时失效?
虽然交叉熵损失总是遵循一个单调递减的趋势,这可以通过公式 (2) 中的 Scaling Law 来获得。但当增加预训练数据集大小时,我们并不总能看到 BLEU 得分的单调增加(见图 2(上,中)和图 3(上,右))。研究者观察到,这种情况只在预训练数据集与翻译任务对齐度不足时发生 —— 这导致与在其他数据集上预训练的模型相比,这类模型总体上 BLEU 得分较低。对于微调后导致高 BLEU 得分的预训练模型,总能看到 BLEU 得分单调增加,并且可以很好地用公式 (1) 中的 Scaling Law 来描述。因此,Scaling Law 能否拟合实证 BLEU 得分,可以作为评估预训练数据对下游(翻译)任务价值的一个好的初步检查。
预训练数据评估指南
结合上述对 BLEU 得分缩放表现的研究结果,研究者给出了两条指南,用于评估预训练数据集对目标下游任务的价值:
1、给定一个预训练数据集,在给定的计算和时间限制条件下尽可能长时间地进行预训练。定期选择预训练检查点,对其进行微调,并记录下游性能指标(根据第 3.3 节的讨论,研究者推荐使用 BLEU 得分而非交叉熵)。
2、由于 (1) 中的定律有三个系数需要拟合,因此一旦有了三对(看到的预训练 token 数、BLEU 得分),就会尝试找到最佳系数。
如果 BLEU 得分具有非单调表现,就无法拟合 Scaling Law。由于非单调行为可能是不对齐的迹象(根据第 3.3 节中的讨论),研究者建议检查可用的最佳微调检查点的 BLEU 得分,并将其与直接在下游任务中训练的非预训练模型的性能进行比较。
如果 Scaling Law 拟合得很好,就可以在增加预训练数据集规模(或预训练更多步骤)时对 BLEU 分数进行初步预测。
如果对预测的 BLEU 得分不满意,就会得出结论:不值得对该数据集进行预训练。如果预测的 BLEU 分数足够高,那么就继续预训练,直到达到目标 BLEU 得分。
如果 Scaling Law 在任何一点上被打破,就会得出结论:预训练数据集与下游任务的匹配程度不够,进一步预训练可能不会有任何益处。
实验结果
在图 1 中,研究者分析了在不同比例的数据集上预训练的模型,这些数据集包括(左)50% 英文 - MC4 + 50% 德文 - MC4 的混合体、(中)50% 英文 - MC4 + 50% 法文 - MC4 的混合体以及(右)50% 英文 - MC4 + 50% 罗马尼亚文 - MC4 的混合体。然后,这些模型分别在(左)英 - 德翻译数据集、(中)英 - 法翻译数据集和(右)英 - 罗翻译数据集的不同部分上进行微调。
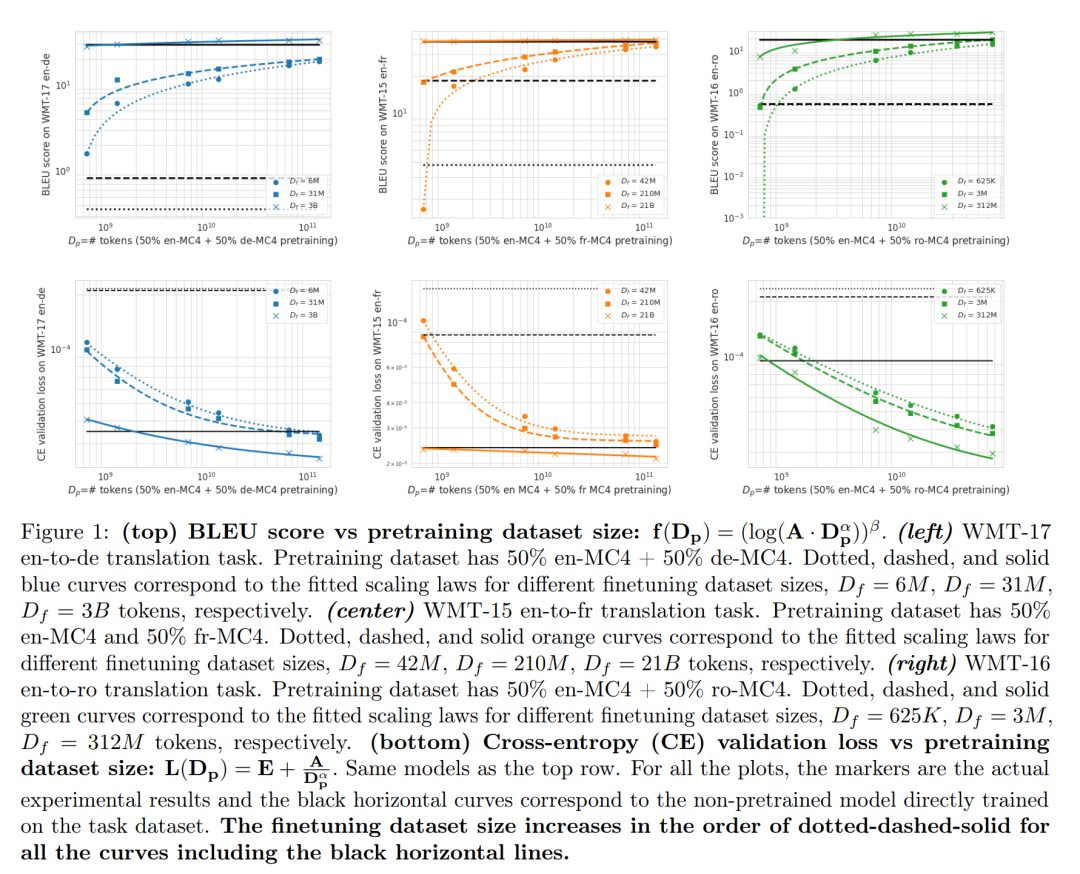
第一行记录了 BLEU 得分,第二行记录了下游交叉熵损失。点线、虚线和实线分别对应于公式(1)和(2)中不同微调数据集大小 D_f 的 Scaling Law。黑色线条对应「未经预训练」的模型(随机初始化),这些模型直接在微调数据集的不同部分上进行训练。
在所有情况下,Scaling Law 都很好地适应了实证结果(图中标记)。正如预期的那样,随着微调数据集大小的增加(例如,按点线 - 虚线 - 实线的顺序),BLEU 得分增加,交叉熵损失平滑且单调地减少。同样,随着预训练数据集大小 D_p 的增加(沿 x 轴),可以看到两个指标都有所改善。
可以注意到,增加预训练数据集大小对于较小的微调数据集更有效。当微调数据集足够大时(例如,实线),不论预训练数据集大小如何,BLEU 得分或多或少保持恒定。实际上,当微调数据集足够大时,与未经预训练的模型(黑线)相比,可以看到预训练几乎没有改善。
这意味着,对于这些任务,当微调数据集足够大时,没有必要进行模型预训练。幸运的是,我们可以使用 Scaling Law 正确预测是否会出现这种情况,需要做的就是在预训练数据集的一小部分上以合理的计算成本预训练模型,以优化 Scaling Law 的系数,然后遵循论文第 3.4 节提供的指南。
在图 2 中,研究者将所有图中的预训练数据集更改为 100% 英文 - MC4。直观上,他们预期这个数据集与图 1 中的「多语言对」比起来,与翻译任务的对齐度较低,因为它不包括翻译任务中的一种语言。的确,我们通常看到相同微调数据集大小的情况下,BLEU 得分更低,交叉熵损失更高。
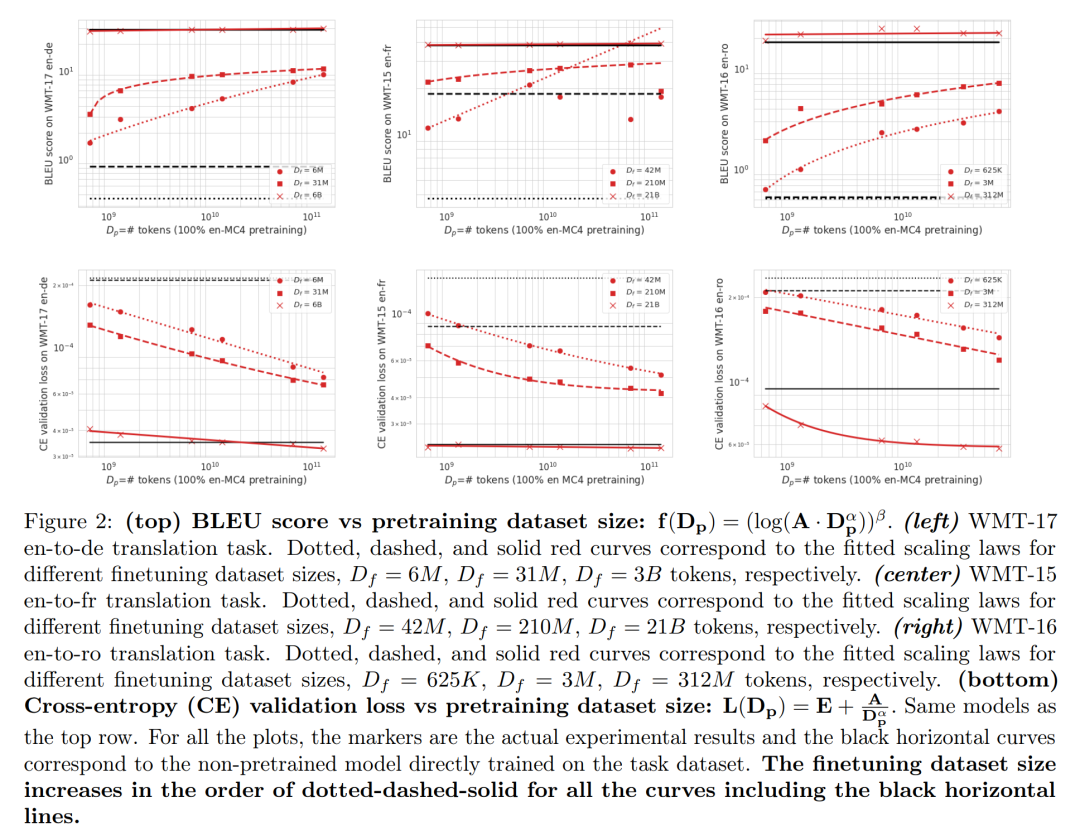
大部分从图 1 中得出的结论也适用于图 2 中的结果。例如,当微调数据集足够大时,预训练数据的重要性较小。一个显著的不同在于英 - 法翻译任务(中间一栏)的 BLEU 得分。研究者发现,对于 D_f = 42M 和 D_f = 210M,一旦预训练数据集大小超过一个阈值,BLEU 得分的 Scaling Law 实际上会断裂,而交叉熵损失则如预期那样缩放。这是违反直觉的,因为对于更大的预训练数据集,BLEU 得分有时会下降。注意,在英 - 德或英 - 罗翻译任务中,这种 Scaling Law 的断裂并未发生,因为 Scaling Law 很好地适应了预训练数据,这些任务的预测误差最多为 0.025(δ = 0.1))。
为了更好地调查这一点,在图 3 中,研究者更仔细地研究了由于语言选择而对齐度较低的一些预训练数据集:
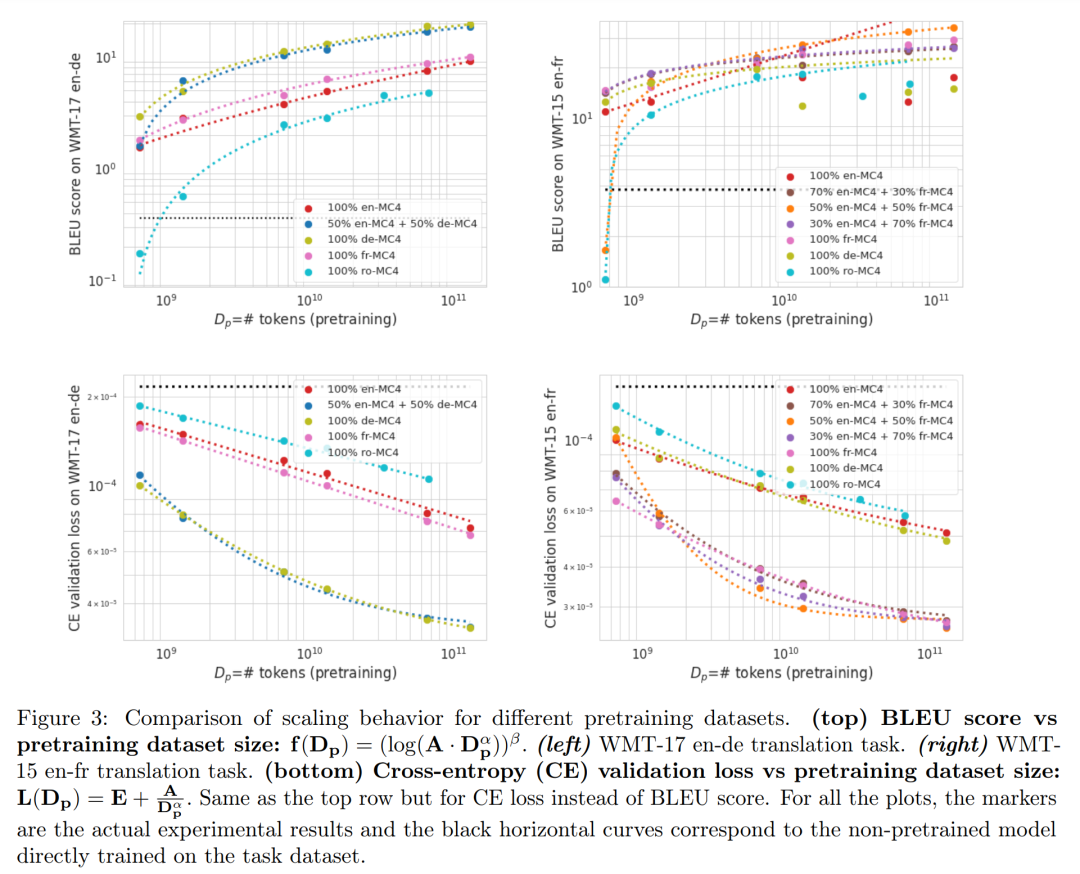
在图 3(左侧),研究者为英 - 德翻译任务提供了 Scaling Law,其中预训练数据集包括 100% 英文 - MC4(与图 2-(左侧)相同)、50% 英文 - MC4 和 50% 德文 - MC4(与图 1-(左侧)相同)、100% 德文 - MC4、100% 法文 - MC4(对齐度较低)和 100% 罗马尼亚文 - MC4(对齐度较低)。注意,最后两个预训练数据集预期与翻译任务的对齐度最低,因为翻译对不包括这些语言。可以看到,尽管如此,Scaling Law 始终适用于 BLEU 得分和交叉熵损失。
然而,对于英法翻译任务,情况并非总是如此。在图 3-(右侧),研究者为英法翻译任务提供了 Scaling Law,其中预训练数据集是英文 - MC4 和法文 - MC4 数据集的不同混合。他们还包括了「对齐度较低」的预训练数据集,如 100% 德文 - MC4 和 100% 罗马尼亚文 - MC4。令人惊讶的是,可以看到对于仅英文(100% 英文 - MC4)、仅德文(100% 德文 - MC4)和仅罗马尼亚文(100% 罗马尼亚文 - MC4)的预训练数据集,BLEU 得分的 Scaling Law 在某一点后断裂,而交叉熵损失总是遵循公式 (2) 中的 Scaling Law。有趣的是,研究者没有在仅法文(100% 法文 - MC4)的预训练数据集中观察到 BLEU 得分缩放的断裂 —— 这暗示在预训练中不包括法文数据会导致英法翻译任务中的缩放性能下降,但不包括英文则没有这种影响。
研究者还注意到,在这三个缩放断裂的预训练数据集中,BLEU 得分最低。这表明,只要预训练数据集有望带来良好的性能,公式 (1) 中的 Scaling Law 对于 BLEU 得分就适用得很好。然而,当 Scaling Law 适用得不好时,研究者可能会怀疑 BLEU 得分总体上较低。因此,是否能够适应 BLEU 得分的 Scaling Law 似乎能很好地指示预训练数据与特定翻译任务之间的对齐程度。
请参阅原始论文以获取更多详细信息。
伴随大模型迭代速度越来越快,训练集群规模越来越大,高频率的软硬件故障已经成为阻碍训练效率进一步提高的痛点,检查点(Checkpoint)系统在训练过程中负责状态的存储和恢复,已经成为克服训练故障、保障训练进度和提高训练效率的关键。近日,字节跳动豆包大模型团队与香港大学联合提出了ByteCheckpoint。这是一个PyTorch原生,兼容多个训练框架,支持Checkpoint的高效读写和自动重新切分的大模型Checkpointing系统,相比现有方法有显著性能提升和易用性优势。本文介绍了大模型训练提效中C

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文第一作者杜超群是清华大学自动化系2020级直博生。导师为黄高副教授。此前于清华大学物理系获理学学士学位。研究兴趣为不同数据分布上的模型泛化和鲁棒性研究,如长尾学习,半监督学习,迁移

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者是来自OpenSearch中国研发团队的机器学习负责人杨扬博士以及机器学习工程师耿志超和管聪。OpenSearch是一个由亚马逊云科技发起的纯开源搜索和实时分析引擎项目。目前软件

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com皮仁杰:香港科技大学博士三年级学生,师从张潼教授和周晓方教授。于2024年获得苹果奖学金。目前主要研究方向是多模态大语言模型和数据为中心的AI。张鉴殊:武汉大学本科三年级学生,目前在张潼
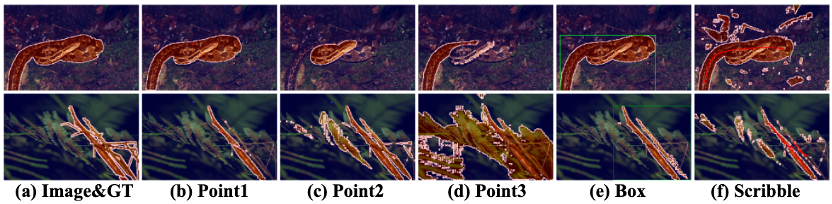
仅需一个任务描述,即可一键分割所有图片!SegmentationAnythingModel(SAM)的提出在图像分割领域引起了巨大的关注,其卓越的泛化性能引发了广泛的兴趣。然而,尽管如此,SAM仍面临一个无法回避的问题:为了使SAM能够准确地分割出目标物体的位置,每张图片都需要手动提供一个独特的视觉提示。如下图所示,即使点击的是同一物体(图(b)-(d)),微小位置变化都会导致分割结果的显著差异。这是因为视觉提示语义信息的缺乏,即使提供了想要分割的目标物体上,仍然可能引发歧义。框提示和涂鸦提示(图(e)(
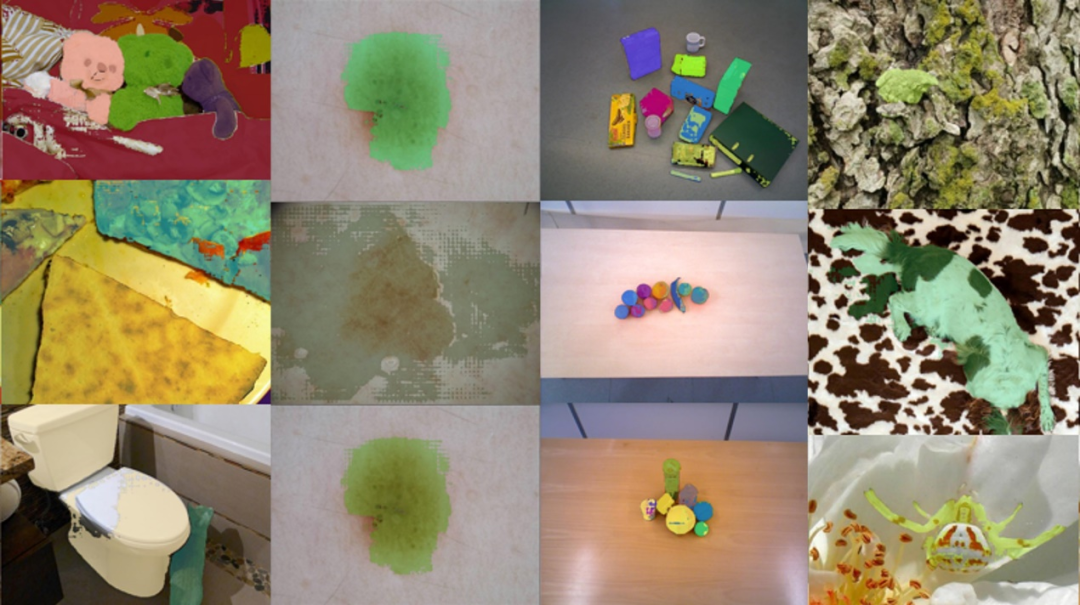
第一个针对「SegmentAnything」大模型的域适应策略来了!相关论文已被CVPR2024接收。引言大语言模型(LLMs)的成功激发了计算机视觉领域探索分割基础模型的兴趣。这些基础分割模型通常通过PromptEngineer来进行zero/few图像分割。其中,SegmentAnythingModel(SAM)是最先进的图像分割基础模型。图SAM在多个下游任务上表现不佳但是最近的研究表明,SAM在多种下游任务中并非具有很强的鲁棒性与泛化性,例如在医学图像、伪装物体、添加干扰的自然图像等领域表现较差。

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者来自浙江大学、上海人工智能实验室、香港中文大学、悉尼大学和牛津大学。作者列表:吴逸璇,王逸舟,唐诗翔,吴文灏,贺通,WanliOuyang,PhilipTorr,JianWu。其
颠覆过往大模型评测标准,最新、最全、最权威的测评数据集MR-Ben来了!这是继今年4月发布堪称GPT-4+DALL-E-3的王炸产品超强视觉语言模型Mini-Gemini后,港中文贾佳亚团队再次提出的极具代表性的作品。在MR-Ben的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。MR-Ben细致地评测了不少国内外一线的开源和闭源模型,如GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文共同第一作者简介:张逸骅:密歇根州立大学计算机系博士三年级学生,师从SijiaLiu教授,主要研究方向是大模型的安全、隐私和效率问题。李平治:本科毕业于中国科学技术大学,将于2024

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com该文章的作者团队来自于哈工大社会计算与信息检索研究中心,作者团队构成:郑子豪、张梓涵、王泽鑫、付瑞吉、刘铭、王仲远、秦兵。多模态表示多模态命名实体识别,作为构建多模态知识图谱的一项基础而





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



