

解决Windows电脑文件乱码问题的技巧
文件打开是乱码怎么解决?在我们使用电脑中,都遇到过打开文件后,发现全是乱码。遇到这种情况,该怎么解决呢?这里小编整理了一些实用的文件修复方法,有需要的朋友可以来看看哦。个人建议修改时尽量修改自定义选项例如.bash_profile,.vimrc文档,这样不会忘记自己修改了哪里,有时候某处的修改导致后面出现了新的问题,但却无法定位。汉字乱码现象有4种类型:1.文本乱码:是windows系统显示乱码,如:菜单、桌面、提示框等。这是由于注册表中有关字体部分的设置不当引起的;2.文档乱码:是各种应用程序,游戏本来
文件打开是乱码怎么解决?在我们使用电脑中,都遇到过打开文件后,发现全是乱码。遇到这种情况,该怎么解决呢?这里小编整理了一些实用的文件修复方法,有需要的朋友可以来看看哦。
个人建议
修改时尽量修改自定义选项例如.bash_profile,.vimrc文档,这样不会忘记自己修改了哪里,有时候某处的修改导致后面出现了新的问题,但却无法定位。
汉字乱码现象有4种类型:
1.文本乱码:是windows系统显示乱码,如:菜单、桌面、提示框等。这是由于注册表中有关字体部分的设置不当引起的;
2. 文档乱码:是各种应用程序,游戏本来显示中文的地方出现乱码。 这种乱码形成的原因比较复杂,有第1类的乱码原因,也有可能是软件中使用的中文动态链接库被英文动态链接库复盖处造成的;
3.文件乱码:主要是指邮件乱码;
4.网页乱码:是由于港台的繁体中文大五码(big5)与大陆简体中文(gb2312)不通用而造成的。
文件内容乱码
以.txt文档为例,直接打开是乱码,可通过下面方法查看情况,在vim软件中输入
#查看当前文件编码:set fileencodingfileencoding=gb18030
在.vimrc文档下加入
set fileencodings=utf-8,gb2312,gb18030,gbk,ucs-bom,cp936,latin1set enc=utf8set fencs=utf8,gbk,gb2312,gb18030
此时文档会正确显示。
解压文件夹文件名乱码
对于windows平台,编码格式是GBK,对应的汉字是两个字节长度。对于Linux平台,编码格式是UTF-8,对应的汉字是3个字节。
解压文件夹的命令
unzip -O CP936 testCode.zip
对应的解释
unzip --h-O CHARSET specify a character encoding for DOS, Windows and OS/2 archives
命令行乱码怎么办?
执行以下命令
vim ~/.bash_profile #添加下面的命令export LANGUAGE=en_US.UTF-8export LANG=en_US.UTF-8export LC_ALL=en_US.UTF-8 #使得生效,有的让重启是一个意思source ~/.bash_profile
使用命令查看当前编码
locale:local encode,即本地编码的意思。这个命令不带任何参数就是显示当前系统的字符集编码。也可以设置环境变量,全体参数man locale
在Linux中通过locale来设置程序运行的不同语言环境,locale由ANSI C提供支持。locale的命名规则为<语言>_<地区>.<字符集编码>,如zh_CN.UTF-8,zh代表中 文,CN代表大陆地区,UTF-8表示字符集。
locale#LANG LC_*的默认值,是最低级别的设置,如果LC_*没有设置,则使用该值。类似于 LC_ALL。LANG=en_US.UTF-8LANGUAGE=en_US.UTF-8#LC_CTYPE用于字符分类和字符串处理,控制所有字符的处理方式,包括字符编码,字符是单字节还是多字节,如何打印等。是最重要的一个环境变量。LC_CTYPE="en_US.UTF-8"# LC_NUMERIC 非货币的数字显示格式LC_NUMERIC="en_US.UTF-8"#LC_TIME 时间和日期格式LC_TIME="en_US.UTF-8"# LC_COLLATE定义该环境的排序和比较规则LC_COLLATE="en_US.UTF-8"#LC_MONETARY货币格式LC_MONETARY="en_US.UTF-8"#LC_MESSAGES提示信息的语言。另外还有一个LANGUAGE参数,它与LC_MESSAGES相似,但如果该参数一旦设置,则LC_MESSAGES参数就会失效。LANGUAGE参数可同时设置多种语言信息,如LANGUANE="zh_CN.GB18030:zh_CN.GB2312:zh_CN"。LC_MESSAGES="en_US.UTF-8"LC_PAPER="en_US.UTF-8"LC_NAME="en_US.UTF-8"LC_ADDRESS="en_US.UTF-8"LC_TELEPHONE="en_US.UTF-8"LC_MEASUREMENT="en_US.UTF-8"LC_IDENTIFICATION="en_US.UTF-8"#LC_ALL它是一个宏,如果该值设置了,则该值会覆盖所有LC_*的设置值。注意,LANG的值不受该宏影响。LC_ALL=en_US.UTF-8
locale -a你可以看看目前系统里支持的字符集,如果不支持,还要安装奥。当前.bash_profile的设置是
#中文显示if [ 1 -eq 1 ];thenLANG=zh_CN.GB18030LANGUAGE=zh_CN.GB18030:zh_CN.GB2312:zh_CNexport LANG LANGUAGEfi#英文显示 if [ 0 -eq 1 ];thenexport LANGUAGE=en_US.UTF-8export LANG=en_US.UTF-8export LC_ALL=en_US.UTF-8fi
字符编码基础知识
最初的计算机字符编码是通过ASCII来编码的,是现今最通用的单字节编码系统,使用7位二进制数来表示所有的字母、数字、标点符号及一些特殊控制字符,作为美国编码标准来使用。
ISO-8859-1编码是单字节编码,向下兼容ASCII,是许多欧洲国家使用的编码标准。其编码范围是0x00-0xFF,0x00-0x7F之间完全和ASCII一致,0x80-0x9F之间是控制字符,0xA0-0xFF之间是文字符号。
Unicode,学名是Universal Multiple-Octet Coded Character Set(简称UCF),与ISO-8859-1标准兼容。由国际组织标准制定,作为一种国际语言编码标准,支持超过十万个字符,涵盖世界数十种文字系统,是一种通用字符编码标准。很多技术,如Java编程语言、现代操作系统都采用了Unicode编码。
UTF-8/UTF-16等则是对Unicode进行了编码,是其一种实现方式。UTF-8(8-bit Unicode Transformation Format),是一种变长的编码方式,它以8位为码元,用1-6个码元对Unicode进行编码,对英文字符使用单字节编码,对中文编码用到三个字节来编码。UTF-16(16-bit Unicode Transformation Format)是用16位为码元,用1个或2个码元对Unicode进行编码。
utf-16将字符集划分为基本多文中平面和辅助平面,基本多文中平面中的字符与Unicode是一致的,不需要转换;处在辅助平面中的码元(如一些拼音文字或者中日韩表意文字的扩充),需要2个码元进行编码。
GB2312是国家制定的汉字编码标准,使用双子节进行编码,共收入6763个汉字和682个非汉字图形字符。GBK即对国标编码的扩展,在GB2312的基础上进行扩展形成的,使用双子节编码方式,共收入21003个汉字,从而大大满足了汉字使用的需要。
总结:unicode是国际通用编码标准,可以表示全世界的字符,但其字符集也是最复杂、占用空间最大的。开发者可以根据需要进行选择编码方式。
参考文献
原文:https://blog.csdn.net/shijing_0214/article/details/50908144 关于文件编码的一些命令
查看文件的编码:编码为GB2512
#检查文件的编码 enca test1.txt enca -L zh_CN fileName Simplified Chinese National Standard; GB2312 CRLF line terminators
转换文件编码
enca -L 当前语言 -x 目标编码 文件名 enca -L zh_CN -x utf-8 * //例如要把当前目录下的所有文件都转成utf-8 enca -L zh_CN -x UTF-8 file //将文件编码转换为"UTF-8"编码 enca -L zh_CN -x UTF-8 < file1 > file2 //如果不想覆盖原文件可以这样enca -L zh_CN -x utf8quadTest.c
乱码-ubuntu下文档的文件名到windows下变为___下划线
现象:Windows下编辑过的中文文档,Ubuntu下会显示乱码。
原因:两个操作系统使用的编码不同。Ubuntu下使用的编码是utf-8,而Windows使用的是gb18030。
ubuntu16.04解决文件中文乱码问题
1、查看当前系统使用的字符编码
~$ localeLANG=en_USLANGUAGE=en_US:LC_CTYPE="en_US"LC_NUMERIC="en_US"LC_TIME="en_US"LC_COLLATE="en_US"LC_MONETARY="en_US"LC_MESSAGES="en_US"LC_PAPER="en_US"LC_NAME="en_US"LC_ADDRESS="en_US"LC_TELEPHONE="en_US"LC_MEASUREMENT="en_US"LC_IDENTIFICATION="en_US"LC_ALL=
2、查看当前系统支持的字符集
:~$ locale -aCC.UTF-8en_USen_US.iso88591en_US.utf8POSIX
3、查看locale文件
:~$ cat /etc/default/locale# File generated by update-localeLANG="en_US"LANGUAGE="en_US:"
解决:
1、执行locale-gen zh_CN.UTF-8拉取中文编码(需要root权限)
:~$ locale-gen zh_CN.UTF-8sed: couldn't open temporary file /etc/sedMLPzNn: Permission denieddeployer@RSLog026:~$ sudo su[sudo] password for deployer:root@RSLog026:/home/deployer# locale-gen zh_CN.UTF-8Generating locales (this might take a while)...zh_CN.UTF-8... done
2、查看现在系统支持的字符集,发现多了zh_*等中文字符集
:~$ locale -aCC.UTF-8en_USen_US.iso88591en_US.utf8POSIXzh_CNzh_CN.gb2312zh_CN.gbkzh_CN.utf8
3、修改文件/etc/default/locale(必须要改,,开始还以为不该也行,发现如果不改这个文件,需要执行两遍第四步操作)
当前文件:~$ cat /etc/default/locale# File generated by update-localeLANG="en_US"LANGUAGE="en_US:"改成如下::~$ cat /etc/default/locale# File generated by update-localeLANG=zh_CN.UTF-8#LANGUAGE="en_US:"
4、执行sudo dpkg-reconfigure locales命令,由于不能截图,这里语言描述下了。
选中zh_CN GB2312,zh_CN.GBK GBK,zh_CN.UTF-8 UTF-8 按空格就是选中,然后tab键到ok,点击ok以后会跳转到下一界面,选中zh_CN.UTF-8,,然后ok就可以了
接下来重新打开会话就能正常使用中文了,不用重启系统。
查看当前系统使用的字符编码
locale LANG=zh_CN.UTF-8LANGUAGE=zh_CN:en_US:enLC_CTYPE="zh_CN.UTF-8"LC_NUMERIC=zh_CN.UTF-8LC_TIME=zh_CN.UTF-8LC_COLLATE="zh_CN.UTF-8"LC_MONETARY=zh_CN.UTF-8LC_MESSAGES="zh_CN.UTF-8"LC_PAPER=zh_CN.UTF-8LC_NAME=zh_CN.UTF-8LC_ADDRESS=zh_CN.UTF-8LC_TELEPHONE=zh_CN.UTF-8LC_MEASUREMENT=zh_CN.UTF-8LC_IDENTIFICATION=zh_CN.UTF-8LC_ALL=
查看当前系统支持的字符集
locale -aCC.UTF-8en_AGen_AG.utf8en_AU.utf8en_BW.utf8en_CA.utf8en_DK.utf8en_GB.utf8en_HK.utf8en_IE.utf8en_ILen_IL.utf8en_INen_IN.utf8en_NGen_NG.utf8en_NZ.utf8en_PH.utf8en_SG.utf8en_US.utf8en_ZA.utf8en_ZMen_ZM.utf8en_ZW.utf8POSIXzh_CN.utf8zh_SG.utf8
执行locale-gen zh_CN.UTF-8拉取中文编码
sudo locale-gen zh_CN.*Generating locales (this might take a while)... zh_CN.GB18030... done zh_CN.GB2312... done zh_CN.GBK... done zh_CN.UTF-8... doneGeneration complete.
查看现在系统支持的字符集,发现多了zh_*等中文字符集
locale -aCC.UTF-8en_AGen_AG.utf8en_AU.utf8en_BW.utf8en_CA.utf8en_DK.utf8en_GB.utf8en_HK.utf8en_IE.utf8en_ILen_IL.utf8en_INen_IN.utf8en_NGen_NG.utf8en_NZ.utf8en_PH.utf8en_SG.utf8en_US.utf8en_ZA.utf8en_ZMen_ZM.utf8en_ZW.utf8POSIXzh_CNzh_CN.gb18030zh_CN.gb2312zh_CN.gbkzh_CN.utf8zh_SG.utf8
乱码-windows下文档移到linux下文件显示乱码
上面的方法可以实现在gedit软件下,正确显示,但是在vim文档下显示如下
°üº¬µÄÐéÄâ»úID£¬¼°Æä·Ö²¼·½Ê½
但在gedit软件中打开实际上是
包含的虚拟机ID,及其分布方式
查看文件的编码方式
file debug_tran.cppdebug_tran.cpp: C++ source, ISO-8859 text, with CRLF line terminators
由于我的vim 配置里面显示了文件的格式,我的vim显示如下
doslatin1cpp
经过查询可知:Latin1是ISO-8859-1的别名,有些环境下写作Latin-1。此字符集支持部分于欧洲使用的语言,所以中文显示乱码。
可以采用下面的命令转换
iconv -f gbk -t utf8 debug_tran.cpp.gbk > debug_tran.cpp.utf
查找新产生的文件
file debug_tran.cpp.utf debug_tran.cpp.utf: C++ source, UTF-8 Unicode text, with CRLF line terminators
使用下面的语句查看具体选项
iconv --help
在windows中打开linux文档建议使用notepad++文件打开,在里面可以修改不同编码。
乱码分类表

电脑开机后一直显示转圈圈无法进入桌面?本文详解Windows启动加载界面的含义,介绍通过强制重启、进入安全模式、清理启动项及执行系统修复来解决卡顿问题的具体步骤。
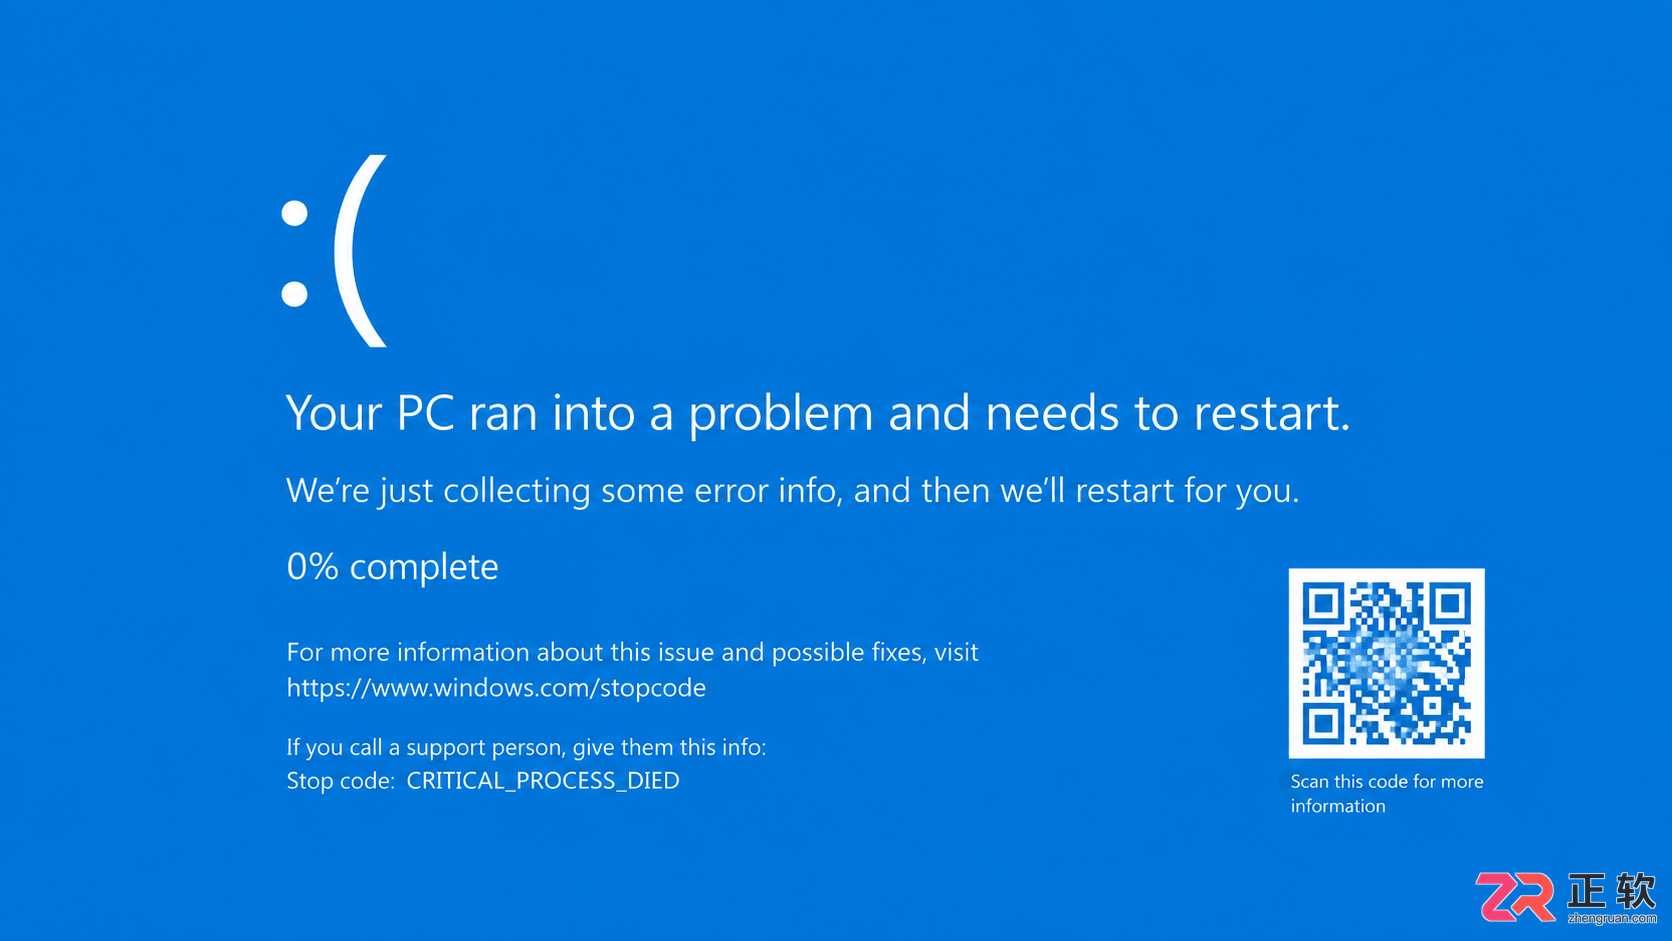
遇到电脑蓝屏不知所措?本文整理常见蓝屏代码对照表,详解CRITICAL_PROCESS_DIED、MEMORY_MANAGEMENT等错误含义,提供驱动更新、内存检测等实用解决方法。

刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。

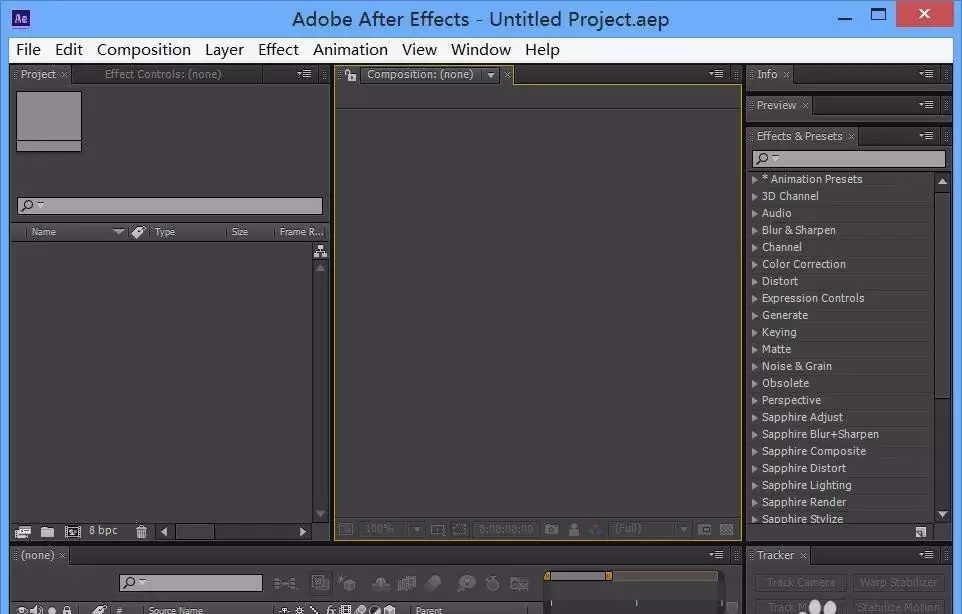
本文指导After Effects新手完成从打开软件到制作简单动画的完整流程。内容涵盖新建合成、导入素材、添加关键帧及预览验证,适用于AE基础学习。读者可依据步骤快速完成首个可播放的动效项目。
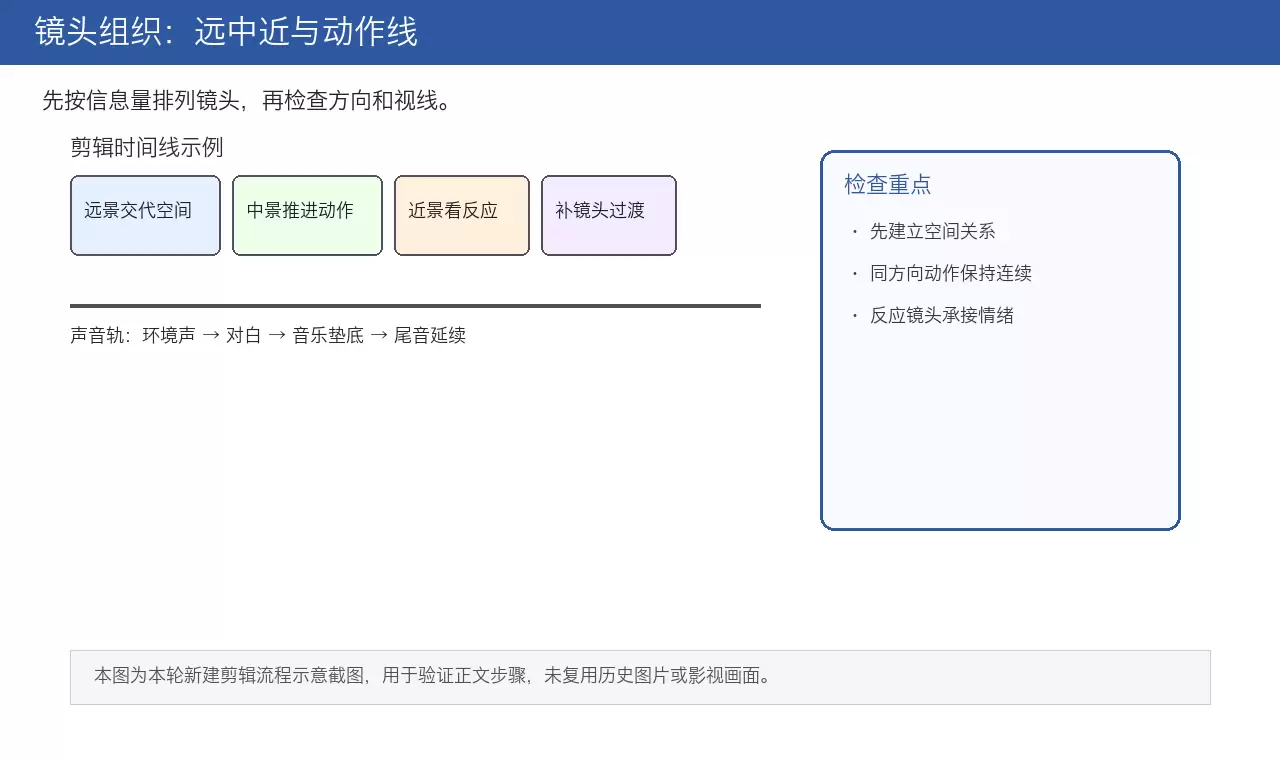
本文详解电影剪辑核心流程,从素材整理、镜头空间组织到叙事节奏压缩,再到J-cut/L-cut声音衔接技巧。通过粗剪保逻辑、精剪压停顿、反应镜头缓冲及电平统一检查,帮助创作者打造空间清晰、情绪连贯且听感自然的成片。
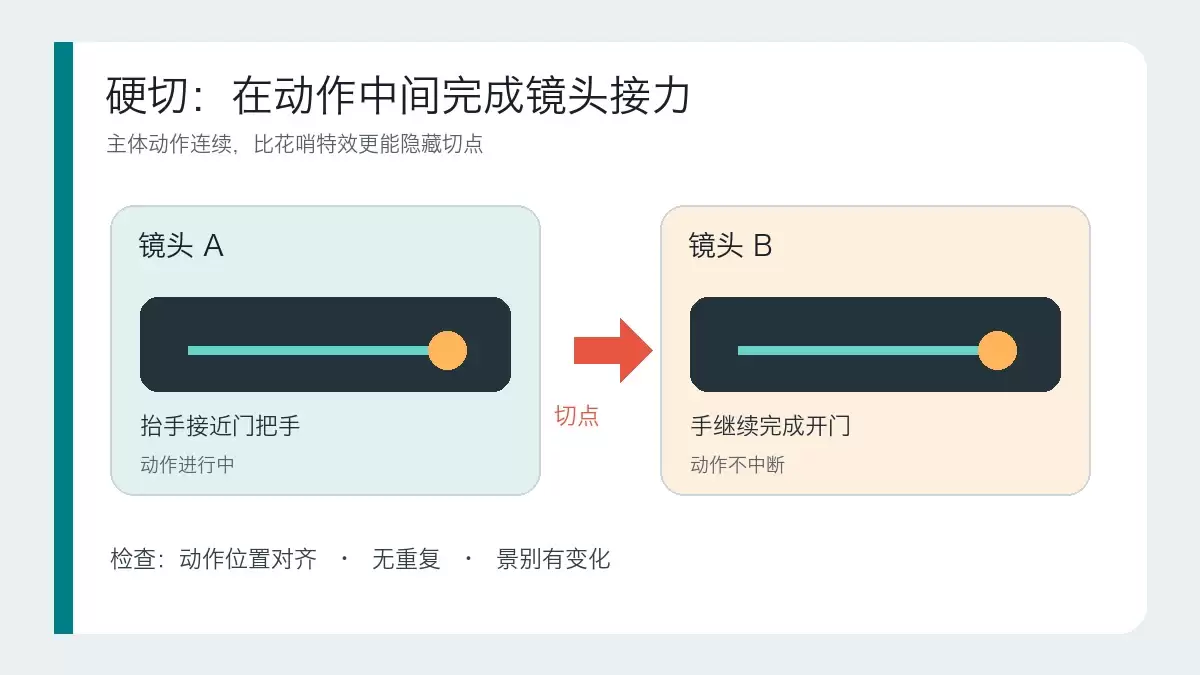
本文详解硬切、遮挡转场和运镜转场的适用场景与操作逻辑。通过对比三种转场的核心区别,提供基于素材条件和叙事目的的判断标准,帮助剪辑师避免滥用特效,掌握自然衔接画面的实战技巧。
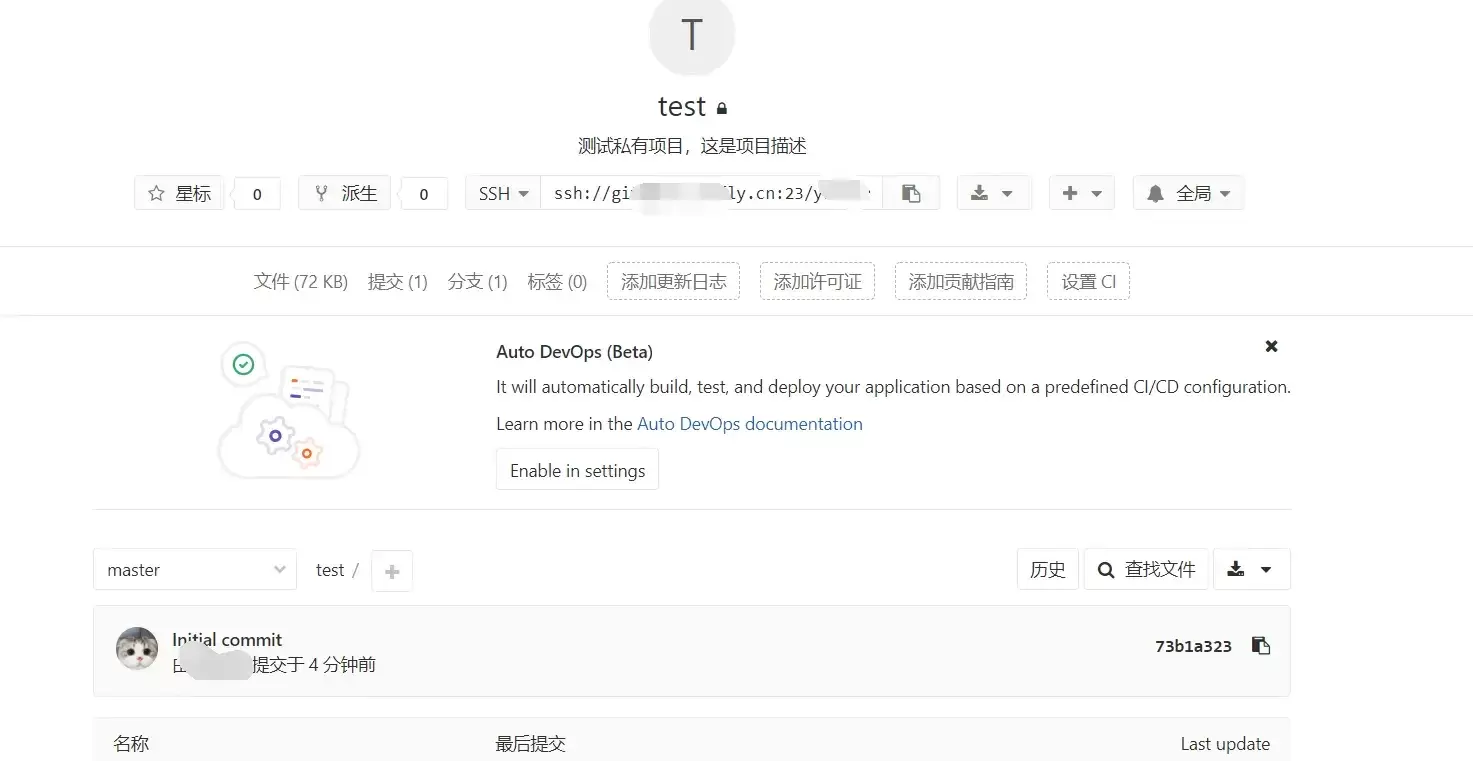
本文指导GitLab新手完成创建项目并推送第一次提交的最小闭环。涵盖远程项目创建、本地仓库初始化、添加远程地址及执行git push。重点说明HTTPS与SSH认证差异、分支名(master/main)核对及提交验证标准,确保远程仓库真正建立。
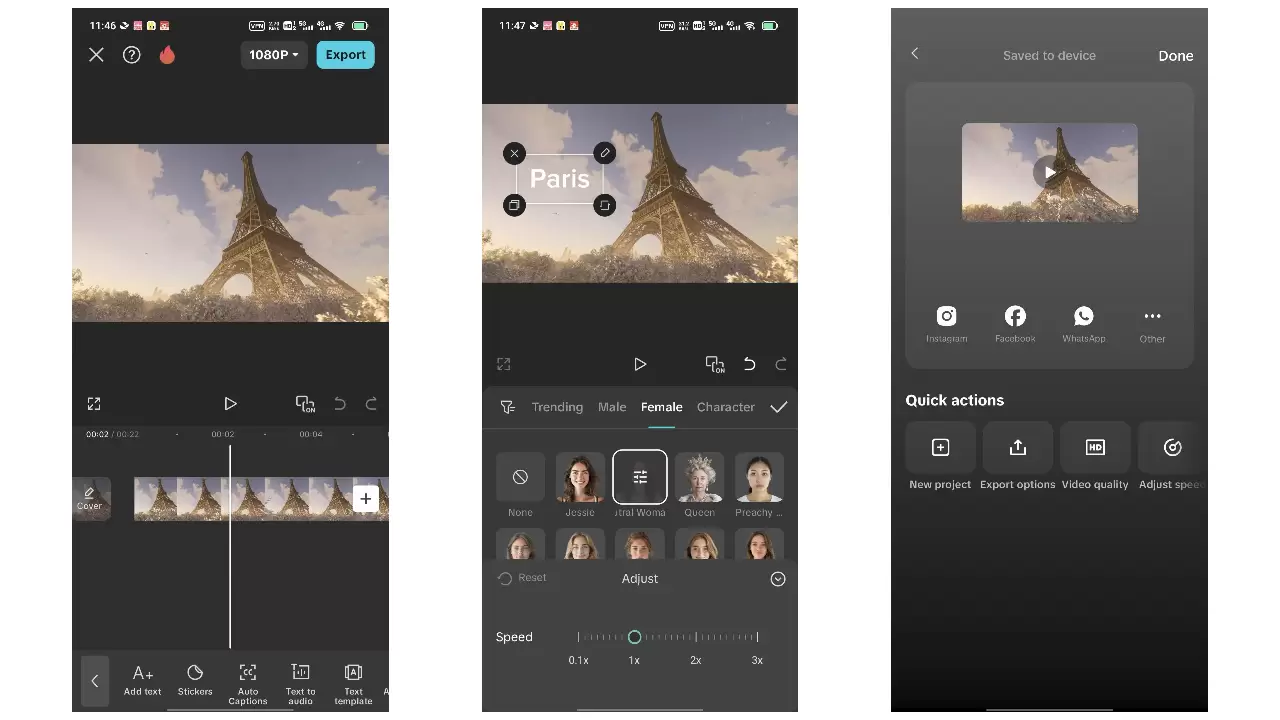
本教程针对抖音竖屏视频制作,涵盖拍摄前构思、稳定运镜、粗剪筛选、音乐卡点及导出检查全流程。重点在于拍摄时预留字幕空间、利用动作节点辅助剪辑,以及通过鼓点对齐画面。适用于新手快速完成第一条完整成片,强调素材质量与节奏自然,避免过度特效与版权风险。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
