

微软发布6页三进制LLM论文获热议
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
这就是由微软和中国中科院大学在最新一项研究中所提出的结论——所有的LLM,都将是1.58bit的。具体而言,这项研究提出的方法叫做BitNetb1.58,可以说是从大语言模型“根儿”上的参数下手。将传统以16位浮点数(如FP16或BF16)形式的存储,统统变成了三进制,也就是{-1,0,1}。需要注意的是,“1.58bit”并非表示每个参数占用1.58字节的存储空间,而是指每个参数可以用1.58位的信息来编码。在如此转换之后,矩阵中的计算就只会涉及到整数的加法,因此会让大模型在保持一定精度的同时,显著减少
这就是由微软和中国中科院大学在最新一项研究中所提出的结论——
所有的LLM,都将是1.58 bit的。
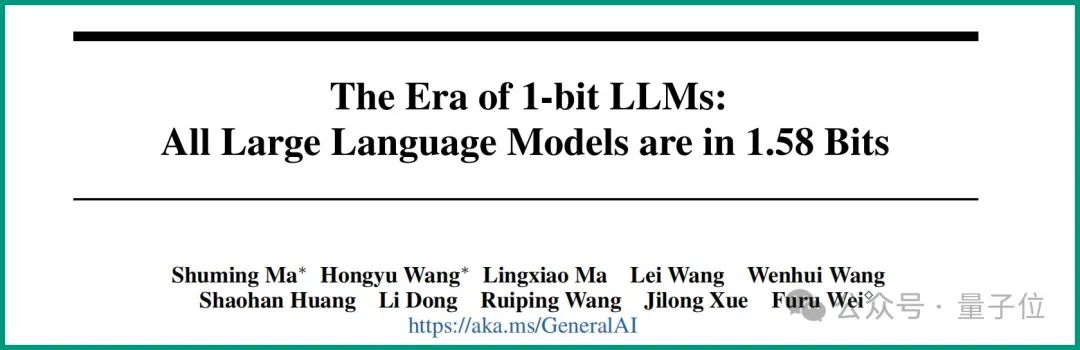
具体而言,这项研究提出的方法叫做BitNet b1.58,可以说是从大语言模型“根儿”上的参数下手。
将传统以16位浮点数(如FP16或BF16)形式的存储,统统变成了三进制,也就是 {-1, 0, 1}。
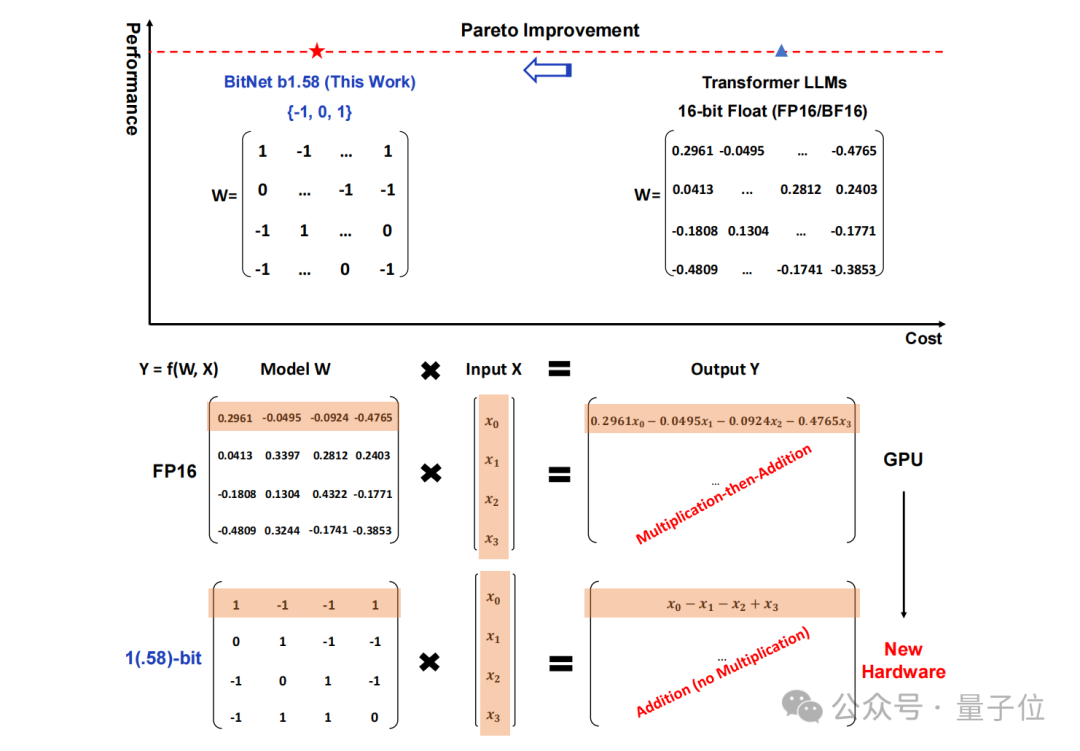
需要注意的是,“1.58 bit”并非表示每个参数占用1.58字节的存储空间,而是指每个参数可以用1.58位的信息来编码。
在如此转换之后,矩阵中的计算就只会涉及到整数的加法,因此会让大模型在保持一定精度的同时,显著减少所需的存储空间和计算资源。
例如BitNet b1.58在3B模型大小时与Llama做比较,速度提高了2.71倍的同时,GPU内存使用几乎仅是原先的四分之一。
而且当模型的规模越大时(例如70B),速度上的提升和内存上的节省就会更加显著!
这种颠覆传统的思路着实是让网友们眼前一亮,论文在X上也是受到了高度的关注:
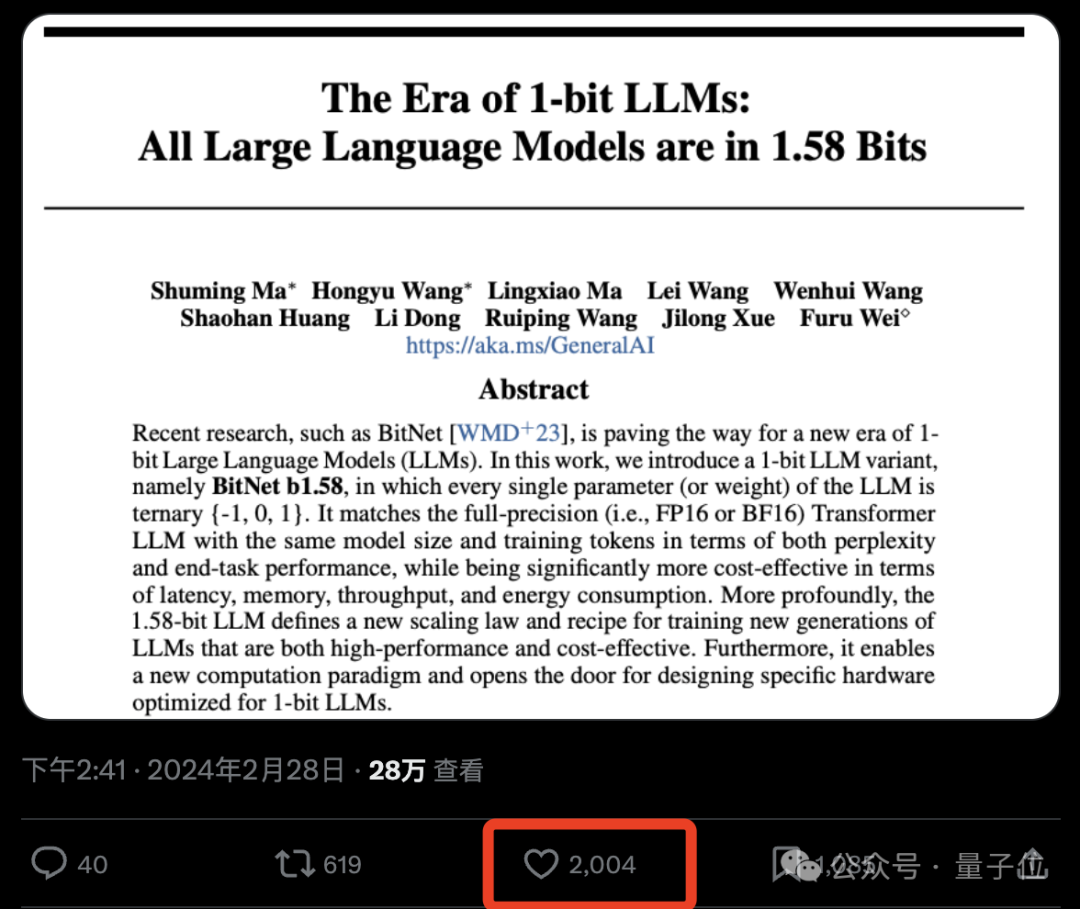
网友们惊叹“改变游戏规则”的同时,还玩起了谷歌attention论文的老梗:
1 bit is all YOU need.
那么BitNet b1.58具体又是如何实现的?我们继续往下看。
把参数都变成三进制
这项研究实则是原班人马在此前发表的一篇论文基础之上做的优化,即在原始BitNet的基础上增加了一个额外的0值。
整体来看,BitNet b1.58依旧是基于BitNet架构(一种Transformer),用BitLinear替换了nn.Linear。
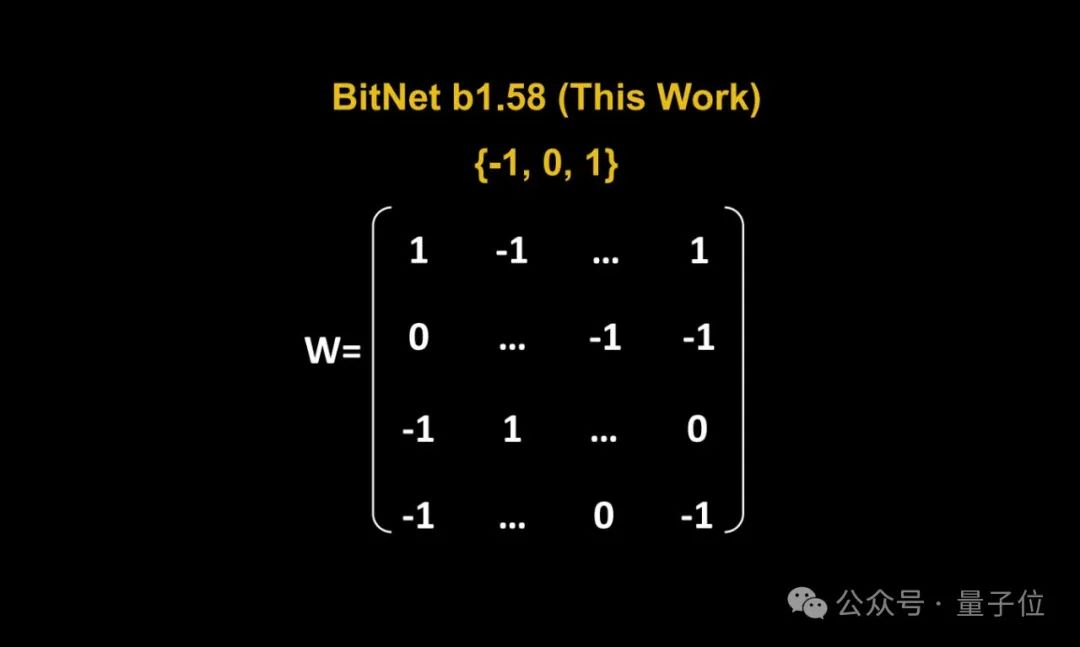
至于细节上的优化,首先就是我们刚才提到的“加个0”,即权重量化(weight quantization)。
BitNet b1.58模型的权重被量化为三元值{-1, 0, 1},这相当于在二进制系统中使用了1.58 bit来表示每个权重。这种量化方法减少了模型的内存占用,并简化了计算过程。
其次,在量化函数设计方面,为了将权重限制在-1、0或+1之间,研究者们采用了一种称为absmean的量化函数。
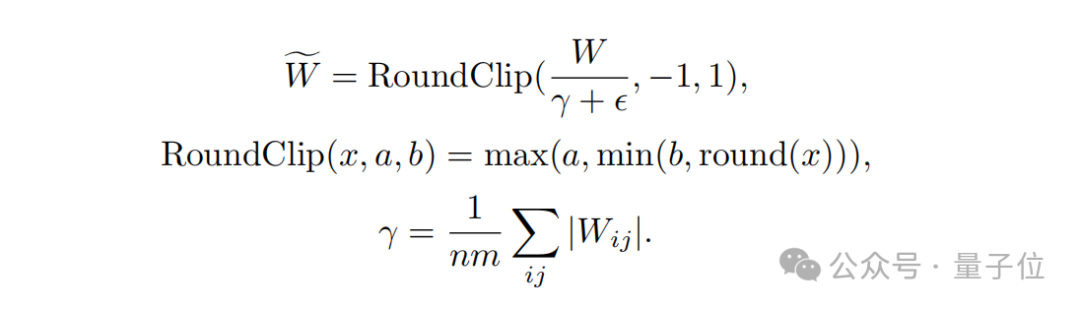
这个函数先会根据权重矩阵的平均绝对值进行缩放,然后将每个值四舍五入到最接近的整数(-1, 0, +1)。
接下来就到了激活量化(activation quantization)这一步。
激活值的量化与BitNet中的实现相同,但在非线性函数之前不将激活值缩放到[0, Qb]的范围内。相反,激活值被缩放到[−Qb, Qb]的范围,以此来消除零点量化。
值得一提的是,研究团队为了BitNet b1.58与开源社区兼容,采用了LLaMA模型的组件,如RMSNorm、SwiGLU等,使得它可以轻松集成到主流开源软件中。
最后,在实验的性能比较上,团队将BitNet b1.58与FP16 LLaMA LLM在不同大小的模型上进行了比较。
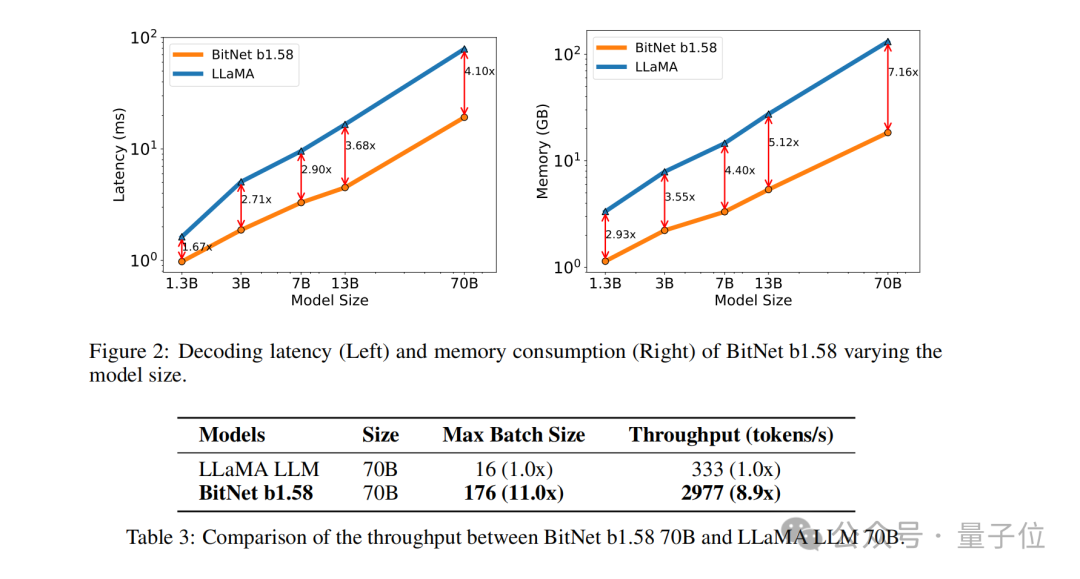
结果显示,BitNet b1.58在3B模型大小时开始与全精度LLaMA LLM在困惑度上匹配,同时在延迟、内存使用和吞吐量方面有显著提升。
而且当模型规模越大时,这种性能上提升就会越发显著。
网友:能在消费级GPU跑120B大模型了
正如上文所言,这篇研究独特的方法在网上引发了不小的热议。
DeepLearning.scala作者杨博表示:
BitNet b1.58相比原版BitNet,最大的特点就是允许0参数。我觉得稍微修改一下量化函数,也许可以控制0参数的比例。当0参数的比例很大时,可以用稀疏格式存储权重,使得平均每个参数的显存占用甚至低于1比特。这就相当于权重级别的MoE了。我觉得比一般的MoE更优雅。
与此同时,他也提出了关于BitNet的缺点:
BitNet最大的缺点在于虽然能减少推理时的显存开销,但优化器状态和梯度仍然要用浮点数,训练仍然很费显存。我觉得如果能把BitNet和训练时节省显存的技术结合起来,那么相比传统半精度网络,同等算力和显存下支持更多参数,优势就很大了。
目前能节省优化器状态的显存开销的办法是offloading。能节省梯度的显存占用的办法可能是ReLoRA。但是ReLoRA的论文实验只用了十亿参数的模型,并没有证据表明能不能推广到百亿、千亿参数的模型。
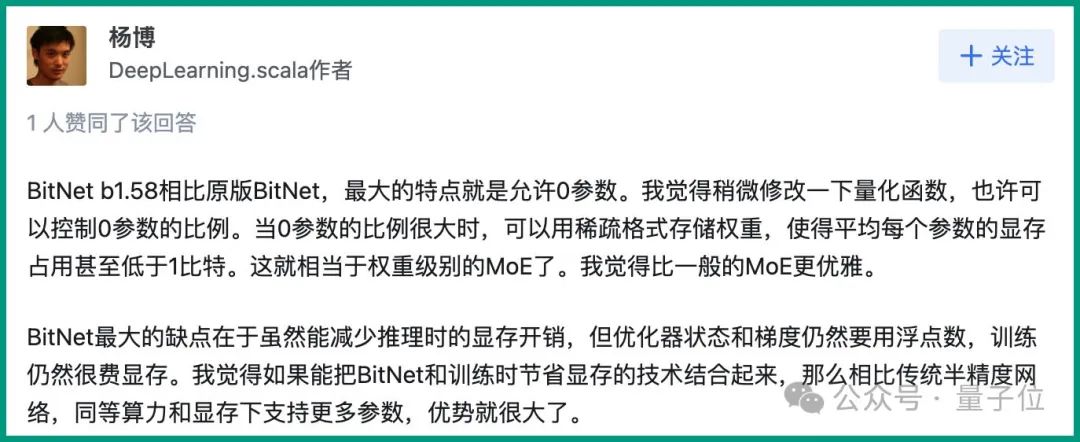
△图源:知乎,经授权引用
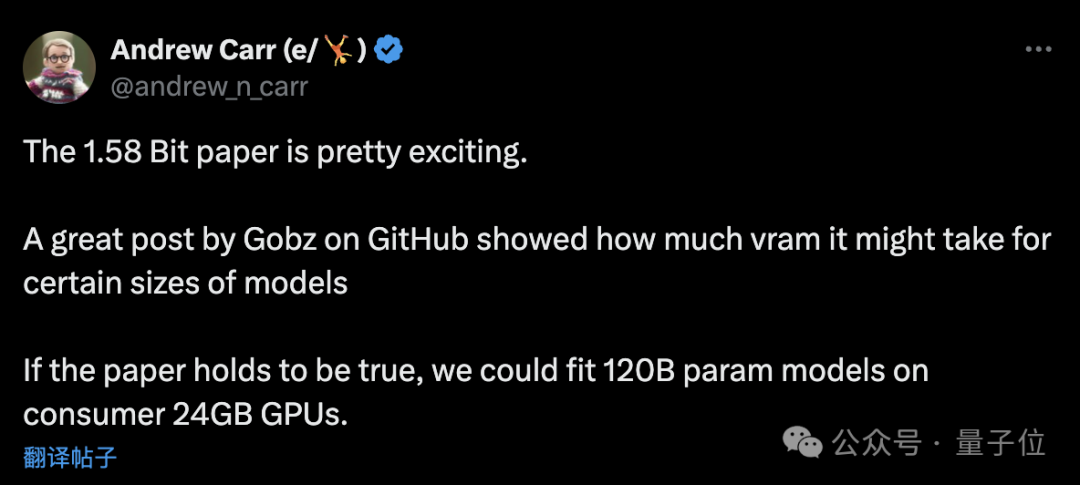
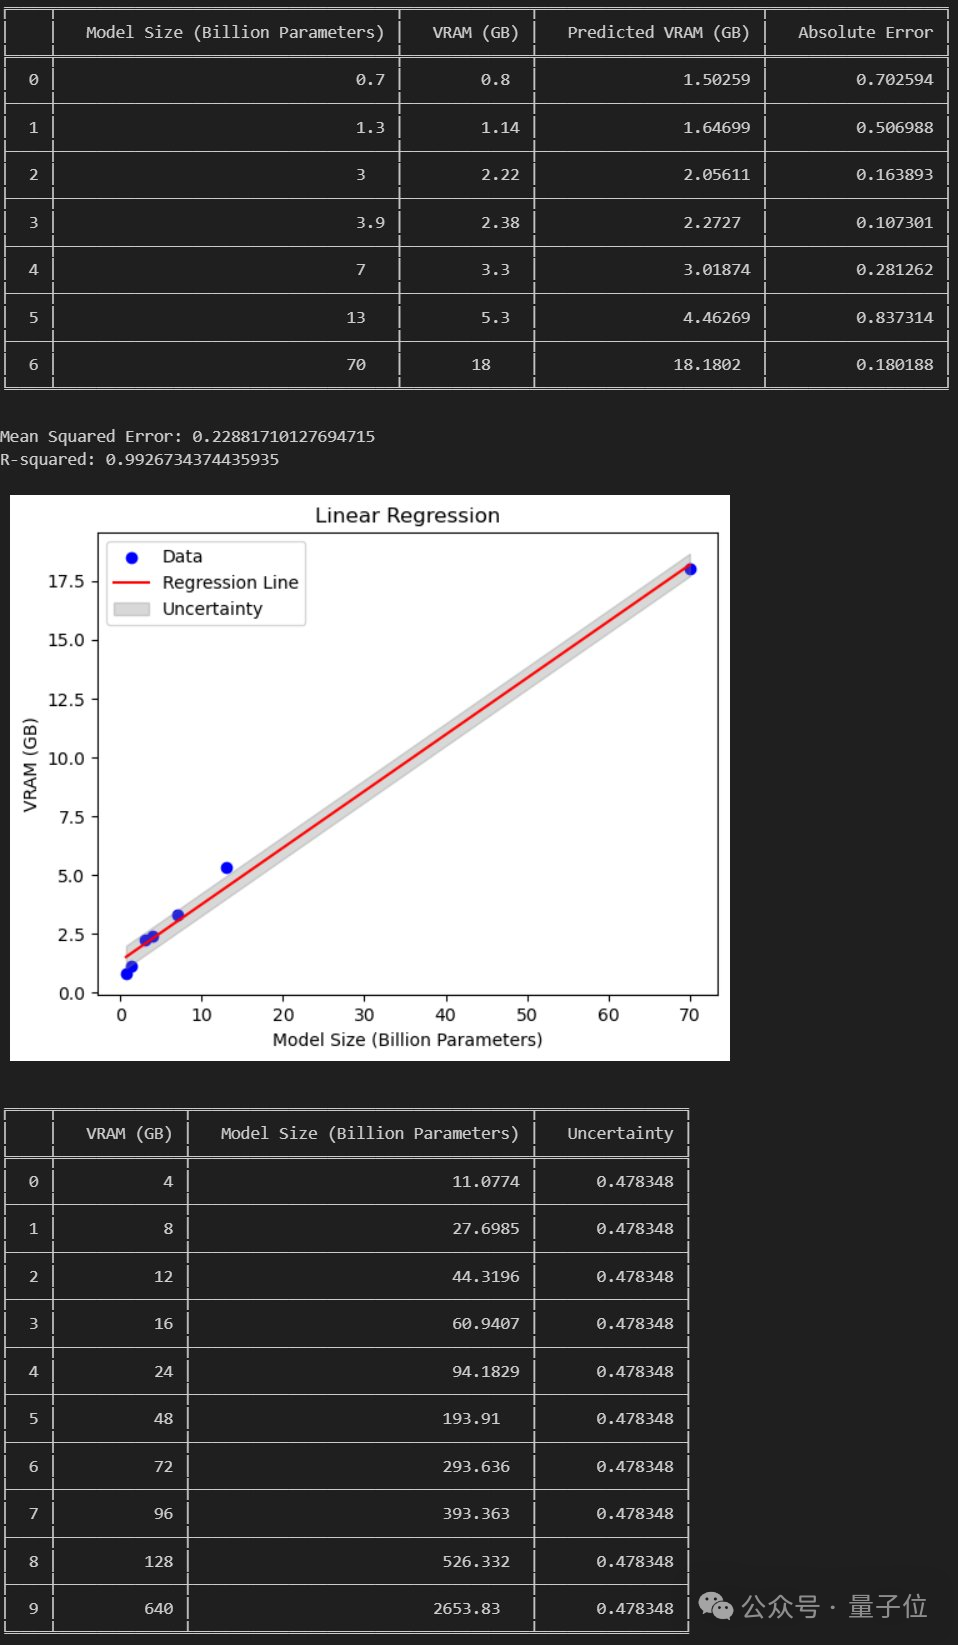
不过也有网友分析认为:
若论文成立,那么我们就能在24GB消费级GPU上跑120B的大模型了。
那么你觉得这种新方法如何呢?
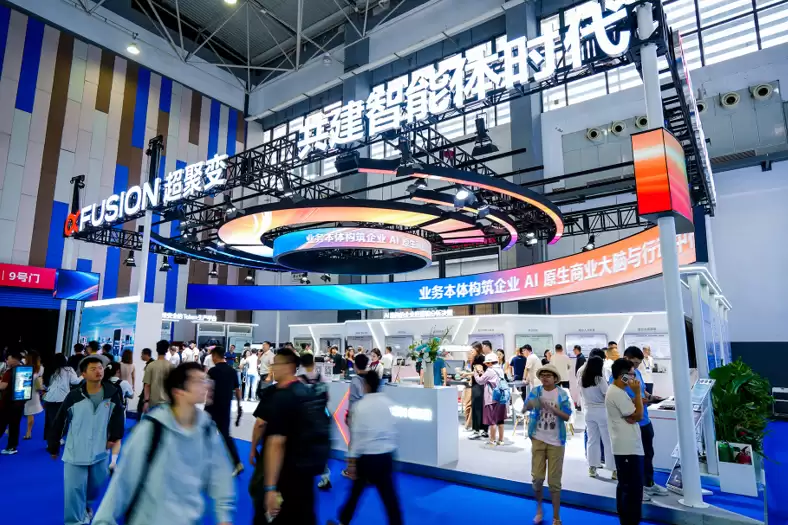
本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。
从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
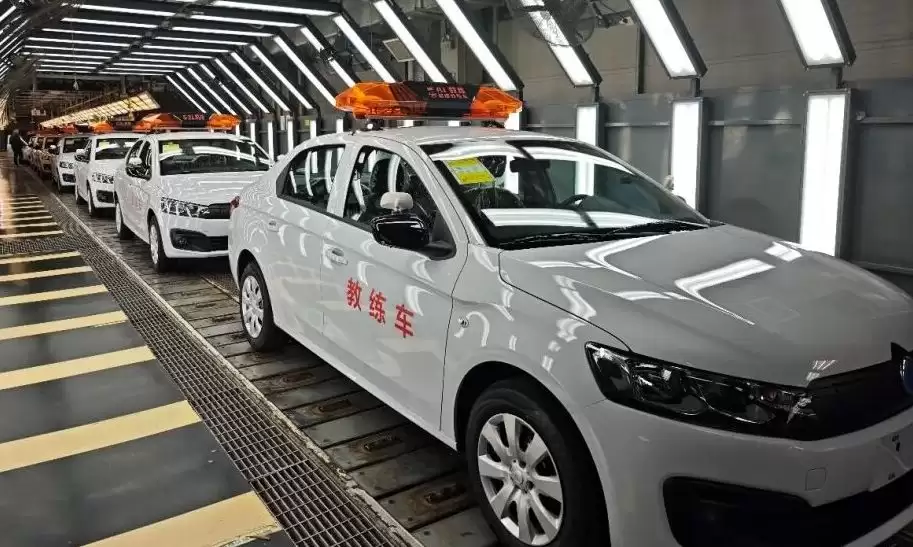
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
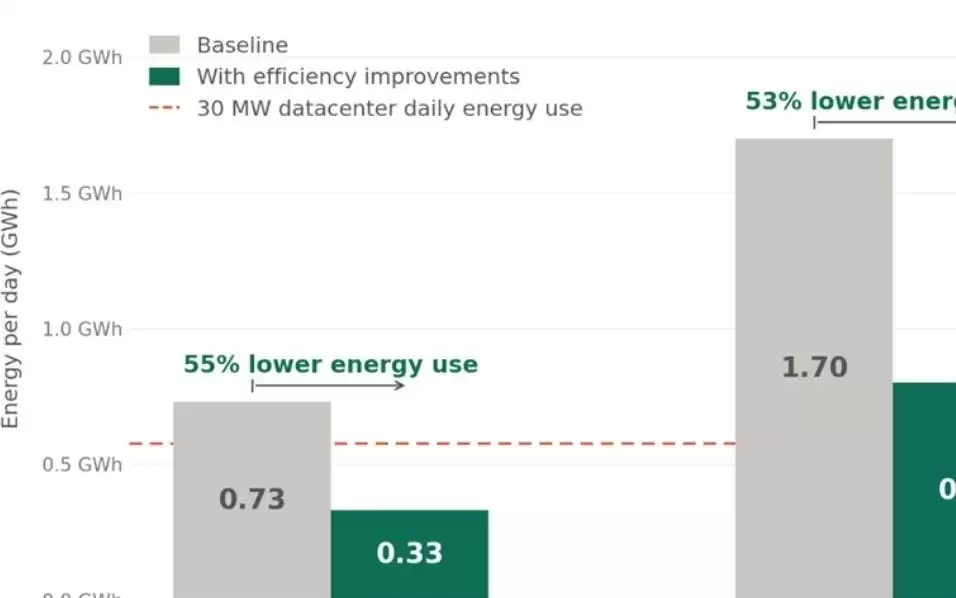
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。
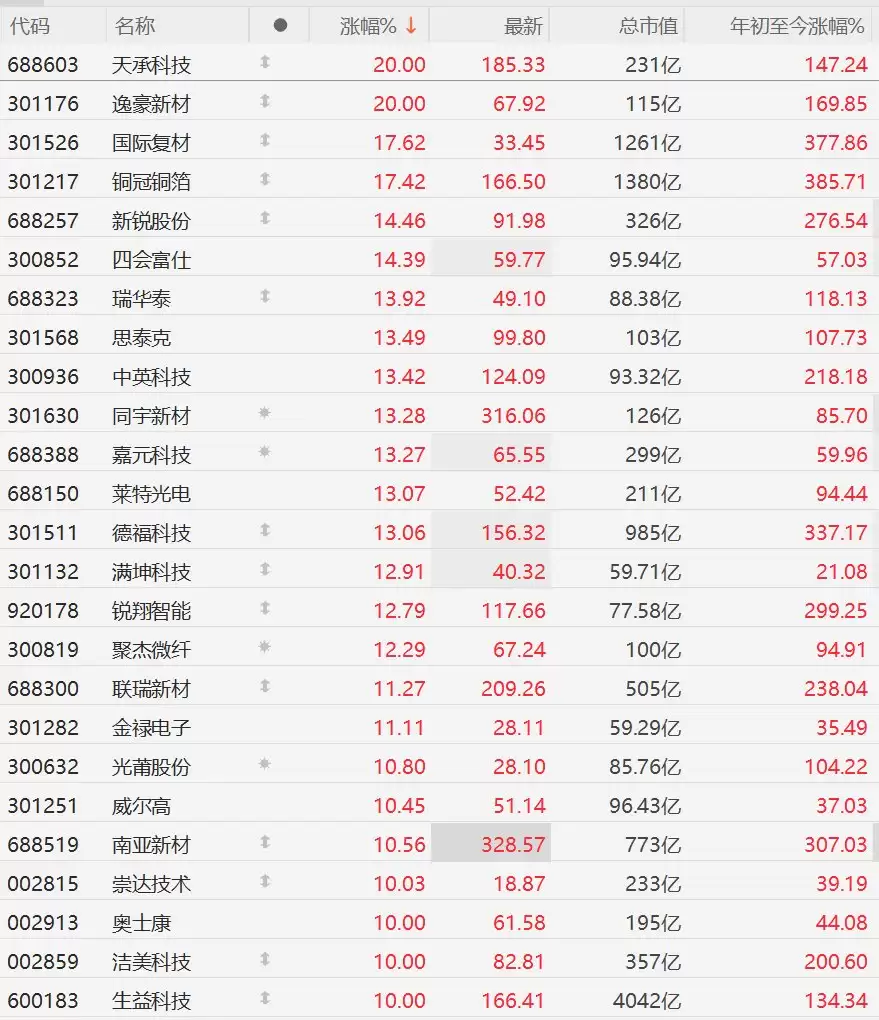
A股PCB概念板块掀起涨停潮,因摩根士丹利报告预测AI光模块PCB市场三年增长超5倍,2025至2028年规模从6.2亿美元增至37.7亿美元,年复合增速高达83%,远超光模块整体增速。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。