

复旦等推出AnyGPT:支持多种输入输出模态,包括图像、音乐、文本和语音
最近,OpenAI的视频生成模型Sora爆火,生成式AI模型在多模态方面的能力再次引起广泛关注。现实世界本质上是多模态的,生物体通过不同的渠道感知和交换信息,包括视觉、语言、声音和触觉。开发多模态系统的一个有望方向是增强LLM的多模态感知能力,主要涉及多模态编码器与语言模型的集成,从而使其能够跨各种模态处理信息,并利用LLM的文本处理能力来产生连贯的响应。然而,这一策略仅仅适用于文本生成,并不涵盖多模态输出。一些开拓性的研究在语言模型中实现了多模态理解和生成,取得了重大进展,但这些模型仅限于单一的非文本模
最近,OpenAI 的视频生成模型 Sora 爆火,生成式 AI 模型在多模态方面的能力再次引起广泛关注。
现实世界本质上是多模态的,生物体通过不同的渠道感知和交换信息,包括视觉、语言、声音和触觉。开发多模态系统的一个有望方向是增强 LLM 的多模态感知能力,主要涉及多模态编码器与语言模型的集成,从而使其能够跨各种模态处理信息,并利用 LLM 的文本处理能力来产生连贯的响应。
然而,这一策略仅仅适用于文本生成,并不涵盖多模态输出。一些开拓性的研究在语言模型中实现了多模态理解和生成,取得了重大进展,但这些模型仅限于单一的非文本模态,比如图像或音频。
为了解决上述问题,复旦大学邱锡鹏团队联合 Multimodal Art Projection(MAP)、上海人工智能实验室的研究者提出了一种名为 AnyGPT 的多模态语言模型,该模型能够以任意的模态组合来理解和推理各种模态的内容。具体来说,AnyGPT 可以理解文本、语音、图像、音乐等多种模态交织的指令,并能熟练地选择合适的多模态组合进行响应。
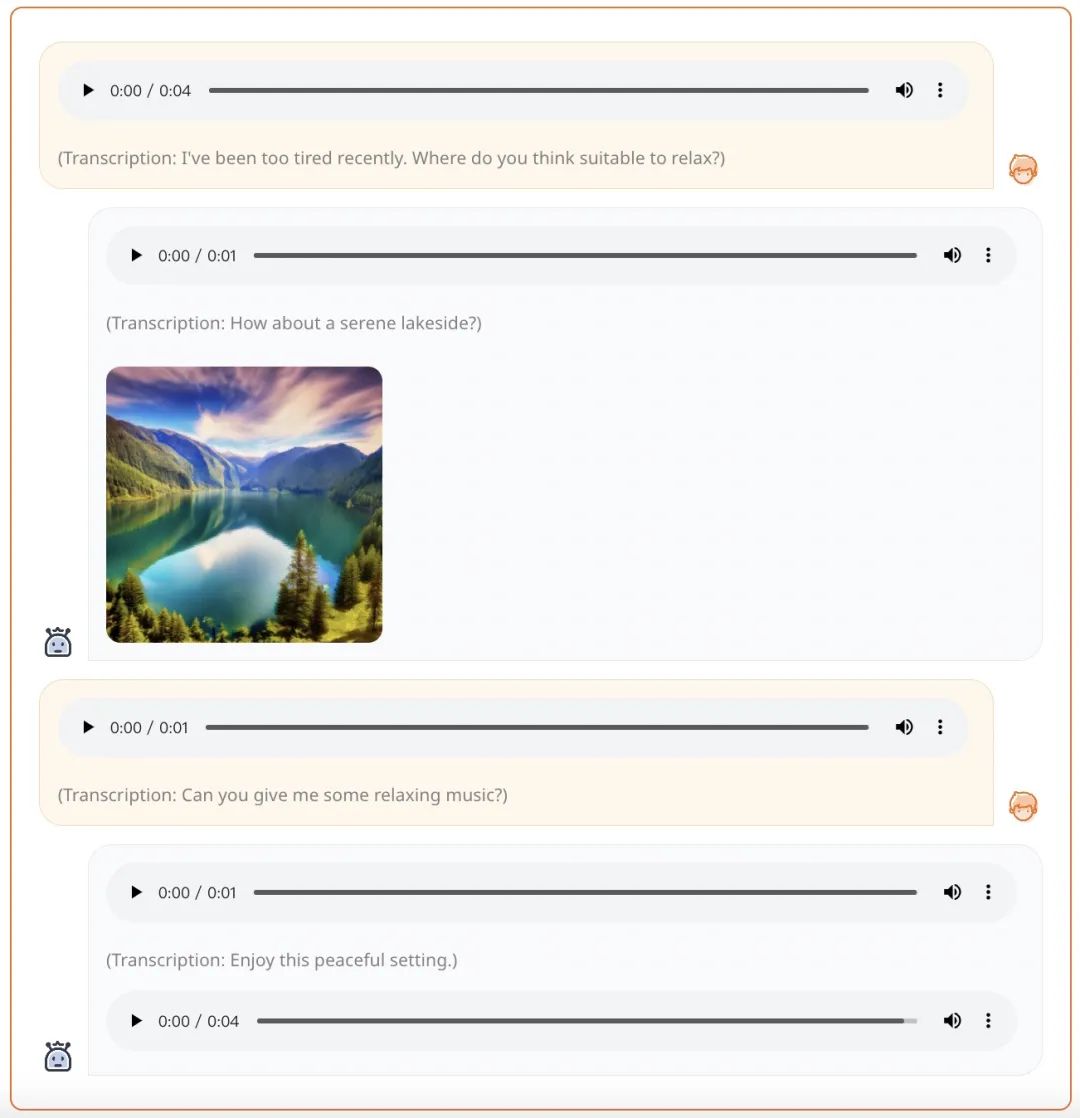
例如给出一段语音 prompt,AnyGPT 能够生成语音、图像、音乐形式的综合响应:
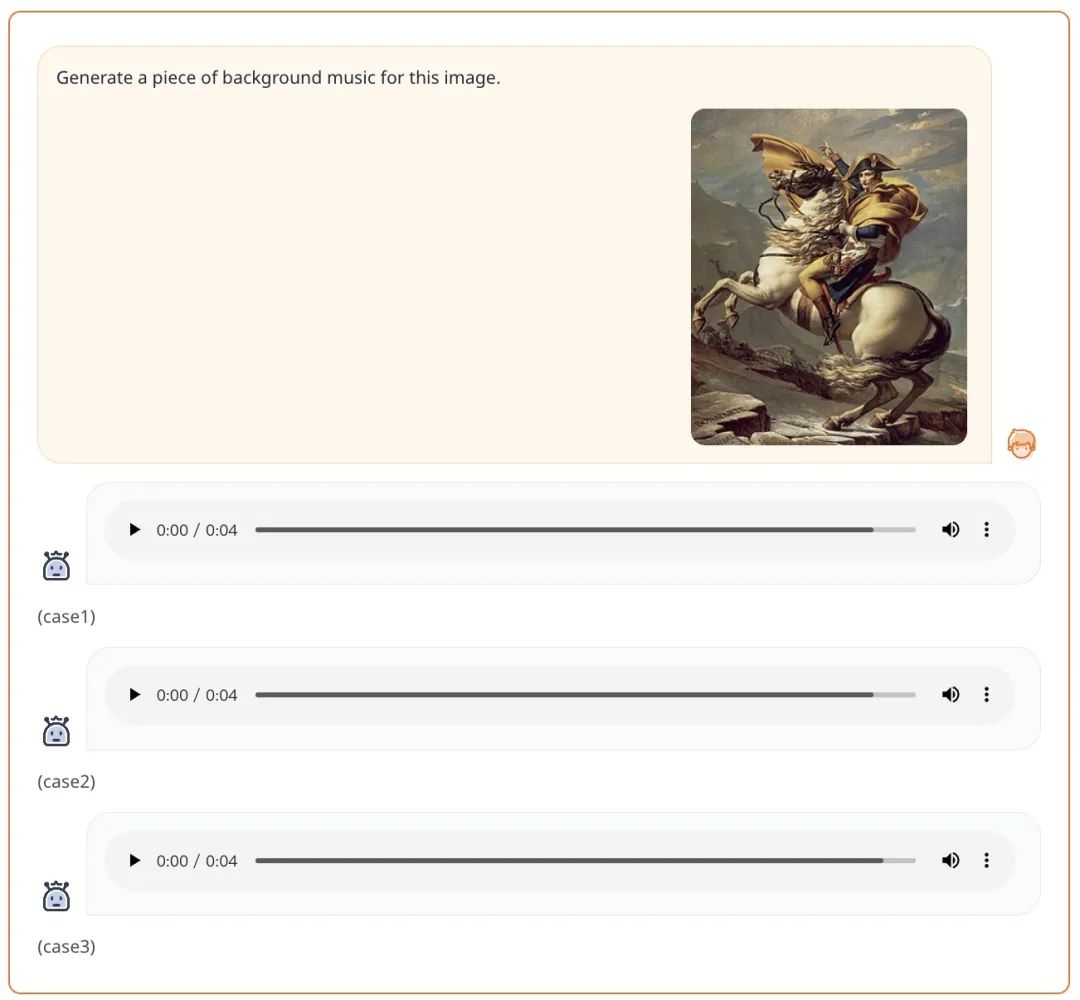
给出文本 + 图像形式的 prompt,AnyGPT 能够按照 prompt 要求生成音乐:
- 论文地址:https://arxiv.org/pdf/2402.12226.pdf
- 项目主页:https://junzhan2000.github.io/AnyGPT.github.io/
方法简介
AnyGPT 利用离散表征来统一处理各种模态,包括语音、文本、图像和音乐。
为了完成任意模态到任意模态的生成任务,该研究提出了一个可以统一训练的综合框架。如下图 1 所示,该框架由三个主要组件组成,包括:
- 多模态 tokenizer
- 作为主干网络的多模态语言模型
- 多模态 de-tokenizer
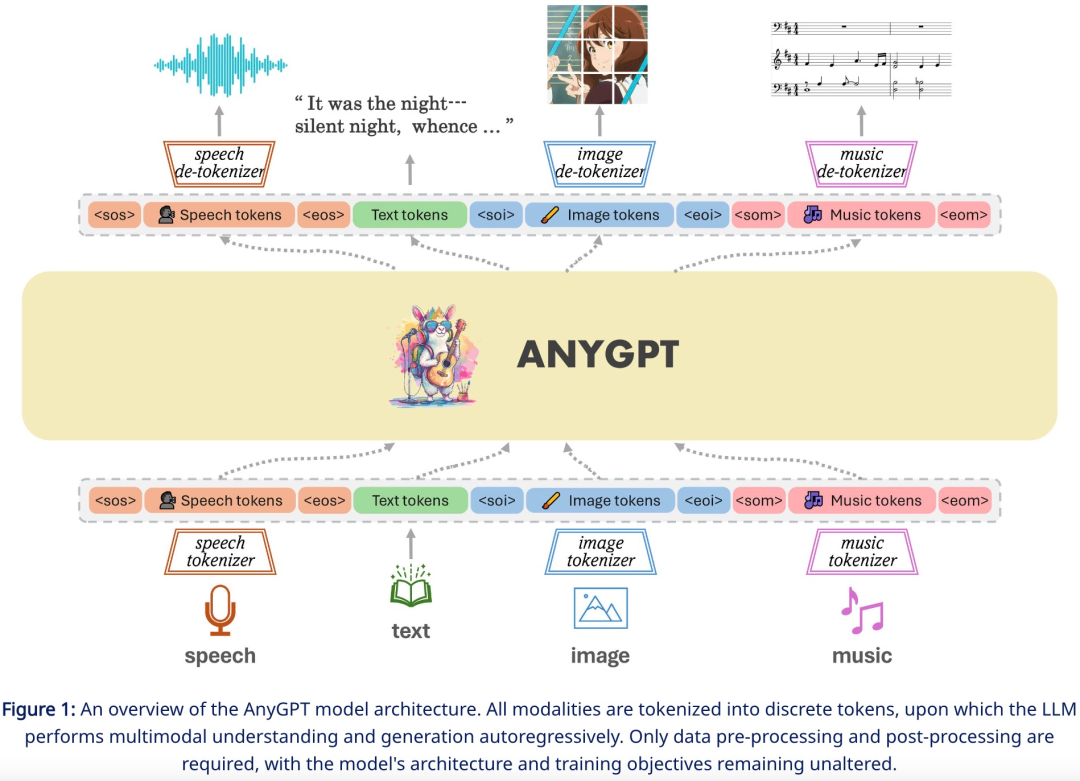
其中,tokenizer 将连续的非文本模态转换为离散的 token,随后将其排列成多模态交错序列。然后,语言模型使用下一个 token 预测训练目标进行训练。在推理过程中,多模态 token 被相关的 de-tokenizer 解码回其原始表征。为了丰富生成的质量,可以部署多模态增强模块来对生成的结果进行后处理,包括语音克隆或图像超分辨率等应用。
AnyGPT 可以稳定地训练,无需对当前的大型语言模型(LLM)架构或训练范式进行任何改变。相反,它完全依赖于数据级预处理,使得新模态无缝集成到 LLM 中,类似于添加新语言。
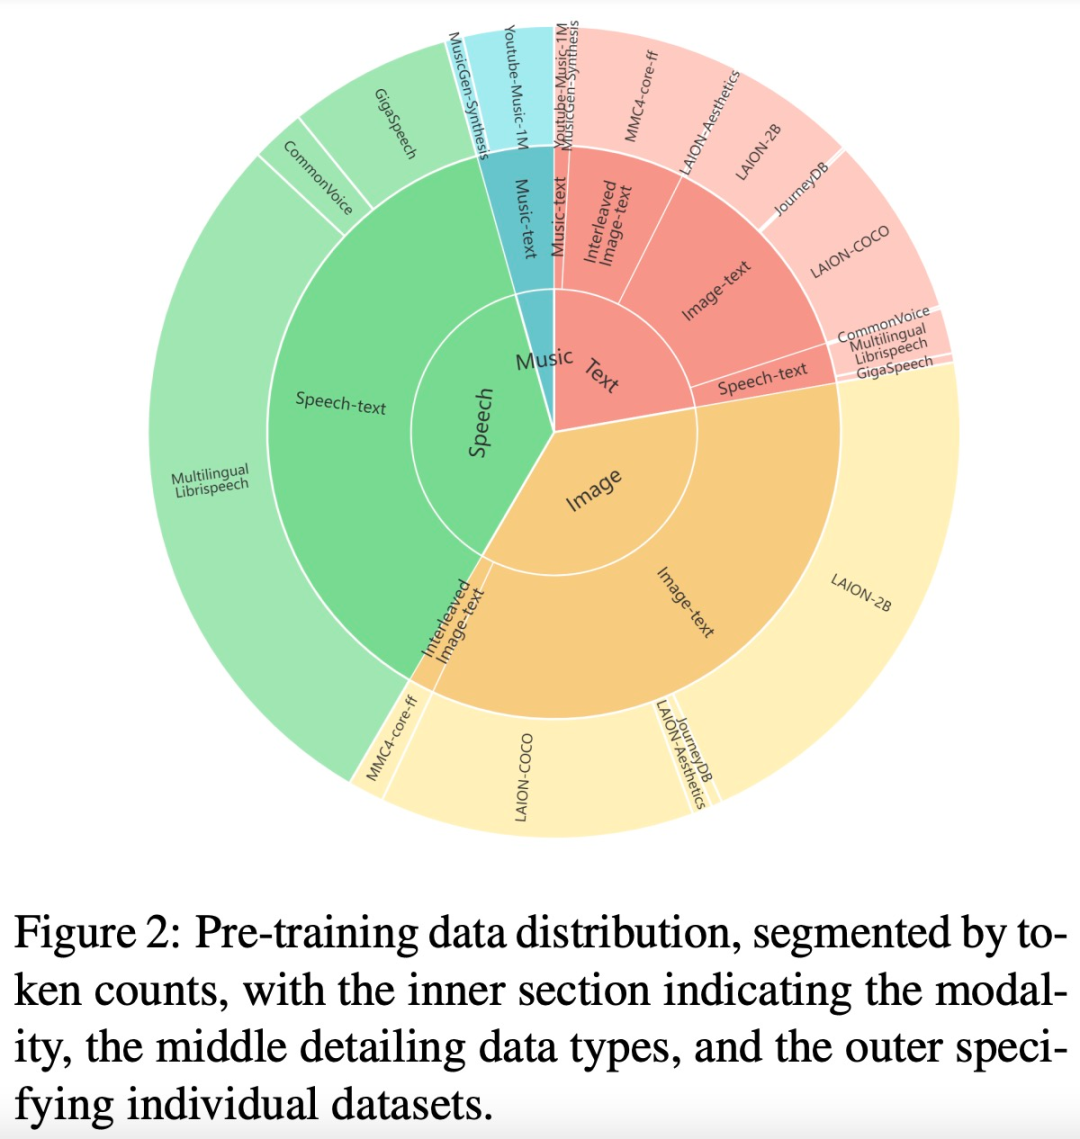
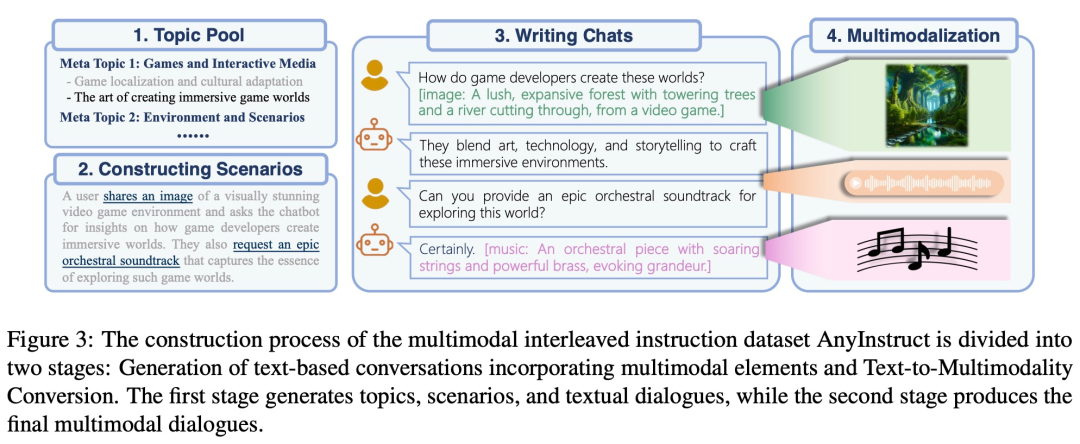
这项研究的一个关键挑战是缺乏多模态交错指令跟踪数据。为了完成多模态对齐预训练,研究团队利用生成模型合成了第一个大规模「任意对任意」多模态指令数据集 ——AnyInstruct-108k。它由 108k 多轮对话样本组成,这些对话错综复杂地交织着各种模态,从而使模型能够处理多模态输入和输出的任意组合。
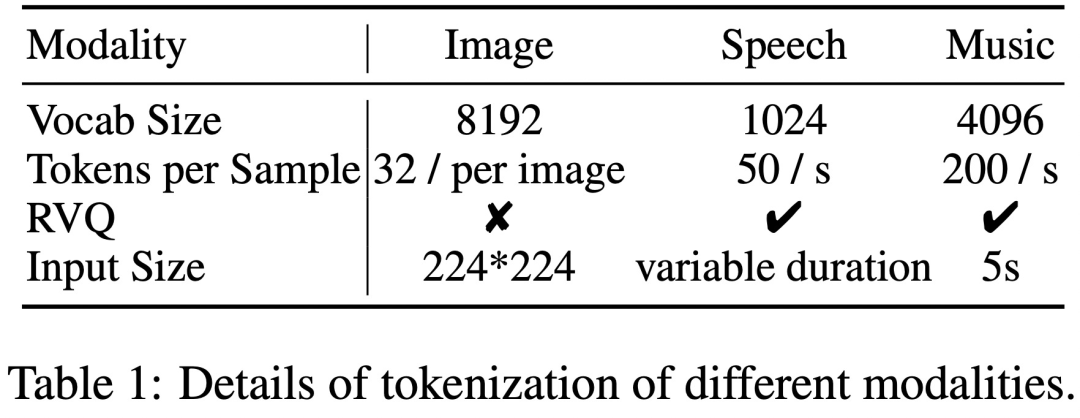
这些数据通常需要大量比特才能准确表征,从而导致序列较长,这对语言模型的要求特别高,因为计算复杂度随着序列长度呈指数级增加。为了解决这个问题,该研究采用了两阶段的高保真生成框架,包括语义信息建模和感知信息建模。首先,语言模型的任务是生成在语义层面经过融合和对齐的内容。然后,非自回归模型在感知层面将多模态语义 token 转换为高保真多模态内容,在性能和效率之间取得平衡。
实验
实验结果表明,AnyGPT 能够完成任意模态对任意模态的对话任务,同时在所有模态中实现与专用模型相当的性能,证明离散表征可以有效且方便地统一语言模型中的多种模态。
该研究评估了预训练基础 AnyGPT 的基本功能,涵盖所有模态的多模态理解和生成任务。该评估旨在测试预训练过程中不同模态之间的一致性,具体来说是测试了每种模态的 text-to-X 和 X-to-text 任务,其中 X 分别是图像、音乐和语音。
为了模拟真实场景,所有评估均以零样本模式进行。这意味着 AnyGPT 在评估过程中不会对下游训练样本进行微调或预训练。这种具有挑战性的评估设置要求模型泛化到未知的测试分布。
评估结果表明,AnyGPT 作为一种通用的多模态语言模型,在各种多模态理解和生成任务上取得了令人称赞的性能。
图像
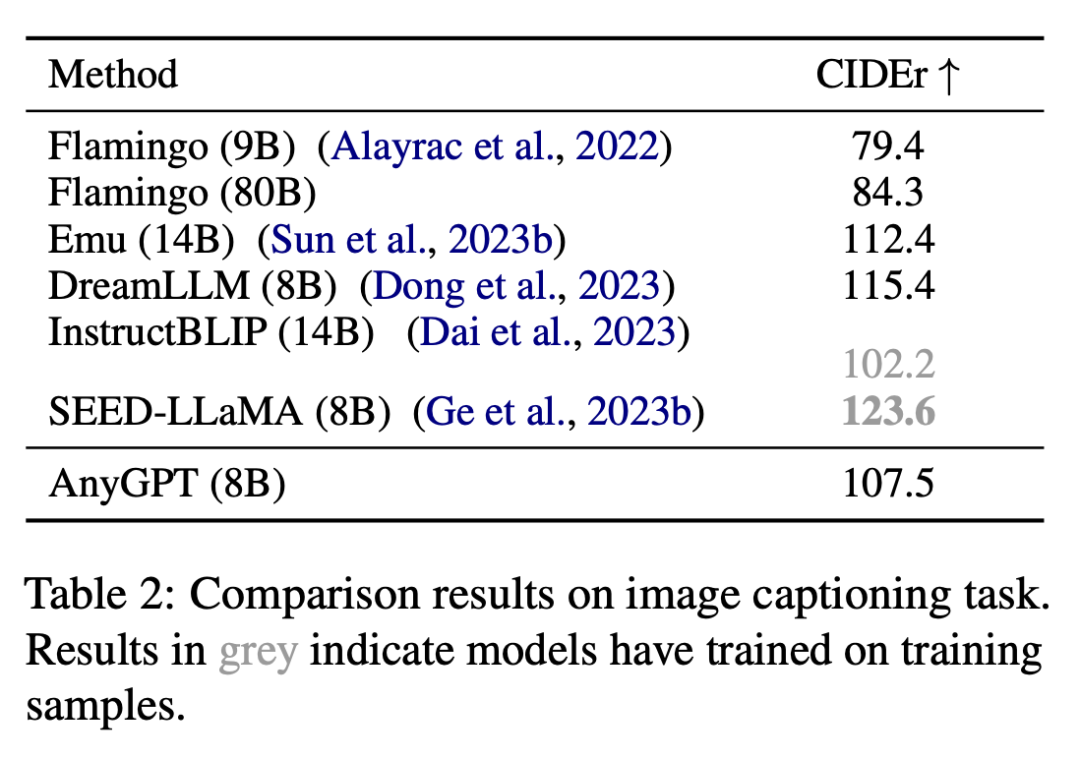
该研究评估了 AnyGPT 在图像描述任务上的图像理解能力,结果如表 2 所示。
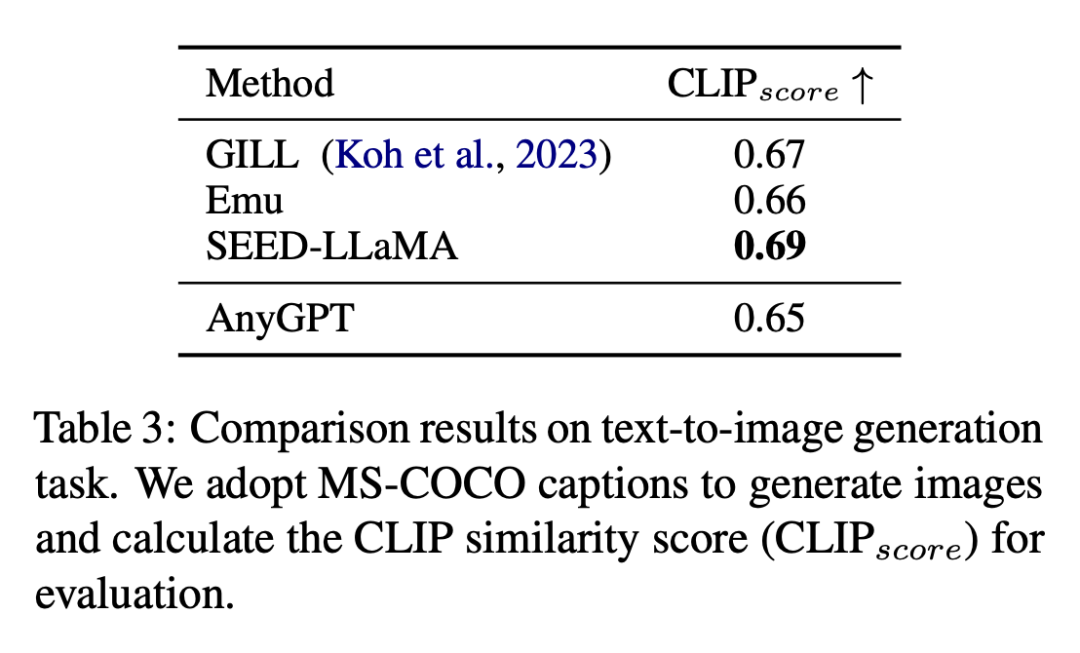
文本到图像生成任务的结果如表 3 所示。
 语音
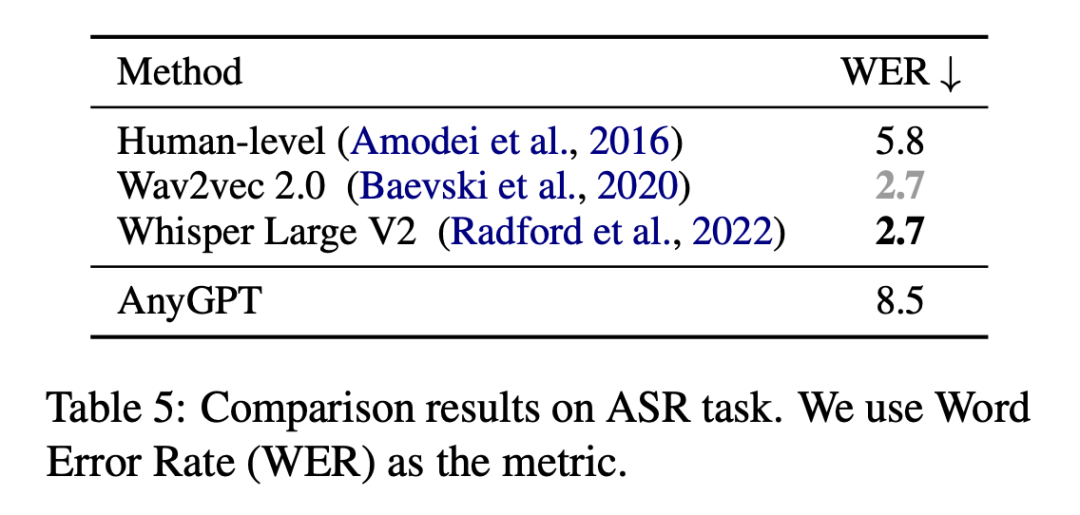
该研究通过计算 LibriSpeech 数据集的测试子集上的词错误率 (WER) 来评估 AnyGPT 在自动语音识别 (ASR) 任务上的性能,并使用 Wav2vec 2.0 和 Whisper Large V2 作为基线,评估结果如表 5 所示。
音乐
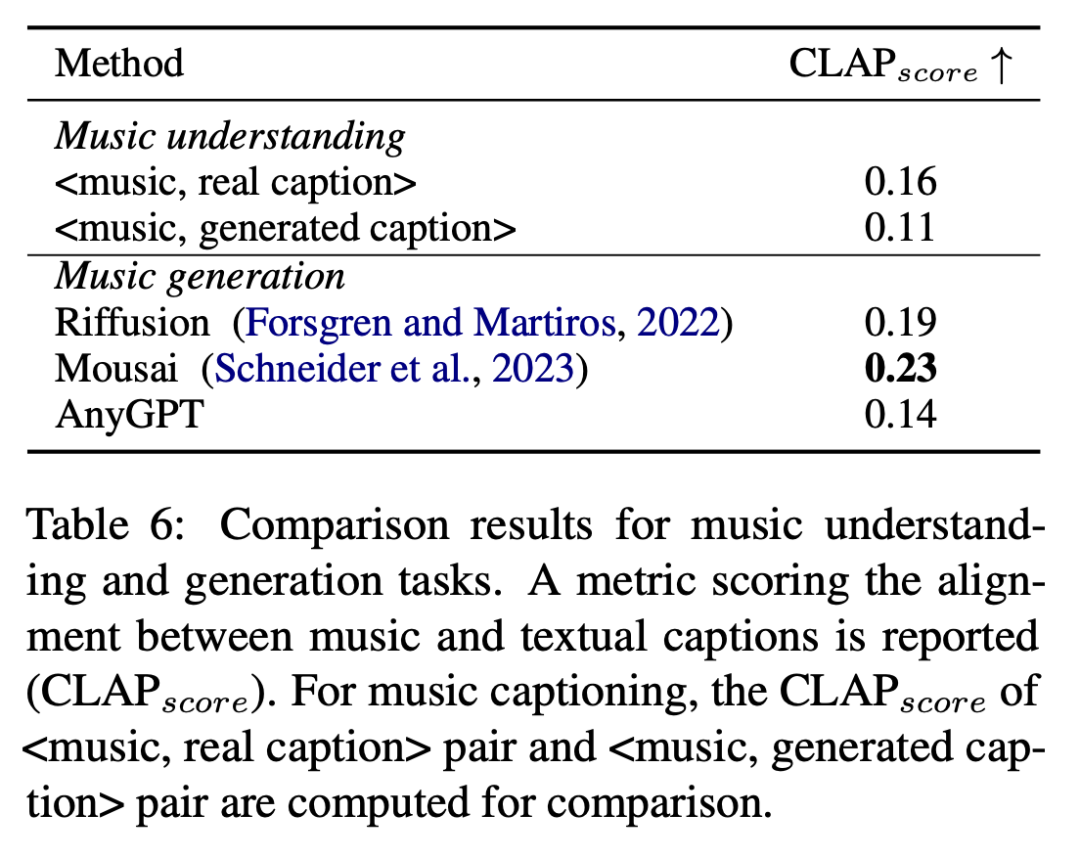
该研究在 MusicCaps 基准上评估了 AnyGPT 在音乐理解和生成任务方面的表现,采用 CLAP_score 分数作为客观指标,衡量生成的音乐和文本描述之间的相似度,评估结果如表 6 所示。
感兴趣的读者可以阅读论文原文,了解更多研究内容。
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
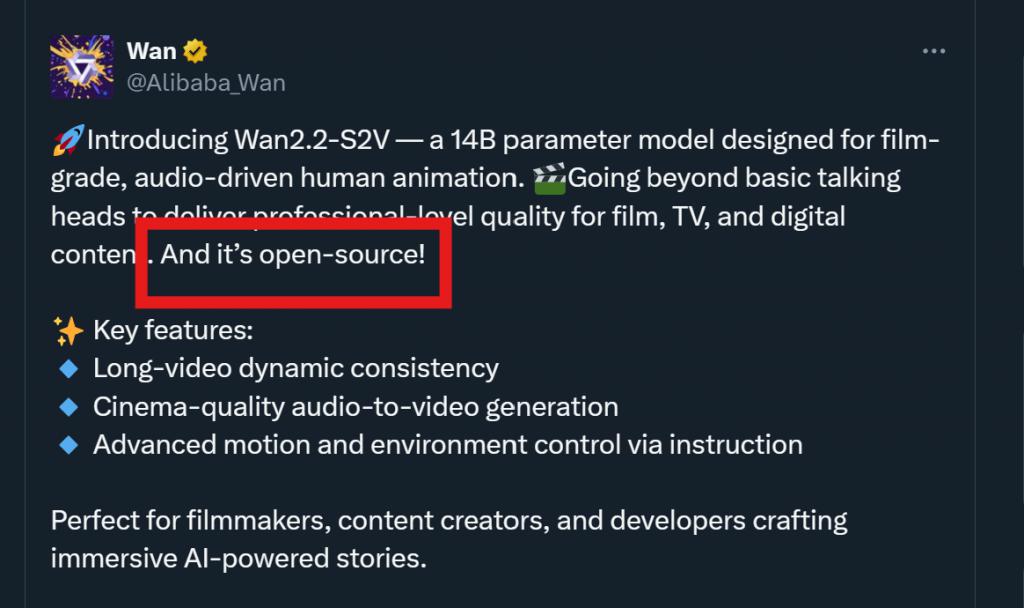
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
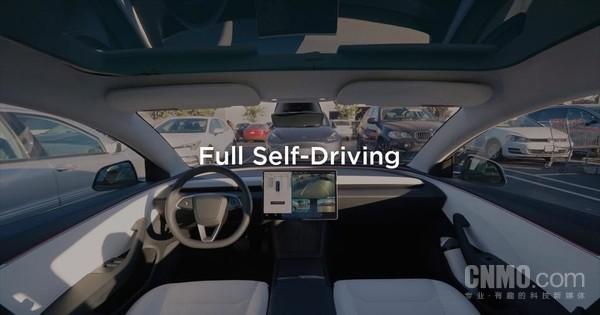
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
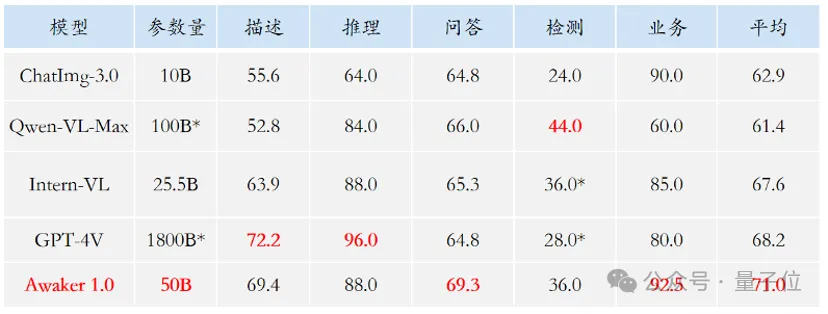
哭死啊,全球狂炼大模型,一互联网的数据不够用,根本不够用。训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。尤其在多模态任务中,这一问题尤为突出。一筹莫展之际,来自人大系的初创团队,用自家的新模型,率先在国内把“模型生成数据自己喂自己”变成了现实。而且还是理解侧和生成侧双管齐下,两侧都能生成高质量、多模态的新数据,对模型本身进行数据反哺。模型是啥?中关村论坛上刚刚露面的多模态大模型Awaker1.0。团队是谁?智子引擎。由人大高瓴人工智能学院博士生高一钊创立,高瓴人工智能
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



