

田渊栋团队成功解决内存限制,发布一块预训练规模为7B的4090模型
MetaFAIR田渊栋参与的研究项目在上个月获得了广泛好评。在他们的论文《MobileLLM:OptimizingSub-billionParameterLanguageModelsforOn-DeviceUseCases》中,他们开始探讨如何优化10亿以下参数的小型模型,旨在实现在移动设备上运行大型语言模型的目标。3月6日,田渊栋团队发布了最新的研究成果,这次专注于提高LLM内存的效率。除了田渊栋本人,研究团队还包括来自加州理工学院、德克萨斯大学奥斯汀分校以及CMU的研究人员。这项研究旨在进一步优化LL
Meta FAIR 田渊栋参与的研究项目在上个月获得了广泛好评。在他们的论文《MobileLLM: Optimizing Sub-billion Parameter Language Models for On-Device Use Cases》中,他们开始探讨如何优化10亿以下参数的小型模型,旨在实现在移动设备上运行大型语言模型的目标。
3 月 6 日,田渊栋团队发布了最新的研究成果,这次专注于提高LLM内存的效率。除了田渊栋本人,研究团队还包括来自加州理工学院、德克萨斯大学奥斯汀分校以及CMU的研究人员。这项研究旨在进一步优化LLM内存的性能,为未来的技术发展提供支持和指导。
他们联合提出了一种名为 GaLore(Gradient Low-Rank Projection)的训练策略,这种策略允许全参数学习,相比于 LoRA 等常见的低秩自适应方法,GaLore具有更高的内存效率。
这项研究首次表明,在配备 24GB 内存的消费级 GPU(例如 NVIDIA RTX 4090)上,可以成功地进行 7B 模型的预训练,而无需使用模型并行、检查点或卸载策略。

论文地址:https://arxiv.org/abs/2403.03507
论文标题:GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection
接下来我们看看文章主要内容。
当前,大型语言模型(LLM)在多个领域展现出卓越的潜力,但我们也必须正视一个现实问题,那就是预训练和微调LLM不仅需要大量的计算资源,还需要大量的内存支持。
LLM 对内存的需求不仅包括以亿计算的参数,还包括梯度和 Optimizer States(例如 Adam 中的梯度动量和方差),这些参数可能大于存储本身。举例来说,使用单个批大小且从头开始预训练的 LLaMA 7B ,需要至少 58 GB 内存(14 GB 用于可训练参数,42 GB 用于 Adam Optimizer States 和权重梯度,2 GB 用于激活)。这使得训练 LLM 在消费级 GPU(例如具有 24GB 内存的 NVIDIA RTX 4090)上变得不可行。
为了解决上述问题,研究人员不断开发各种优化技术,以减少预训练和微调期间的内存使用。
该方法在 Optimizer States 下将内存使用量减少了 65.5%,同时还能保持在 LLaMA 1B 和 7B 架构上使用最多 19.7B token 的 C4 数据集进行预训练的效率和性能,以及在 GLUE 任务上微调 RoBERTa 的效率和性能。与 BF16 基准相比,8-bit GaLore 进一步减少了优化器内存达 82.5%,总训练内存减少了 63.3%。
看到这项研究后,网友表示:「是时候忘记云、忘记 HPC 了,有了 GaLore,所有的 AI4Science 都将在 2000 美元的消费级 GPU 上完成。」

田渊栋表示:「有了 GaLore,现在可以在具有 24G 内存的 NVidia RTX 4090s 中预训练 7B 模型了。
我们没有像 LoRA 那样假设低秩权重结构,而是证明权重梯度自然是低秩的,因此可以投影到(变化的)低维空间中。因此,我们同时节省了梯度、Adam 动量和方差的内存。
因此,与 LoRA 不同,GaLore 不会改变训练动态,可用于从头开始预训练 7B 模型,无需任何内存消耗的预热。GaLore 也可用于进行微调,产生与 LoRA 相当的结果」。

方法介绍
前面已经提到,GaLore 是一种允许全参数学习的训练策略,但比常见的低秩自适应方法(例如 LoRA)更节省内存。GaLore 关键思想是利用权重矩阵 W 的梯度 缓慢变化的低秩结构,而不是试图将权重矩阵直接近似为低秩形式。
本文首先从理论上证明了梯度矩阵 G 在训练过程中会变成低秩,在理论的基础上,本文用 GaLore 来计算两个投影矩阵  和
 将梯度矩阵 G 投影成低秩形式 P^⊤GQ。在这种情况下,依赖于组件梯度统计的 Optimizer States 的内存成本可以大大减少。如表 1 所示,GaLore 的内存效率比 LoRA 更高。实际上,与 LoRA 相比,在预训练期间,这可减少高达 30% 的内存。

本文证明了 GaLore 在预训练和微调方面表现良好。当在 C4 数据集上预训练 LLaMA 7B 时,8-bit GaLore 结合了 8-bit 优化器和逐层权重更新技术,实现了与全秩相当的性能,并且 optimizer state 的内存成本不到 10%。
值得注意的是,对于预训练,GaLore 在整个训练过程中保持低内存,而不需要像 ReLoRA 那样进行全秩训练。得益于 GaLore 的内存效率,这是首次可以在具有 24GB 内存的单个 GPU(例如,在 NVIDIA RTX 4090 上)上从头开始训练 LLaMA 7B,而无需任何昂贵的内存卸载技术(图 1)。

作为一种梯度投影方法,GaLore 与优化器的选择无关,只需两行代码即可轻松插入现有优化器,如算法 1 所示。

下图为将 GaLore 应用于 Adam 的算法:

实验及结果
研究者对 GaLore 的预训练和 LLM 的微调进行了评估。所有实验均在英伟达 A100 GPU 上进行。
为了评估其性能,研究者应用 GaLore 在 C4 数据集上训练基于 LLaMA 的大型语言模型。C4 数据集是 Common Crawl 网络抓取语料库的一个巨大的净化版本,主要用于预训练语言模型和单词表征。为了最好地模拟实际的预训练场景,研究者在不重复数据的情况下,对足够大的数据量进行训练,模型大小范围可达 70 亿个参数。
本文沿用了 Lialin 等人的实验设置,采用了基于 LLaMA3 的架构,带有 RMSNorm 和 SwiGLU 激活。对于每种模型大小,除了学习率之外,他们使用了相同的超参数集,并以 BF16 格式运行所有实验,以减少内存使用,同时在计算预算相同的情况下调整每种方法的学习率,并报告最佳性能。
此外,研究者使用 GLUE 任务作为 GaLore 与 LoRA 进行内存高效微调的基准。GLUE 是评估 NLP 模型在各种任务中性能的基准,包括情感分析、问题解答和文本关联。
本文首先使用 Adam 优化器将 GaLore 与现有的低秩方法进行了比较,结果如表 2 所示。

研究者证明,GaLore 可以应用于各种学习算法,尤其是内存高效的优化器,以进一步减少内存占用。研究者将 GaLore 应用于 AdamW、8 bit Adam 和 Adafactor 优化器。他们采用一阶统计的 Adafactor,以避免性能下降。
实验在具有 10K 训练步数的 LLaMA 1B 架构上对它们进行了评估,调整了每种设置的学习率,并报告了最佳性能。如图 3 所示,下图表明,GaLore 可适用于流行的优化器,例如 AdamW、8-bit Adam 和 Adafactor。此外,引入极少数超参数不会影响 GaLore 的性能。

如表 4 所示,在大多数任务中,GaLore 都能以更少的内存占用获得比 LoRA 更高的性能。这表明,GaLore 可以作为一种全栈内存高效训练策略,用于 LLM 预训练和微调。

如图 4 所示,与 BF16 基准和 8 bit Adam 相比,8 bit GaLore 所需的内存要少得多,在预训练 LLaMA 7B 时仅需 22.0G 内存,且每个 GPU 的 token 批量较小(最多 500 个 token)。

更多技术细节,请阅读论文原文。

近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫

在千兆宽带、5G通信与云服务深度普及的2026年,大众普遍以为超大文件传输已步入“秒级时代”,但现实远未达到这般畅快。当面对数TB乃至数十TB级别的庞大数据集时,当下最可靠、最迅捷且兼顾安全性的传输方案,依然是“物理位移”——依靠人工携带存储介质完成跨地域交付。一位来自河南信阳的用户讲述了真实经历:他曾需将4TB资料从信阳送往郑州,首次尝试纯网络传输,系统预估总耗时近72小时;最终改用专人驱车运送,单程仅需约2.5小时,当天即完成取件与送达,整体效率显著超越线上方式。该实例迅速引发热议,多位资深IT博主随
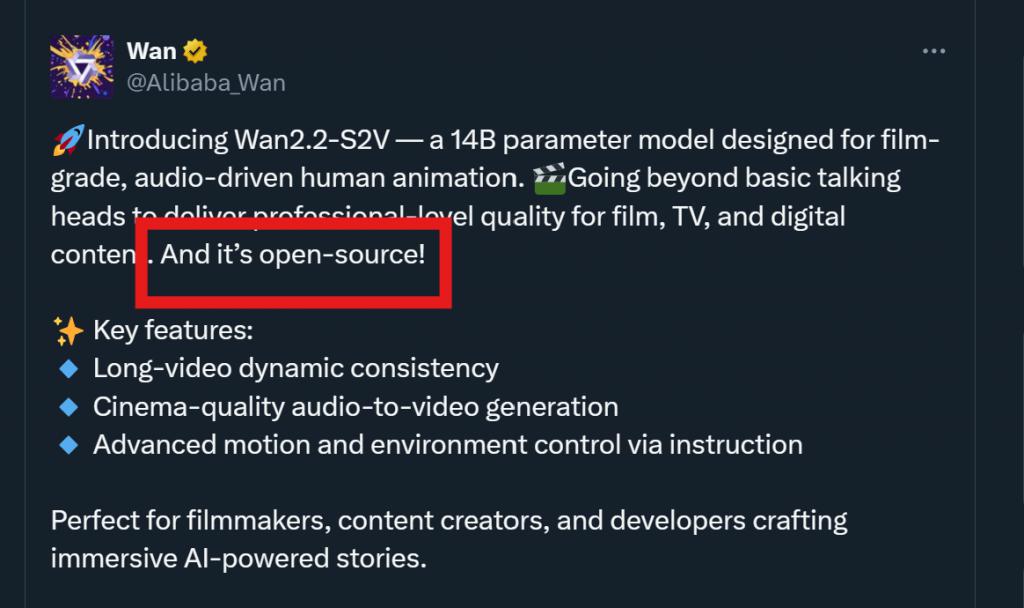
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及

大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型

强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足

无论是专业摄影师还是摄影爱好者,相机内存储卡的可靠性都至关重要,尤其是在恶劣的拍摄环境中,数据存储的安全性更是不可忽视。尽管市场上有多种支持三防功能的移动存储设备用于数据备份,但最常用的SD存储卡由于采用塑料外壳,长期使用后容易出现破损,导致数据损坏,甚至可能损坏相机的存储卡槽,带来的损失不可估量。国际存储品牌雷克沙推出了全新的Armor系列SD存储卡,不仅读写速度快,还采用了不锈钢材质的外壳,具有优异的防水、防尘和防跌落性能,为相机的原始拍摄数据提供了可靠的保护。雷克沙ArmorSD存储卡分为GOLD


1.1计算机发展历程[计组]1.0_你好,我是计算机组成原理我们生活在一个信息化程度极高的世界中,我们每天的生活都离不开电脑和手机,这些设备实际上都属于计算机的范畴。计算机的底层结构由硬件构成,在硬件之上,我们会安装操作系统,再在操作系统上运行各种应用软件,这样就能得到一个易于使用的计算机系统。通过计算机网络,这些设备实现了信息的互联互通,这正是我们现在生活的信息化世界的缩影。计算机组成原理这门课研究的就是这些计算机硬件在底层如何协同工作。既然我们要研究硬件,不妨先来看一下大家日常生活中常见的一些硬件






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
