

是一种图片文字识别软件。FineReader提供快速、准确、方便的方式来扫描文件、PDF格式、数字或移动电话图像转换成可编辑的格式
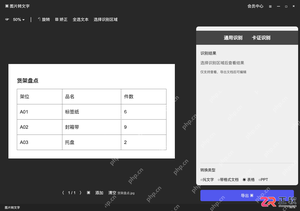
面向需要快速数字化纸质单据的办公人员,本文介绍如何将货架盘点表等纸质表格通过拍照转换为可编辑的Excel文件。针对拍摄反光、识别错位及数据遗漏等常见痛点,详细拆解拍摄规范、区域框选、格式导出及数据校验四个关键步骤。重点讲解如何确保表头与边框完整入镜、排除无关手写批注干扰,以及利用SUM函数核对件数合计以验证识别准确性,帮助用户高效完成从图片到结构化数据的转换。
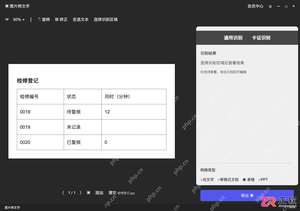
面向需要利用WPS AI从图片中提取结构化数据的办公用户,解决OCR识别中常见的字符误读、网格错位及数据类型丢失问题。本文以检修登记表为例,详解从原图矫正、相似字符(如0与O)排查、空白值与零值区分,到导出后设置文本格式及公式核验的全流程。通过规范图像预处理和严格的后期校验步骤,确保提取数据的准确性与可用性,避免前导零丢失或统计偏差。
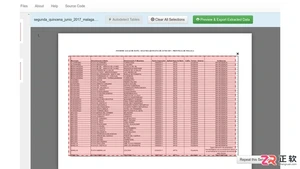
针对PDF表格提取需求,本文根据文件类型推荐三款工具。文字型PDF可使用Tabula进行框选导出,或直接用Excel Power Query获取数据并清洗;扫描件或图片型PDF则需借助ABBYY FineReader PDF的OCR功能识别后再导出。文章详细说明了各软件的操作步骤及注意事项,帮助用户解决错列、漏行及数字精度丢失等常见痛点,确保提取数据的准确性。
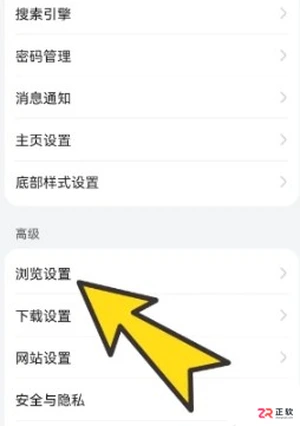
面向追求轻量化浏览体验及移动端阅读需求的用户,BoBo浏览器极速版凭借小巧安装包、智能广告过滤及内置电子书阅读器解决卡顿与干扰痛点。本文详解该版本的核心特色,重点演示如何在设置中开启“锁定横屏”功能以优化视频观看体验,并介绍无痕浏览、OCR识别等实用操作路径,帮助用户在低配设备上实现流畅、纯净的一站式上网与阅读。
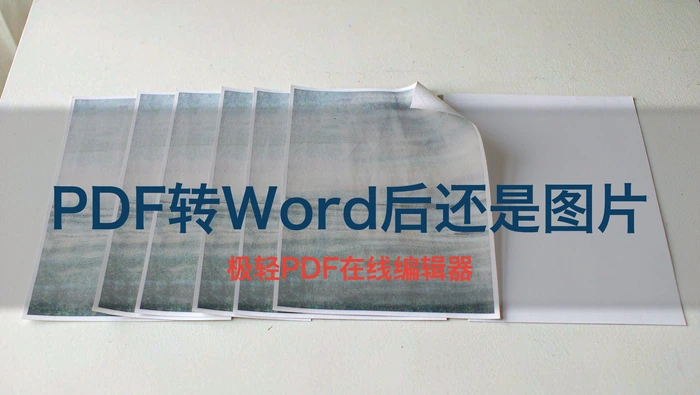
处理PDF转Word后还是图片,需先普通转换保留页面图像,OCR才会创建可编辑文字层。本文结合真实步骤图说明在原PDF中测试文字选取,整页选中说明为扫描件、只要保版式时可接受整页图片的Word结果、需要修改文字时选择中文OCR,再导出可编辑DOCX,并补充核对OCR的数字、专有名词、标点和表格。
精准提取扫描版 PDF 中的文本与表格。通过 PDF.cn 在线 OCR 工具、桌面软件按区域识别及手机重拍再识别三大方案,轻松解决错字多、表格散行及多栏顺序混乱等难题。
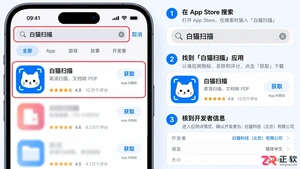
想知道白猫扫描怎么在iPhone上下载和使用?本文详解从App Store正规安装、权限配置到首次扫描测试的全流程,教你高效识别文档并保护个人隐私。
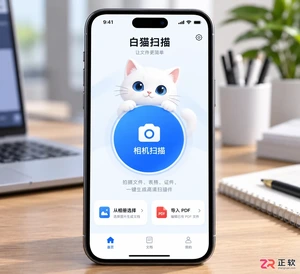
了解白猫扫描最新版的核心价值,掌握OCR文字识别与PDF导入的正确用法。本文详解自动边缘识别、批量处理技巧及结果校对方法,助您高效完成文档数字化工作。
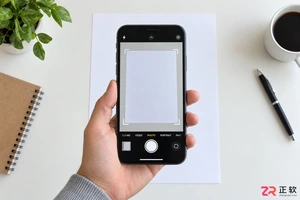
详解白猫扫描从拍摄到识别的全流程,包括光线控制、边缘调整、结果校对及隐私注意事项,帮助新手快速掌握高效的文字提取方法。
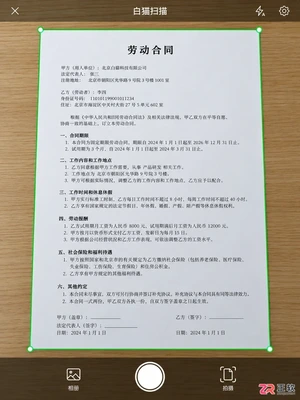
想知道白猫扫描怎么用最顺手?本文从拍照取景、识别入口选择、关键信息校对到最终导出格式,一步步拆解操作流程,帮你避开常见坑,让文字提取更准确、工作流更顺畅。


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




