

前言最近因为项目需要写了一段时间的 Go ,相对于 Java 来说语法简单同时又有着一些 Python 之类的语法糖,让人大呼”真香“。但现阶段相对来说还是 Python 写的多一些,偶尔还得回炉写点 Java ;自然对 Go 也谈不上多熟悉。于是便利用周末时间自己做个小项目来加深一些使用经验。于是
作者简介Janakiram MSV不仅是Janakiram & Associates的首席分析师,还是国际信息技术学院的兼职教师。他还是Google Qualified Developer、亚马逊认证解决方案架构师、亚马逊认证开发者、亚马逊认证SysOps管理员以及微软认证Azure专业人员。Jan
对于缓存,大家肯定都不陌生,不管是前端还是服务端开发,缓存几乎都是必不可少的优化方式之一。在实际生产环境中,缓存的使用规范也是一直备受重视的,如果使用的不好,很容易就遇到缓存击穿、雪崩等严重异常情景,从而给系统带来难以预料的灾害。为了避免缓存使用不当带来的损失,我们有必要了解每种异常产生的原因和解决
本文来自OPPO云平台团队高级工程师徐工,他自2014年开始从事容器化相关工作,目前负责OPPO云平台的编排与调度方向的工作,主要关注技术领域为超大规模的集群管理与调度,混合云平台建设与融合计算。伴随着kubernetes 1.20中对于docker的弃用,关于docker的灭亡与kubernete
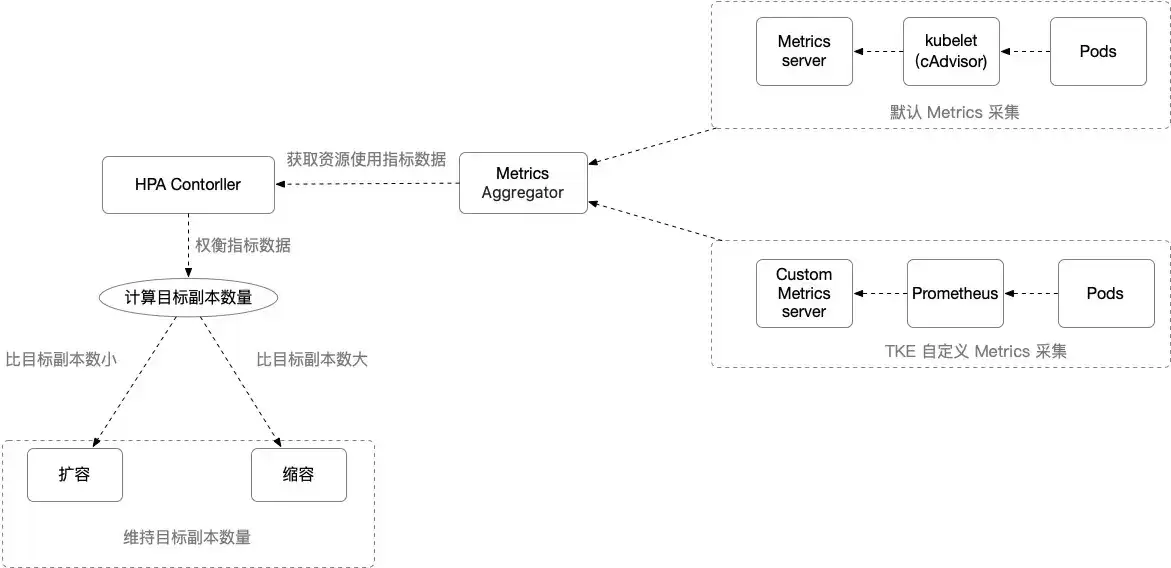
在 TKE 上利用 HPA 实现业务的弹性伸缩概述Kubernetes Pod 水平自动扩缩(Horizontal Pod Autoscaler,以下简称 HPA)可以基于 CPU 利用率、内存利用率和其他自定义的度量指标自动扩缩 Pod 的副本数量,以使得工作负载服务的整体度量水平与用户所设定的目
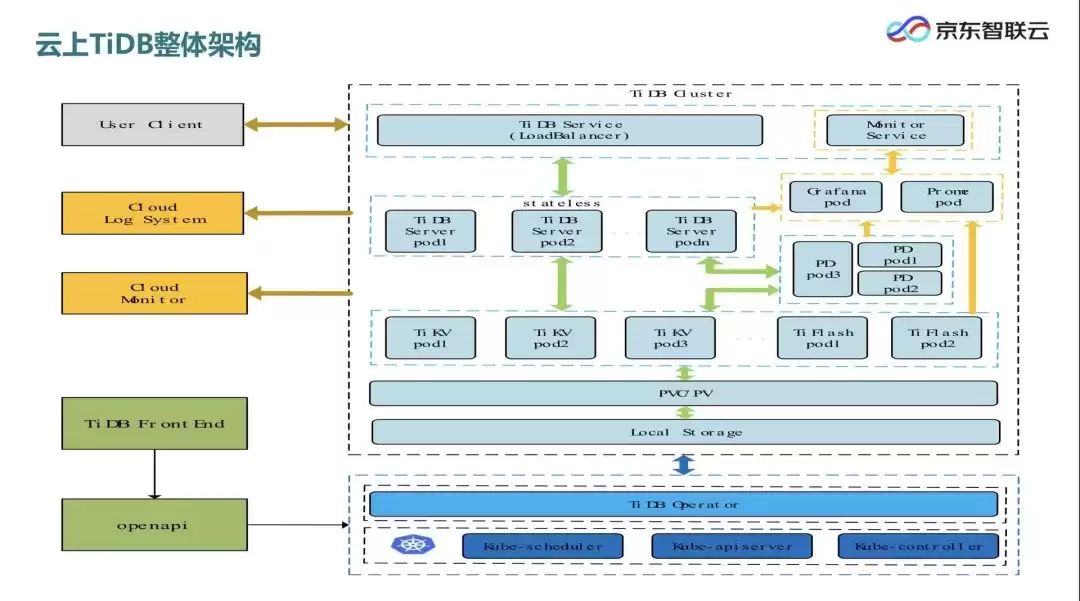
对于任何一家业务快速成长的企业来说,应对峰值流量冲击,一直是摆在技术团队面前的一大难题。面对海量数据,数据库及业务团队都希望做到“无感扩容”,但流行的分库、分表方案在扩容速度和一致性上经常不能满足需求。行业期待着性能强大、简单易用的全新数据库方案,从根本上解决企业面对流量高峰时的数据库性能瓶颈。行业
自从2009年入职百度以来,已经经历了11年了,我自己从一线研发工程师开始,也逐步成长成为了带领复杂技术方向的技术负责人。10年多的工作历程,让我有幸经历了大范围的技术演变,特别是云计算和云原生技术从朦胧到普及,对工程师和架构师的要求也发生了不少变化。趁着自己入职11周年的日子,结合我自己在百度的
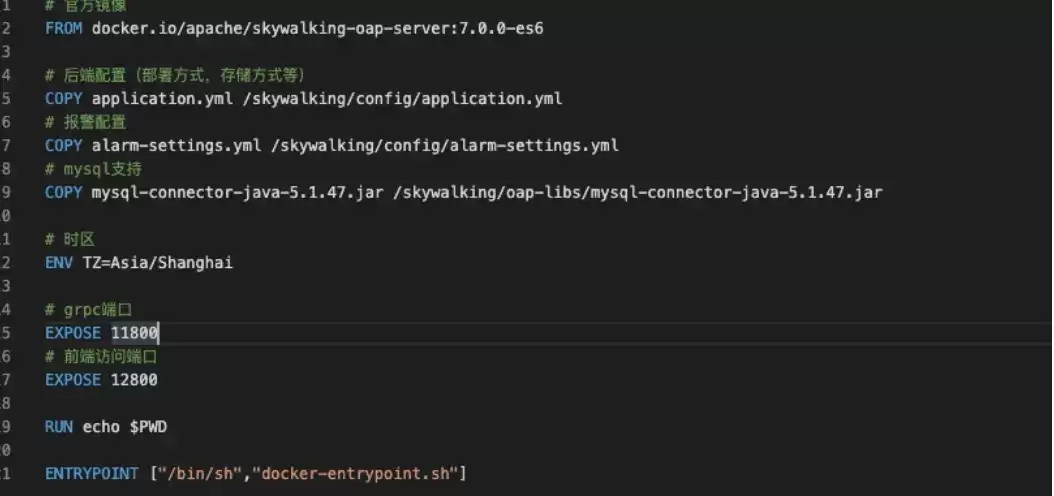
1.搭建1.构建Skywalking-docker镜像Skywalking支持下载zip包安装,但是推荐使用docker进行安装更加方便。Skywalking在Docker Hub提供了官方镜像,我们只需要引用在此基础上进行扩展即可。Skywalking-oap(服务端,接受埋点信息和计算)Skyw
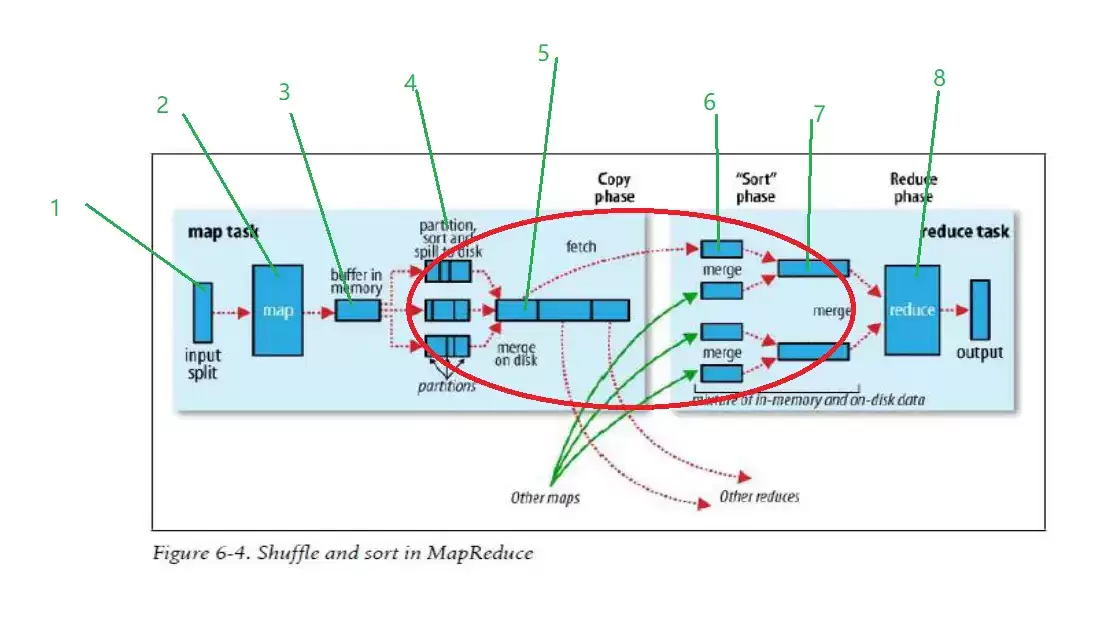
1.思考熟悉hadoop中mapreduce原理的人,都知道整个流程的运行原理。其中涉及至少三次排序,分别是溢写快速排序、溢写归并排序和reduce拉取归并排序,而且排序是默认的,也就是天然排序。那为什么要这么设计呢?先给出结论:为了整体更稳定,输出满足多数需求。前者体现在采用的是sortShuff
技术的成熟度源自大规模的实践,在 Ja va 领域,阿里将自身的实践源源不断的反哺给微服务技术体系;在 Node.js 领域,阿里正掀起了前所未有的前端革命浪潮,将实践反哺给 Serverless 技术体系,并逐渐拓展到其他多语言体系和后端 BaaS 上。Serverless云研发平台,乃阿里巴巴集





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。
