

业界资讯
PEFT(ParameterEfficientFine-tuning)是一种优化深度学习模型微调过程的参数高效技术,旨在在有限的计算资源下实现高效微调。研究人员通过采用一系列策略来减少微调所需的计算资源,从而在保持模型性能的同时提高微调效率。这些策略包括减少微调训练的迭代次数、降低训练数据的采样率以及减少模型参数的更新频率等。通过这些方法,PEFT能够在资源受限的情况下,有效地进行深度学习模型的微调,为实际应用中的计算资源节约提供了一种有效的解决方案。PEFT的应用广泛,包括图像分类和自然语言处理等领域。
细粒度情感分析器是一种机器学习模型,用于识别文本中的情感细节。在自然语言处理中,情感分析是一项重要任务,它帮助我们理解文本中的情感,更好地了解人们的想法和感受。细粒度情感分析器专注于情感细节,能够准确分析文本中的情感信息。细粒度情感分析器利用深度学习技术,如卷积神经网络、长短时记忆网络和注意力机制,对文本进行情感分析。它通过训练数据集来学习文本样本和对应情感标签之间的关系。训练数据集通常包括大量的文本样本和情感标签,如积极、消极和中性。通过学习这些样本和标签之间的关系,细粒度情感分析器能够自动地对新的文本
极限学习机(ELM)是一种新兴的人工神经网络算法,通过快速、简单的方法训练前馈神经网络。ELM的独特之处在于,它随机初始化隐藏层的权重矩阵和偏置向量,只需进行一次正向传播即可得到输出权重。这一特点使得ELM相比传统的神经网络具有更快的训练速度和更好的泛化性能。ELM的基本原理是将输入数据通过一个随机初始化的权重矩阵和偏置向量映射到一个隐含层,然后使用非线性激活函数对该层进行转换。随后,使用线性回归或支持向量机等方法,对该层的输出进行逆向传播,得到输出层的权重。隐藏层的权重和偏置向量在整个训练过程中保持不变
单元,又称为节点或神经元,是神经网络的核心。每个单元接收一个或多个输入,将每个输入乘以一个权重,然后将加权输入与偏置值相加。接下来,该值将被输入到激活函数中。在神经网络中,单元的输出可以被发送给其他神经元。多层感知器,又称为前馈神经网络,是目前使用最广泛且最简单的人工神经网络模型。它由多个层次相互连接而成,每一层都将输入特征与目标值进行连接。这种网络结构被称为“前馈”,是因为输入特征值在网络中以“前向”方式传递,每一层都会对特征值进行转换,直到最终输出与目标输出一致。在前馈神经网络中,有三种类型的层。每个
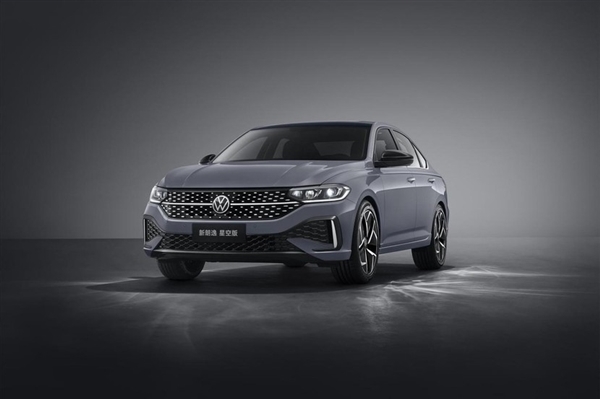
根据上汽国际副总经理赵爱民的宣布,今年上汽集团计划海外销售135万辆汽车。而明年,他们更有雄心壮志,希望能够达到150万辆的销售目标。赵爱民表示,尽管上汽具备实现更高销售目标的实力,但他们更倾向于保持稳定增长的策略。他强调了上汽将利用名爵MG品牌百年历史的机遇,将品牌宣传的重点放在全球销量上。根据了解,上汽从今年开始将以名爵MG为引领,在品牌推广方面加大力度;目前上汽的新能源车型都属于“全球车”范畴,未来两年计划推出14款新能源汽车,覆盖全球市场。智己汽车和飞凡汽车这样的高端品牌正迎来全球化的机遇,虽然它
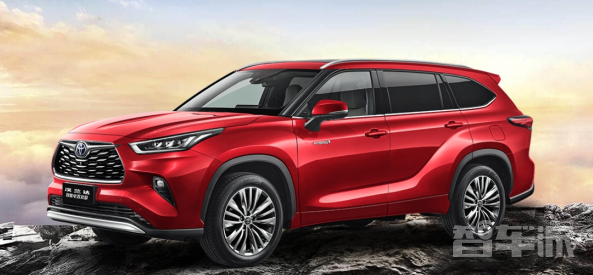
6月1日消息,丰田近日宣布将加大对兴建中的TBMNC电池工厂的投资,以满足美国市场对电动汽车需求扩大的趋势。这是丰田第二次对该工厂进行追加投资,预计总投资额将达到59亿美元。作为全球最大的汽车制造商之一,丰田在电动汽车领域的发展被业界认为相对较晚。据统计,2022年,丰田电动汽车的全球销量仅为2.4万辆。然而,丰田新领导层于今年4月宣布加快电动汽车发展战略,计划在2026年之前将丰田电动汽车的全球销量提高到每年150万辆。为实现这一目标,丰田认为必须在纯电动汽车迎来普及的美国市场扩大销售。美国政府为在当地
稳定扩散模型是一种数学模型,用于描述随机现象中的扩散过程。扩散过程是指在空间或时间上的随机分布。在稳定扩散模型中,扩散过程的分布由稳定分布来描述。稳定分布是一种具有尺度不变性和稳定性的特殊概率分布。稳定扩散模型的基本假设是扩散过程是独立的、稳定的随机过程。该模型的主要应用领域包括金融市场、物理学和生物学等。稳定扩散模型的研究对于理解和预测随机过程的行为具有重要意义。稳定扩散模型的原理基于随机过程理论和稳定分布理论。随机过程是一种描述随时间变化的随机变量的数学工具。它可以用来描述在不同时间点上的随机事件的演
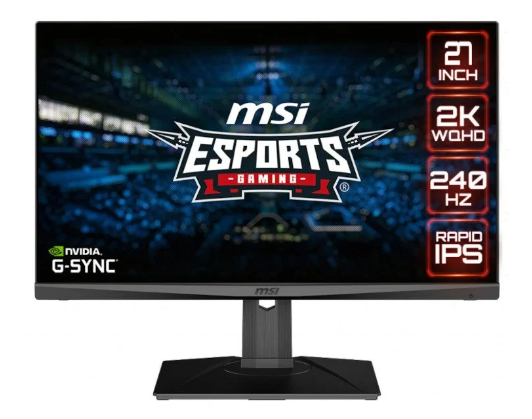
6月12日消息,微星今日推出了一款引人注目的全新游戏显示器OptixG274QPX。这款高性能显示器提供了震撼的游戏画面,为玩家们带来了独特的视觉享受。OptixG274QPX采用了27英寸的IPS面板,分辨率达到2560x1440,让用户可以欣赏到更加细腻和清晰的图像。高达1000:1的对比度和100%sRGB、95%DCI-P3的色域覆盖,确保了显示效果的精准和真实。而支持可超频至270Hz的240Hz刷新率,配合300尼特的亮度,为玩家们提供了流畅且明亮的游戏体验。据小编了解,OptixG
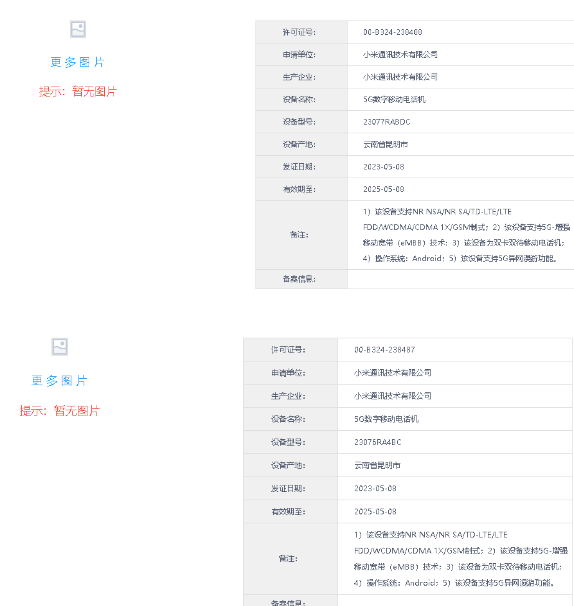
6月6日消息,据了解,小米近日通过国家3C质量认证的两款新机型引起了广泛关注。这两款新机型的型号分别为23077RABDC和23076RA4BC,预计属于Redmi旗下的入门系列机型。而令人期待的是,这两款新机型在上个月已通过工信部的入网审核,显示出支持5G异网漫游功能。然而,目前关于这两款新机的证件照和详细参数还未公布。据了解,这两款新机由昆明闻讯代工,并搭配了MDY-11-EM充电器,支持22.5W快充功能。MDY-11-EM充电器的快充特性将为用户提供更便捷的充电体验。此外,这两款新机的5G异网漫游
什么是误差反向传播误差反向传播法,又称为Backpropagation算法,是训练神经网络的一种常用方法。它利用链式法则,计算神经网络输出与标签之间的误差,并将误差逐层反向传播到每个节点,从而计算出每个节点的梯度。这些梯度可用于更新神经网络的权重和偏置,使网络逐渐接近最优解。通过反向传播,神经网络能够自动学习并调整参数,提高模型的性能和准确性。在误差反向传播中,我们使用链式法则来计算梯度。我们有一个神经网络,它有输入x,输出y和隐藏层。我们通过反向传播计算隐藏层每个节点的梯度。首先,我们需要计算每个节点的
在机器学习中,矩阵运算是一种重要的数学工具,用于处理和转换数据。通过将数据表示为矩阵形式,可以进行各种线性代数运算,如矩阵乘法、加法和逆运算等。这些运算可用于模型训练和推断过程中的特征转换、参数优化和预测计算。通过矩阵运算,我们可以有效地处理大规模数据集,并利用并行计算的优势来加速计算过程。此外,矩阵运算还与特征提取、降维和图像处理等领域密切相关,为机器学习提供了强大的数学基础和工具。矩阵运算在机器学习中具有广泛的应用,下面将详细介绍几个常见的应用场景。1.线性回归线性回归是一种机器学习算法,用于建立变量
模型可解释性是指人们能够理解机器学习模型的决策规则和预测结果的程度。它涉及到理解模型的决策过程和模型如何根据输入数据进行预测或分类。在机器学习领域,模型可解释性是一个重要的话题,因为它有助于人们了解模型的局限性、不确定性和潜在偏差,从而增强模型的信任度和可靠性。通过理解模型的决策规则,人们可以更好地评估模型在不同情况下的表现,并作出相应的决策。此外,模型可解释性还可以帮助人们发现模型中的错误或偏见,并提供改进模型的方向。因此,提高模型的可解释性对于机器学习的应用和发展都具有重要意义。下面介绍几种常见的模型
自监督学习(SSL)是一种无需人工输入数据标记的监督学习形式。它通过独立分析数据、标记和分类信息的模型来获得结果,而无需任何人工干预。这种方法可以减少人工标注的工作量,提高训练效率,并且在大规模数据集上表现出色。SSL是一种有前景的学习方法,可以在各种领域中应用,如计算机视觉和自然语言处理。自监督学习是一种利用未标记数据来生成监督信号的无监督学习方式。简单来说,它通过生成高置信度的数据标签来训练模型,然后在下一次迭代中使用这些标签。在每次迭代中,基于数据标签的基本事实都会发生变化。这种方法可以有效地利用未
三星在今日举办的GalaxyS24系列发布会上,向全球消费者展示了他们的最新智能穿戴产品——GalaxyRing智能指环。这款创新产品的亮相为整个科技盛宴增添了一抹亮色。在发布会即将结束之际,三星通过一段精彩的预告片向公众展示了GalaxyRing的迷人魅力。这款智能指环的设计独特,它像一枚时尚的戒指,轻松佩戴在手指上。指环内侧集成了多个先进传感器,结合AI技术,为用户提供全方位的健康追踪服务。然而,预告片并未透露GalaxyRing的售价和上市时间等更多细节。用户期待能尽快了解这款智能指环的详细信息,以
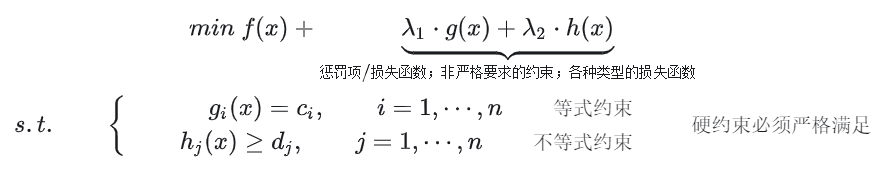
本项目代码:github.com/liangwq/robot_motion_planing轨迹约束中的软硬约束前面的几篇文章已经介绍了,轨迹约束的本质就是在做带约束的轨迹拟合。输入就是waypoint点list,约束条件有两种硬约束和软约束。所谓硬约束对应到数学形式就是代价函数,硬约束对应的就是最优化秋季的约束条件部分。对应到物理意义就是,为了获得机器人可行走的安全的轨迹有:把轨迹通过代价函数推离障碍物的方式给出障碍物之间的可行走凸包走廊,通过硬约束让机器人轨迹必须在凸包走廊行走上图展示的是软硬约束下Be
据报道,印度执法局(ED)最近对vivo印度公司展开了新一轮的“反洗钱调查”,并逮捕了包括临时CEO和CFO在内的多名高管。这是继今年10月印度金融执法机构逮捕vivo员工之后,印度当局对该公司进行的又一次严打据界面新闻报道,对此,vivo一位发言人表示“深感震惊”,称印度当局“最近的拘捕行动表明骚扰行为仍在继续,给整个行业带来了不确定性”,公司将坚决利用一切法律手段来应对和挑战这些指控。本站注意到,自2021年年末开始,印度当局对小米、vivo、OPPO等中国手机厂商展开多次突袭查税,并以各种理由冻结、
Logistic回归是一种用于分类问题的线性模型,主要用于预测二分类问题中的概率值。它通过使用sigmoid函数将线性预测值转换为概率值,并根据阈值进行分类决策。在Logistic回归中,OR值是一个重要的指标,用于衡量模型中不同变量对结果的影响程度。OR值代表了自变量的单位变化对因变量发生的概率的倍数变化。通过计算OR值,我们可以判断某个变量对模型的贡献程度。OR值的计算方法是取指数函数(exp)的自然对数(ln)的系数,即OR=exp(β),其中β是Logistic回归模型中自变量的系数。具体地说,如
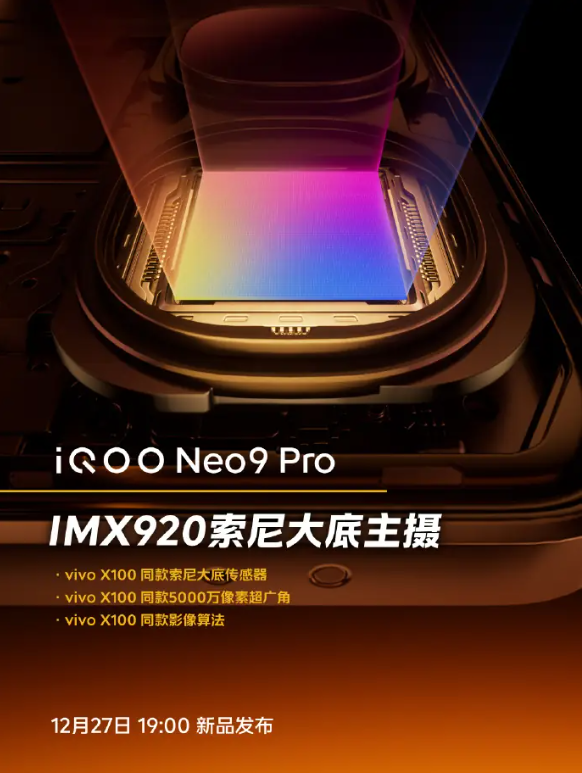
12月25日消息,iQOONeo9系列即将于12月27日闪亮登场,备受瞩目的Pro版现已披露了其令人期待的影像技术细节。iQOONeo9Pro,这款备受期待的设备,将采用与vivoX100相同的IMX920主摄传感器。此外,它还会配备与X100一样的5000万像素超广角镜头和高级影像算法。这款手机还将整合vivo最新的旗舰影像处理算法,提供悬浮运动抓拍等尖端功能,以提升用户的摄影体验vivoX100以其5000万像素的强大分辨率和1/1.49英寸的大传感器尺寸而引以为豪的主摄像头,确保了出色的图像质量。该
吉洪诺夫正则化,又称为岭回归或L2正则化,是一种用于线性回归的正则化方法。它通过在模型的目标函数中添加一个L2范数惩罚项来控制模型的复杂度和泛化能力。该惩罚项对模型的权重进行平方和的惩罚,以避免权重过大,从而减轻过拟合问题。这种方法通过在损失函数中引入正则化项,通过调整正则化系数来平衡模型的拟合能力和泛化能力。吉洪诺夫正则化在实际应用中具有广泛的应用,可以有效地改善模型的性能和稳定性。在正则化之前,线性回归的目标函数可以表示为:J(w)=\frac{1}{2m}\sum_{i=1}^{m}(h_w(x^{
什么是MLOps?通过可重复且高效的工作流程交付机器学习模型的学科被称为机器学习操作(MLOps)。MLOps与软件开发生命周期的DevOps类似,旨在将高性能ML应用程序持续交付到大规模生产中。它特别关注ML在现有SDLC和CI/CD程序中存在的独特需求,以创造一个与之并存的新生命周期。这样做可以为ML带来更高效的工作流程和更好的结果。MLOps方法提高了机器学习和深度学习模型的质量,简化了管理流程,并实现了自动化部署。模型更易与业务需求和法规要求保持一致。机器学习(ML)具有独特的生命周期,与传统软件
变分推断和EM算法是常用的概率图模型推断方法,都用于从观测数据中推断隐含变量的分布。它们在实际应用中被广泛使用,能够处理复杂问题。一、变分推断变分推断是一种近似推断方法,它通过转化问题为寻找一个近似分布的方式来解决。通常,这个近似分布是一个简单的分布,如高斯分布或指数分布。变分推断通过最小化近似分布与真实分布之间的距离,来寻找最优的近似分布。这个距离一般使用KL散度来度量。因此,变分推断的目标是最小化KL散度,以减小近似分布与真实分布之间的差异。具体来说,变分推断的过程是通过以下步骤完成的:1.确定模型的

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




