

业界资讯
生成式AI是一种人工智能技术,它利用深度学习模型从输入数据中学习并生成新的数据,而不是简单地对现有数据进行分类或预测。它的应用范围非常广泛,可以用于图像生成、文本生成、音乐生成等各种任务。生成式AI通常依赖于生成对抗网络(GANs)或变分自编码器(VAEs)等模型来实现。GANs通过让一个生成网络和一个判别网络相互竞争,从而提高生成网络的生成能力。VAEs则利用编码器将输入数据映射到潜在空间中,并通过解码器从潜在空间中生成新的数据。当涉及到数据缺失问题时,生成式AI可以发挥重要作用。它可以通过学习现有数据
目标检测是计算机视觉领域中一项重要任务,其目标是从图像或视频中识别出特定物体,并标注它们的位置和类别。深度学习在目标检测中取得了巨大成功,尤其是基于卷积神经网络(CNN)的方法。本文将介绍计算机视觉深度学习目标检测的概念和实现步骤。一、概念1.目标检测的定义目标检测是通过图像或视频识别特定物体,并标注位置和类别。相比于图像分类和物体检测,目标检测需要定位多个物体,因此更具挑战性。2.目标检测的应用目标检测在很多领域都有着广泛的应用,例如智能家居、智能交通、安防监控、医学影像分析等。其中,在自动驾驶领域中,
反向传播是神经网络训练中的一种常见算法,用于调整单个神经元的权重。它通过从神经元的输出向后移动来实现权重的优化,从而最小化网络的错误。该过程始于随机生成权重的网络,然后利用反向传播算法将它们调整到模型中。反向传播算法涉及什么?它是一种监督学习算法,用于训练神经网络中权重和偏差的优化。它主要基于微积分中的链式法则,计算损失函数对神经网络权重的梯度。其工作原理是通过将错误从输出层向后传播到神经网络的每一层,根据梯度调整权重。每个权重的梯度用于在反向梯度的方向更新权重,以最小化损失函数。不断重复此过程,直到损失
Transformer模型有这几个主要缺陷:Transformer模型在训练过程中需要大量计算,特别是在处理大型数据集和长序列时。因此,在实时应用程序或资源受限设备上使用Transformer模型是具有挑战性的。2.并行化困难:Transformer模型的顺序性质可能导致难以并行化训练过程,从而减慢训练时间。Transformer模型的缺点之一是缺乏可解释性。相比其他一些机器学习模型,Transformer模型没有明确的输入-输出映射,这使得解释其内部工作原理变得更加困难。Transformer模型对超参
06月14日消息,高通今日宣布推出全新的Android™onSnapdragon门户网站,旨在帮助开发者最大限度地发挥骁龙芯片的潜力,打造出卓越而创新的安卓应用。这个全新的网站将聚焦于最新的骁龙技术,提供详细的介绍和说明,以引导开发者将这些技术应用于安卓应用的开发中。高通的目标是为安卓应用程序开发人员提供丰富的工具集,以帮助他们在骁龙移动平台上利用各种安卓API,并结合骁龙扩展API来提升应用的体验,并提供构建安卓应用的最佳实践方法。据小编了解,该门户网站还提供各种安卓API演示、免费的代码样本以及关于S
贝叶斯深度学习是结合了贝叶斯统计和深度学习技术的一种方法。它旨在解决深度学习中存在的问题,如过拟合、参数不确定性和数据不足。本文将详细介绍贝叶斯深度学习的原理、应用和算法。一、原理常规的深度学习模型主要使用最大似然估计方法来对参数进行估计,即通过最大化训练数据集上的似然函数来找到最优的参数值。然而,这种方法无法提供关于参数的不确定性的量化,也无法有效应对过拟合等问题。与之相反,贝叶斯深度学习采用贝叶斯方法来对模型参数进行建模,从而能够量化参数的不确定性并获得模型的置信度。通过引入先验概率分布,贝叶斯深度学
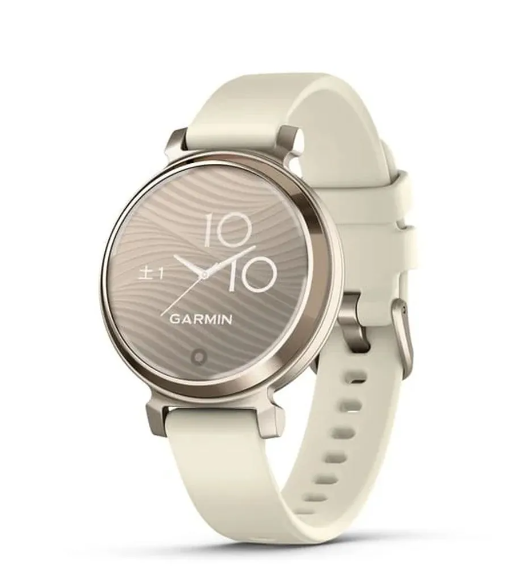
佳明(Garmin)宣布即将推出新一代智能手表Lily2,引起了广泛关注。据悉,这款新品有望在近期正式上市。近日,佳明日本的支持页面意外曝光了Lily2Sport的清晰照片。从照片中可以看出,Lily2继续沿用了初代的设计风格,采用光面表圈与磨砂表身的搭配,展现出独特的美感。同时,这款手表也是专为女性用户打造的,相信会受到不少消费者的喜爱。根据我们的了解,除了Lily2Sport之外,泄露的图片还展示了四款Lily2Classic的不同款式。这些款式还提供了皮革和尼龙材质的表带选择,以满足消费者的不同需求
6月7日消息,苹果在今天举办的WWDC2023开发者大会上揭示了一项令人振奋的计划,他们将在macOS系统中推出一种新的功能,允许用户模拟运行Windows10和Windows11系统的游戏。这一消息对于广大游戏玩家来说无疑是个令人兴奋的消息。据小编了解,在此次活动中,苹果详细介绍了如何通过引入metalShaderConverter和metal调试工具来提升游戏性能,并显著减少前期准备所需的时间。这意味着用户可以更轻松地在macOS平台上畅玩Windows游戏,无需单独购买Windows设备。值得一提的
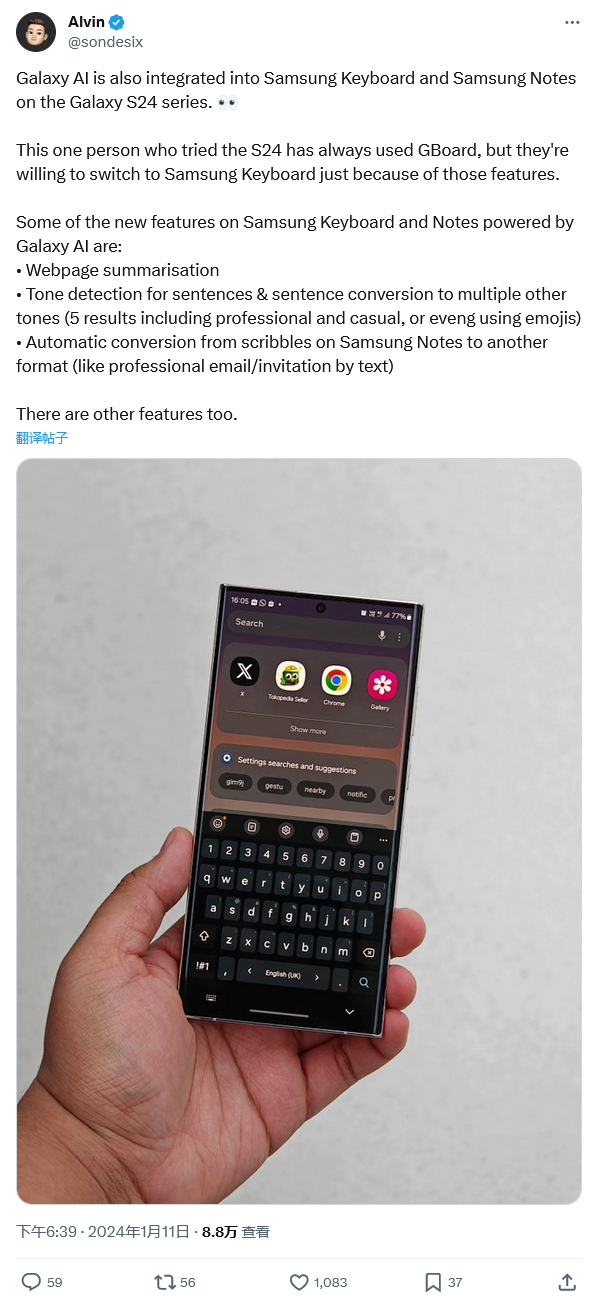
三星S24系列要上AI!?发布会前最后一爆,这波稳了!今年三星还是期待值点满的,根据爆料来看,今年三星S24系列会着重在AI方面发力,不知道会带来什么样的惊喜,无独有偶,前阵子OPPO也发布了最新的AI手机:FindX7系列,这还是首个端侧搭载70亿大数据模型的手机,目前各路测评博主都是一致好评。看了迪仔Dizzz的FindX7测评,感觉OPPO这波是整了个好玩又好用的AI功能,就比如这个通话摘要功能,就能对通话内容进行重点摘要,像是需要记事的时候十分方便,对于文章也能使用摘要功能,并且还可以直接翻译成中
偏差和方差是机器学习的重要概念,影响模型性能。了解可提高准确性和稳健性。偏差是指模型对基础数据分布的假设所引入的误差。高偏差的模型做出过于简单的假设,导致在未见数据上出现拟合不足和性能不佳的问题。低偏差的模型更灵活,能捕获更多的数据复杂性,从而获得更好的性能。方差是指模型对特定训练数据的敏感性,高方差的模型容易过度拟合,表现良好但在新数据上表现不佳。这是因为模型学习了训练数据中的噪声和随机性,而不是真实的模式。相反,具有低方差的模型更稳健,能更好地泛化到新数据。在机器学习领域,我们通常希望找到偏差和方差之
计算机视觉深度估计是通过计算机视觉技术来估计图像中物体的距离信息,即物体离相机的距离。深度估计在自动驾驶、机器人导航、虚拟现实等领域具有广泛的应用。本文将介绍深度估计的方法和计算深度信息的过程。一、计算机视觉深度估计的方法计算机视觉深度估计的方法可以分为两大类:单目视觉深度估计和双目视觉深度估计。1.单目视觉深度估计单目视觉深度估计是通过一张图像估计物体深度。方法主要有:视差法、结构法、学习法。(1)基于几何的方法:通过计算物体在图像中的大小、位置等几何信息,来推断物体与相机的距离。该方法主要应用于静态场
随着数字化时代的到来,搜索引擎在产品发现和销售中的重要性日益增加。机器学习技术在提升搜索引擎的效果方面起着关键作用。产品搜索引擎的目的是将用户查询与相关产品相匹配。这个过程可以分为三个主要步骤:索引、排名和检索。索引涉及从产品数据中提取特征并将其存储在数据库中。排名涉及根据与用户查询的相关性对索引数据进行排序。检索涉及向用户展示排名最高的产品。在每个步骤中,机器学习可以发挥重要作用,提高系统的准确性和效率。通过机器学习技术,搜索引擎可以自动学习和优化索引和排名算法,以更好地理解用户的意图,提供精确的搜索结
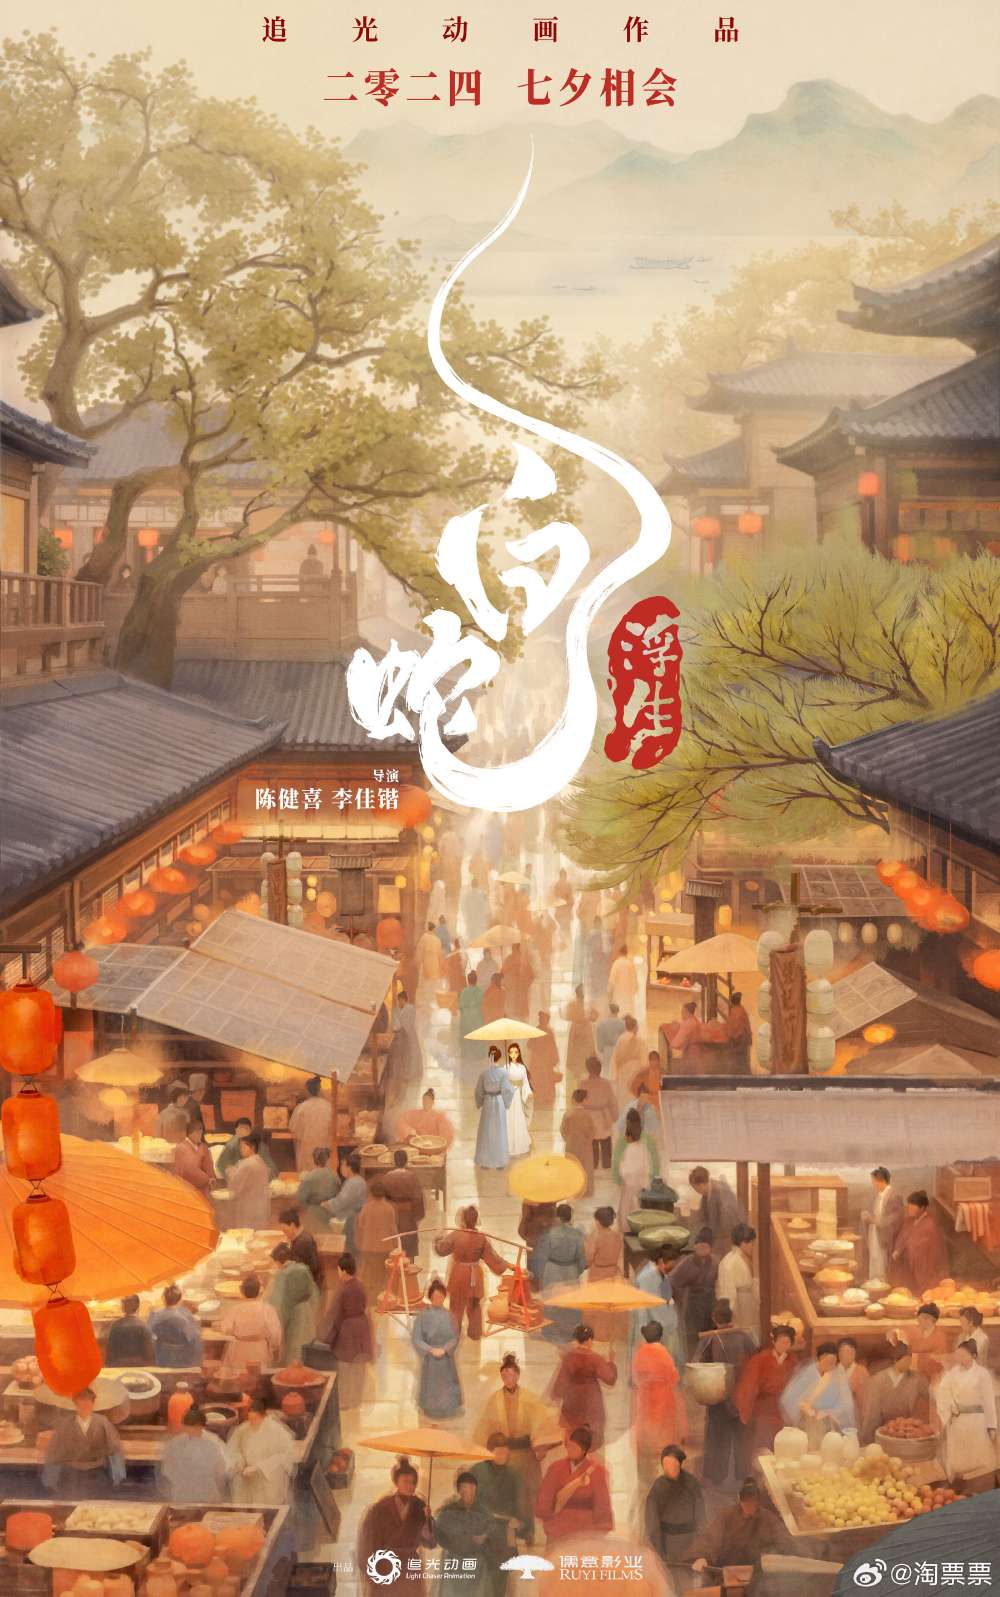
本站1月11日消息,追光动画“白蛇系列”第三部电影《白蛇:浮生》今日发布“情定今生”版定档海报,宣布将于今年七夕全国上映(本站注:2024年8月10日)。本作的故事将承接《白蛇:缘起》结尾,讲述南宋年间,小白寻找到阿宣的转世——许仙,开启这一世姻缘。电影《白蛇:缘起》于2019年上映,目前豆瓣评分7.8;《白蛇:青蛇劫起》于2021年上映,目前豆瓣评分6.8。《白蛇:浮生》仍由追光动画老板王微编剧,但换了导演,期待他的表现。
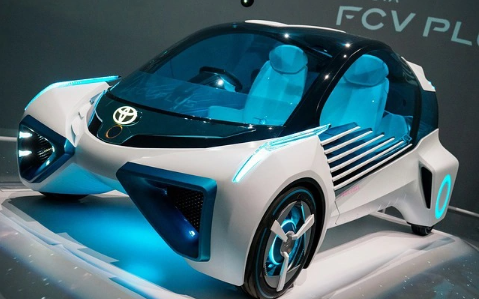
6月13日消息,丰田汽车日前宣布了其最新的电动汽车战略计划。据悉,丰田将于2026年起在全球市场推出采用下一代电池的纯电动汽车(EV),并由丰田专注于电动汽车的新部门BEV工厂进行研发和制造。新一代电池仍然采用高性能锂离子电池技术,充电时间仅需20分钟,而续航里程更可达1000公里。据小编了解,丰田汽车还表示正在研发一种用于大规模生产全固态电池的方法,并计划在2027年至2028年期间实现商业化。这种新型电池技术将实现10分钟快速充电,续航里程更可超过1200公里。丰田汽车部门总裁TakeroKato在一
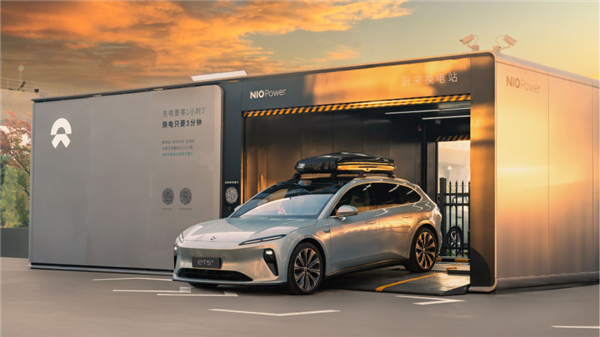
蔚来汽车近日宣布推出一项创新的电池共享活动,旨在提高电池利用效率并回馈用户。根据该活动规则,购买了100kWh长续航电池包的蔚来用户可以前往指定的换电站将其更换为75kWh标准续航电池包,而之前的长续航电池将供应给其他有灵活升级需求的用户。通过这种电池共享的方式,蔚来汽车能够最大限度地提高电池的使用效率,减少浪费,并且回馈给用户一定的实惠。这种创新的电池共享模式将进一步推动电动汽车行业的发展,为用户提供更便捷的服务体验。根据了解,此次电池共享活动将于1月20日至2月20日期间进行。参与活动的用户将有机会获
命名实体识别(NER)是自然语言处理中的重要任务,旨在从文本中识别出有特定意义的实体,如人名、地名、组织机构名等。中文NER面临着更多的挑战,因为中文语言具有特殊性,需要使用更多的语言处理技术和规则来应对。中文命名实体识别的方法主要包括基于规则、基于统计和混合方法。基于规则的方法通过人工构建规则或规则模板来识别实体。基于统计的方法则利用机器学习算法从大量语料库中学习实体识别模型。混合方法将两种方法结合,既能利用规则的优势,又能利用统计学习的优势。对于中文命名实体识别的具体实现,一般可以采用以下步骤:1.分
扩张卷积和空洞卷积是卷积神经网络中常用的操作,本文将详细介绍它们的区别和关系。一、扩张卷积扩张卷积,又称膨胀卷积或空洞卷积,是一种卷积神经网络中的操作。它是在传统的卷积操作基础上进行的扩展,通过在卷积核中插入空洞来增大卷积核的感受野。这样一来,网络可以更好地捕捉更大范围的特征。扩张卷积在图像处理领域有着广泛的应用,能够在不增加参数数量和计算量的情况下提升网络的性能。通过扩大卷积核的感受野,扩张卷积能够更好地处理图像中的全局信息,从而提高特征提取的效果。扩张卷积的主要思想是,在卷积核的周围引入一些间隔,这些
熵和决策树是机器学习中常用的概念,在分类、回归、聚类等任务中有广泛应用。下面将从熵和决策树两个方面详细介绍。熵是信息理论中的一个重要概念,用于衡量系统的混乱程度或不确定性。在机器学习中,我们常用熵来评估数据集的纯度。对于一个二分类数据集,其中包含n个正样本和m个负样本,可以使用以下公式计算数据集的熵:H=-\frac{n}{n+m}\log_2(\frac{n}{n+m})-\frac{m}{n+m}\log_2(\frac{m}{n+m})在这个公式中,\log_2表示以2为底的对数。观察公式可以发现,
感知器是一种基本的人工神经网络模型,用于分类和回归等任务。它由多个输入节点和一个输出节点组成。每个输入节点都有一个权重,将输入与权重相乘,并将结果相加后加上一个偏差。最后,该结果会经过激活函数进行处理。在感知器中,偏差是一个关键参数,对模型的性能有着重要影响。本文将探讨感知器中偏差的作用以及相应的解决方法。一、偏差的定义在感知器中,偏差是一个常数项,它会加到加权和中,以调整感知器的输出。偏差可以被看作是一个额外的“神经元”,其输出恒为1,与其他神经元的输出相乘,然后加到加权和中。可以将偏差视为感知器的阈值
累积分布函数(CDF)是概率密度函数的积分,用于描述随机变量X小于或等于某个值x的概率。在机器学习中,CDF被广泛应用于理解和分析数据分布,以选择适合的模型和算法进行建模和预测。通过计算CDF,我们可以得到某个值落在特定百分比范围内的概率。这有助于我们评估数据点相对于整个数据集的位置和重要性。另外,CDF还可以用于计算分位数,即将数据集划分为特定百分比的区间,从而更好地理解数据的分布情况。通过理解和分析CDF,我们能够更好地了解数据的特征,并为模型选择和预测提供指导。从概念上理解,CDF是用来描述随机变量
机器学习中一个重要的问题是理解模型预测的原因。虽然我们可以通过现有的算法模型知道算法的功能,但很难解释为什么模型会得出这样的预测结果。然而,解释性算法可以帮助我们识别我们感兴趣的结果和有意义的变量影响。解释性算法让我们能够理解模型中变量之间的关系,而不仅仅是用来预测结果。因此,通过使用多种算法,我们可以更好地理解给定模型中自变量和因变量之间的关系。解释性算法线性/逻辑回归是一种统计方法,用于建模因变量与一个或多个自变量之间的线性关系。该方法通过检验和系数,可以帮助我们了解变量之间的关系。决策树是一种机器学
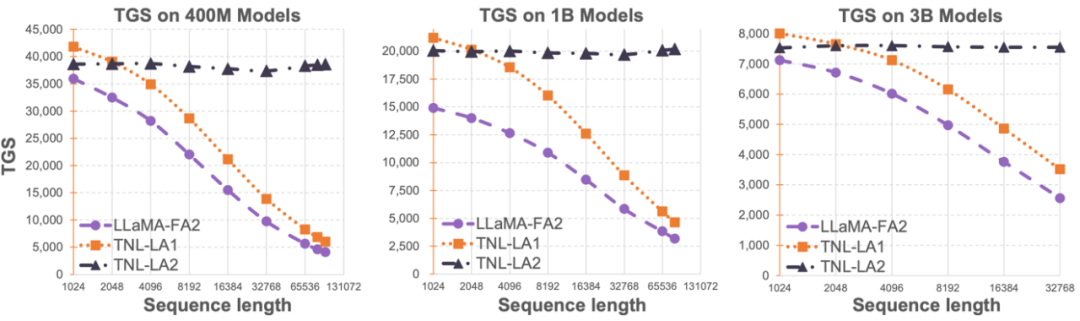
当前大语言模型的应用受到了序列长度限制的制约,这限制了其在人工智能领域中的应用。例如,在多轮对话、长文本理解和多模态数据处理与生成方面存在一定的挑战。造成这种限制的根本原因是目前大语言模型普遍采用的Transformer架构,其计算复杂度与序列长度呈二次关系。因此,随着序列长度的增加,计算资源的需求会呈几何倍数增长。因此,如何高效地处理长序列一直是大语言模型所面临的挑战之一。过去的方法主要集中在让大语言模型在推理阶段适应更长的序列。其中一种方法是采用Alibi或类似的相对位置编码,以使模型能够自适应不同长
超分辨率图像重建是利用深度学习技术,如卷积神经网络(CNN)和生成对抗网络(GAN),从低分辨率图像中生成高分辨率图像的过程。该方法的目标是通过将低分辨率图像转换为高分辨率图像,从而提高图像的质量和细节。这种技术在许多领域都有广泛的应用,如医学影像、监控摄像、卫星图像等。通过超分辨率图像重建,我们可以获得更清晰、更具细节的图像,有助于更准确地分析和识别图像中的目标和特征。重建方法超分辨率图像重建的方法通常可以分为两类:基于插值的方法和基于深度学习的方法。1)基于插值的方法基于插值的超分辨率图像重建方法是一

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




