

xpath
XPath是用于XML和HTML文档中定位与选择节点的语言,支持路径表达式、谓词筛选及多种节点类型,具备轴、函数等高级功能,在网页数据抓取和自动化测试中广泛应用,能高效提取所需数据。
XPath通过路径表达式选择XML节点,支持绝对路径与相对路径。基本规则包括节点名称、斜杠、双斜杠和@符号选择节点。谓语条件用方括号筛选,如位置、属性值比较。通配符*匹配任意元素,@*匹配任意属性,|连接多个路径。
答案:使用Python的requests和lxml库,通过发送请求、XPath解析提取小说标题和正文,可批量爬取并保存内容。需注意动态加载、反爬机制及版权问题。
XPath语法错误常见于大小写不匹配、路径缺少斜杠或引号不闭合,应使用标准格式如//Element[@Attribute='Value'];2.命名空间需通过XmlNamespaceManager显式注册,否则无法匹配带命名空间的节点;3.节点不存在或结构误判可通过输出文档内容、逐层测试路径及使用*通配符验证层级来排查。
XML解析Java提供了两种解析XML文档的方法:DOM和SAX。DOM(文档对象模型)将整个XML文档加载到内存中,并允许程序员使用对象表示访问其内容。SAX(简单apiforXML)是一种事件驱动的解析器,在解析文档时触发事件,从而提高了效率。示例(DOM):DocumentBuilderFactoryfactory=DocumentBuilderFactory.newInstance();DocumentBuilderbuilder=factory.newDocumentBuilder();Docu
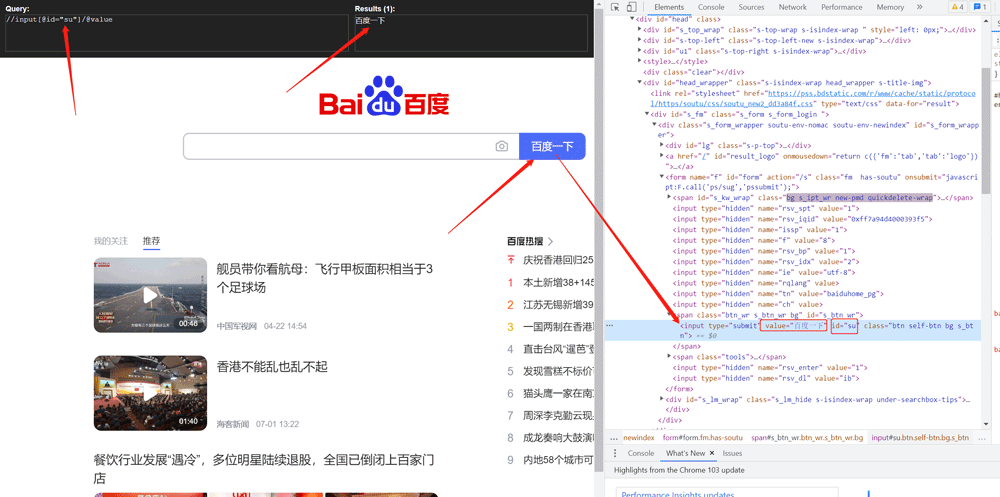
1.xpath1.1xpath使用google提前安装xpath插件,按ctrl+shift+x出现小黑框安装lxml库pipinstalllxml‐ihttps://pypi.douban.com/simple导入lxml.etreefromlxmlimportetreeetree.parse()解析本地文件html_tree=etree.parse('XX.html')etree.HTML()服务器响应文件html_tree=etree.HTML(response.read().dec


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




