

Scrapy在Twitter数据爬取和分析中的实际应用
Scrapy是一个基于Python的Web爬虫框架,它能够快速地从互联网上爬取数据,并提供简单易用的API和工具进行数据处理和分析。在这篇文章中,我们将讨论Scrapy在Twitter数据爬取与分析中的实际应用案例。Twitter是一个社交媒体平台,有着海量的用户和数据资源。研究人员、社交媒体分析者和数据科学家们可以从中获取大量的数据,并通过数据挖掘和分析来
Scrapy是一个基于Python的Web爬虫框架,它能够快速地从互联网上爬取数据,并提供简单易用的API和工具进行数据处理和分析。在这篇文章中,我们将讨论Scrapy在Twitter数据爬取与分析中的实际应用案例。
Twitter是一个社交媒体平台,有着海量的用户和数据资源。研究人员、社交媒体分析者和数据科学家们可以从中获取大量的数据,并通过数据挖掘和分析来发现有趣的见解和信息。然而,通过Twitter API获取数据是有一些限制的,Scrapy可以通过模拟人工访问,来绕过这些限制,从而获取更大量的Twitter数据。
首先,我们需要创建一个Twitter开发者账号,并申请API Key和Access Token。接着,我们需要在Scrapy的settings.py文件中设置Twitter API的访问参数,这将允许Scrapy模拟人工访问Twitter API来获取数据。例如:
TWITTER_CONSUMER_KEY = 'your_consumer_key'
TWITTER_CONSUMER_SECRET = 'your_consumer_secret'
TWITTER_ACCESS_TOKEN = 'your_access_token'
TWITTER_ACCESS_TOKEN_SECRET = 'your_access_token_secret'
接下来,我们需要定义一个Scrapy爬虫,来爬取Twitter数据。我们可以使用Scrapy的Item定义来指定要爬取的数据类型,例如:
class TweetItem(scrapy.Item):
    text = scrapy.Field()
    created_at = scrapy.Field()
    user_screen_name = scrapy.Field()
在爬虫的配置中,我们可以设置要查询的关键词和时间范围,例如:
class TwitterSpider(scrapy.Spider):
    name = 'twitter'
    allowed_domains = ['twitter.com']
    start_urls = ['https://twitter.com/search?f=tweets&q=keyword%20since%3A2021-01-01%20until%3A2021-12-31&src=typd']

    def parse(self, response):
        tweets = response.css('.tweet')
        for tweet in tweets:
            item = TweetItem()
            item['text'] = tweet.css('.tweet-text::text').extract_first().strip()
            item['created_at'] = tweet.css('._timestamp::text').extract_first()
            item['user_screen_name'] = tweet.css('.username b::text').extract_first().strip()
            yield item
在这个示例爬虫中,我们使用了CSS选择器来提取Twitter上关于“keywords”的所有推文,从2021年1月1日到2021年12月31日。我们将数据存储在上面定义的TweetItem对象中,并通过yield语句将其传递给Scrapy引擎。
当我们运行Scrapy爬虫时,它将自动模拟人工访问Twitter API,获取Twitter数据并将其存储在定义的数据类型TweetItem对象中。我们可以使用Scrapy提供的各种工具和数据分析库来对爬取到的数据进行分析和挖掘,例如:
class TwitterAnalyzer():
    def __init__(self, data=[]):
        self.data = data
        self.texts = [d['text'] for d in data]
        self.dates = [dt.strptime(d['created_at'], '%a %b %d %H:%M:%S %z %Y').date() for d in data]

    def get_top_hashtags(self, n=5):
        hashtags = Counter([re.findall(r'(?i)#w+', t) for t in self.texts])
        return hashtags.most_common(n)

    def get_top_users(self, n=5):
        users = Counter([d['user_screen_name'] for d in self.data])
        return users.most_common(n)

    def get_dates_histogram(self, step='day'):
        if step == 'day':
            return Counter(self.dates)
        elif step == 'week':
            return Counter([date.fromisoformat(str(dt).split()[0]) for dt in pd.date_range(min(self.dates), max(self.dates), freq='W')])

analyzer = TwitterAnalyzer(data)
print(analyzer.get_top_hashtags())
print(analyzer.get_top_users())
print(analyzer.get_dates_histogram('day'))
在这个示例代码中,我们定义了一个TwitterAnalyzer类,它使用TweetItem对象中的数据来帮助我们获取Twitter数据的各种信息和见解。我们可以使用该类的方法获取推文中使用频率最高的哈希标签、揭示活跃用户和展示数据的时间变化等等。
总之,Scrapy是一个非常有效的工具,能够帮助我们从Twitter等网站中获取数据,再利用数据挖掘和分析技术来发掘其中有趣的信息和洞见。无论你是一位学术研究者、社交媒体分析者还是数据科学爱好者,Scrapy都是一个值得尝试和使用的工具。
编程是借助编程语言编排指令,让计算机完成指定任务的过程。其核心在于编程思维,即分析、拆解并解决实际问题,如同教机器人做饭需细化每个步骤,最终实现预期结果。

Pandas是Python数据分析的核心工具,安装使用pipinstallpandas,导入为importpandasaspd。创建DataFrame可从字典或CSV文件读取,如pd.DataFrame(data)或pd.read_csv('your_data.csv')。数据选择可通过列名或条件过滤实现,如df['姓名']或df[df['年龄']>=28]。数据清洗包括填充缺失值fillna()、删除缺失值dropna()和去重drop_duplicates()。类型转换用astype()函数,应
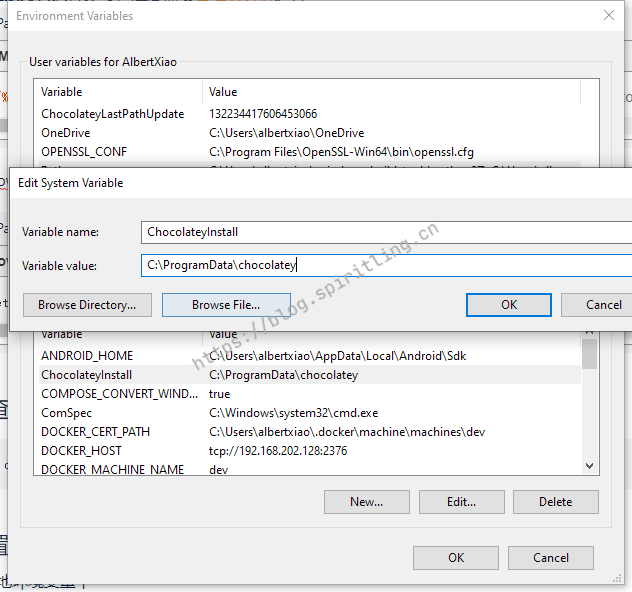
原文链接:https://blog.spiritling.cn/posts/4cb12659/Choco命令行安装直接拷贝执行即可,注意需要管理员身份运行cmd安装:代码语言:javascript代码运行次数:0运行复制@"%SystemRoot%\System32\WindowsPowerShell\v1.0\powershell.exe"-NoProfile-InputFormatNone-ExecutionPolicyBypass-Command"iex((New-ObjectS
Python通过requests、BeautifulSoup等库实现高效房价数据采集,利用pandas进行数据清洗与预处理,结合matplotlib、seaborn可视化分析区域房价分布、面积与价格关系,并可通过scikit-learn构建预测模型,挖掘价格影响因素与市场趋势。
Scrapy架构设计的亮点包括:1.基于Twisted的异步机制提升并发效率;2.中间件机制灵活处理Request和Response;3.组件可扩展性强,支持自定义Spider、Pipeline等;4.清晰的组件划分便于理解和维护。
Go语言以其并发处理、低延迟和强大的标准库,为数据分析创新赋能。通过并发处理,Go语言能同时执行多个分析任务,显著提升性能。其低延迟特性使分析应用程序能够实时处理数据,实现快速响应和洞察。此外,Go语言丰富的标准库提供了数据处理、并发控制和网络连接的库,方便分析师构建健壮、可扩展的分析应用程序。
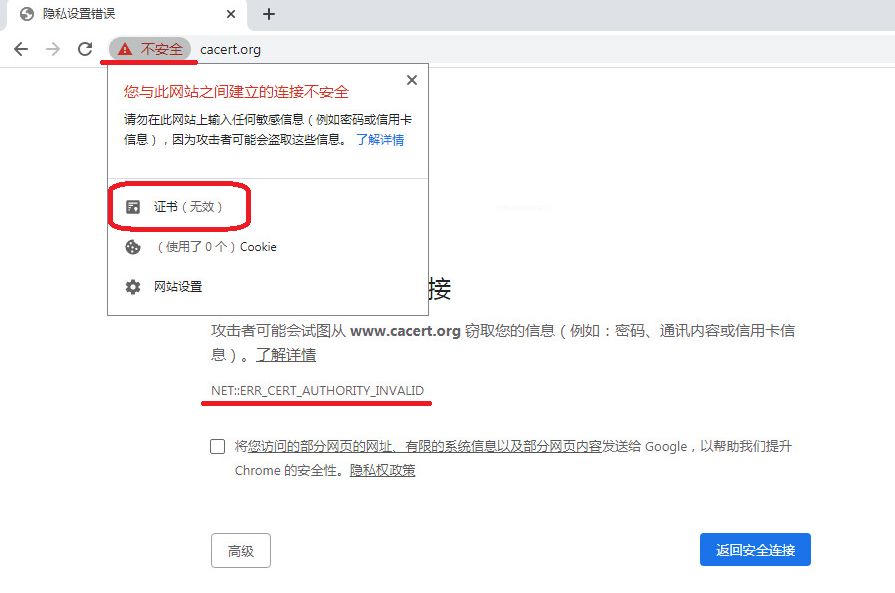
本文作者:jack.zhou(TimelineSec交流群成员)本文共2076字,预计阅读时间为6到7分钟。声明:本文内容仅供学习研究,不得用于非法途径,违者后果自负。0x01简介对于未接触过公钥签名信任体系的读者,可能难以理解此漏洞。我们先不讨论具体的算法和PKI公钥体系,简单介绍一下证书信任关系的建立。在现实生活中,人与人之间、公司与公司之间的信任关系最初是不存在的。信任通常是通过相互认识和交往建立起来的,但这种方法的缺陷在于一个人或公司不可能认识所有其他人和公司。那么,如何在不认识的人或公司之间
Golang为数据分析团队提供了多项优势:出色的并发性和高性能,使用goroutine进行并行处理。简洁易学的语法和强类型系统,缩短开发时间。丰富的针对数据分析的库和工具生态系统,简化任务。

MySQLvs.TiDB:哪个数据库更适合实时数据分析?引言:在现代数据驱动的世界中,实时数据分析对于企业的决策和业务发展至关重要。选择合适的数据库是实现高效实时数据分析的关键。本文将探讨MySQL和TiDB这两种常见的数据库,分析它们在实时数据分析方面的特点和优势,并给出适用场景和代码示例,帮助读者更好地选择最适合自己需求的数据库。一、MySQL数据





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



