

爬虫

最近研究了一下怎么爬取那些Ja vaScript渲染后的网页内容,折腾了一圈,发现核心武器还是得靠Puppeteer。不过它是个Node库,想在PHP里用还得再套一层,这里用到了`spatie/browsershot`这个包。下面把整个流程和踩坑点都捋一遍。 ## 环境依赖 先看看环境要求,其实不算


解析XML时,本地文件用ElementTree.parse(),网络字符串用fromstring()。命名空间需显式声明或使用“.//tag”模糊匹配。文本为空时用strip()判断,含子标签用itertext()拼接。findall()查直接子节点,iter()深度遍历,需按需选用。

基于SQLite实现爬虫断点续传,需建表含url、status、updated_at三列,使用INSERTORIGNORE防重。请求前将URL标记为pending,成功后更新为success,失败更新为error。重启时对error状态URL设置冷却时间再重置为pending,避免无限重试,并记录更新时间用于超时重试判断。

爬虫数据提取最可靠的验证方式是回溯HTML节点层级,确认选择器命中目标元素。需用开发者工具定位真实结构,避免被动态class、JS渲染干扰。使用属性锚定和结构断言,区分服务端与客户端渲染,并用正则校验提取结果格式,确保每次抓取流程中嵌入验证。

调试爬虫核心:让变量“开口说话”,在发送请求后立即检查response.status_code、url和text[:200]内容。必须使用Debug模式而非Run,并确保未勾选RunwithPythonConsole。常见问题:HTTP200但response.text为空或包含反爬代码,需检查请求头(如User-Agent)和解码方式。若Beautiful

动态下拉菜单爬取常见问题包括元素未加载、被遮挡或嵌套iframe、事件未触发及反爬拦截。解决方案涉及使用WebDriverWait等待可点击、切换iframe、执行JavaScript点击、触发change事件,以及隐藏自动化特征以规避反爬。

评论接口翻页参数常为动态加密字符串,时间戳需对齐服务器时钟,签名算法涉及多步哈希与密钥拼接,行为链检测请求间隔、User-Agent与Referer等,需利用真实浏览器环境或断点调试JS才能绕过。

全站图片抓取需关注页面层级关系与URL边界管理,用requests+BeautifulSoup递归爬取并控制深度。图片提取需处理src、data-src等属性,过滤占位图与base64。去重采用URL归一化与哈希指纹双保险,避免重复下载。使用asyncio+aiohttp配合并发控制及重试机制,稳定性优于多线程。

由于Flash已正式退役,swf文件无法渲染或加载,爬取Flash内容只能通过逆向分析浏览器网络请求与JavaScript初始化逻辑,获取迁移后的媒体流链接(如mp4、m3u8),并正确处理Referer、User-Agent等请求头及签名逻辑,从而成功获取媒体流,这是爬取Flash遗留内容的关键技术。
正确构造带文件上传的 multipart/form-data 请求需用 requests.Session() 管理 Cookie,data 传文本字段、files 传文件元组,由 requests 自动设 boundary 和 Content-Type;CSRF Token 需先 GET 提取再即时
Playwright:搞定动态网页抓取,这才是稳扎稳打的方案 说到抓取动态网页,Playwright 目前是公认最稳妥的方案之一。它可不是简单的模拟请求,而是能真实启动浏览器、完整执行 Ja vaScript、耐心等待所有内容加载完毕,甚至还能模拟用户的点击、滚动等交互行为。比起老牌的 Seleni
最简可行方案:用 HttpClient 抓取网页,用 HtmlAgilityPack 提取文本 话说回来,想快速上手一个能用的C#爬虫,其实没那么复杂。核心就两件事:把网页HTML拿下来,再把需要的文本信息提出来。下面这个最简可行方案,能帮你避开绝大多数新手坑。 用 HttpClient 抓取网页
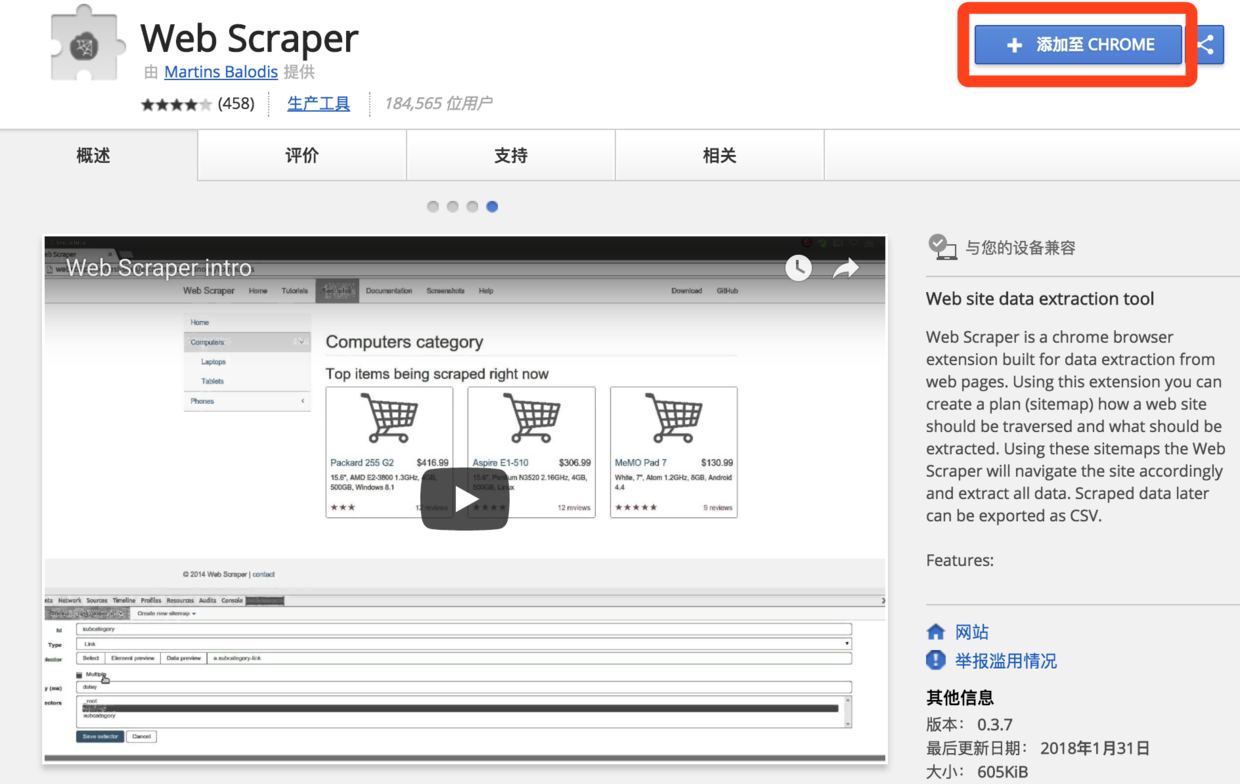
环境需求这个工具对环境的要求非常简单,只需一台能上网的电脑和一个版本号大于31的Chrome浏览器即可。当然,浏览器版本越新越好,目前Chrome浏览器已更新至60多版本,满足要求并不难。在线安装过程在线安装需要能够翻墙,访问Chrome应用商店在线访问WebScraper插件页面,点击“添加至Chrome”按钮。2.在弹出的对话框中点击“添加扩展程序”。3.安装完成后,WebScraper的图标将显示在浏览器顶部工具栏中。本地安装过程无法翻墙的用户可以使用本地安装方式,在本公众号回复「爬虫」可下
Go语言爬虫常用错误处理策略包括:网络错误重试并配合指数退避,根据HTTP状态码区分客户端与服务器错误以决定重试逻辑,解析失败时校验HTML格式与编码,数据提取时判断空值;通过context控制超时,用fmt.Errorf包装错误保留上下文,确保爬虫健壮性。
随着互联网的发展,爬虫越来越受到人们的关注,因为爬虫可以在互联网上收集大量的数据,并进行分析和处理,这对于很多行业来说是非常有帮助的。本文将介绍使用PHP实现一个简单的爬虫,以爬取豆瓣电影评论为例。一、前期准备安装PHP首先需要安装PHP,你可以从官网下载最新的PHP安装包,并按照提示进行安装即可。安装Curl扩展Curl是PHP中一个
Scrapy框架爬取Twitter数据的实现随着互联网的发展,社交媒体已成为人们广泛使用的平台之一。而Twitter作为全球最大的社交网络之一,每天都有海量的信息产生。因此,如何利用现有的技术手段有效地获取并分析Twitter上的数据就变得尤为重要。Scrapy是一个Python的开源框架,专门用于抓取和提取特定网站上的数据。相对于其他类似框架,Scrapy
随着互联网的不断发展,数据已经成为产业和研究领域的重要资源。因此,网络爬虫逐渐成为获取和处理数据的重要方式。而PHP和Selenium的组合也被证明是一种非常强大的网络爬虫开发工具包。本文将为您介绍如何使用PHP和Selenium来编写网络爬虫,以及如何处理所获取的数据。在本文中,我们将通过实际示例来演示如何使用这些工具,让您更好地掌握网络爬虫的开发。什么是
Java的爬虫应用教程,实战数据抓取与分析随着互联网时代的到来,数据成为了企业和个人获取成功的一条必经之路,所以数据的重要性也越来越高。而爬虫技术作为数据获取的利器,在各行各业都得到了广泛的应用。本文将介绍如何使用Java语言编写爬虫,实现数据的抓取与分析。一、前置知识在学习Java爬虫之前,需要掌握以下几个基础知识:Java语言基础:至少需要了解Java中
近年来,随着电商市场的蓬勃发展,天猫成为了中国最大的电商平台之一。对于公司而言,想要了解目标市场,了解自身产品的销售状况,获取竞争对手的销售状况等信息是十分重要的。在这种情况下,爬取天猫数据成为了企业常用的方式之一。本文将介绍如何使用Scrapy爬虫框架爬取天猫数据,并对数据进行简要分析。一、Scrapy爬虫的基本使用Scrapy是一个用于Web数据抓取的P
在如今的信息技术时代,海量数据的爬取成为了一项重要的技能。而随着大数据技术的快速发展,数据爬取技术也不断得到更新和改进。其中,Scrapy框架无疑是最为常用和流行的一种框架,其在数据爬取和处理上有着独特的优势和灵活性。本文将介绍如何使用Scrapy框架爬取Flickr图片库。Flickr是一个图片分享网站,其库存有数亿张图片,具备非常大量的数据资源。通过Sc
写在前面python是当下最为流行的编程语言之一,它在爬虫、自动化测试、数据分析等领域有着广泛的应用。Http请求是WEB应用开发的基础,掌握HTTP请求的艺术可以帮助你更优雅地处理网络数据。HTTP请求的基础知识HTTP请求是一个发送到Web服务器的请求,服务器会返回一个响应。一个HTTP请求由以下部分组成:请求行:它包含HTTP方法(如GET、POST)、请求URI和HTTP协议版本。请求头:它包含一些关于请求的元数据,如请求的来源、内容类型和长度。请求它包含请求的数据,如表单数据或JSON数据。服务
高级技巧:掌握Go语言在爬虫开发中的进阶应用引言:随着互联网的迅速发展,网页上的信息量日益庞大。而获取网页中的有用信息,就需要使用爬虫。Go语言作为一门高效、简洁的编程语言,在爬虫开发中广受欢迎。本文将介绍Go语言在爬虫开发中的一些高级技巧,并提供具体的代码示例。一、并发请求在进行爬虫开发时,我们经常需要同时请求多个页面,以提高数据的获取效率。Go语言中提供
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。


