

如何使用Python的sklearn CountVectorizer?
简介CountVectorizer官方文档。将一个文档集合向量化为为一个计数矩阵。如果不提供一个先验字典,不使用分析器做某种特征选择,那么特征的数量将等于通过分析数据发现的词汇量。数据预处理两种方法:1.可以不分词直接投入模型;2.可以先将中文文本进行分词。两种方法产生的词汇会非常不同。在后面会具体给出示范。importjiebaimportrefromsklearn.feature_extraction.textimportCountVectorizer#原始数据text=['很少在公众场合手机
简介
CountVectorizer官方文档。
将一个文档集合向量化为为一个计数矩阵。
如果不提供一个先验字典,不使用分析器做某种特征选择,那么特征的数量将等于通过分析数据发现的词汇量。
数据预处理
两种方法:1.可以不分词直接投入模型;2.可以先将中文文本进行分词。
两种方法产生的词汇会非常不同。在后面会具体给出示范。
import jieba
import re
from sklearn.feature_extraction.text import CountVectorizer
#原始数据
text = ['很少在公众场合手机外放',
        '大部分人都还是很认真去学习的',
        '他们会用行动来',
        '无论你现在有多颓废,振作起来',
        '只需要一点点地改变',
        '你的外在和内在都能焕然一新']
#提取中文
text = [' '.join(re.findall('[\u4e00-\u9fa5]+',tt,re.S)) for tt in text]
#分词
text = [' '.join(jieba.lcut(tt)) for tt in text]
text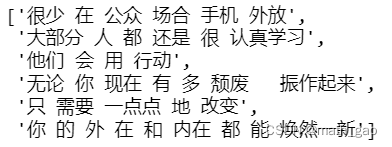
构建模型
训练模型
#构建模型
vectorizer = CountVectorizer()
#训练模型
X = vectorizer.fit_transform(text)
所有词汇:model.get_feature_names()
#所有文档汇集后生成的词汇
feature_names = vectorizer.get_feature_names()
print(feature_names)
不分词生成的词汇

分词后生成的词汇

计数矩阵:X.toarray()
#每个文档相对词汇量出现次数形成的矩阵
matrix = X.toarray()
print(matrix)
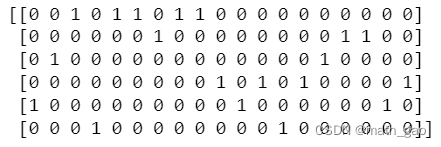
#计数矩阵转化为DataFrame
df = pd.DataFrame(matrix, columns=feature_names)
df
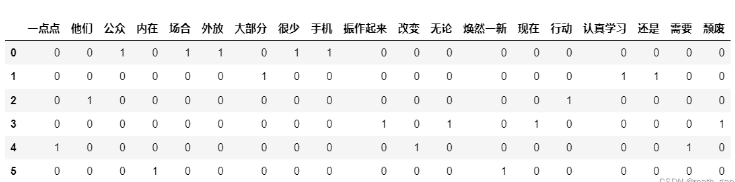
词汇索引:model.vocabulary_
print(vectorizer.vocabulary_)

通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。
本教程通过实战案例详解UniApp开发流程,包括项目初始化、页面结构解析、数据绑定与事件处理,帮助初学者快速上手跨平台应用开发。
详细讲解2026年最新版Android Studio的下载与安装步骤,涵盖JDK环境检查、组件选择及初始配置,助您顺利开启安卓应用开发之旅。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。