

如何在MySQL中添加自定义函数?
1背景MySQL语法解析器用的bison(即yacc)来实现的,而词法解析是自己来实现的,涉及到的token都在文件lex.h里面,然后通过Lex_input_stream里面相关的函数,解析client的sql字节流(其中会通过提前构造好的hash表帮助快速找到对应symbol,相关代码在sql_lex_hash.cc里面),转换为token,交给bison进行语法解析。为了给MySQL添加一个新的语法,我们必须添加新的token(如果有新增),以及增加新的语法(sql_yacc.yy)里面。本文以给c
1 背景
MySQL语法解析器用的bison(即yacc)来实现的,而词法解析是自己来实现的,涉及到的token都在文件lex.h里面,然后通过Lex_input_stream 里面相关的函数,解析client的sql字节流(其中会通过提前构造好的hash表帮助快速找到对应symbol,相关代码在sql_lex_hash.cc里面),转换为token,交给bison进行语法解析。
为了给MySQL添加一个新的语法,我们必须添加新的token(如果有新增),以及增加新的语法(sql_yacc.yy)里面。本文以给create table增加一个新的options为例,来演示如何给MySQL新增一个语法。最终的效果如下:
create table t1 (
  id int primary key,
  name varchar(100)
) global_partition by hash(id) partitions 10; //global_partition by为新增语法,global_partition为新增token
涉及到的修改文件如下:
sql/lex.h //token
sql/parse_tree_nodes.cc
sql/parse_tree_nodes.h
sql/parse_tree_partitions.cc
sql/parse_tree_partitions.h
sql/parser_yystype.h
sql/sql_yacc.yy
2 新增关键词(token)
文件:sql/lex.h
static const SYMBOL symbols[] = {
    /*
     Insert new SQL keywords after that commentary (by alphabetical order):
    */
    //省略部分代码
    {SYM("GLOBAL_PARTITION", GLOBAL_PARTITION_SYM)}, //注意按照字典序进行添加。
    //省略部分代码
};
按照上面的格式添加即可
3 新增语法
文件:sql/sql_yacc.yy
该文件为bison的语法,关于bison语法可以查看这里。下面凡是注释标有###为新增部分,没有标的注释是为了方便理解
%tokenGLOBAL_PARTITION_SYM 1309 /* seancheer */ //### 声明上一步添加的token,声明了才可以使用,编号1309选择一个未使用的就行 %type global_partition_clause //### 声明新增加的数据结构,后面会介绍 create_table_stmt: CREATE opt_temporary TABLE_SYM opt_if_not_exists table_ident '(' table_element_list ')' opt_create_table_options_etc //最后一个标记在YYSTYPE中对应的是create_table_tail, 后面会介绍 { $$= NEW_PTN PT_create_table_stmt(YYMEM_ROOT, $1, $2, $4, $5, $7, $9.opt_create_table_options, $9.opt_partitioning, $9.opt_global_partitioning, //### 赋值给对应参数,该构造函数需要新增,后面会介绍 $9.on_duplicate, $9.opt_query_expression); } | CREATE opt_temporary TABLE_SYM opt_if_not_exists table_ident opt_create_table_options_etc { $$= NEW_PTN PT_create_table_stmt(YYMEM_ROOT, $1, $2, $4, $5, NULL, $6.opt_create_table_options, $6.opt_partitioning, $6.opt_global_partitioning, //### 赋值给对应参数,该构造函数需要新增,后面会介绍 $6.on_duplicate, $6.opt_query_expression); //partition相关的语法 opt_create_partitioning_etc: partition_clause opt_duplicate_as_qe //这里是原生的partition表语法 { $$= $2; $$.opt_partitioning= $1; } | global_partition_clause opt_duplicate_as_qe //### 此处是新增的global_partition语法, { $$= $2; $$.opt_global_partitioning= $1; } | opt_duplicate_as_qe ; //### 下面为重点,新增的global_partition语法,可以看到,用到了新增的token global_partition_clause: GLOBAL_PARTITION_SYM BY part_type_def opt_num_parts { $$= NEW_PTN PT_global_partition($3, @4, $4); } ;
4 类似于PT_partition添加对应的数据结构global_partition_clause
文件:parser_yystype.h:该文件是bison(yacc)运行的一环,代替bison内置的YYSTYPE的,当bison对相关语法解析后,需要构造相关的数据结构,通过对YYSTYPE的自定义,就可以实现构造自定义数据结构的目的了。添加我们自定义的数据结构代码如下:
union YYSTYPE {
  PT_sub_partition *opt_sub_part;
  PT_part_type_def *part_type_def;
  PT_partition *partition_clause;
  PT_global_partition *global_partition_clause; //新加数据结构

  struct {
    Mem_root_array *opt_create_table_options;
    PT_partition *opt_partitioning;
    PT_global_partition *opt_global_partitioning; //同时注意添加到create_table_tail里面,因为create table语法会有该操作
    On_duplicate on_duplicate;
    PT_query_primary *opt_query_expression;
  } create_table_tail;
};
static_assert(sizeof(YYSTYPE) <= 40, "YYSTYPE is too big"); //因为struct里面添加了一个成员变量,所以该union需要的空间也会变大,因此注意修改这一行 下面内容介绍PT_global_partition数据结构,为了保持和MySQL习惯一致,新增加的数据结构放在了
sql/parse_tree_nodes.cc sql/parse_tree_nodes.h sql/parse_tree_partitions.cc sql/parse_tree_partitions.h
四个文件里,理论上可以放在任何地方。可根据自身需求添加对应数据结构:
文件:sql/parse_tree_partitions.h sql/parse_tree_partitions.cc
/**
新增数据结构
*/
class PT_global_partition : public Parse_tree_node {
    typedef Parse_tree_node super;

    PT_part_type_def *const part_type_def;
    const POS part_defs_pos;
    uint num_parts;
public:
    partition_info part_info;
public:
    PT_global_partition(PT_part_type_def *part_type_def, const POS &part_defs_pos,
                        uint opt_num_parts)
            : part_type_def(part_type_def),
              part_defs_pos(part_defs_pos),
              num_parts(opt_num_parts) {}
    bool contextualize(Parse_context *pc) override;
};

//模仿其原生的实现方式即可
bool PT_global_partition::contextualize(Parse_context *pc) {
    if (super::contextualize(pc)) return true;

    Partition_parse_context part_pc(pc->thd, &part_info, false);
    if (part_type_def->contextualize(&part_pc)) return true;

    if (part_info.part_type != partition_type::HASH) {
        //only support hash partition for shard key
        my_error(ER_PARTITIONS_MUST_BE_DEFINED_ERROR, MYF(0), "NOT HASH");
        return true;
    }

    uint count_curr_parts = part_info.partitions.elements;

    if (part_info.num_parts != 0) {
        if (part_info.num_parts != count_curr_parts) {
            error(&part_pc, part_defs_pos,
                  ER_THD(pc->thd, ER_PARTITION_WRONG_NO_PART_ERROR));
            return true;
        }
    } else if (count_curr_parts > 0)
        part_info.num_parts = count_curr_parts;
    return false;
}文件:sql/parse_tree_nodes.cc sql/parse_tree_nodes.h
接下来修改create table对应的数据结构,将新增的PT_global_partition添加到create table里面
class PT_create_table_stmt final : public PT_table_ddl_stmt_base {
  PT_partition *opt_partitioning;
  PT_global_partition *opt_global_partitioning; //添加成员变量
  PT_create_table_stmt(
    MEM_ROOT *mem_root, PT_hint_list *opt_hints, bool is_temporary,
    bool only_if_not_exists, Table_ident *table_name,
    const Mem_root_array *opt_table_element_list,
    const Mem_root_array *opt_create_table_options,
    PT_partition *opt_partitioning,
    PT_global_partition *opt_global_partitioning, On_duplicate on_duplicate,
    PT_query_primary *opt_query_expression)
    : PT_table_ddl_stmt_base(mem_root),
  m_opt_hints(opt_hints),
  is_temporary(is_temporary),
  only_if_not_exists(only_if_not_exists),
  table_name(table_name),
  opt_table_element_list(opt_table_element_list),
  opt_create_table_options(opt_create_table_options),
  opt_partitioning(opt_partitioning),
  opt_global_partitioning(opt_global_partitioning), //添加构造函数,主要是为了增加对PT_global_partition的赋值操作
  on_duplicate(on_duplicate),
  opt_query_expression(opt_query_expression),
  opt_like_clause(nullptr) {}

//在其对应的函数中增加相关逻辑,调用对应的初始化函数contextualize
Sql_cmd *PT_create_table_stmt::make_cmd(THD *thd) {
    if (opt_global_partitioning){
        if (opt_global_partitioning->contextualize(&pc)) return nullptr;
        lex->part_info = &opt_global_partitioning->part_info;
    }
} 
详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。
深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。
刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。
深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。
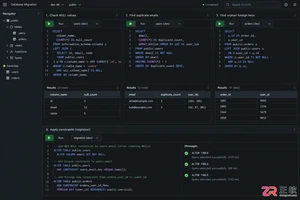
后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。
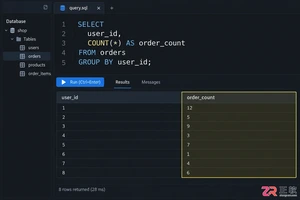
针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。
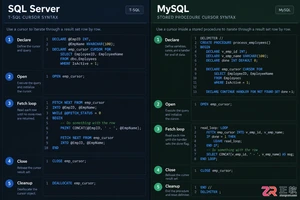
本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
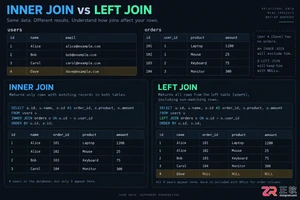
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



