

MySQL索引的作用是什么
首先建立一张数据库表:createtablesingle_table(idintnotauto_increment,key1varchar(100),key2int,key3varchar(100),key_part1varchar(100),key_part2varchar(100),key_part3varchar(100),common_fieldvarchar(100),primarykey(id),#聚簇索引keyidx_key1(key1),#二级索引uniquekeyuk_key2(key2
首先建立一张数据库表:
create table single_table(
	id int not auto_increment,
	key1 varchar(100),
	key2 int,
	key3 varchar(100),
	key_part1 varchar(100),
	key_part2 varchar(100),
	key_part3 varchar(100),
    common_field varchar(100),
	primary key(id),          # 聚簇索引
	key idx_key1(key1),       # 二级索引
	unique key uk_key2(key2), # 二级索引,而且该索引是唯一二级索引
	key idx_key3(key3),       # 二级索引
	key idx_key_part(key_part1,key_part2,key_part3) # 二级索引,也是联合索引
)Engine=InnoDB CHARSET=utf8;
1、索引用于减少需要扫描的记录数量
对于某个查询来说,最简单粗暴的执行方案就是扫描表中的所有记录,判断每一条搜索记录是否符合搜索条件。如果符合,就将其发送到客户端,否则就跳过该记录。这种执行方案被称为全表扫描。
对于InnoDB存储引擎来说,全表扫描意味着从聚簇索引第一个叶子节点的第一条记录开始,沿着记录所在的单向链表向后扫描,直到最后一个叶子节点的最后一条记录,如果可以利用B+树查找索引列值等于某个值的记录,这样就可以减少需要扫描的记录的数量。
由于B+树叶子节点中的记录是按照索引列值有小到大的顺序排序的,所以只需要扫描某个区间或者某些区间中的记录也可以明显减少需要扫描的记录的数量。
对于查询语句:
select * from single_table where id>=2 and id<=100;
这个语句其实就是想查找id值在[2,100]区间中的所有聚簇索引记录,我们可以通过聚簇索引对应的B+树快速的找到id=2的那条聚簇索引记录,然后沿着记录所在的单向链表向后扫描,直到某条聚簇索引记录的id值不在[2,100]区间中为止,与扫描全部的聚簇索引记录相比,这种方式大大减少了需要扫描的记录数量,所以提升了查询效率。
其实,对于B+树来说,只要索引列和常数使用=、<=>、in、not in、is null、is not null、>、<、>=、<=、between、!=、或者like操作符连接起来,就可以产生扫描区间,从而提高查询效率。
2、索引用于排序
我们在编写查询语句时,经常需要使用order by子句对查询出来的记录按照某种规则进行排序。在一般情况下,我们只能把记录加载到内存中,然后再用一些排序算法在内存中对这些记录进行排序。有时查询的结果集可能太大以至于在内存中无法进行排序,此时就需要暂时借助磁盘的空间来存放中间结果,在排序操作完成后再把排序的结果返回给客户端。
在MySQL中,这种在内存中或者磁盘中进行排序的方式称为文件排序,但是如果order by子句中使用了索引列,就有可能省去在内存或磁盘中排序的步骤。
1、分析下面的查询语句:
select * form single_table order by key_part1,key_part2,key_part3 limit 10;
这个查询语句的结果集需要先按照key_part1值排序,如果记录的key_part1值相同,再按照key_part2值排序,如果key_part1值和key_part2值都相同,再按照key_part3排序。而我们建立的联合索引idx_key_part就是按照上面的规则排序的,如下为idx_key_part索引的简化示意图:
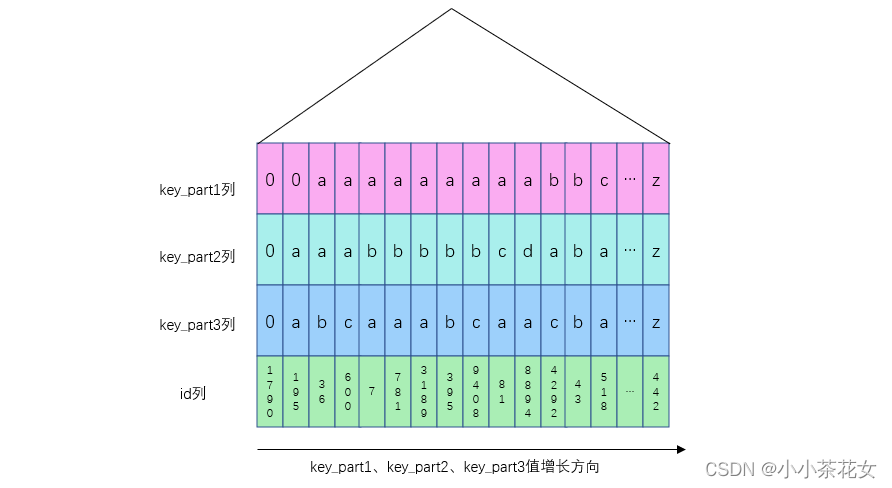
所以我们可以从第一条idx_key_part二级索引记录开始,沿着记录所在的单向链表向后扫描,取10条二级索引记录即可。由于我们的查询列表是*,也就是需要读取完整的用户记录,所以针对获取到的每一条二级索引记录都执行一次回表操作,将完整的用户记录发送给客户端。这样就省去了给10000条记录排序的时间。
这里我们在执行查询语句时加了limit语句,如果不限制需要获取的记录数量,会导致为大量二级索引记录执行回表操作,这样会影响整体的性能。
2、使用联合索引进行排序时的注意事项
在使用联合索引时,需要注意:order by子句后面的列的顺序也必须按照索引列的顺序给出;如果给出order by key_part3,key_part2,key_part1的顺序,则无法使用B+树索引。
之所以颠倒排序列顺序就不能使用索引,原因还是联合索引中页面和记录的排序规则是规定的,即先按照key_part1值排序,如果记录的key_part1值相同,再按照key_part2值排序,如果记录的key_part1值和key_part2值都相同,再按照key_part3值排序。如果order by子句的内容是order by key_part3,key_part2,key_part1,那就要求先按照key_part3值排序,如果记录的key_part3值相同,再按照key_part2值排序,如果记录的key_part3值和key_part2值都相同,再按照key_part1值排序,这显然是冲突的。
3、不可以使用索引进行排序的情况:
(1) ASC、DESC混用;
对于使用联合索引进行排序的场景,我们要求各个排序列的排序规则是一致的,也就是要么各个列都是按照升序规则排序,要么都是按照降序规则排序。
(2) 排序列包含非一个索引的列;
有时用来排序的多个列不是同一个索引中的,这种情况也不能使用索引进行排序,比如下面的查询语句:
select * from single_table order by key1,,key2 limit 10;
对于idx_key1的二级索引记录来说,只按照key1列的值进行排序,而且在key1列相同的情况下是不按照
key2列的值进行排序的,所以不能使用idx_key1索引执行上述查询。
(3) 排序列是某个联合索引的索引列,但是这些排序列在联合索引中并不连续;
(4) 排序列不是以单独列名的形式出现在order by子句中;
3、索引用于分组
有时为了方便统计表中的一些信息,会把表中的记录按照某些列进行分组。比如下面的分组查询语句:
select key_part1,key_part2,key_part3,count(*) fron single_table group by key_part1,key_part2,key_part3;
这个查询语句相当于执行了3次分组操作:
先按照
key_part1值把记录进行分组,key_part1值相同的所有记录划分为一组;将
key_part1值相同的每个分组中的记录再按照key_part2的值进行分组,将key_part2值相同的记录放到一个小分组中,看起来像是在一个大分组中又细分了好多小分组。再将上一步中产生的小分组按照
key_part3的值分成更小的分组。所以整体上看起来就像是先把记录分成一个大分组,然后再把大分组分成若干个小分组,最后把若干个小分组再细分为更多的小分组。
上面这个查询语句就是统计每个小小分组包含的记录条数。
如果没有idx_key_part索引,就得建立一个用于统计的临时表,在扫描聚簇索引的记录时将统计的中间结果填入这个临时表。当扫描完记录后,再把临时表中的结果作为结果集发送给客户端。
如果有了idx_key_part索引,恰巧这个分组顺序又与idx_key_part的索引列的顺序一致,因此可以直接使用idx_key_part的二级索引进行分组,而不用建立临时表了。
与使用B+树索引进行排序差不多,分组列的顺序页需要与索引列的顺序一致,也可以值使用索引列中左边连续的列进行分组。
详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。
深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。
刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。
深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。
后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。
针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。
本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



