

python内置堆如何实现
1.简介堆,又称优先队列,是一个完全二叉树,它的每个父节点的值都只会小于或等于所有孩子节点(的值)。它使用了数组来实现:从零开始计数,对于所有的k,都有heap[k]5,交换7和55.符合堆的要求,即结果为[2,5,3,7]原有数据不是堆importheapqh=[5,2,1,4,7]heapq.heappop(h)print(h)[1,2,7,4]操作流程如下:1.初始状态,很明显不符合堆的性质2.移除最上面的元素(第一个元素),重新对剩下的元素进行堆的排列3.依据python最小堆的特性,2>1交换2
1.简介
堆,又称优先队列,是一个完全二叉树,它的每个父节点的值都只会小于或等于所有孩子节点(的值)。 它使用了数组来实现:从零开始计数,对于所有的 k ,都有 heap[k] <= heap[2k+1] 和 heap[k] <= heap[2k+2]。 为了便于比较,不存在的元素被认为是无限大。 堆最有趣的特性在于最小的元素总是在根结点:heap[0]。
python的堆一般都是最小堆,与很多教材上的内容有所不同,教材上大多以最大堆,由于堆的表示方法,从上到下,从左到右存储,与列表十分相似,因此创建一个堆,可以使用list来初始化为 [] ,或者你可以通过一个函数 heapify() ,来把一个list转换成堆。如下是python中关于堆的相关操作,从这可以看出,python确实是将堆看作是列表去处理的。
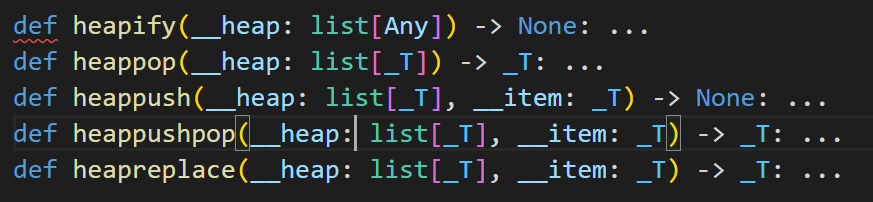
2.堆的相关操作
heapq.heappush(heap, item)
将 item 的值加入 heap 中,保持堆的不变性。会自动依据python中的最小堆特性,交换相关元素使得堆的根节点元素始终不大于子节点元素。
原有数据是堆
import heapq

h = [1, 2, 3, 5, 7]
heapq.heappush(h, 2)
print(h)
#输出
[1, 2, 2, 5, 7, 3]
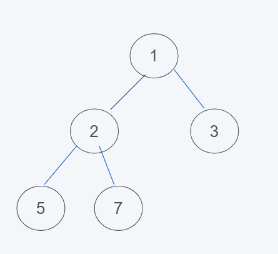
操作流程如下:
1.如下是初始状态
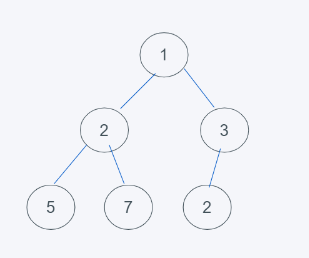
2.添加了2元素之后
3.由于不符合最小堆的特性,因此与3进行交换
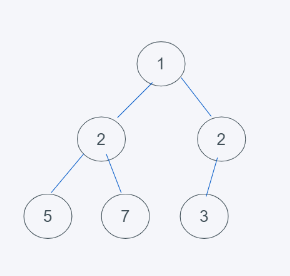
4.符合最小堆的特性,交换结束,因此结果是[1, 2, 3, 5, 7, 3]
原有数据不是堆
import heapq

h = [5, 2, 1, 4, 7]
heapq.heappush(h, 2)
print(h)
#输出
[5, 2, 1, 4, 7, 2]
由此可见,当进行push操作时,元素不是堆的情况下,默认按照列表的append方法进行添加元素
heapq.heappop(heap)
弹出并返回 heap 的最小的元素,保持堆的不变性。如果堆为空,抛出 IndexError 。使用 heap[0] ,可以只访问最小的元素而不弹出它。
原有数据是堆
import heapq

h = [1, 2, 3, 5, 7]
heapq.heappop(h)
print(h)
#输出
[2, 5, 3, 7]
操作流程如下:
1.初始状态
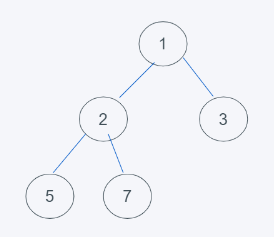
2.删除了堆顶元素,末尾元素移入堆顶
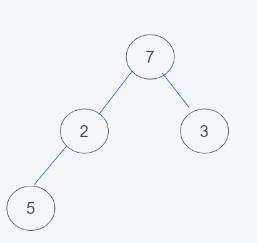
3.依据python最小堆的特性进行交换元素,由于7>2,交换7和2
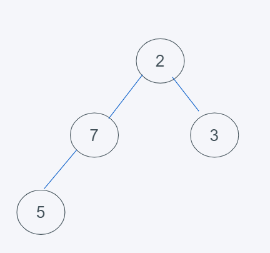
4.依据python最小堆的特性进行交换元素,由于7>5,交换7和5
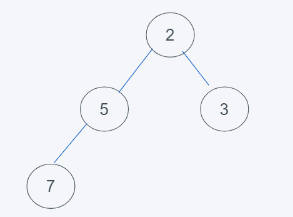
5.符合堆的要求,即结果为[2, 5, 3, 7]
原有数据不是堆
import heapq

h = [5, 2, 1, 4, 7]
heapq.heappop(h)
print(h)

[1, 2, 7, 4]
操作流程如下:
1.初始状态,很明显不符合堆的性质
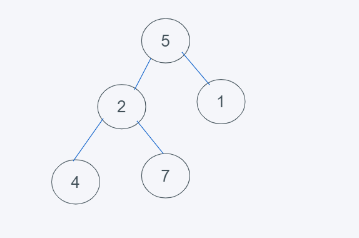
2.移除最上面的元素(第一个元素),重新对剩下的元素进行堆的排列
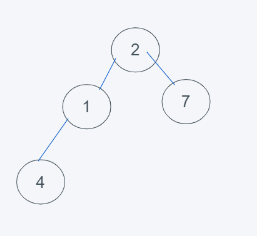
3.依据python最小堆的特性,2>1 交换2与1
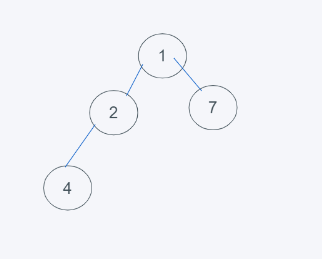
4.符合堆的要求,结果为[1, 2, 7, 4]
heapq.heappushpop(heap, item)
将 item 放入堆中,然后弹出并返回 heap 的最小元素。该组合操作比先调用 heappush() 再调用 heappop() 运行起来更有效率。需要注意的是弹出的元素必须位于堆顶或者堆尾,也就是说当插入一个元素后,进行比较最小元素时,其实一直比较的都是堆顶元素,如果插入元素大于或等于堆顶元素,则堆不会发生变化,当插入元素小于堆顶元素,则堆会依据python堆的最小堆特性进行处理。
原有数据是堆
import heapq

h = [1, 2, 3, 5, 7]
min_data = heapq.heappushpop(h, 2)
print(min_data)
print(h)
#输出
1
[2, 2, 3, 5, 7]
操作流程如下
1.初始状态
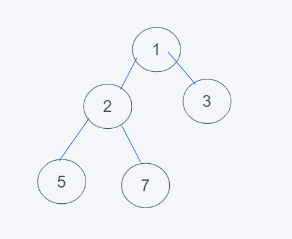
2.插入元素2
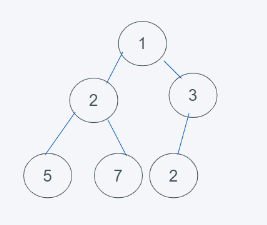
3.删除最小元素,刚好是堆顶元素1,并使用末尾元素2代替
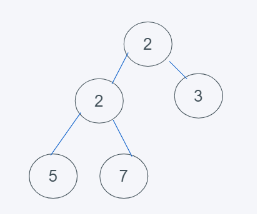
4.符合要求,即结果为[2, 2, 3, 5, 7]
原有数据不是堆
h = [5, 2, 1, 4, 7]
min_data = heapq.heappushpop(h, 2)
print(min_data)
print(h)
min_data = heapq.heappushpop(h, 6)
print(min_data)
print(h)

#输出
2
[5, 2, 1, 4, 7]
5
[1, 2, 6, 4, 7]
对于插入元素6的操作过程如下
1.初始状态
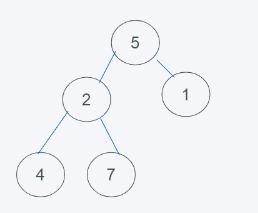
2.插入元素6之后
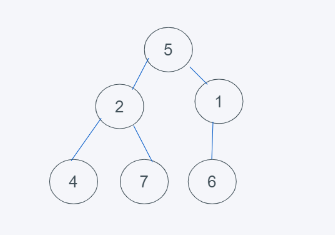
3.发现元素6大于堆顶元素5,弹出堆顶元素5,由堆尾元素6替换
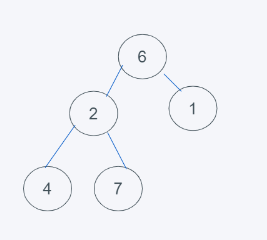
4.依据python的最小堆特性,元素6>元素1且元素6>元素2,但元素2>元素1, 交换6与1
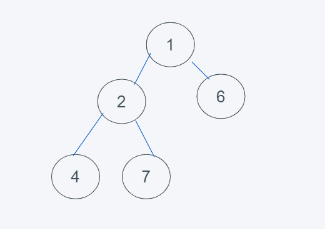
5.符合要求,则结果为[1, 2, 6, 4, 7]
由结果可以看出,当插入元素小于堆顶元素时,则堆不会发生改变,当插入元素大于堆顶元素时,则堆依据python堆的最小堆特性处理。
heapq.heapify(x)
将列表转换为堆。
h = [1, 2, 3, 5, 7]
heapq.heapify(h)
print(h)
h = [5, 2, 1, 4, 7]
heapq.heapify(h)
print(h)
#输出
[1, 2, 3, 5, 7]
[1, 2, 5, 4, 7]
会自动将列表依据python最小堆特性进行重新排列。
heapq.heapreplace(heap, item)
弹出并返回最小的元素,并且添加一个新元素item,这个单步骤操作比heappop()加heappush() 更高效。适用于堆元素数量固定的情况。
返回的值可能会比添加的 item 更大。 如果不希望如此,可考虑改用heappushpop()。 它的 push/pop 组合会返回两个值中较小的一个,将较大的值留在堆中。
import heapq

h = [1, 2, 3, 5, 7]
heapq.heapreplace(h, 6)
print(h)
h = [5, 2, 1, 4, 7]
heapq.heapreplace(h, 6)
print(h)
#输出
[2, 5, 3, 6, 7]
[1, 2, 6, 4, 7]
原有数据是堆
对于插入元素6的操作过程如下:
1.初始状态
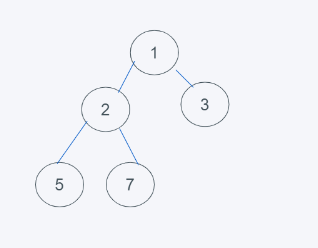
2.弹出最小元素,只能弹出堆顶或者堆尾的元素,很明显,最小元素是1,弹出1,插入元素是6,代替堆顶元素
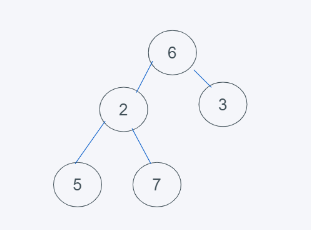
3.依据python堆的最小堆特性,6>2,交换6与2
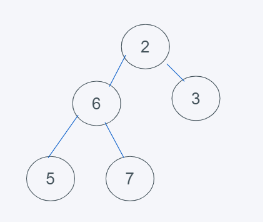
4.依据python堆的最小堆特性,6>5,交换6与5
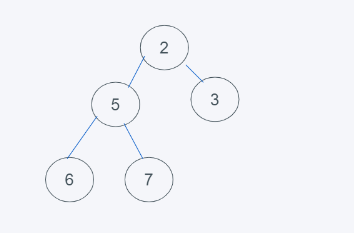
5.符合要求,则结果为[2, 5, 3, 6 ,7]
原有数据不是堆
对于插入元素6的操作过程如下:
1.初始状态
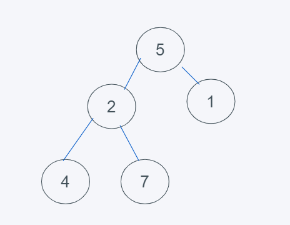
2.对于数据不为堆的情况下,默认移除第一个元素,这里就是元素5,然后插入元素6到堆顶
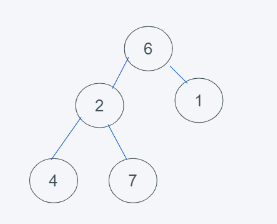
3.依据python的最小堆特性,元素6>1,交换元素6与1
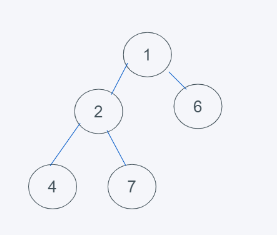
4.符合要求,即结果为[1, 2, 6, 4, 7
heapq.merge(*iterables, key=None, reverse=False)
将多个已排序的输入合并为一个已排序的输出(例如,合并来自多个日志文件的带时间戳的条目)。 返回已排序值的 iterator。注意需要是已排序完成的可迭代对象(默认为从小到大排序),当reverse为True时,则为从大到小排序。
heapq.nlargest(n, iterable, key=None)
从 iterable 所定义的数据集中返回前 n 个最大元素组成的列表。 如果提供了 key 则其应指定一个单参数的函数,用于从 iterable 的每个元素中提取比较键 (例如 key=str.lower)。
等价于: sorted(iterable, key=key, reverse=True)[:n]。
import time
import heapq

h = [1, 2, 3, 5, 7]

size = 1000000
start = time.time()
print(heapq.nlargest(3, h))
for i in range(size):
    heapq.nlargest(3, h)
print(time.time() - start)

start = time.time()
print(sorted(h, reverse=True)[:3:])
for i in range(size):
    sorted(h, reverse=True)[:3:]
print(time.time() - start)
#输出
[7, 5, 3]
1.6576552391052246
[7, 5, 3]
0.2772986888885498
[7, 5, 4]
由上述结构可见,heapq.nlargest与sorted(iterable, key=key, reverse=False)[:n]功能是类似的,但是性能方面还是sorted较为快速。
heapq.nsmallest(n, iterable, key=None)
从 iterable 所定义的数据集中返回前 n 个最小元素组成的列表。 如果提供了 key 则其应指定一个单参数的函数,用于从 iterable 的每个元素中提取比较键 (例如 key=str.lower)。 等价于: sorted(iterable, key=key)[:n]。
import time
import heapq

h = [1, 2, 3, 5, 7]

size = 1000000
start = time.time()
print(heapq.nsmallest(3, h))
for i in range(size):
    heapq.nsmallest(2, h)
print(time.time() - start)

start = time.time()
print(sorted(h, reverse=False)[:3:])
for i in range(size):
    sorted(h, reverse=False)[:2:]
print(time.time() - start)
#输出
[1, 2, 3]
1.1738648414611816
[1, 2, 3]
0.2871997356414795
由上述结果可见,sorted的性能比后面两个函数都要好,但如果只是返回最大的或者最小的一个元素,则使用max和min最好。
3.堆排序
由于在python中堆的特性是最小堆,堆顶的元素始终是最小的,可以将序列转换成堆之后,再使用pop弹出堆顶元素来实现从小到大排序。具体实现如下:
from heapq import heappush, heappop, heapify


def heapsort(iterable):
    h = []
    for value in iterable:
        heappush(h, value)
    return [heappop(h) for i in range(len(h))]


def heapsort2(iterable):
    heapify(iterable)
    return [heappop(iterable) for i in range(len(iterable))]


data = [1, 3, 5, 7, 9, 2, 4, 6, 8, 0]

print(heapsort(data))
print(heapsort2(data))
#输出
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
4.堆中元素可以是元组形式,主要用于任务优先级
from heapq import heappush, heappop

h = []
heappush(h, (5, 'write code'))
heappush(h, (7, 'release product'))
heappush(h, (1, 'write spec'))
heappush(h, (3, 'create tests'))
print(h)
print(heappop(h))

[(1, 'write spec'), (3, 'create tests'), (5, 'write code'), (7, 'release product')]
(1, 'write spec')
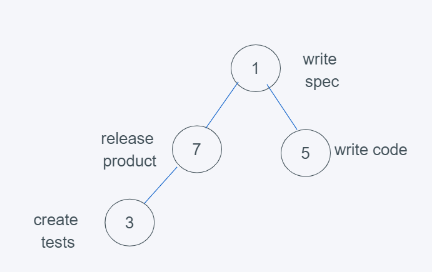
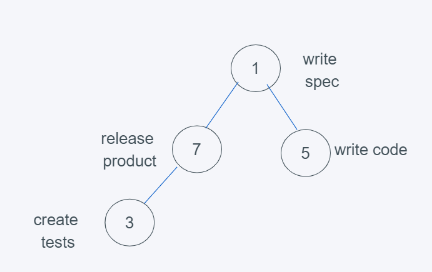
上述操作流程如下:
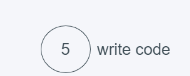
1.当进行第一次push(5, ‘write code’)时
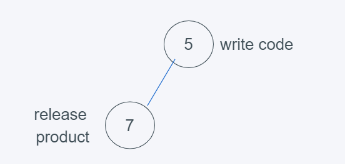
2.当进行第二次push(7, ‘release product’)时,符合堆的要求
3.当进行第三次push(1, ‘write spec’)时,
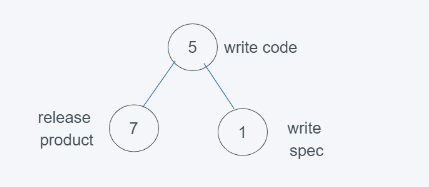
4.依据python的堆的最小堆特性,5>1 ,交换5和1
5.当进行最后依次push(3, ‘create tests’)时
6.依据python堆的最小堆特性,7>3,交换7与3
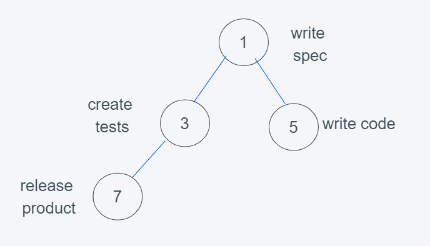
7.符合要求,因此结果为[(1, ‘write spec’), (3, ‘create tests’), (5, ‘write code’), (7, ‘release product’)],弹出元素则是堆顶元素,数字越小,优先级越大。

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



