

如何解决Python文本文件转码问题
测试数据注:测试文本采用UTF-8编码,通常汉字是占三个字节。GBK中汉字通常是占2个字节。编码转换代码importos#对于单个文件进行操作的函数,如果需要对文件夹进行操作,可以使用一个函数包装它,这样不用修改本函数,即达到扩展的目的了。deftransfer_encode(source_path,target_path,source_encode='GBK',target_encode='UTF-8'):withopen(source_path,mode='r&
测试数据
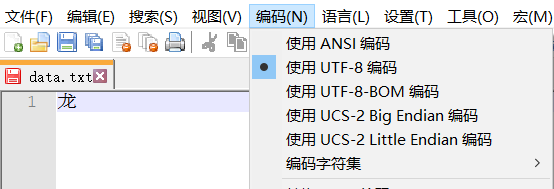
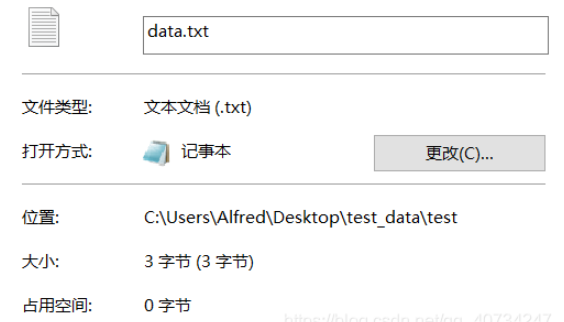
注:测试文本采用UTF-8编码,通常汉字是占三个字节。GBK中汉字通常是占2个字节。
编码转换代码
import os

# 对于单个文件进行操作的函数,如果需要对文件夹进行操作,可以使用一个函数包装它,这样不用修改本函数,即达到扩展的目的了。
def transfer_encode(source_path, target_path, source_encode='GBK', target_encode='UTF-8'):
    with open(source_path, mode='r', errors='ignore', encoding=source_encode) as source_file:  # 读取文件时,如果直接忽略报错,则程序正常执行,但是文件已经损坏了。
        with open(target_path, mode='w', encoding=target_encode) as target_file:               # 所以,应该捕获异常,停止程序执行。
            line = source_file.readline()
            while line != '':
                target_file.write(line)
                line = source_file.readline()
    print("Execute End!")


# 这个函数的功能和上面是一样的,区别在于它是以二进制读取的,然后解码、转码再写入的
def transfer_encode2(source_path, target_path, source_encode='GBK', target_encode='UTF-8'):
    with open(source_path, mode='rb') as source_file:
        with open(target_path, mode="wb") as target_file:
            bs = source_file.read(1024)
            while len(bs) != 0:
                target_file.write(bs.decode(source_encode).encode(target_encode))
                bs = source_file.read(1024)
    print("Execute End!")


source_path = r'C:\Users\Alfred\Desktop\test_data\test\data.txt'
target_path = r'C:\Users\Alfred\Desktop\test_data\test\data1.txt'

transfer_encode(source_path=source_path, target_path=target_path, source_encode="UTF-8", target_encode="GBK")

# transfer_encode2(source_path=source_path, target_path=target_path)

# 在cmd中使用 type命令,可以查看文件的内容,并且使用cmd默认的编码。
# 使用 chcp 命令可以查看当前使用的编码的数字编号
执行结果
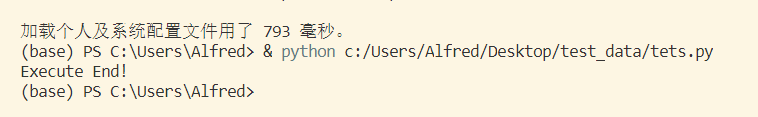
控制台输出 这个函数执行的输出没有什么意义,只是我要知道它执行了没,所以打印的。
测试文件夹 data1.txt是转换编码后的文本。
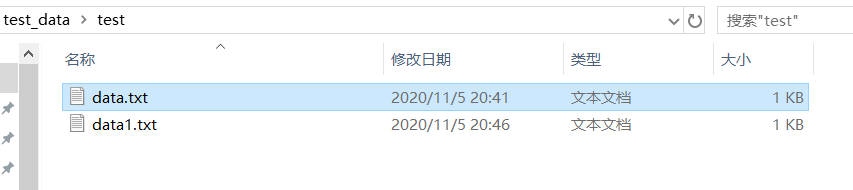
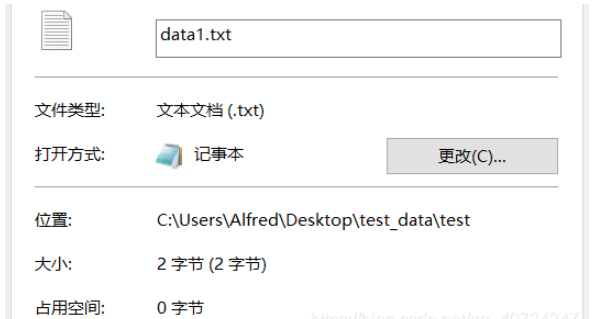
从生成的文件来看,因为只含有一个字,所以只比较大小就知道是否转换成功了。当然了,直接打开查看也是可以的,但是直接打开查看的话,没有什么效果,都会显示一个汉字龙。所以,这里我们另辟蹊径,使用不一样的查看方式!
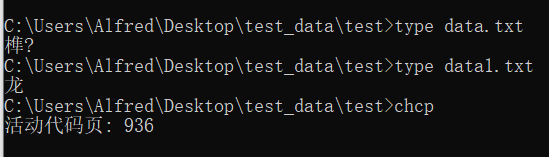
注意:data.txt是采用的UTF-8编码的,而data1.txt是采用的GBK编码的。因为国内使用的Windows默认采用的中国的编码方式,所以它显示不了UTF-8编码的文本。第三个输出是查看当前使用的编码,它返回的是编码的代号,详见下图:
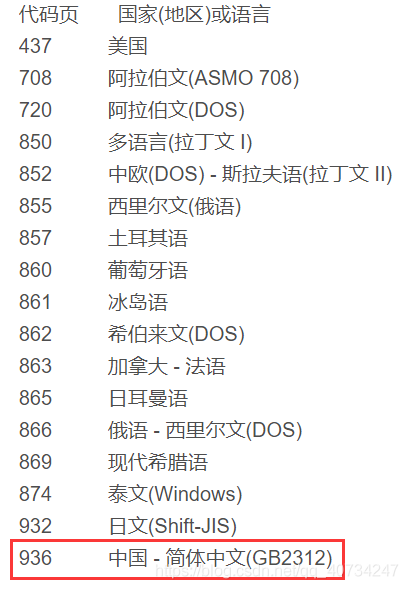
注:GBK是兼容GB2312的编码。
说明
使用python的话,对于单个文件进行编码转换,只需要7行代码就够了!上面我写了两个函数,但是功能是一样的,区别在于第一个函数是以特定的编码方式读取文本信息,然后直接以另一种编码方式写入。第二个函数是以二进制形式读取文件内容,然后解码再转码写入。它的原理都是一样的,即必须包括依次解码和转码操作。
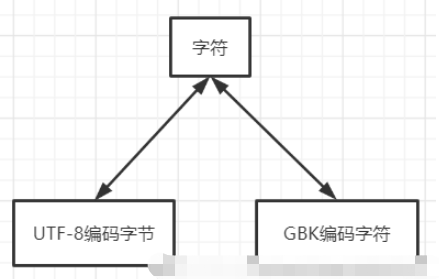
编码、解码、字符集本身是很复杂的,往深入了讲我也不会了。这里可以这样简化理解,两个不同编码的字符集具有相同的字符,所以将UTF-8编码文件读取出来,是为了得到它映射的字符,然后再写入,是为了将它映射为另一种编码字符集,所以说字符类似于中转站的功能。 而直接使用一种字符集去读取另一种字符集的内容,就会出现上面cmd中显示的乱码。
PS: 所以,也可以解释一个问题,即为什么打开一个大的文本文件,会导致程序卡死!因为一个大的文本文件,里面包含了很多需要解码的字符。这就和排队有点类似,每一个字符等待被解码,虽然处理一个字符很快,但是一个大的文本文件,包含了大量的字符。例如,notepad++打开大文本毫无压力, 我打开这个超大型的文本,还是直接把它卡死了!(这里的排队只是一个比喻,实际的情况我也不太清楚,但是它一定是需要挨个处理的。)
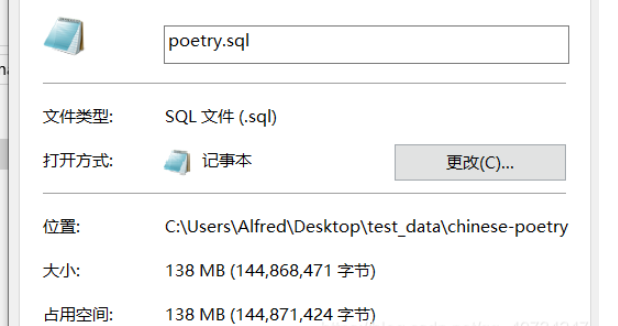
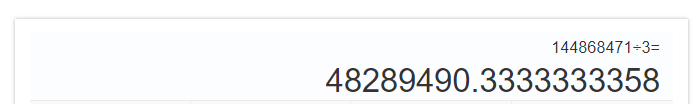
我们对其进行估计,假设所有字符都是中文(实际的话,还是包含一些英文的,当总的来说还是中文占多数。)这里显示是大约5千万的字符需要解码,所以计算机处理起来仍然是很吃力的,notepad++可以查看摘要,但是直接打开就卡死了,这里就不进行尝试了。

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



