

阿里云宣布自研 EMO 模型上线通义 App,用照片 + 音频生成唱歌视频
“本站4月25日消息,EMO(EmotePortraitAlive)是一个由阿里巴巴集团智能计算研究院开发的框架,一个音频驱动的AI肖像视频生成系统,能够通过输入单一的参考图像和语音音频,生成具有表现力的面部表情和各种头部姿势的视频。”阿里云今日宣布,通过实验室研发的AI模型——EMO正式上线通用App,并开放给所有用户免费使用。借助这一功能,用户可以在歌曲、热梗、表情包中任选一款模板,然后通过上传一张肖像照片就能让EMO合成演唱视频。根据介绍,通义App首批上线了80多个EMO模板,包括热门歌曲《上春山
“本站4月25日消息,EMO(Emote Portrait Alive)是一个由阿里巴巴集团智能计算研究院开发的框架,一个音频驱动的AI肖像视频生成系统,能够通过输入单一的参考图像和语音音频,生成具有表现力的面部表情和各种头部姿势的视频。”
阿里云今日宣布,通过实验室研发的 AI 模型 —— EMO 正式上线通用 App,并开放给所有用户免费使用。借助这一功能,用户可以在歌曲、热梗、表情包中任选一款模板,然后通过上传一张肖像照片就能让 EMO 合成演唱视频。

根据介绍,通义 App 首批上线了80多个 EMO 模板,包括热门歌曲《上春山》《野狼 Disco》等,还有网络热梗“钵钵鸡”“回手掏”等,但目前暂未提供自定义音频。
本站附 EMO 官网入口:
官方项目主页:https://humanaigc.github.io/emote-portrait-alive/
arXiv 研究论文:https://arxiv.org/abs/2402.17485
GitHub:https://github.com/HumanAIGC/EMO(模型和源码待开源)

EMO 的主要特点
生成EMO音频的视频:EMO能够根据输入的音频(如对话或歌曲)直接生成视频,无需依赖于预先录制的视频片段或3D面部模型。
高表现力和逼真度:EMO 生成的视频具有高度的表现力,能够捕捉并再现人类面部表情的细微差别,包括微妙的微表情,以及与音频节奏相匹配的头部运动。
无缝帧过渡:EMO 确保视频帧之间的过渡自然流畅,避免了面部扭曲或帧间抖动的问题,从而提高了视频的整体质量。
身份保持:通过 FrameEncoding 模块,EMO 能够在视频生成过程中保持角色身份的一致性,确保角色的外观与输入的参考图像保持一致。
稳定的控制机制:EMO 采用了速度控制器和面部区域控制器等稳定控制机制,以增强视频生成过程中的稳定性,避免视频崩溃等问题。
灵活的视频时长:EMO 可以根据输入音频的长度生成任意时长的视频,为用户提供了灵活的创作空间。
跨语言和跨风格:EMO 的训练数据集涵盖了多种语言和风格,包括中文和英文,以及现实主义、动漫和 3D 风格,这使得 EMO 能够适应不同的文化和艺术风格。

阿里巴巴2026财年ESG报告显示,AI成为效率与价值杠杆。自建数据中心PUE优化至1.187,清洁电力比例达73.6%,自身减排319.5万吨,带动客户避免排放约1亿吨。同时开源超400个模型,AI云教室覆盖400余所,平扫CT+AI筛查30万人次确诊800余例,高德鹰眼发布230亿次预警。
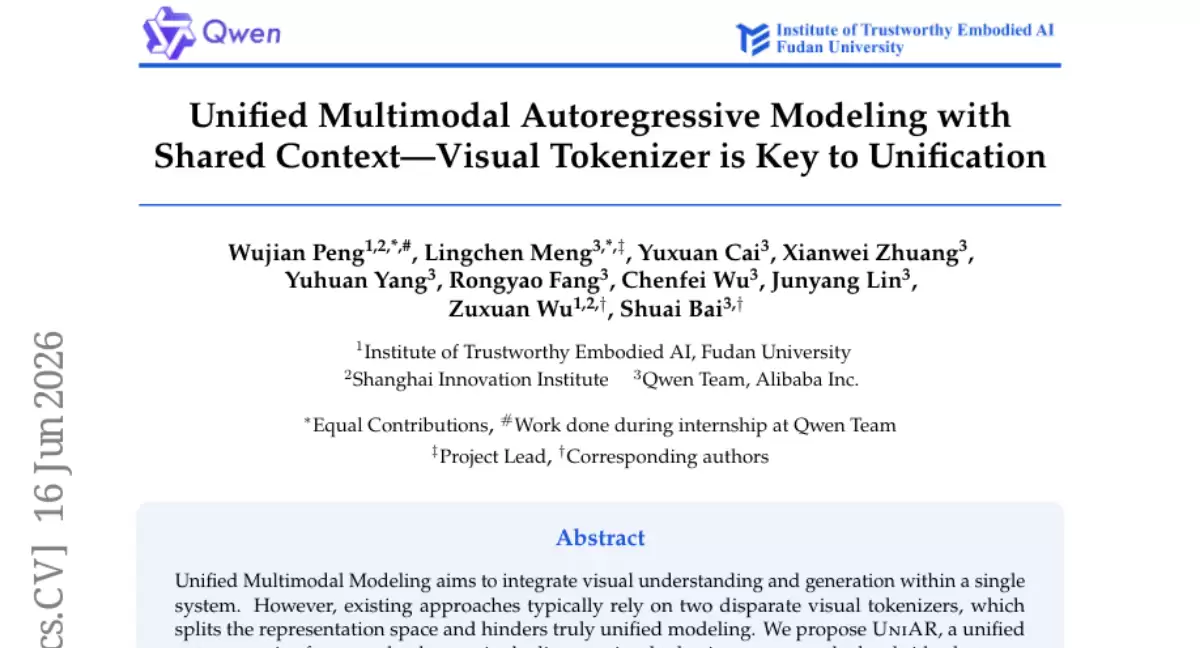
复旦大学与阿里巴巴联合提出的UniAR框架,通过统一的二进制球形量化与多层特征融合,使单一自回归模型同时实现图片理解与生成。三阶段训练后,该模型在指令遵循、文字渲染等多项测试中超越GPT-4o等模型,并展现出直接理解自身生成内容的能力。
阿里巴巴发布视频生成模型HappyHorse1.1,在动态表现力、主体一致性、指令遵循能力、视觉质感和音频处理等维度实现系统升级,视频流畅度、稳定性和画质显著提升,已登陆阿里云百炼与千问云平台。
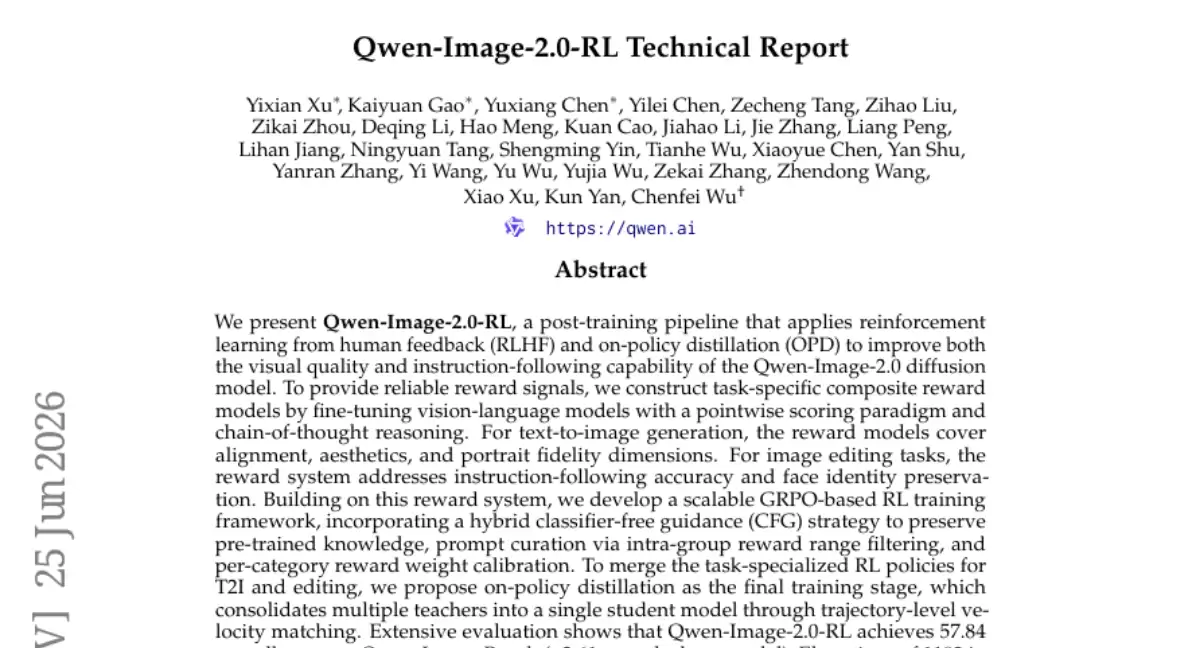
阿里Qwen团队提出Qwen-Image-2.0-RL,通过强化学习与人类反馈构建多维度奖励模型(图文对齐、美感、肖像),结合GRPO算法和混合CFG策略训练,并采用在线策略蒸馏合并文生图与编辑能力。在Qwen-Image-Bench总分提升2.61分,Elo评分文生图提升78分,图像编辑提升93分。
在企业内部,将云原生基础架构作为企业内部的统一架构已成为大势所趋。与此同时,也必然带来了由各种基础平台整合带来的兼容性问题,特别是规模越大、历史沉淀越多的企业,这种“技术债务”体现得越明显。本文分享的经验来自于阿里巴巴过去数年来在混合调度方面积累的生产实践积累,具有很强的生产实用价值。内容由浅入门,

今天,数字化成为企业的核心竞争力,千行百业都在拥抱云计算,拥抱云原生。2020年我们认为是云原生的落地元年,那么2021年将是云原生加速推动企业数字创新的关键节点。在3月29日阿里云计算峰会上,阿里巴巴研究员、阿里云智能云原生应用平台负责人丁宇(叔同)发表了《云原生,企业数字创新的最短路径》主题演讲
简介: 目前 KubeNode 已经覆盖了阿里巴巴集团的所有的 ASI 集群,接下来,将随着阿里巴巴集团“统一资源池”的项目,推进 KubeNode 覆盖更大的范围、更多的场景,让云原生的容器基础设施运维架构发挥更大的价值。 阿里巴巴节点运维的挑战 在阿里巴巴的场景下,做节点运维面临的挑战主要来自于
技术的成熟度源自大规模的实践,在 Ja va 领域,阿里将自身的实践源源不断的反哺给微服务技术体系;在 Node.js 领域,阿里正掀起了前所未有的前端革命浪潮,将实践反哺给 Serverless 技术体系,并逐渐拓展到其他多语言体系和后端 BaaS 上。Serverless云研发平台,乃阿里巴巴集
受台风和强降雨影响,广西南宁、贵港出现险情。阿里巴巴启动防汛应急行动,首批调拨1万个应急照明设备紧急装车,菜鸟物流负责人连夜赶赴现场协调。同时,阿里公益与壹基金支持的首批2500份应急食品已发车驰援灾区。
对于从事批发采购或寻找源头工厂的朋友来说,一个高效、可靠的线上采购平台至关重要。今天,我们就来详细解析1688阿里巴巴官网——这个国内领先的B2B批发市场,看看它如何打通从选品到交易的每一个环节,成为众多生意人的首选采购通道。其官网地址是 https://www.1688.com/,您可以直接访问,






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
