

一行 Python 代码实现并行
Python在程序并行化方面多少有些声名狼藉。撇开技术上的问题,例如线程的实现和GIL,我觉得错误的教学指导才是主要问题。常见的经典Python多线程、多进程教程多显得偏"重"。而且往往隔靴搔痒,没有深入探讨日常工作中最有用的内容。传统的例子简单搜索下"Python多线程教程",不难发现几乎所有的教程都给出涉及类和队列的例子:importosimportPILfrommultiprocessingimportPoolfromPILimportImage
Python 在程序并行化方面多少有些声名狼藉。撇开技术上的问题,例如线程的实现和 GIL,我觉得错误的教学指导才是主要问题。常见的经典 Python 多线程、多进程教程多显得偏"重"。而且往往隔靴搔痒,没有深入探讨日常工作中最有用的内容。
传统的例子
简单搜索下"Python 多线程教程",不难发现几乎所有的教程都给出涉及类和队列的例子:
import os
import PIL

from multiprocessing import Pool
from PIL import Image

SIZE = (75,75)
SAVE_DIRECTORY = 'thumbs'

def get_image_paths(folder):
    return (os.path.join(folder, f)
            for f in os.listdir(folder)
            if 'jpeg' in f)

def create_thumbnail(filename):
    im = Image.open(filename)
    im.thumbnail(SIZE, Image.ANTIALIAS)
    base, fname = os.path.split(filename)
    save_path = os.path.join(base, SAVE_DIRECTORY, fname)
    im.save(save_path)

if __name__ == '__main__':
    folder = os.path.abspath(
        '11_18_2013_R000_IQM_Big_Sur_Mon__e10d1958e7b766c3e840')
    os.mkdir(os.path.join(folder, SAVE_DIRECTORY))

    images = get_image_paths(folder)

    pool = Pool()
    pool.map(creat_thumbnail, images)
    pool.close()
    pool.join()
哈,看起来有些像 Java 不是吗?
我并不是说使用生产者/消费者模型处理多线程/多进程任务是错误的(事实上,这一模型自有其用武之地)。只是,处理日常脚本任务时我们可以使用更有效率的模型。
问题在于…
首先,你需要一个样板类;
其次,你需要一个队列来传递对象;
而且,你还需要在通道两端都构建相应的方法来协助其工作(如果需想要进行双向通信或是保存结果还需要再引入一个队列)。
worker 越多,问题越多
按照这一思路,你现在需要一个 worker 线程的线程池。下面是一篇 IBM 经典教程中的例子——在进行网页检索时通过多线程进行加速。
#Example2.py
'''
A more realistic thread pool example
'''

import time
import threading
import Queue
import urllib2

class Consumer(threading.Thread):
    def __init__(self, queue):
        threading.Thread.__init__(self)
        self._queue = queue

    def run(self):
        while True:
            content = self._queue.get()
            if isinstance(content, str) and content == 'quit':
                break
            response = urllib2.urlopen(content)
        print 'Bye byes!'

def Producer():
    urls = [
        'http://www.python.org', 'http://www.yahoo.com'
        'http://www.scala.org', 'http://www.google.com'
        # etc..
    ]
    queue = Queue.Queue()
    worker_threads = build_worker_pool(queue, 4)
    start_time = time.time()

    # Add the urls to process
    for url in urls:
        queue.put(url)
    # Add the poison pillv
    for worker in worker_threads:
        queue.put('quit')
    for worker in worker_threads:
        worker.join()

    print 'Done! Time taken: {}'.format(time.time() - start_time)

def build_worker_pool(queue, size):
    workers = []
    for _ in range(size):
        worker = Consumer(queue)
        worker.start()
        workers.append(worker)
    return workers

if __name__ == '__main__':
    Producer()
这段代码能正确的运行,但仔细看看我们需要做些什么:构造不同的方法、追踪一系列的线程,还有为了解决恼人的死锁问题,我们需要进行一系列的 join 操作。这还只是开始……
至此我们回顾了经典的多线程教程,多少有些空洞不是吗?样板化而且易出错,这样事倍功半的风格显然不那么适合日常使用,好在我们还有更好的方法。
何不试试 map
map 这一小巧精致的函数是简捷实现 Python 程序并行化的关键。map 源于 Lisp 这类函数式编程语言。它可以通过一个序列实现两个函数之间的映射。
    urls = ['http://www.yahoo.com', 'http://www.reddit.com']
    results = map(urllib2.urlopen, urls)
上面的这两行代码将 urls 这一序列中的每个元素作为参数传递到 urlopen 方法中,并将所有结果保存到 results 这一列表中。其结果大致相当于:
results = []
for url in urls:
    results.append(urllib2.urlopen(url))
map 函数一手包办了序列操作、参数传递和结果保存等一系列的操作。
为什么这很重要呢?这是因为借助正确的库,map 可以轻松实现并行化操作。
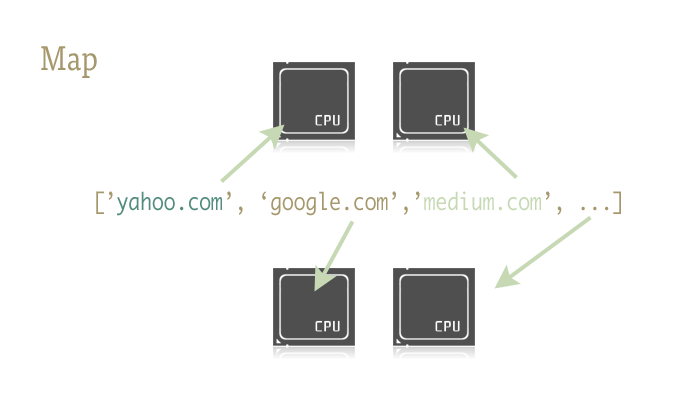
在 Python 中有个两个库包含了 map 函数:multiprocessing 和它鲜为人知的子库 multiprocessing.dummy.
这里多扯两句:multiprocessing.dummy?mltiprocessing 库的线程版克隆?这是虾米?即便在 multiprocessing 库的官方文档里关于这一子库也只有一句相关描述。而这句描述译成人话基本就是说:"嘛,有这么个东西,你知道就成."相信我,这个库被严重低估了!
dummy 是 multiprocessing 模块的完整克隆,唯一的不同在于 multiprocessing 作用于进程,而 dummy 模块作用于线程(因此也包括了 Python 所有常见的多线程限制)。
所以替换使用这两个库异常容易。你可以针对 IO 密集型任务和 CPU 密集型任务来选择不同的库。
动手尝试
使用下面的两行代码来引用包含并行化 map 函数的库:
from multiprocessing import Pool
from multiprocessing.dummy import Pool as ThreadPool
实例化 Pool 对象:
pool = ThreadPool()
这条简单的语句替代了 example2.py 中 buildworkerpool 函数 7 行代码的工作。它生成了一系列的 worker 线程并完成初始化工作、将它们储存在变量中以方便访问。
Pool 对象有一些参数,这里我所需要关注的只是它的第一个参数:processes. 这一参数用于设定线程池中的线程数。其默认值为当前机器 CPU 的核数。
一般来说,执行 CPU 密集型任务时,调用越多的核速度就越快。但是当处理网络密集型任务时,事情有有些难以预计了,通过实验来确定线程池的大小才是明智的。
pool = ThreadPool(4) # Sets the pool size to 4
线程数过多时,切换线程所消耗的时间甚至会超过实际工作时间。对于不同的工作,通过尝试来找到线程池大小的最优值是个不错的主意。
创建好 Pool 对象后,并行化的程序便呼之欲出了。我们来看看改写后的 example2.py
import urllib2
from multiprocessing.dummy import Pool as ThreadPool

urls = [
    'http://www.python.org',
    'http://www.python.org/about/',
    'http://www.onlamp.com/pub/a/python/2003/04/17/metaclasses.html',
    'http://www.python.org/doc/',
    'http://www.python.org/download/',
    'http://www.python.org/getit/',
    'http://www.python.org/community/',
    'https://wiki.python.org/moin/',
    'http://planet.python.org/',
    'https://wiki.python.org/moin/LocalUserGroups',
    'http://www.python.org/psf/',
    'http://docs.python.org/devguide/',
    'http://www.python.org/community/awards/'
    # etc..
    ]

# Make the Pool of workers
pool = ThreadPool(4)
# Open the urls in their own threads
# and return the results
results = pool.map(urllib2.urlopen, urls)
#close the pool and wait for the work to finish
pool.close()
pool.join()
实际起作用的代码只有 4 行,其中只有一行是关键的。map 函数轻而易举的取代了前文中超过 40 行的例子。为了更有趣一些,我统计了不同方法、不同线程池大小的耗时情况。
# results = []
# for url in urls:
#   result = urllib2.urlopen(url)
#   results.append(result)

# # ------- VERSUS ------- #

# # ------- 4 Pool ------- #
# pool = ThreadPool(4)
# results = pool.map(urllib2.urlopen, urls)

# # ------- 8 Pool ------- #

# pool = ThreadPool(8)
# results = pool.map(urllib2.urlopen, urls)

# # ------- 13 Pool ------- #

# pool = ThreadPool(13)
# results = pool.map(urllib2.urlopen, urls)
结果:
#        Single thread:  14.4 Seconds
#               4 Pool:   3.1 Seconds
#               8 Pool:   1.4 Seconds
#              13 Pool:   1.3 Seconds
很棒的结果不是吗?这一结果也说明了为什么要通过实验来确定线程池的大小。在我的机器上当线程池大小大于 9 带来的收益就十分有限了。
另一个真实的例子
生成上千张图片的缩略图
这是一个 CPU 密集型的任务,并且十分适合进行并行化。
基础单进程版本
import os
import PIL

from multiprocessing import Pool
from PIL import Image

SIZE = (75,75)
SAVE_DIRECTORY = 'thumbs'

def get_image_paths(folder):
    return (os.path.join(folder, f)
            for f in os.listdir(folder)
            if 'jpeg' in f)

def create_thumbnail(filename):
    im = Image.open(filename)
    im.thumbnail(SIZE, Image.ANTIALIAS)
    base, fname = os.path.split(filename)
    save_path = os.path.join(base, SAVE_DIRECTORY, fname)
    im.save(save_path)

if __name__ == '__main__':
    folder = os.path.abspath(
        '11_18_2013_R000_IQM_Big_Sur_Mon__e10d1958e7b766c3e840')
    os.mkdir(os.path.join(folder, SAVE_DIRECTORY))

    images = get_image_paths(folder)

    for image in images:
        create_thumbnail(Image)
上边这段代码的主要工作就是将遍历传入的文件夹中的图片文件,一一生成缩略图,并将这些缩略图保存到特定文件夹中。
这我的机器上,用这一程序处理 6000 张图片需要花费 27.9 秒。
如果我们使用 map 函数来代替 for 循环:
import os
import PIL

from multiprocessing import Pool
from PIL import Image

SIZE = (75,75)
SAVE_DIRECTORY = 'thumbs'

def get_image_paths(folder):
    return (os.path.join(folder, f)
            for f in os.listdir(folder)
            if 'jpeg' in f)

def create_thumbnail(filename):
    im = Image.open(filename)
    im.thumbnail(SIZE, Image.ANTIALIAS)
    base, fname = os.path.split(filename)
    save_path = os.path.join(base, SAVE_DIRECTORY, fname)
    im.save(save_path)

if __name__ == '__main__':
    folder = os.path.abspath(
        '11_18_2013_R000_IQM_Big_Sur_Mon__e10d1958e7b766c3e840')
    os.mkdir(os.path.join(folder, SAVE_DIRECTORY))

    images = get_image_paths(folder)

    pool = Pool()
    pool.map(creat_thumbnail, images)
    pool.close()
    pool.join()
5.6 秒!
虽然只改动了几行代码,我们却明显提高了程序的执行速度。在生产环境中,我们可以为 CPU 密集型任务和 IO 密集型任务分别选择多进程和多线程库来进一步提高执行速度——这也是解决死锁问题的良方。此外,由于 map 函数并不支持手动线程管理,反而使得相关的 debug 工作也变得异常简单。
到这里,我们就实现了(基本)通过一行 Python 实现并行化。
译者:caspar
译文:https://segmentfault.com/a/1190000000414339
原文:https://medium.com/building-things-on-the-internet/40e9b2b36148

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



