

Python Redis数据处理的方法
Redis Assistant 是一款为Redis设计的高效可视化管理与监控工具,提供多种操作模式,高效处理服务器数据。日常使用里的持续防护和信息管理会更突出,适合把安全控制放进长期使用流程中的场景。
1.前言Redis:RemoteDictionaryServer,即:远程字典服务,Redis底层使用C语言编写,是一款开源的、基于内存的NoSql数据库由于Redis性能远超其他数据库,并且支持集群、分布式及主从同步等优势,所以经常用于缓存数据、高速读写等场景2.准备我们以在云服务器Centos7.8安装Redis-Server为例首先,安装在云服务器上Redis数据库#下载epel仓库yuminstallepel-release#安装redisyuminstallredis然后,通过vim命令修改Re
1. 前言
Redis:Remote Dictionary Server,即:远程字典服务,Redis 底层使用 C 语言编写,是一款开源的、基于内存的 NoSql 数据库
由于 Redis 性能远超其他数据库,并且支持集群、分布式及主从同步等优势,所以经常用于 缓存数据、高速读写 等场景
2. 准备
我们以在云服务器 Centos 7.8 安装 Redis-Server 为例
首先,安装在云服务器上 Redis 数据库
# 下载epel仓库
yum install epel-release

# 安装redis
yum install redis
然后,通过 vim 命令修改 Redis 配置文件,打开远程连接,设置连接密码
配置文件目录:/etc/redis.conf
bind 更改为 0.0.0.0,容许外网访问
requirepass 设置一个访问密码
# vim /etc/redis.conf
# 1、bing从127.0.0.1修改为:0.0.0.0,开放远程连接
bind 0.0.0.0

# 2、设置密码
requirepass 123456
需要指出的是,为了保证云服务器数据安全,Redis 开放远程访问的时候,一定要加强密码
接着,启动 Redis 服务,开启防火墙和端口,配置云服务器安全组
默认情况下,Redis 服务使用的端口号是 6379
另外,需要在云服务器安全组进行配置,保证 Redis 数据库能正常连接
# 启动Redis服务,默认redis端口号是6379
systemctl start redis

# 打开防火墙
systemctl start firewalld.service

# 开放6379端口
firewall-cmd --zone=public --add-port=6379/tcp --permanent

# 配置立即生效
firewall-cmd --reload
完成以上操作,我们就可以通过 Redis-CLI 或 Redis 客户端工具进行连接了
最后,要使用 Python 操作 Redis,我们需要使用 pip 安装一个依赖
# 安装依赖,便于操作redis
pip3 install redis
3. 实战
在操作 Redis 中的数据之前,我们需要利用 Host、端口号、密码实例化一个 Redis 连接对象
from redis import Redis

class RedisF(object):

    def __init__(self):
        # 实例化Redis对象
        # decode_responses=True,如果不加则写入的为字节类型
        # host:远程连接地址
        # port:Redis端口号
        # password:Redis授权密码
        self.redis_obj = Redis(host='139.199.**.**',port=6379,password='123456',decode_responses=True,charset='UTF-8', encoding='UTF-8')
接下来我们以操作字符串、列表、set 集合、zset 集合、哈希表、事务为例,讲讲 Python 操作这些数据的方法
1、字符串操作
操作字符串有两种方式,操作方法分别是:set() 和 mset()
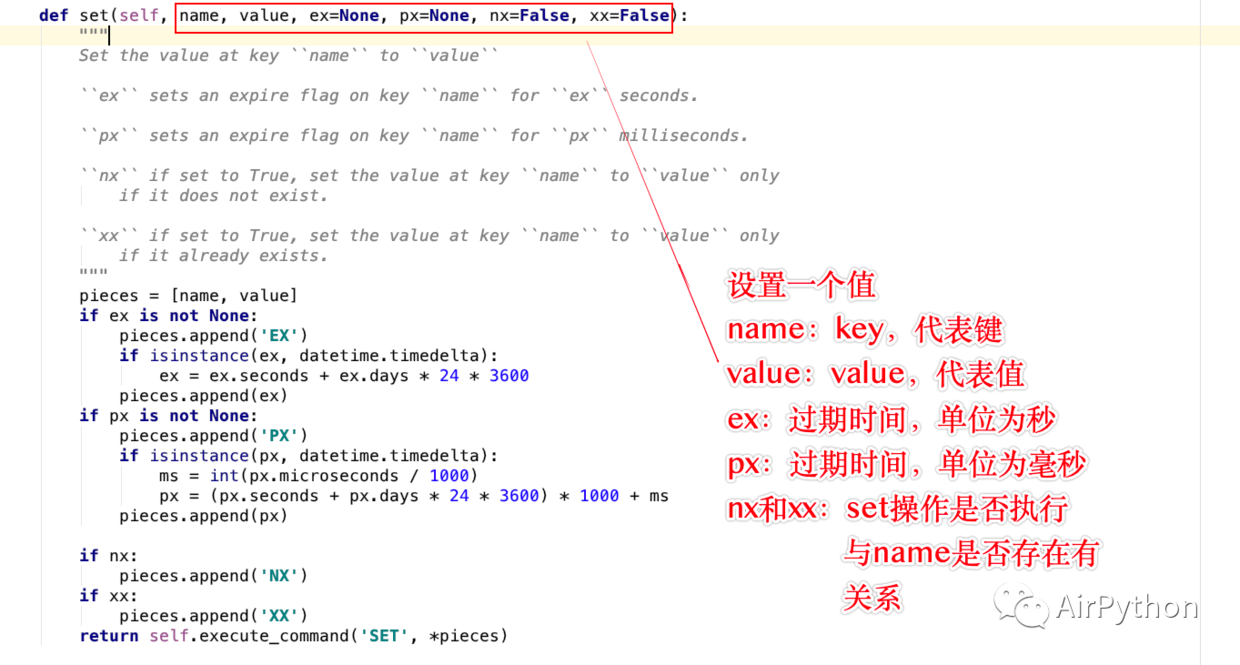
其中:set() 一次只能保存一个值,参数意义如下
name:key,代表键
value:value,待保存的值
ex:过期时间,以秒为单位,如果不设置,则永久不过期;否则,过期则删除
px:过期时间,以毫秒为单位
nx/xx:set 操作是否执行与 name 键是否存在有关
获取值和删除值的操作方法分别为:get(Key)、 delete(Key or Keys)
# set():单字符串操作
# 添加一个值,并设置超时时间为120s
 self.redis_obj.set('name', 'airpython', ex=120)

# get():获取这个值
print(self.redis_obj.get('name'))

# delete():删除一个值或多个值
self.redis_obj.delete('name')
print(self.redis_obj.get('name'))
对于多值数据的设置,只需要调用 mset() 方法,将待插入的数据以键值对组成一个字典作为参数即可
同理,Redis 提供了 mget()方法,可以一次获取多个键的值
# mset():设置多个值
self.redis_obj.mset({"foo": "foo1", "zoo": "zoo1"})

# mget():获取多个值
result = self.redis_obj.mget("foo", "zoo")
print(result)
2、列表操作
Redis 提供了很多方法用于操作列表,其中比较常见的如下:
lpush/rpush:将一个值或多个值插入到列表头部或尾部,其中,lpush 代表头部插入;rpush 代表尾部插入数据
lset:通过索引,将值插入到列表对应的位置
linsert:在列表元素前面或后面插入数据
lindex:通过索引获取列表中的某一个元素,其中,0 代表第一个元素;-1 代表最后一个元素
lrange:通过制定起始位置和结束位置,从列表中获取指定区域的值
llen:获取列表的长度,如果 Key 对应的列表不存在,返回 0
lpop:移除并返回列表中的第一个元素
rpop:移除并返回列表中的最后一个元素
实例代码如下:
def manage_list(self):
    """
    操作列表
    :return:
    """
    # 1、新增一个列表,并左边插入一个数据
    # 注意:可以一次加入多个元素,也可以一个个元素的加入
    self.redis_obj.lpush('company', '阿里', '腾讯', '百度')

    # 2、移除第一个元素
    self.redis_obj.lpop("company")

    # 3、右边插入数据
    self.redis_obj.rpush('company', '字节跳动', '小米')

    # 4、移除最后一个元素
    self.redis_obj.rpop("company")

    # 5、获取列表的长度
    self.redis_obj.llen("company")

    # 6、通过索引,获取列表中的某一个元素(第二个元素)
    print('列表中第二个元素是:', self.redis_obj.lindex("company", 1))

    # 7、根据范围,查看列表中所有的值
    print(self.redis_obj.lrange('company', 0, -1))
3、操作 Set 集合
Set 是一个无序的元素集合,集合中的元素不能重复,Redis 同样提供了很多方法,便于操作 Set 集合
其中,比较常用的方法如下:
sadd:添加元素到集合中,已经存在集合中的元素将被忽略,如果集合不存在,则新建一个集合
scard:返回集合元素的数量
smembers:返回集合中所有元素
srem:移除集合中一个或多个元素,如果元素不存在则忽略
sinter:返回两个集合的交集,结果依然是一个集合
sunion:返回两个集合的并集
sdiff:以第一个集合参数为标准,返回两个集合的差集
sunionstore:计算两个集合的并集,保存到一个新的集合中
sismember:判断集合中是否存在某个元素
spop:随机删除集合中的一个元素,并返回
具体实例代码如下:
def manage_set(self):
    """
    操作set集合
    :return:
    """
    self.redis_obj.delete("fruit")

    # 1、sadd:新增元素到集合中
    # 添加一个元素:香蕉
    self.redis_obj.sadd('fruit', '香蕉')

    # 再添加两个元素
    self.redis_obj.sadd('fruit', '苹果', '桔子')

    # 2、集合元素的数量
    print('集合元素数量:', self.redis_obj.scard('fruit'))

    # 3、移除一个元素
    self.redis_obj.srem("fruit", "桔子")

    # 再定义一个集合
    self.redis_obj.sadd("fruit_other", "香蕉", "葡萄", "柚子")

    # 4、获取两个集合的交集
    result = self.redis_obj.sinter("fruit", "fruit_other")
    print(type(result))
    print('交集为:', result)

    # 5、获取两个集合的并集
    result = self.redis_obj.sunion("fruit", "fruit_other")
    print(type(result))
    print('并集为:', result)

    # 6、差集,以第一个集合为标准
    result = self.redis_obj.sdiff("fruit", "fruit_other")
    print(type(result))
    print('差集为:', result)

    # 7、合并保存到新的集合中
    self.redis_obj.sunionstore("fruit_new", "fruit", "fruit_other")
    print('新的集合为:', self.redis_obj.smembers('fruit_new'))

    # 8、判断元素是否存在集合中
    result = self.redis_obj.sismember("fruit", "苹果")
    print('苹果是否存在于集合中', result)

    # 9、随机从集合中删除一个元素,然后返回
    result = self.redis_obj.spop("fruit")
    print('删除的元素是:', result)

    # 3、集合中所有元素
    result = self.redis_obj.smembers('fruit')

    print("最后fruit集合包含的元素是:", result)
4、操作 zset 集合
zset 集合相比普通 set 集合,是有序的,zset 集合中的元素包含:值和分数,其中分数用于排序
其中,比较常用的方法如下:
zadd:往集合中新增元素,如果集合不存在,则新建一个集合,然后再插入数据
zrange:通过起始点和结束点,返回集合中的元素值(不包含分数);如果设置withscores=True,则返回结果会带上分数
zscore:获取某一个元素对应的分数
zcard:获取集合中元素个数
zrank:获取元素在集合中的索引
zrem:删除集合中的元素
zcount:通过最小值和最大值,判断分数在这个范围内的元素个数
实践代码如下:
def manage_zset(self):
    """
    操作zset集合
    :return:
    """
    self.redis_obj.delete("fruit")

    # 往集合中新增元素:zadd()
    # 三个元素分别是:"banana", 1/"apple", 2/"pear", 3
    self.redis_obj.zadd("fruit", "banana", 1, "apple", 2, "pear", 3)

    # 查看集合中所有元素(不带分数)
    result = self.redis_obj.zrange("fruit", 0, -1)
    # ['banana', 'apple', 'pear']
    print('集合中的元素(不带分数)有:', result)

    # 查看集合中所有元素(带分数)
    result = self.redis_obj.zrange("fruit", 0, -1, withscores=True)
    # [('banana', 1.0), ('apple', 2.0), ('pear', 3.0)]
    print('集合中的元素(带分数)有:', result)

    # 获取集合中某一个元素的分数
    result = self.redis_obj.zscore("fruit", "apple")
    print("apple对应的分数为:", result)

    # 通过最小值和最大值,判断分数在这个范围内的元素个数
    result = self.redis_obj.zcount("fruit", 1, 2)
    print("集合中分数大于1,小于2的元素个数有:", result)

    # 获取集合中元素个数
    count = self.redis_obj.zcard("fruit")
    print('集合元素格式:', count)

    # 获取元素的值获取索引号
    index = self.redis_obj.zrank("fruit", "apple")
    print('apple元素的索引为:', index)

    # 删除集合中的元素:zrem
    self.redis_obj.zrem("fruit", "apple")
    print('删除apple元素后,剩余元素为:', self.redis_obj.zrange("fruit", 0, -1))
4、操作哈希
哈希表中包含很多键值对,并且每一个键都是唯一的
Redis 操作哈希表,下面这些方法比较常用:
hset:往哈希表中添加一个键值对值
hmset:往哈希表中添加多个键值对值
hget:获取哈希表中单个键的值
hmget:获取哈希表中多个键的值列表
hgetall:获取哈希表中种所有的键值对
hkeys:获取哈希表中所有的键列表
hvals:获取哈表表中所有的值列表
hexists:判断哈希表中,某个键是否存在
hdel:删除哈希表中某一个键值对
hlen:返回哈希表中键值对个数
对应的操作代码如下:
def manage_hash(self):
    """
    操作哈希表
    哈希:一个键对应一个值,并且键不容许重复
    :return:
    """
    self.redis_obj.delete("website")

    # 1、新建一个key为website的哈希表
    # 往里面加入数据:baidu(field),www.baidu.com(value)
    self.redis_obj.hset('website', 'baidu', 'www.alibababaidu.com')
    self.redis_obj.hset('website', 'google', 'www.google.com')

    # 2、往哈希表中添加多个键值对
    self.redis_obj.hmset("website", {"tencent": "www.qq.com", "alibaba": "www.taobao.com"})

    # 3、获取某一个键的值
    result = self.redis_obj.hget("website", 'baidu')
    print("键为baidu的值为:", result)

    # 4、获取多个键的值
    result = self.redis_obj.hmget("website", "baidu", "alibaba")
    print("多个键的值为:", result)

    # 5、查看hash表中的所有值
    result = self.redis_obj.hgetall('website')
    print("哈希表中所有的键值对为:", result)

    # 6、哈希表中所有键列表
    # ['baidu', 'google', 'tencent', 'alibaba']
    result = self.redis_obj.hkeys("website")
    print("哈希表,所有的键(列表)为:", result)

    # 7、哈希表中所有的值列表
    # ['www.alibababaidu.com', 'www.google.com', 'www.qq.com', 'www.taobao.com']
    result = self.redis_obj.hvals("website")
    print("哈希表,所有的值(列表)为:", result)

    # 8、判断某一个键是否存在
    result = self.redis_obj.hexists("website", "alibaba")
    print('alibaba这个键是否存在:', result)

    # 9、删除某一个键值对
    self.redis_obj.hdel("website", 'baidu')
    print('删除baidu键值对后,哈希表的数据包含:', self.redis_obj.hgetall('website'))

    # 10、哈希表中键值对个数
    count = self.redis_obj.hlen("website")
    print('哈希表键值对一共有:', count)
5、操作事务管道
Redis 支持事务管道操作,能够将几个操作统一提交执行
操作步骤是:
首先,定义一个事务管道
然后通过事务对象去执行一系列操作
提交事务操作,结束事务操作
下面通过一个简单的例子来说明:
def manage_steps(self):
    """
    执行事务操作
    :return:
    """
    # 1、定义一个事务管道
    self.pip = self.redis_obj.pipeline()

    # 定义一系列操作
    self.pip.set('age', 18)

    # 增加一岁
    self.pip.incr('age')

    # 减少一岁
    self.pip.decr('age')

    # 执行上面定义3个步骤的事务操作
    self.pip.execute()

    # 判断
print('通过上面一些列操作,年龄变成:', self.redis_obj.get('age')) 
学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



