当前位置:

首页 > 业界资讯 > 人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

在4月27日召开的中关村论坛通用人工智能平行论坛上,人大系初创公司智子引擎隆重发布全新的多模态大模型Awaker1.0,向AGI迈出至关重要的一步。相对于智子引擎前代的ChatImg序列模型,Awaker1.0采用全新的MOE架构并具备自主更新能力,是业界首个实现“真正”自主更新的多模态大模型。在视觉生成方面,Awaker1.0采用完全自研的视频生成底座VDT,在写真视频生成上取得好于Sora的效果,打破大模型“最后一公里”落地难的困境。Awaker1.0是
本文目录
    在 4 月 27 日召开的中关村论坛通用人工智能平行论坛上,人大系初创公司智子引擎隆重发布全新的多模态大模型 Awaker 1.0,向 AGI 迈出至关重要的一步。

    相对于智子引擎前代的 ChatImg 序列模型,Awaker 1.0 采用全新的 MOE 架构并具备自主更新能力,是业界首个实现 “真正” 自主更新的多模态大模型。

    在视觉生成方面,Awaker 1.0 采用完全自研的视频生成底座 VDT,在写真视频生成上取得好于 Sora 的效果,打破大模型 “最后一公里” 落地难的困境。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

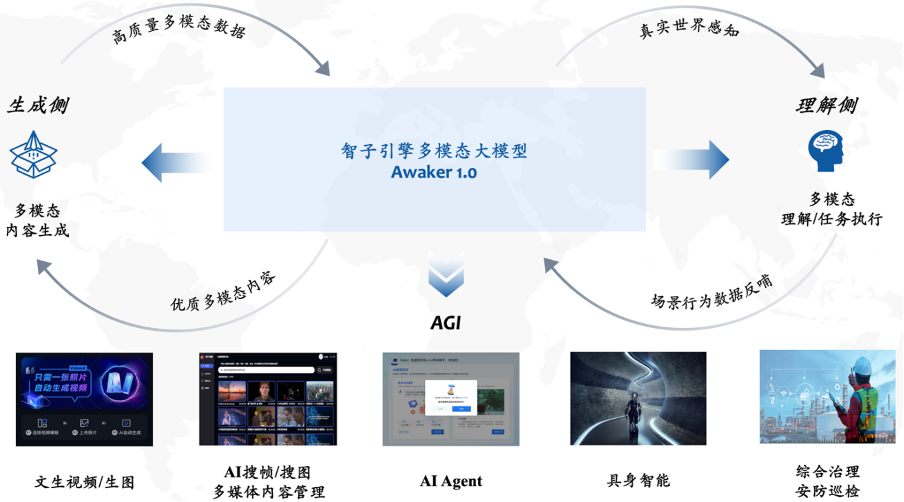
    Awaker 1.0 是一个将视觉理解与视觉生成进行超级融合的多模态大模型。在理解侧,Awaker 1.0 与数字世界和现实世界进行交互,在执行任务的过程中将场景行为数据反哺给模型,以实现持续更新与训练;在生成侧,Awaker 1.0 可以生成高质量的多模态内容,对现实世界进行模拟,为理解侧模型提供更多的训练数据。

    尤其重要的是,因为具备 “真正” 的自主更新能力,Awaker 1.0 适用于更广泛的行业场景,能够解决更复杂的实际任务,比如 AI Agent、具身智能、综合治理、安防巡检等。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

    Awaker 的 MOE 基座模型

    在理解侧,Awaker 1.0 的基座模型主要解决了多模态多任务预训练存在严重冲突的问题。受益于精心设计的多任务 MOE 架构,Awaker 1.0 的基座模型既能继承智子引擎前代多模态大模型 ChatImg 的基础能力,还能学习各个多模态任务所需的独特能力。相对于前代多模态大模型 ChatImg,Awaker 1.0 的基座模型能力在多个任务上都有了大幅提升。

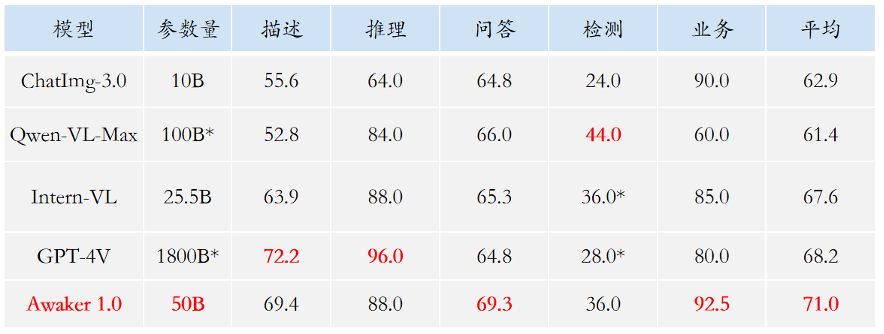
    鉴于主流的多模态评测榜单存在评测数据泄露的问题,我们采取严格的标准构建自有的评测集,其中大部分的测试图片来自个人的手机相册。在该多模态评测集上,我们对 Awaker 1.0 和国内外最先进的三个多模态大模型进行公平的人工评测,详细的评测结果如下表所示。注意到 GPT-4V 和 Intern-VL 并不直接支持检测任务,它们的检测结果是通过要求模型使用语言描述物体方位得到的。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

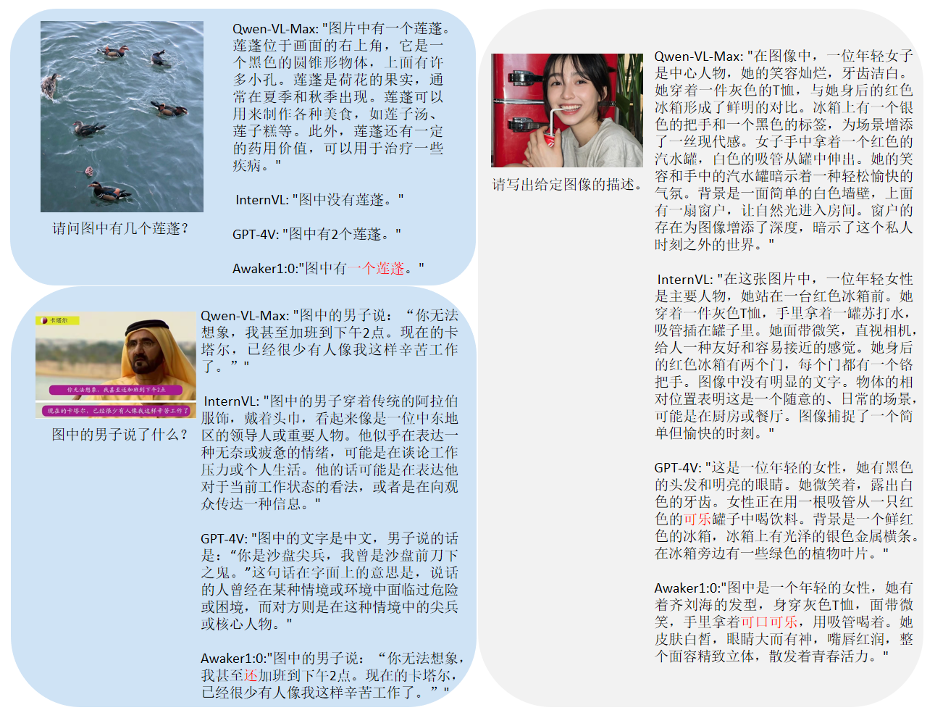
    我们发现,Awaker 1.0 的基座模型在视觉问答和业务应用任务上超过了 GPT-4V、Qwen-VL-Max 和 Intern-VL,同时它在描述、推理和检测任务上也达到了次好的效果。总体而言,Awaker 1.0 的平均得分超过国内外最先进的三个模型,验证了多任务 MOE 架构的有效性。下面是几个具体的对比分析例子。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

    从这些对比例子可以看到,在计数和 OCR 问题上,Awaker 1.0 能正确地给出答案,而其它三个模型均回答错误(或部分错误)。在详细描述任务上,Qwen-VL-Max 比较容易出现幻觉,Intern-VL 能够准确地描述图片的内容但在某些细节上不够准确和具体。GPT-4V 和 Awaker 1.0 不但能够详细地描述图片的内容,而且能够准确地识别出图片中的细节,如图中展示的可口可乐。

    Awaker + 具身智能:迈向 AGI

    多模态大模型与具身智能的结合是非常自然的,因为多模态大模型所具有的视觉理解能力可以天然与具身智能的摄像头进行结合。在人工智能领域,“多模态大模型 + 具身智能” 甚至被认为是实现通用人工智能(AGI)的可行路径。

    一方面,人们期望具身智能拥有适应性,即智能体能够通过持续学习来适应不断变化的应用环境,既能在已知多模态任务上越做越好,也能快速适应未知的多模态任务。

    另一方面,人们还期望具身智能具有真正的创造性,希望它通过对环境的自主探索,能够发现新的策略和解决方案,并探索人工智能的能力边界。通过将多模态大模型用作具身智能的 “大脑”,我们有可能大幅地提升具身智能的适应性和创造性,从而最终接近 AGI 的门槛(甚至实现 AGI)。

    但是,现有的多模态大模型都存在两个明显的问题:一是模型的迭代更新周期长,需要大量的人力和财力投入;二是模型的训练数据都源自现有的数据,模型不能持续获得大量的新知识。虽然通过 RAG 和长上下文的方式也可以注入持续出现的新知识,但是多模态大模型本身并没有学习到这些新知识,同时这两种补救方式还会带来额外的问题。

    总之,目前的多模态大模型在实际应用场景中均不具备很强的适应性,更不具备创造性,导致在行业落地时总是出现各种各样的困难。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

    智子引擎此次发布的 Awaker 1.0,是世界上首个具有自主更新机制的多模态大模型,可以用作具身智能的 “大脑”。Awaker 1.0 的自主更新机制,包含三大关键技术:数据主动生成、模型反思评估、模型连续更新。

    区别于所有其它多模态大模型,Awaker 1.0 是 “活” 的,它的参数可以实时持续地更新。

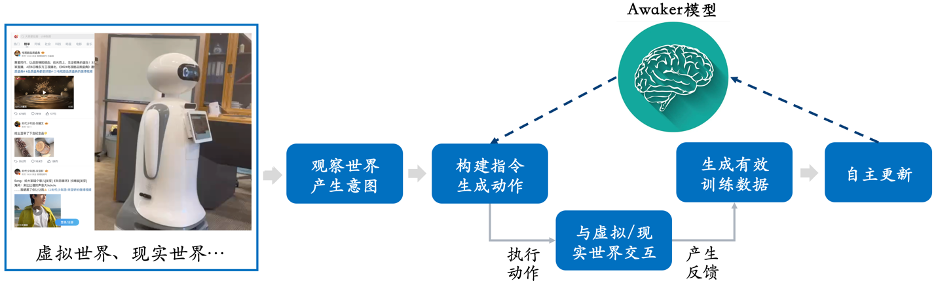
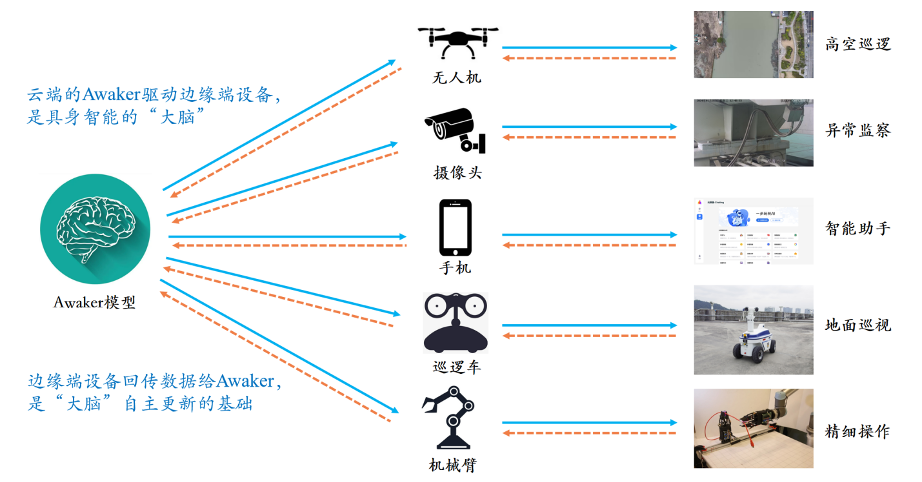
    从上方的框架图中可以看出,Awaker 1.0 能够与各种智能设备结合,通过智能设备观察世界,产生动作意图,并自动构建指令控制智能设备完成各种动作。智能设备在完成各种动作后会自动产生各种反馈,Awaker 1.0 能够从这些动作和反馈中获取有效的训练数据进行持续的自我更新,不断强化模型的各种能力。

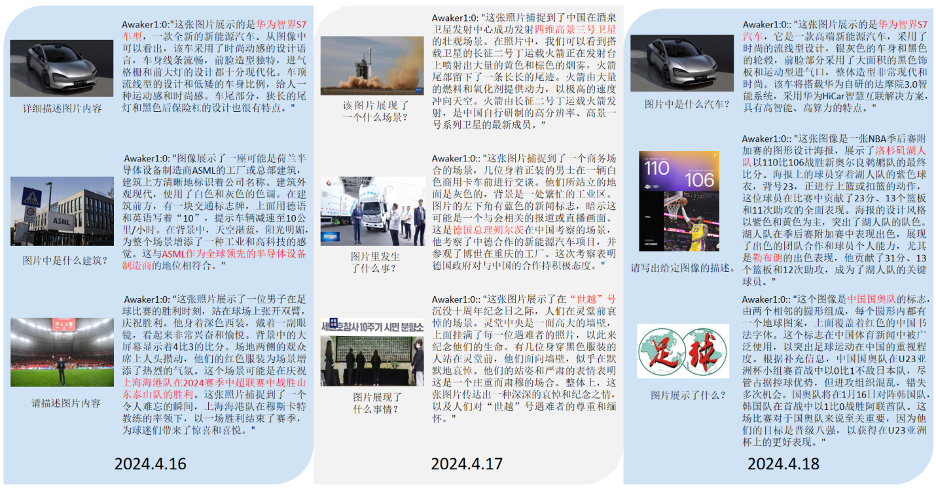
    以新知识注入为例,Awaker 1.0 能够不断地在互联网上学习最新的新闻信息,并结合新学习到的新闻信息回答各种复杂问题。不同于 RAG 和长上下文的传统方式,Awaker 1.0 能真正学到新知识并 “记忆” 在模型的参数上。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

    从上述例子可以看到,在连续三天的自我更新中,Awaker 1.0 每天都能学习当天的新闻信息,并在回答问题时准确地说出对应信息。同时,Awaker 1.0 在连续学习的过程中并不会遗忘学过的知识,例如智界 S7 的知识在 2 天后仍然被 Awaker 1.0 记住或理解。

    Awaker 1.0 还能够与各种智能设备结合,实现云边协同。Awaker 1.0 作为 “大脑” 部署在云端,控制各种边端智能设备执行各项任务。边端智能设备执行各项任务时获得的反馈又会源源不断地传回给 Awaker 1.0,让它持续地获得训练数据,不断进行自我更新。人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora
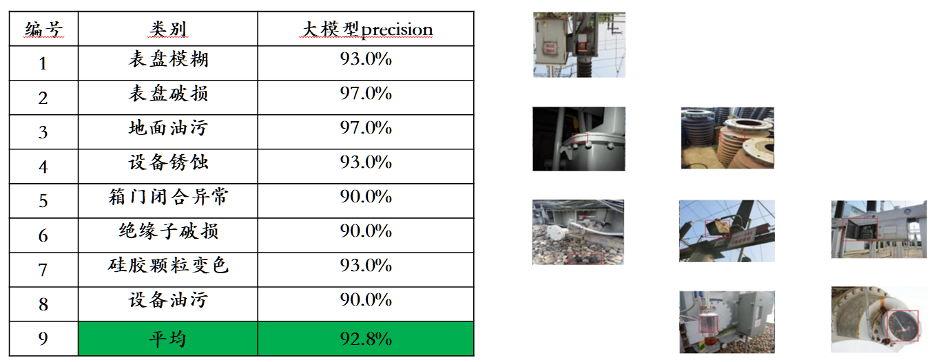
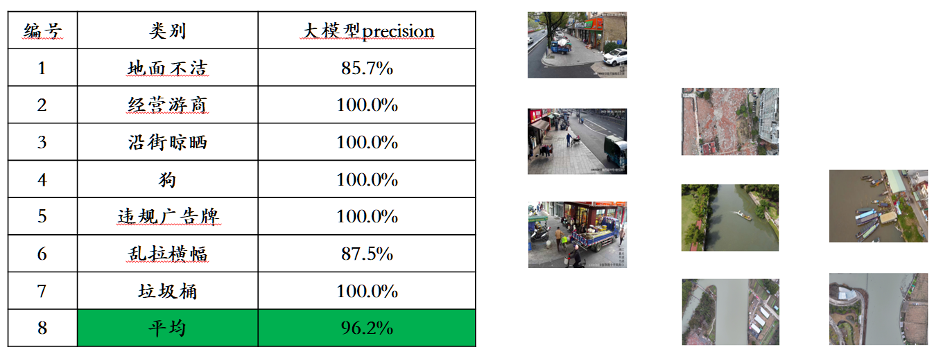
    上述云边协同的技术路线已经应用在电网智能巡检、智慧城市等应用场景中,取得了远远好于传统小模型的识别效果,并获得了行业客户的高度认可。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

    现实世界的模拟器:VDT

    Awaker 1.0 的生成侧,是智子引擎自主研发的类 Sora 视频生成底座 VDT,可以用作现实世界的模拟器。VDT 的研究成果于 2023 年 5 月发布在 arXiv 网站,比 OpenAI 发布 Sora 提前 10 个月。VDT 的学术论文已经被国际顶级人工智能会议 ICLR 2024 接收。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

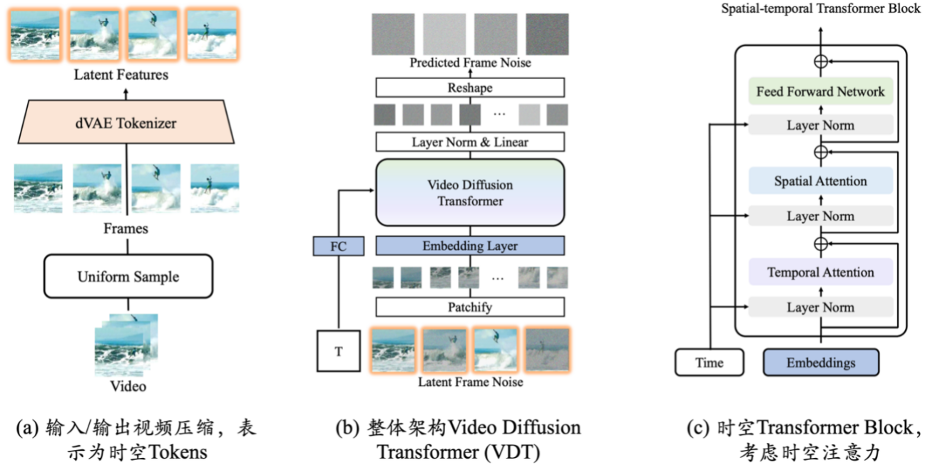
    视频生成底座 VDT 的创新之处,主要包括以下几个方面:

    • 将 Transformer 技术应用于基于扩散的视频生成,展现了 Transformer 在视频生成领域的巨大潜力。VDT 的优势在于其出色的时间依赖性捕获能力,能够生成时间上连贯的视频帧,包括模拟三维对象随时间的物理动态。
    • 提出统一的时空掩码建模机制,使 VDT 能够处理多种视频生成任务,实现了该技术的广泛应用。VDT 灵活的条件信息处理方式,如简单的 token 空间拼接,有效地统一了不同长度和模态的信息。同时,通过与时空掩码建模机制结合,VDT 成为了一个通用的视频扩散工具,在不修改模型结构的情况下可以应用于无条件生成、视频后续帧预测、插帧、图生视频、视频画面补全等多种视频生成任务。
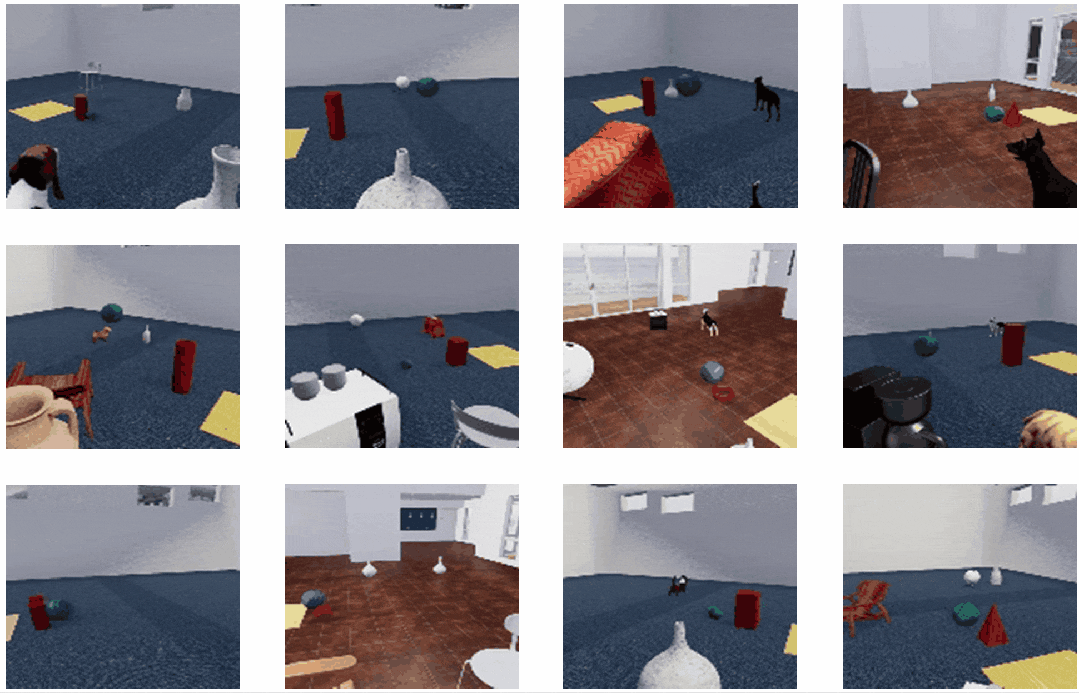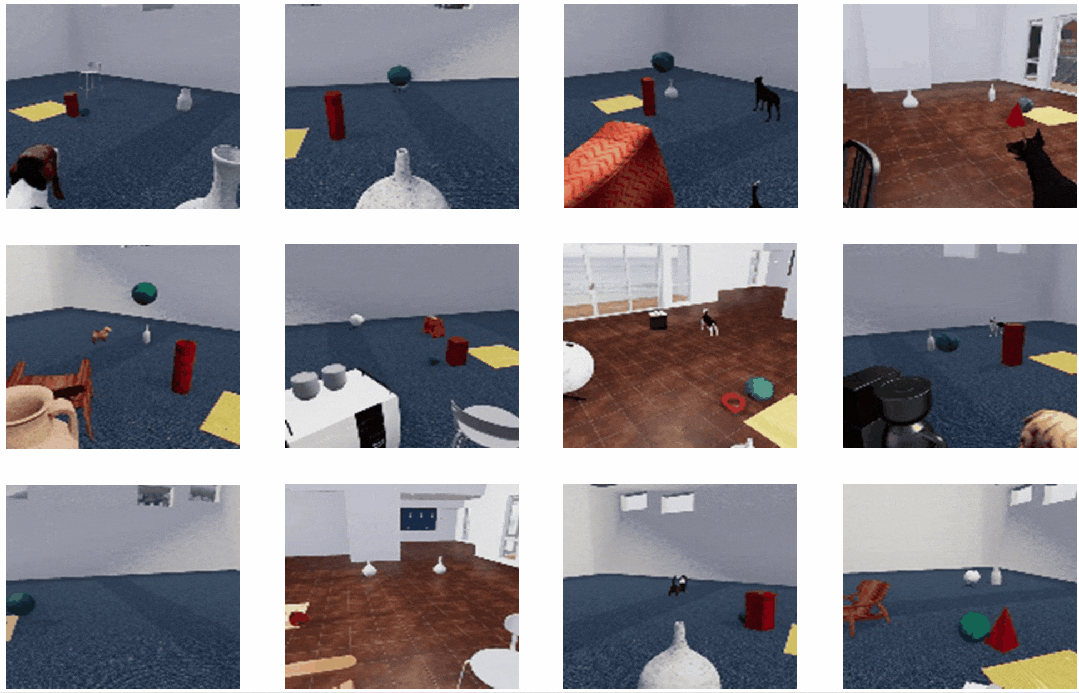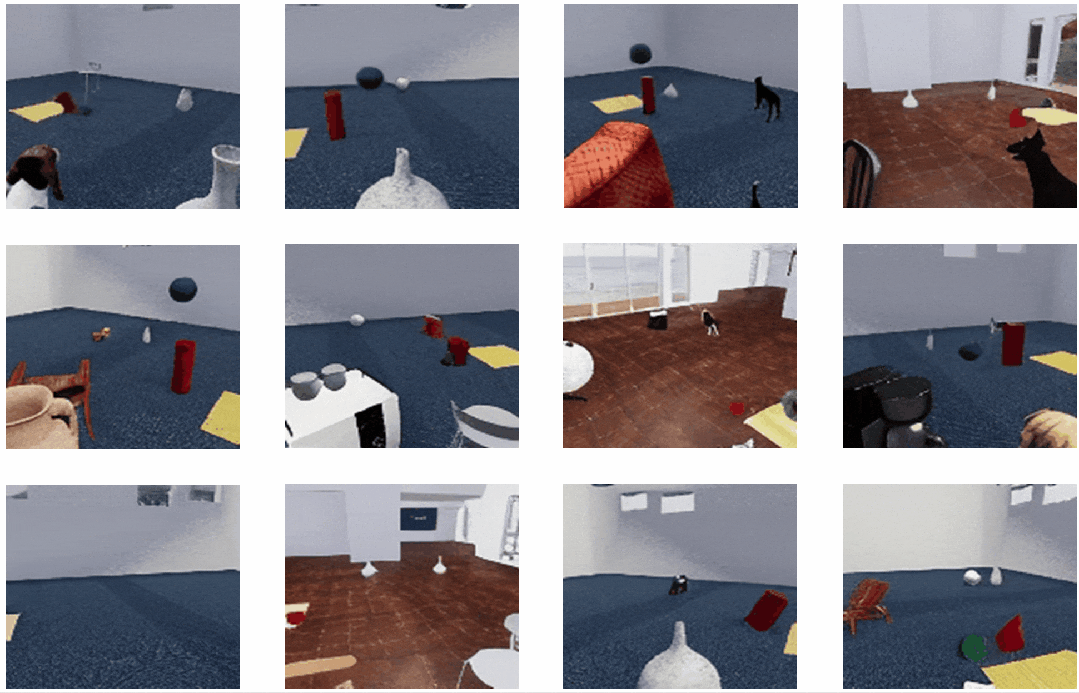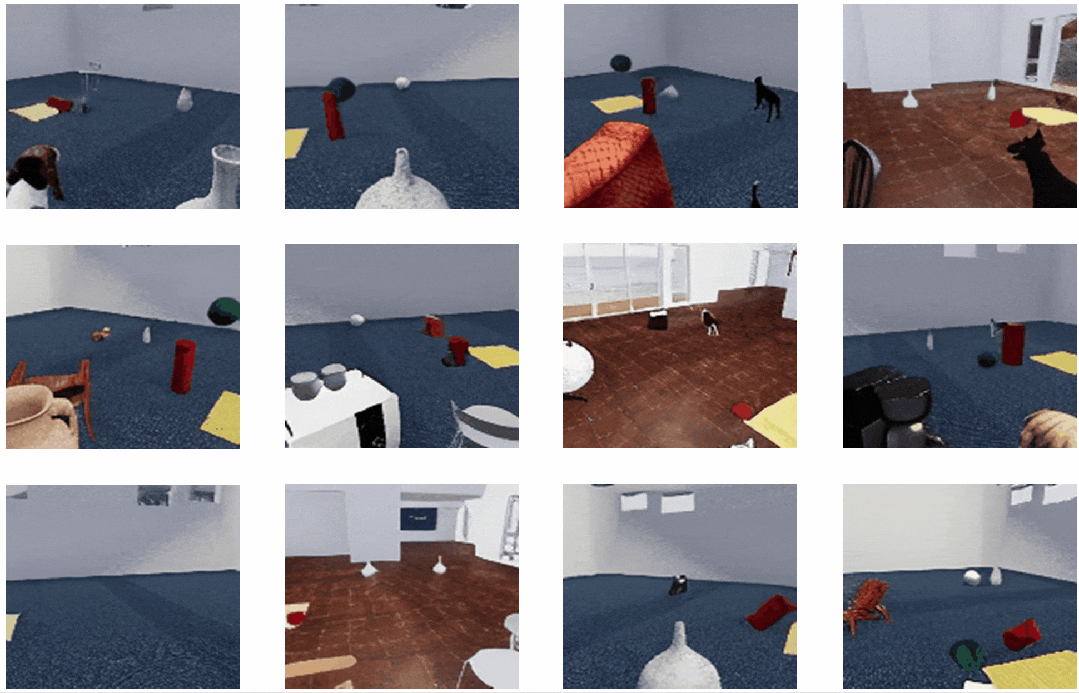
    我们重点探索了 VDT 对简单物理规律的模拟,在 Physion 数据集上对 VDT 进行训练。在下面的示例中,我们发现 VDT 成功模拟了物理过程,如小球沿抛物线轨迹运动和小球在平面上滚动并与其他物体碰撞等。同时也能从第 2 行第 2 个例子中看出 VDT 捕捉到了球的速度和动量规律,因为小球最终由于冲击力不够而没有撞倒柱子。这证明了 Transformer 架构可以学习到一定的物理规律。

    人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora

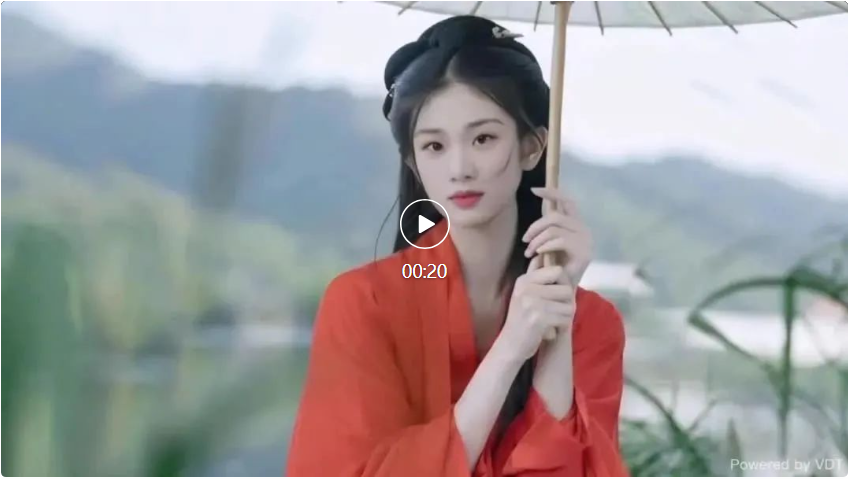
    我们还在写真视频生成任务上进行了深度探索。该任务对视频生成质量的要求非常高,因为我们天然对人脸以及人物的动态变化更加敏感。鉴于该任务的特殊性,我们需要结合 VDT(或 Sora)和可控生成来应对写真视频生成面临的挑战。目前智子引擎已经突破写真视频生成的大部分关键技术,取得比 Sora 更好的写真视频生成质量。智子引擎还将继续优化人像可控生成算法,同时也在积极进行商业化探索。目前已经找到确定的商业落地场景,有望近期就打破大模型 “最后一公里” 落地难的困境。人大系多模态模型迈向AGI:首次实现自主更新,写真视频生成力压Sora
    未来更加通用的 VDT 将成为解决多模态大模型数据来源问题的得力工具。使用视频生成的方式,VDT 将能够对现实世界进行模拟,进一步提高视觉数据生产的效率,为多模态大模型 Awaker 的自主更新提供助力。

    结语

    Awaker 1.0 是智子引擎团队向着 “实现 AGI” 的终极目标迈进的关键一步。团队认为 AI 的自我探索、自我反思等自主学习能力是智能水平的重要评估标准,与持续加大参数规模(Scaling Law)相比是同等重要的。Awaker 1.0 已实现 “数据主动生成、模型反思评估、模型连续更新” 等关键技术框架,在理解侧和生成侧都实现了效果突破,有望加速多模态大模型行业的发展,最终让人类实现 AGI。
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯
    相关文章 更多
    一年损耗4.6亿吨、1.88万亿打水漂!县域经济,别再“卖特产”了
    一年损耗4.6亿吨、1.88万亿打水漂!县域经济,别再“卖特产”了

    前瞻研判:未来十年,县域特色化经济的竞争,不再是资源的竞争,而是市场信任的竞争。谁能为消费者提供最确定的价值承诺,谁就能赢得市场。 2026年全国两会刚刚落幕,“十五五”规划进入开局之年。今年的政府工作报告中,“扎实推进乡村全面振兴”被摆在突出位置,明确提出要“壮大县域富民产业,做好土特产文章”。这
    南昌光电产业集群将重磅亮相ISLE 2026
    南昌光电产业集群将重磅亮相ISLE 2026

    2026 ISLE展前瞻:南昌光电产业集群即将重磅亮相 明年三月,深圳国际会展中心将迎来一场行业盛事。2026年3月5日至7日,ISLE国际智慧显示及系统集成展将在这里拉开帷幕。而这一次,聚光灯将格外聚焦于一个区域——南昌光电产业集群。他们将以“光耀南昌,智链全球”为主题,携一支实力雄厚的“集团军”
    天龙三号全球首次海上动力系统试车成功,商业航天竞速“大运力”更需安全“压舱石”
    天龙三号全球首次海上动力系统试车成功,商业航天竞速“大运力”更需安全“压舱石”

    天龙三号海上试车成功:看中国商业航天如何将“安全”铸为核心竞争力 9月15日,山东海阳东方航天港,巨大的轰鸣声撕裂长空,炽热的白色蒸汽升腾而起。北京天兵科技自主研制的天龙三号大型液体运载火箭,在这里的海上平台成功完成了一级动力系统试车。 这次试车可不简单——它是世界首次海上动力系统试车试验。结果让人
    通用技术集团发布四大战略行动计划,形成全维发展布局
    通用技术集团发布四大战略行动计划,形成全维发展布局

    3月18日,通用技术集团机床产业生态合作伙伴大会在北京国家会议中心举行 春日的北京,一场关乎中国工业未来的盛会拉开帷幕。通用技术集团机床产业生态合作伙伴大会在国家会议中心举行,近500位产业链上下游的企业代表与行业专家齐聚一堂。会上,通用技术集团总工程师、机床公司董事长周舟发布了集团机床产业的未来发
    华为鸿蒙电脑亮相,重构产业新格局
    华为鸿蒙电脑亮相,重构产业新格局

    华为鸿蒙电脑技术与生态沟通会隆重举行,首款鸿蒙电脑惊艳登场,这一标志性事件预示着华为在电脑领域迈出了具有深远影响的关键一步,为国产电脑产业带来了全新的革新与发展契机。鸿蒙电脑的推出并非一朝一夕之功,而是华为经过五年精心策划的结果。在此期间,华为汇聚了超过10000名顶尖工程师,与20多家专业研究所紧密合作,投入大量的精力与资源进行技术研发,最终积累了超过2700项核心专利,彰显了其强大的技术实力与创新能力。新推出的HarmonyOS5采用鸿蒙内核,从操作系统底层开始重构,旨在为用户提供全面升级的办公体验

    ACL 2024 | 提升大模型持续学习性能,哈工大、度小满提出共享注意力框架SAPT
    ACL 2024 | 提升大模型持续学习性能,哈工大、度小满提出共享注意力框架SAPT

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com赵伟翔是哈尔滨工业大学社会计算与信息检索研究中心2021级直博生,导师为赵妍妍教授和秦兵教授。主要研究方向为对话系统、大语言模型对齐等。他曾以第一作者在ACL、AAAI、IJCAI、CO
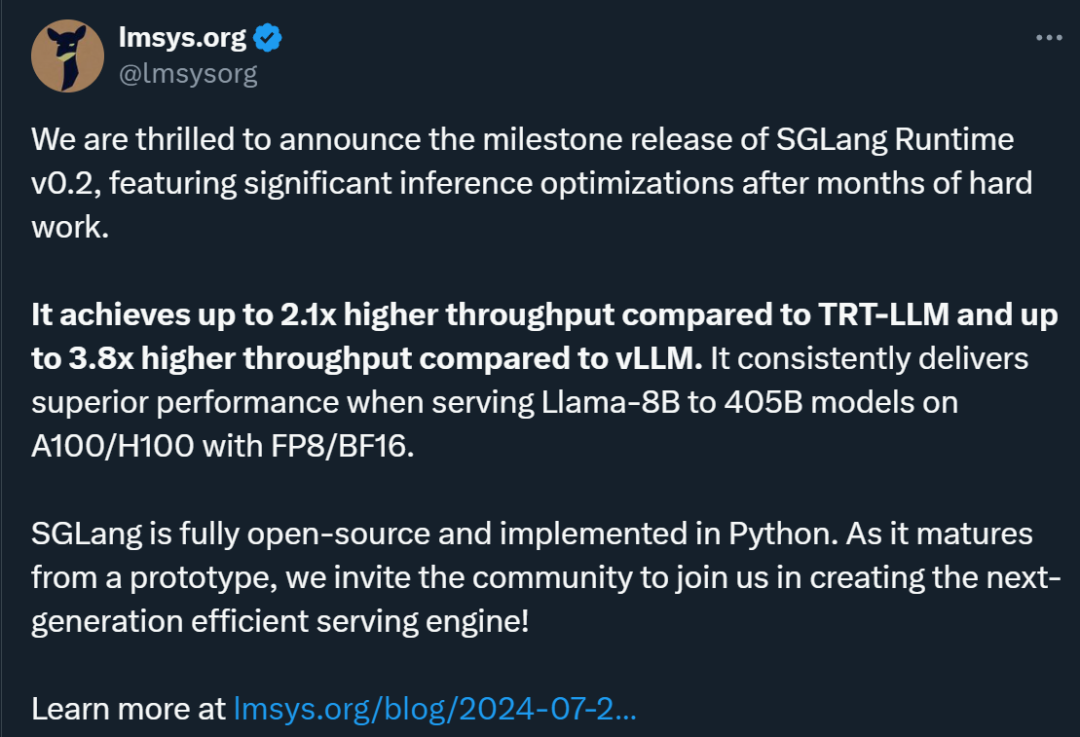
    贾扬清点赞:3K star量的SGLang上新,加速Llama 405B推理秒杀vLLM、TensorRT-LLM
    贾扬清点赞:3K star量的SGLang上新,加速Llama 405B推理秒杀vLLM、TensorRT-LLM

    用来运行Llama3405B优势明显。最近,Meta开源了最新的405B模型(Llama3.1405B),把开源模型的性能拉到了新高度。由于模型参数量很大,很多开发者都关心一个问题:怎么提高模型的推理速度?时隔才两天,LMSYSOrg团队就出手了,推出了全新的SGLangRuntimev0.2。这是一个用于LLM和VLM的通用服务引擎。在运行Llama3.1405B时,它的吞吐量和延迟表现都优于vLLM和TensorRT-LLM。在某些情况下(运行Llama系列模型),它的吞吐量甚至能达到TensorRT
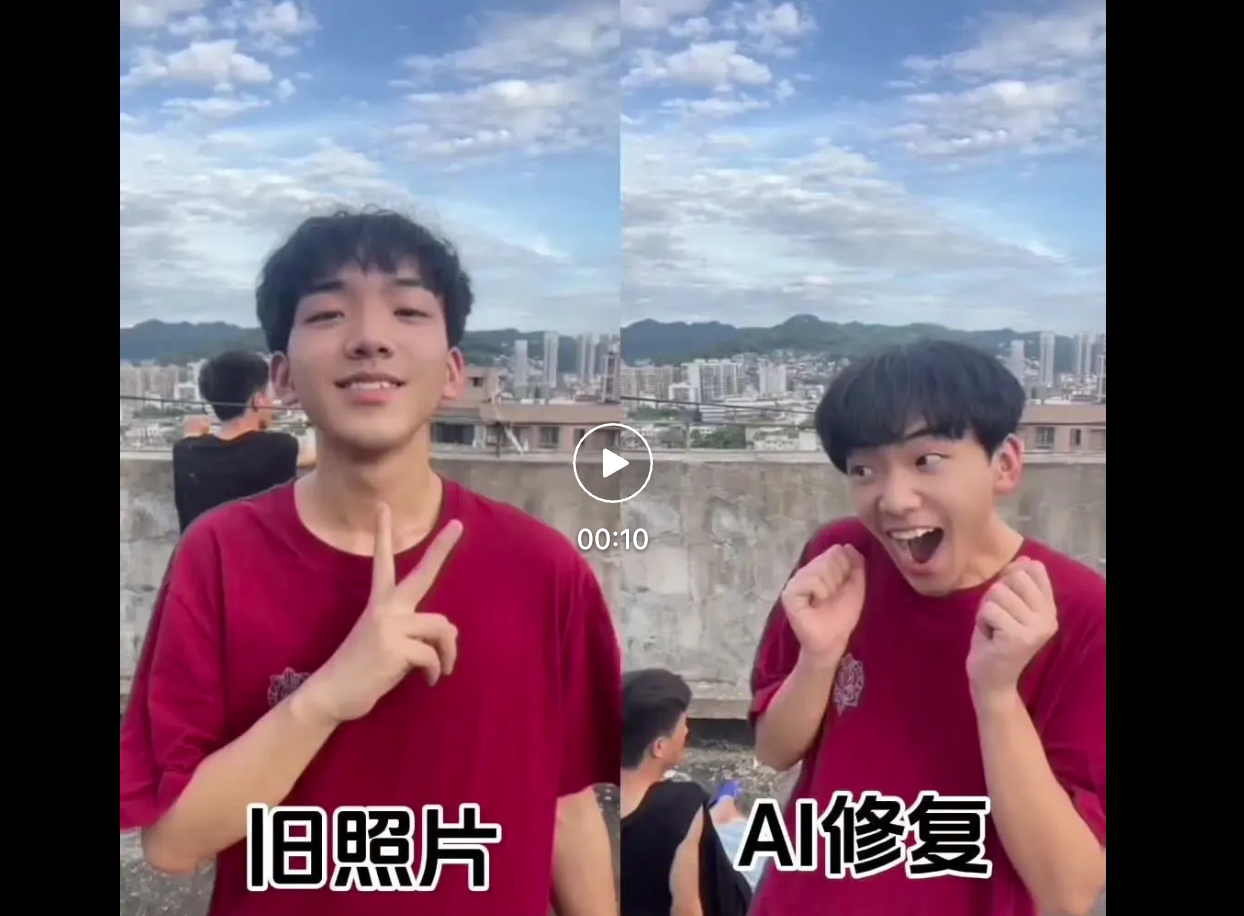
    人类模仿AI新赛道,AI:论疯癫,你是我爹
    人类模仿AI新赛道,AI:论疯癫,你是我爹

    机器之能报道编辑:杨文AI被人类带坏!这个世界,太癫了……最近,社交媒体上冒出来一堆搞怪视频,打着AI的旗号,真人cosAI,甚至抖音还专门出了个热门话题——人类模仿AI大赛。(视频来自抖音博主「关妮乱石」)视频链接:https://mp.weixin.qq.com/s/1DVc8skecSsO0a9QcklZlw套路都一个样儿:左边一张旧照片,右边打着「AI修复」的字幕,实际由真人演绎着脑干缺失的狗血「剧情」。-1-AI:第一次被人冒充,没想到比我还抽
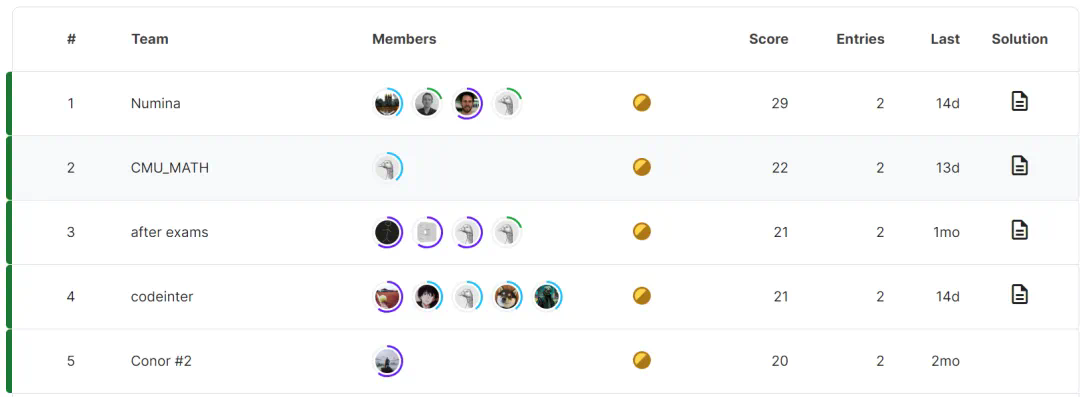
    首届AI奥数竞赛方案公布:4支获奖队伍,竟都选择国产模型DeepSeekMath
    首届AI奥数竞赛方案公布:4支获奖队伍,竟都选择国产模型DeepSeekMath

    获胜的AI数学奥林匹克模型出炉!几天前,随着榜单的公布,大家对全球首届AI数学奥林匹克竞赛(AIMO)进步奖的讨论量居高不下。这次比赛共有5个团队胜出,获得第一名的是Numina的团队,CMU_MATH位列第二,afterexams暂居第三,codeinter、Conor#2团队分别拿到第四、第五的成绩。图源:https://www.kaggle.com/c/ai-mathematical-olympiad-prize/leaderboard这一成绩,曾让陶哲轩感到惊讶。当时官方只公布了获奖名单,并未透漏
    2024年WAIC·云帆奖启航:擎启AGI时代,集结超越边界的探索者
    2024年WAIC·云帆奖启航:擎启AGI时代,集结超越边界的探索者

    2024年WAIC・云帆奖面向全球征选AI青年技术人才,欢迎点击「此链接」报名或提名。人工智能的研究范式和产业格局正在经历深刻而积极的转变。过去一年,大模型引发了一股席卷全球的智能浪潮,这不仅推动了AI技术在更广泛领域的应用,也激发了人类对人工智能深层次潜力的追寻和探索。在这场技术革新的洪流中,通用人工智能(AGI)正逐渐从幻想走进现实。我们正处于一个新征程的起点,这个阶段将以人类对通用智能的不懈追求为特征。迎接即将到来的新时代,让我们将目光投向那些充满激情、勇于探索的青年创新者。他们凭借卓越的智慧和无畏


    查看更多
    精品专题 更多
    装机必备
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows
    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程
    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    Mac软件 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    Aperty macOS版
    Aperty macOS版
    macOS

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    WINDOWS 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    PixTV 网页版
    PixTV 网页版
    Windows

    PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。