

介绍Whoosh:一个Python开发的小型搜索引擎工具
Whoosh简介Whoosh由MattChaput创建,它一开始是一个为Houdini3D动画软件包的在线文档提供简单、快速的搜索服务工具,之后便慢慢成为一个成熟的搜索解决工具并已开源。Whoosh纯由Python编写而成,是一个灵活的,方便的,轻量级的搜索引擎工具,现在同时支持Python2、3,其优点如下:Whoosh纯由Python编写而成,但很快,只需要Python环境即可,不需要编译器;默认使用OkapiBM25F排序算法,也支持其他排序算法;相比于其他搜索引擎,Whoosh会创建更
Whoosh简介
Whoosh由Matt Chaput创建,它一开始是一个为Houdini 3D动画软件包的在线文档提供简单、快速的搜索服务工具,之后便慢慢成为一个成熟的搜索解决工具并已开源。
Whoosh纯由Python编写而成,是一个灵活的,方便的,轻量级的搜索引擎工具,现在同时支持Python2、3,其优点如下:
- Whoosh纯由Python编写而成,但很快,只需要Python环境即可,不需要编译器;
- 默认使用 Okapi BM25F排序算法,也支持其他排序算法;
- 相比于其他搜索引擎,Whoosh会创建更小的index文件;
- Whoosh中的index文件编码必须是unicode;
- Whoosh可以储存任意的Python对象。
Whoosh的官方介绍网站为:https://whoosh.readthedocs.io/en/latest/intro.html 。相比于ElasticSearch或者Solr等成熟的搜索引擎工具,Whoosh显得更轻便,操作更简单,可以考虑在小型的搜索项目中使用。
Index & query
对于熟悉ES的人来说,搜索的两个重要的方面为mapping和query,也就是索引的构建以及查询,背后是复杂的索引储存、query解析以及排序算法等。如果你有ES方面的经验,那么,对于Whoosh是十分容易上手的。
按照笔者的理解以及Whoosh的官方文档,Whoosh的入门使用主要是index以及query。搜索引擎的强大功能之一在于它能够提供全文检索,这依赖于排序算法,比如BM25,也依赖于我们怎样储存字段。因此,index作为名词时,是指字段的索引,index作为动词时,是指建立字段的索引。而query会将我们需要查询的语句,通过排序算法,给出合理的搜索结果。
关于Whoosh的使用,在官文文档中已经给出了详细的说明,笔者在这里只给出一个简单的例子,来说明Whoosh如何能方便地提升我们的搜索体验。
示例代码
数据
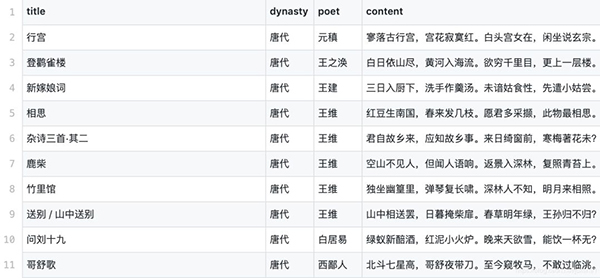
本项目的示例数据为poem.csv,下图为该数据集的前十行:
poem.csv
字段
根据数据集的特征,我们创建四个字段(fields):title, dynasty, poet, content。创建的代码如下:
# -*- coding: utf-8 -*-
import os
from whoosh.index import create_in
from whoosh.fields import *
from jieba.analyse import ChineseAnalyzer
import json
# 创建schema, stored为True表示能够被检索
schema = Schema(title=TEXT(stored=True, analyzer=ChineseAnalyzer()),
 dynasty=ID(stored=True),
 poet=ID(stored=True),
 content=TEXT(stored=True, analyzer=ChineseAnalyzer())
 )
其中,ID只能为一个单元值,不能分割为若干个词,常用于文件路径、URL、日期、分类;
TEXT文件的文本内容,建立文本的索引并存储,支持词汇搜索;Analyzer选择结巴中文分词器。
创建索引文件
接着,我们需要创建索引文件。我们利用程序先解析poem.csv文件,并将它转化为index,写入到indexdir目录下。Python代码如下:
# 解析poem.csv文件
with open('poem.csv', 'r', encoding='utf-8') as f:
 texts = [_.strip().split(',') for _ in f.readlines() if len(_.strip().split(',')) == 4]
# 存储schema信息至indexdir目录
indexdir = 'indexdir/'
if not os.path.exists(indexdir):
 os.mkdir(indexdir)
ix = create_in(indexdir, schema)
# 按照schema定义信息,增加需要建立索引的文档
writer = ix.writer()
for i in range(1, len(texts)):
 title, dynasty, poet, content = texts[i]
 writer.add_document(title=title, dynasty=dynasty, poet=poet, content=content)
writer.commit()
index创建成功后,会生成indexdir目录,里面含有上述poem.csv数据的各个字段的索引文件。
查询
index创建成功后,我们就利用进行查询。
比如我们想要查询content中含有明月的诗句,可以输入以下代码:
# 创建一个检索器
searcher = ix.searcher()
# 检索content中出现'明月'的文档
results = searcher.find("content", "明月")
print('一共发现%d份文档。' % len(results))
for i in range(min(10, len(results))):
 print(json.dumps(results[i].fields(), ensure_ascii=False))
输出结果如下:
一共发现44份文档。
前10份文档如下:
{"content": "床前明月光,疑是地上霜。举头望明月,低头思故乡。", "dynasty": "唐代", "poet": "李白 ", "title": "静夜思"}
{"content": "边草,边草,边草尽来兵老。山南山北雪晴,千里万里月明。明月,明月,胡笳一声愁绝。", "dynasty": "唐代", "poet": "戴叔伦 ", "title": "调笑令·边草"}
{"content": "独坐幽篁里,弹琴复长啸。深林人不知,明月来相照。", "dynasty": "唐代", "poet": "王维 ", "title": "竹里馆"}
{"content": "汉江明月照归人,万里秋风一叶身。休把客衣轻浣濯,此中犹有帝京尘。", "dynasty": "明代", "poet": "边贡 ", "title": "重赠吴国宾"}
{"content": "秦时明月汉时关,万里长征人未还。但使龙城飞将在,不教胡马度阴山。", "dynasty": "唐代", "poet": "王昌龄 ", "title": "出塞二首·其一"}
{"content": "京口瓜洲一水间,钟山只隔数重山。春风又绿江南岸,明月何时照我还?", "dynasty": "宋代", "poet": "王安石 ", "title": "泊船瓜洲"}
{"content": "四顾山光接水光,凭栏十里芰荷香。清风明月无人管,并作南楼一味凉。", "dynasty": "宋代", "poet": "黄庭坚 ", "title": "鄂州南楼书事"}
{"content": "青山隐隐水迢迢,秋尽江南草未凋。二十四桥明月夜,玉人何处教吹箫?", "dynasty": "唐代", "poet": "杜牧 ", "title": "寄扬州韩绰判官"}
{"content": "露气寒光集,微阳下楚丘。猿啼洞庭树,人在木兰舟。广泽生明月,苍山夹乱流。云中君不见,竟夕自悲秋。", "dynasty": "唐代", "poet": "马戴 ", "title": "楚江怀古三首·其一"}
{"content": "海上生明月,天涯共此时。情人怨遥夜,竟夕起相思。灭烛怜光满,披衣觉露滋。不堪盈手赠, 
学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



