

C++技术中的大数据处理:如何利用云计算服务处理大数据集?
答案:C++程序员可以通过以下云计算服务处理大数据集:Hadoop用于分布式数据处理Spark用于快速内存处理AmazonAthena用于服务器端查询摘要:利用云计算服务,C++程序员可以方便地处理大数据集。Hadoop负责摄取和存储,Spark分析数据并识别模式,AmazonAthena提供快速查询和报表功能,帮助企业从数据中获得见解,解决业务问题。
答案: C++ 程序员可以通过以下云计算服务处理大数据集:Hadoop 用于分布式数据处理Spark 用于快速内存处理Amazon Athena 用于服务器端查询摘要:利用云计算服务,C++ 程序员可以方便地处理大数据集。Hadoop 负责摄取和存储,Spark 分析数据并识别模式,Amazon Athena 提供快速查询和报表功能,帮助企业从数据中获得见解,解决业务问题。
C++ 技术中借助云计算服务处理大数据集
引言
在现代数据爆炸的时代,处理和分析大数据集已成为各个行业不可或缺的需求。对于 C++ 程序员来说,利用云计算服务可以简化这项复杂的任务。本文将探讨如何使用 C++ 云计算服务,并通过实战案例展示其强大功能。
利用云计算服务
云计算服务提供按需可用的计算资源,允许开发人员处理海量数据集而不必维护自己的基础设施。对于大数据处理,以下云计算服务尤其有用:
- Hadoop: 一个分布式处理框架,可用于执行大规模数据处理任务。
- Spark: 一个基于内存的高级集群计算框架,可提供极快的处理速度。
- Amazon Athena: 一个基于服务器端交互的查询服务,可用于快速分析大数据。
实用案例
场景:分析大量传感器数据以识别模式和趋势。
解决方案:
- 使用 Hadoop 分布式计算框架摄取和存储传感器数据。
- 使用 Spark 处理和分析数据集,识别模式和趋势。
- 在 Amazon Athena 中查询分析结果,以便进行实时洞察和报告。
代码示例
以下 C++ 代码示例说明了如何在 Hadoop 和 Spark 中摄取和分析数据集:
// Hadoop 摄取
hadoop::JobConf conf;
hadoop::Job job(conf);
job.addResource("./sensor_data_source.xml");

// Spark 分析
spark::SparkConf scf;
spark::SparkContext sc(scf);
spark::RDD data = sc.textFile("sensor_data.txt");
auto results = data.filter(...); // 在这里添加过滤代码

// Amazon Athena 查询
conn = new AthenaConnection("...");
rs = conn.execute("SELECT * FROM patterns");
while (rs->NextRow()) {
    ... // 处理查询结果
}
结论
通过利用 C++ 中的云计算服务,程序员可以处理和分析大数据集,从而获得有价值的见解并解决业务问题。本文中的实用案例展示了 Hadoop、Spark 和 Amazon Athena 如何有效地结合使用,为大数据处理任务提供强大的解决方
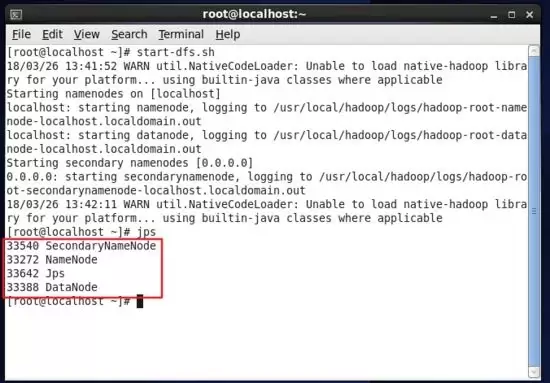
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
Arm架构在全球超大规模云计算市场份额突破50%,十大云服务商均已部署自研Arm芯片。AWSGraviton年营收超200亿美元,谷歌、微软相继跟进。预计2026年Arm在数据中心CPU市场占比达23%,与AMD持平。同时推出首款服务器级AGICPU,锁定Meta、OpenAI等客户,目标2027年收入10亿美元。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian Sniffer在云计算环境中的作用概念澄清“Debian Sniffer”并非单一、官方的工具名称,通常是指在Debian系统上运行的各类网络嗅探/抓包与分析工具(如 tcpdump、Wireshark、netsniff-ng 等)的泛称。其核心能力是对网络数据包进行捕获与分析,用于观
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
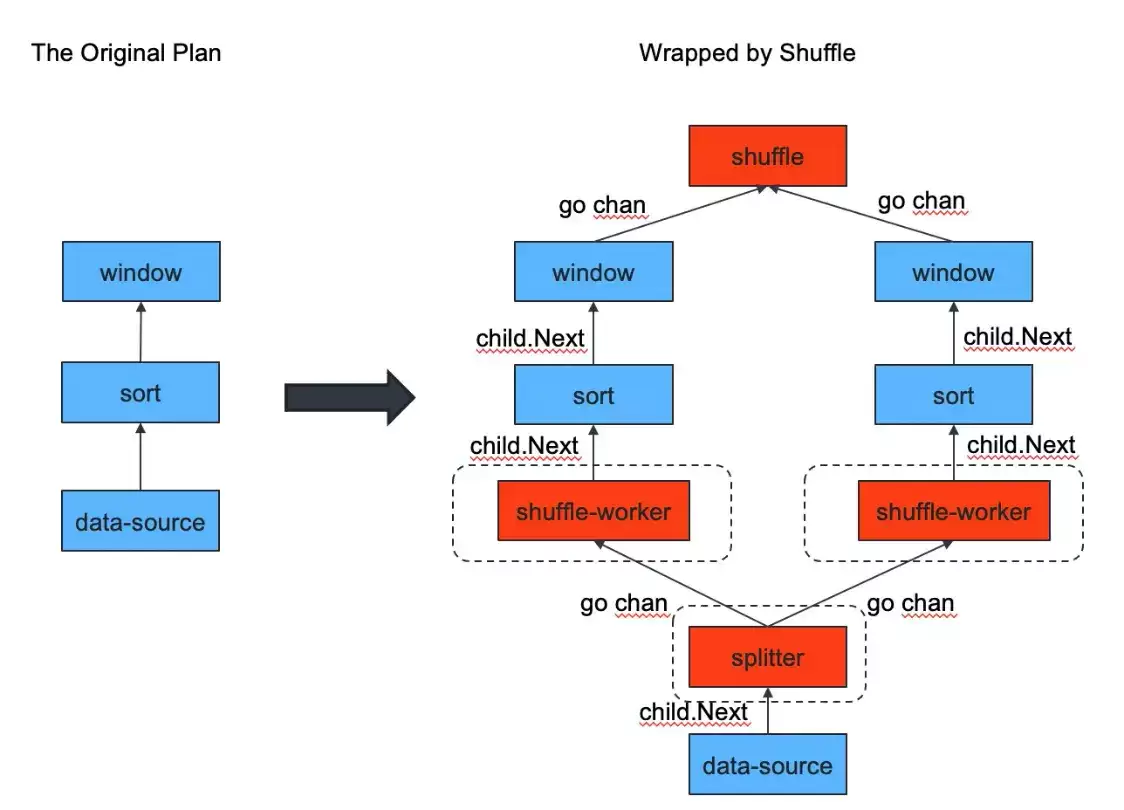
作者介绍:黄建博,云计算领域技术开发工程师;金灵, Shopee 软件研发工程师。他们的队伍 huang-b 在性能竞赛中斩获一等奖,本文将介绍 Shuffle 优化 TiDB 算子项目的设计与实践过程。在我们往常的印象中,分与合是一对矛盾的概念,但是这次比赛留给我们队伍一个很深刻的印象是,分与合是
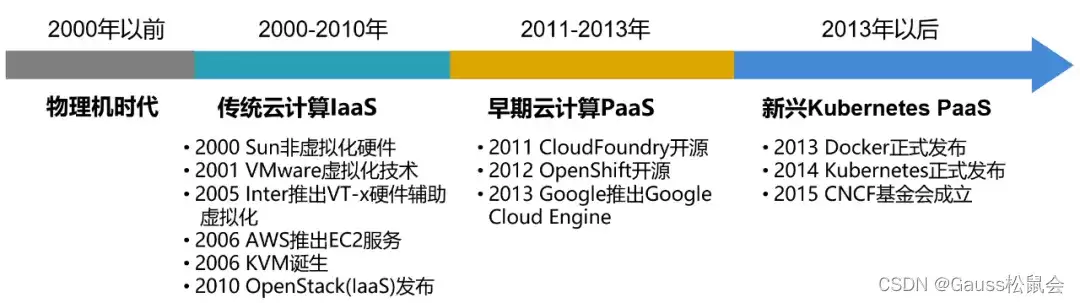
在云原生技术发展的浪潮之中,Kubernetes伴随着容器技术的发展,成为了目前云时代的“操作系统”。Kubernetes作为容器集群管理系统和云原生领域的关键项目,已经是云原生时代最需要理解与实践的核心技术。但技术的发展从来都不是一蹴而就,Kubernetes的诞生也有其对
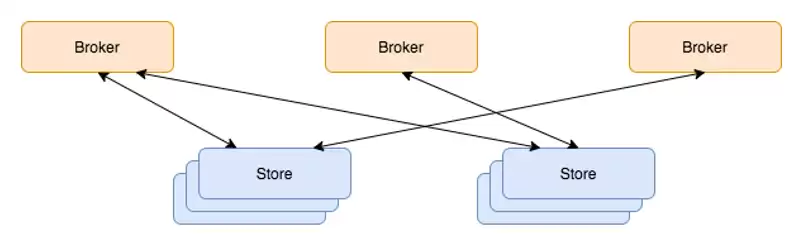
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
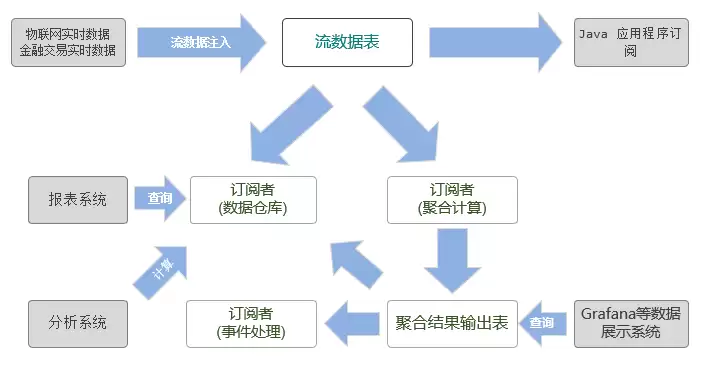
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
