

如何使用Python批量处理PDF文件以输出特定关键词的出现次数
函数模块介绍具体的代码可见全部代码部分,这部分只介绍思路和相应的函数模块对文件进行批量重命名因为文件名是中文,且无关于最后的结果,所以批量命名为数字注意如果不是第一次运行,即已经命名完成,就在主函数内把这个函数注释掉就好了defrename():path='dealPdf'filelist=os.listdir(path)fori,filesinenumerate(filelist):Olddir=os.path.join(path,files)ifos.path.isdir(Olddir
函数模块介绍
具体的代码可见全部代码部分,这部分只介绍思路和相应的函数模块
对文件进行批量重命名
因为文件名是中文,且无关于最后的结果,所以批量命名为数字
注意如果不是第一次运行,即已经命名完成,就在主函数内把这个函数注释掉就好了
def rename():
    path='dealPdf'
    filelist=os.listdir(path)
    for i,files in enumerate(filelist):
        Olddir=os.path.join(path,files)
        if os.path.isdir(Olddir):
            continue
        Newdir=os.path.join(path,str(i+1)+'.pdf')
        os.rename(Olddir,Newdir)
将PDF转化为txt
PDF是无法直接进行文本分析的,所以需要将文字转成txt文件(PDF中图内的文字无法提取)
#将pdf文件转化成txt文件
def pdf_to_txt(dealPdf,index):
    # 不显示warning
    logging.propagate = False
    logging.getLogger().setLevel(logging.ERROR)
    pdf_filename = dealPdf
    device = PDFPageAggregator(PDFResourceManager(), laparams=LAParams())
    interpreter = PDFPageInterpreter(PDFResourceManager(), device)
    parser = PDFParser(open(pdf_filename, 'rb'))
    doc = PDFDocument(parser)


    txt_filename='dealTxt\\'+str(index)+'.txt'

    # 检测文档是否提供txt转换,不提供就忽略
    if not doc.is_extractable:
        raise PDFTextExtractionNotAllowed
    else:
        with open(txt_filename, 'w', encoding="utf-8") as fw:
            #print("num page:{}".format(len(list(doc.get_pages()))))
            for i,page in enumerate(PDFPage.create_pages(doc)):
                interpreter.process_page(page)
                # 接受该页面的LTPage对象
                layout = device.get_result()
                # 这里layout是一个LTPage对象 里面存放着 这个page解析出的各种对象
                # 一般包括LTTextBox, LTFigure, LTImage, LTTextBoxHorizontal 等等
                # 想要获取文本就获得对象的text属性,
                for x in layout:
                    if isinstance(x, LTTextBoxHorizontal):
                        results = x.get_text()
                        fw.write(results)
删除txt中的换行符
因为PDF导出的txt会用换行符换行,为了避免词语因此拆开,所以删除所有的换行符
#对txt文件的换行符进行删除
def delete_huanhangfu(dealTxt,index):
    outPutString=''
    outPutTxt='outPutTxt\\'+str(index)+'.txt'
    with open(dealTxt,'r',encoding="utf-8") as f:
        lines=f.readlines()
        for i in range(len(lines)):
            if lines[i].endswith('\n'):
                lines[i]=lines[i][:-1] #将字符串末尾的\n去掉
        for j in range(len(lines)):
            outPutString+=lines[j]
    with open(outPutTxt,'w',encoding="utf-8") as fw:
        fw.write(outPutString)
添加自定义词语
此处可以根据自己的需要自定义,传入的wordsByMyself是全局变量
分词与词频统计
调用jieba进行分词,读取通用词表去掉停用词(此步其实可以省略,对最终结果影响不大),将词语和出现次数合成为键值对,输出关键词出现次数
#分词并进行词频统计
def cut_and_count(outPutTxt):
    with open(outPutTxt,encoding='utf-8') as f:
        #step1:读取文档并调用jieba分词
        text=f.read()
        words=jieba.lcut(text)
        #step2:读取停用词表,去停用词
        stopwords = {}.fromkeys([ line.rstrip() for line in open('stopwords.txt',encoding='utf-8') ])
        finalwords = []
        for word in words:
            if word not in stopwords:
                if (word != "。" and word != ",") :
                    finalwords.append(word)


        #step3:统计特定关键词的出现次数
        valuelist=[0]*len(wordsByMyself)
        counts=dict(zip(wordsByMyself,valuelist))
        for word in finalwords:
            if len(word) == 1:#单个词不计算在内
                continue
            else:
                counts[word]=counts.get(word,0)+1#遍历所有词语,每出现一次其对应值加1
        for i in range(len(wordsByMyself)):
            if wordsByMyself[i] in counts:
                print(wordsByMyself[i]+':'+str(counts[wordsByMyself[i]]))
            else:
                print(wordsByMyself[i]+':0')
主函数
通过for循环进行批量操作
if __name__ == "__main__":
    #rename()
    for i in range(1,fileNum+1):
        pdf_to_txt('dealPdf\\'+str(i)+'.pdf',i)#将pdf文件转化成txt文件,传入文件路径
        delete_huanhangfu('dealTxt\\'+str(i)+'.txt',i)#对txt文件的换行符进行删除,防止词语因换行被拆分
        word_by_myself()#添加自定义词语
        print(f'----------result {i}----------')
        cut_and_count('outPutTxt\\'+str(i)+'.txt')#分词并进行词频统计,传入文件路径
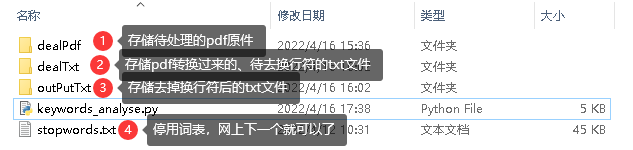
本地文件结构
全部代码
import jieba
import jieba.analyse
from pdfminer.pdfparser import PDFParser
from pdfminer.pdfdocument import PDFDocument
from pdfminer.pdfinterp import PDFResourceManager, PDFPageInterpreter
from pdfminer.converter import PDFPageAggregator
from pdfminer.layout import LTTextBoxHorizontal, LAParams
from pdfminer.pdfpage import PDFPage,PDFTextExtractionNotAllowed
import logging
import os

wordsByMyself=['社会责任','义务','上市','公司'] #自定义词语,全局变量
fileNum=16#存储总共待处理的文件数量

#重命名所有文件夹下的文件,适应处理需要
def rename():
    path='dealPdf'
    filelist=os.listdir(path)
    for i,files in enumerate(filelist):
        Olddir=os.path.join(path,files)
        if os.path.isdir(Olddir):
            continue
        Newdir=os.path.join(path,str(i+1)+'.pdf')
        os.rename(Olddir,Newdir)

#将pdf文件转化成txt文件
def pdf_to_txt(dealPdf,index):
    # 不显示warning
    logging.propagate = False
    logging.getLogger().setLevel(logging.ERROR)
    pdf_filename = dealPdf
    device = PDFPageAggregator(PDFResourceManager(), laparams=LAParams())
    interpreter = PDFPageInterpreter(PDFResourceManager(), device)
    parser = PDFParser(open(pdf_filename, 'rb'))
    doc = PDFDocument(parser)


    txt_filename='dealTxt\\'+str(index)+'.txt'

    # 检测文档是否提供txt转换,不提供就忽略
    if not doc.is_extractable:
        raise PDFTextExtractionNotAllowed
    else:
        with open(txt_filename, 'w', encoding="utf-8") as fw:
            #print("num page:{}".format(len(list(doc.get_pages()))))
            for i,page in enumerate(PDFPage.create_pages(doc)):
                interpreter.process_page(page)
                # 接受该页面的LTPage对象
                layout = device.get_result()
                # 这里layout是一个LTPage对象 里面存放着 这个page解析出的各种对象
                # 一般包括LTTextBox, LTFigure, LTImage, LTTextBoxHorizontal 等等
                # 想要获取文本就获得对象的text属性,
                for x in layout:
                    if isinstance(x, LTTextBoxHorizontal):
                        results = x.get_text()
                        fw.write(results)

#对txt文件的换行符进行删除
def delete_huanhangfu(dealTxt,index):
    outPutString=''
    outPutTxt='outPutTxt\\'+str(index)+'.txt'
    with open(dealTxt,'r',encoding="utf-8") as f:
        lines=f.readlines()
        for i in range(len(lines)):
            if lines[i].endswith('\n'):
                lines[i]=lines[i][:-1] #将字符串末尾的\n去掉
        for j in range(len(lines)):
            outPutString+=lines[j]
    with open(outPutTxt,'w',encoding="utf-8") as fw:
        fw.write(outPutString)

#添加自定义词语
def word_by_myself():
    for i in range(len(wordsByMyself)):
        jieba.add_word(wordsByMyself[i])

#分词并进行词频统计
def cut_and_count(outPutTxt):
    with open(outPutTxt,encoding='utf-8') as f:
        #step1:读取文档并调用jieba分词
        text=f.read()
        words=jieba.lcut(text)
        #step2:读取停用词表,去停用词
        stopwords = {}.fromkeys([ line.rstrip() for line in open('stopwords.txt',encoding='utf-8') ])
        finalwords = []
        for word in words:
            if word not in stopwords:
                if (word != "。" and word != ",") :
                    finalwords.append(word)


        #step3:统计特定关键词的出现次数
        valuelist=[0]*len(wordsByMyself)
        counts=dict(zip(wordsByMyself,valuelist))
        for word in finalwords:
            if len(word) == 1:#单个词不计算在内
                continue
            else:
                counts[word]=counts.get(word,0)+1#遍历所有词语,每出现一次其对应值加1
        for i in range(len(wordsByMyself)):
            if wordsByMyself[i] in counts:
                print(wordsByMyself[i]+':'+str(counts[wordsByMyself[i]]))
            else:
                print(wordsByMyself[i]+':0')

#主函数
if __name__ == "__main__":
    rename()
    for i in range(1,fileNum+1):
        pdf_to_txt('dealPdf\\'+str(i)+'.pdf',i)#将pdf文件转化成txt文件,传入文件路径
        delete_huanhangfu('dealTxt\\'+str(i)+'.txt',i)#对txt文件的换行符进行删除,防止词语因换行被拆分
        word_by_myself()#添加自定义词语
        print(f'----------result {i}----------')
        cut_and_count('outPutTxt\\'+str(i)+'.txt')#分词并进行词频统计,传入文件路径
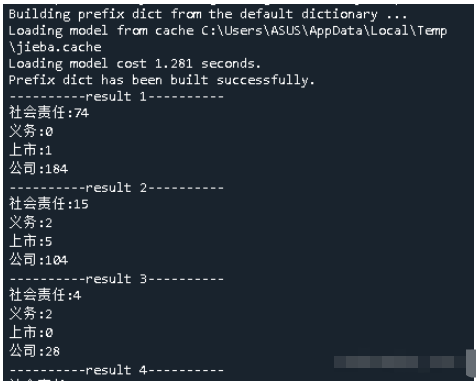
结果预览

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
PDF拆分完成后不要只看文件能否打开。按拆分范围核对页数,用首尾内容检查顺序,再通过补零编号、内容名称和页码范围统一文件名,减少漏页、重复页和发送后乱序的问题。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



